讀者:研究生、科研新人和工程型研究者;檢索與實驗日期:2026-09-17。
摘要
模型的一層被替換後,錯誤答案恢復了,能否據此宣佈找到了“知識存儲位置”?本文從激活替換的三次前向計算出發,閱讀 ROME 與 TransformerLens 官方代碼,訓練一個四百零二參數的小網絡,實際檢查替換方向、整層控制、組合效應和座標旋轉。目標是復現可審計的干預協議,理解證據的邊界;本次沒有運行語言模型,也不將玩具網絡的成績寫成原論文復現結果。
目錄
- 復現價值:從相關圖到干預問題
- 核心思想與公式
- 官方代碼閱讀路線
- 最小實驗與實際結果
- 評測協議與獨立審計
- 失敗排查與解釋邊界
- 後續科研問題
- 總結與參考資料
復現價值:從相關圖到干預問題
機制可解釋性試圖說明神經網絡內部怎樣完成計算。注意力很大、神經元很活躍,只說明觀察到的數值;激活替換則主動改變中間狀態,再觀察輸出。激活是一次前向運行產生的向量,參數是訓練得到的權重,替換前者不等於編輯後者。
論文報告:Meng 等人在 NeurIPS 二〇二二年的工作中,以 causal tracing 研究事實回憶,再提出權重編輯方法 ROME。本文核對的是二〇二三年一月修訂的第五版,重點閱讀追蹤協議,不復述未經運行的編輯成績。題名、作者與版本
另一個起點是 Zhang 與 Nanda 的 ICLR 二〇二四年論文:擾動方法、評分指標和替換範圍可能改變定位結論。因此,本篇問題不是“哪一格最紅”,而是“在什麼輸入對和干預下,這一格改變了什麼”。論文版本頁
核心思想與公式
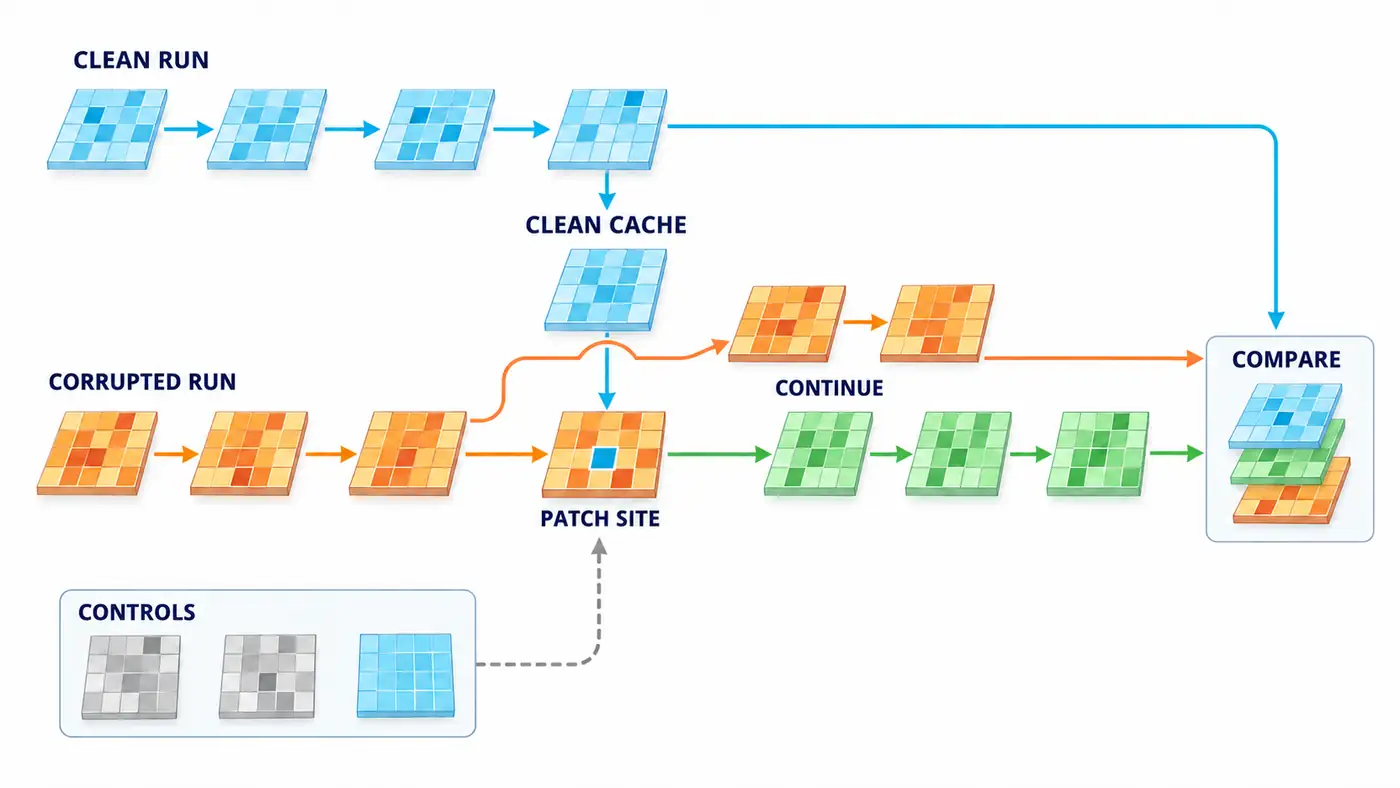
先運行原始輸入 clean,保存激活;再運行對照輸入 corrupted,保存基線;最後重新運行 corrupted,只在指定位置放回 clean 激活,繼續計算。圖中橙色分支在替換前分出,代表獨立完成的未替換基線;格子是概念示意,不是實驗熱圖。
分別是原始和對照輸入, 是本次替換的座標集合,其餘座標保持對照值。在語言模型中,殘差激活常為 :批大小、詞元數和隱藏寬度;替換一個位置通常替換整個 維向量。本次小網絡沒有詞元軸,隱藏層為 ,可以替換一個或多個神經元。
是 softmax 前的 logit,即未歸一化類別分數; 是 clean 答案, 是競爭答案,三個下標表示 patched、corrupted、clean。 表示回到對照分數, 表示回到原始分數;它不是概率,可以越界,不能截斷成漂亮百分比。分母接近零時應保留原始差值並停止解釋恢復率。本文同時保存目標概率變化,避免把分數移動與答案翻轉混為一談。指標與擾動定義
方向也決定問題:clean→corrupted 檢查能否恢復,反向替換檢查原始行為是否受損。恢復所需條件和破壞所需條件可能不同,冗餘通路會讓它們不對稱。Heimersheim 與 Nanda 的方法討論
官方代碼閱讀路線
第一站是 ROME 的 causal_trace.py。沿 calculate_hidden_flow 進入 trace_with_patch:批次零號樣本保持 clean,其餘樣本接受嵌入噪聲;指定層和位置再複製零號激活。輸出取最後位置的目標詞概率,並對受擾動樣本求平均。應檢查噪聲範圍、目標答案和批次索引,不能把這套概率協議直接當成本文的 logit 差協議。
第二站是 nethook.py。hook 是前向執行時的回調,可讀取或替換模塊輸出。檢查返回值是否為元組、緩存是否複製,以及離開上下文後是否移除 hook;否則一次掃描留下的干預可能汙染下一次基線。
第三站是 TransformerLens 的 patching.py。generic_activation_patch 逐個索引重新運行 corrupted;layer_pos_patch_setter 對指定位置賦值。resid_pre、mlp_out 和 attention pattern 的含義、軸順序不同,不能互換。殘差位置掃描返回層×位置結果,但這並不自動證明一條完整計算迴路。
上述鏈接均為實際打開的官方主分支,未鎖定提交,動態版本兼容性待人工核驗。本次完成靜態閱讀,未執行官方環境。附帶的真實模型腳本只支持本地 GPT-2,替換整個 block 輸出,不能稱作單獨替換前饋模塊。
最小實驗與實際結果
任務刻意簡單:輸入兩個取值 ,選擇符 決定輸出哪一個。 選 , 選 ;輸入另含兩個獨立高斯噪聲特徵,標準差為 ,標籤忽略它們。翻轉被選值會改變答案,翻轉未選值則不應改變答案。
模型是多層感知機,即 MLP:五維輸入經過兩個十六維 tanh 隱藏層,再得到兩個類別的分數。數據種子為 760,八種核心模式各搭配不同噪聲,生成訓練五百一十二條、驗證一百二十八條、診斷六十四條。三個集合沒有重複浮點樣本,但共享全部核心模式,因此只檢查該任務內的行為,不能聲稱組合泛化。
tanh 是把實數壓到負一與一之間的雙曲正切函數,在這裡提供非線性;Adam 是按梯度的一階、二階歷史統計調整更新幅度的優化器。這些選擇只是讓小網絡學會選擇任務,並不模擬語言模型的注意力、分詞或事實知識。
模型種子為 76、77、78;全批次 Adam,學習率 ,固定一千步。保存最終權重,驗證曲線不用於早停。每層四個待替換神經元,按驗證集單點平均 選取,診斷集不參與選擇。在文章目錄執行:
python3 code/patching_numpy.py
python3 code/audit_results.py
依賴和環境說明見 code/README.md。本次實際環境為 Python 3.12.14、NumPy 2.3.5、CPU 雙精度;輸入為 [64,5],兩層激活均為 [64,16],輸出為 [64,2]。
本次實際驗證:三個種子的 clean 準確率均為一;翻轉被選值後,相對原答案的準確率均為零。下表是在同一診斷集上的三種子均值,恢復率先逐例計算再平均;標準差表示初始化差異,不是置信區間。
| 干預 | 相對原答案准確率 | 恢復率均值 ± 種子標準差 |
|---|---|---|
| 不替換 | 0.0000 | 0.0000 ± 0.0000 |
| 恢復第一層全部座標 | 1.0000 | 1.0000 ± 0.0000 |
| 恢復第一層驗證集所選四維 | 0.2865 | 0.3836 ± 0.0467 |
| 恢復第二層驗證集所選四維 | 0.1615 | 0.4113 ± 0.0368 |
第二層恢復率稍高,答案准確率卻更低,說明連續分數和離散決策並不等價。整層恢復成功是接口控制:這張無跳連網絡的後續計算只依賴被恢復的整層狀態,成功本來就是預期,不能當作精確定位知識的發現。
再做座標對照:只在第二隱藏層之後插入正交變換 ,恢復計算前乘 。 為 ,滿足 ;未乾預輸出不變,但替換一個新座標等於改變原空間的一條方向。種子 76 的最大單座標平均 從 變為 ,全部座標效應總和仍約為 。
作者推斷:這裡的“集中程度”依賴被允許替換的座標。實驗沒有證明原神經元無意義,也沒有發現新的語言迴路;它展示了單座標排名與整個函數不是同一層面的對象。旋轉發生在 tanh 之後,不能推廣成任意旋轉非線性層都保持等價。
評測協議與獨立審計
先確認模型會做原任務、擾動確實改變目標行為,再談恢復。翻轉未選值時,三個種子的答案准確率仍為一,但 logit 差會移動;本文將該條件的恢復率統一記為空,只觀察原始分數。這比把每種擾動都強行歸一化更清楚。
每個種子保存八千三百二十條記錄,包括無替換、自身複製、整層、單點、四點聯合、反向、置零和錯配供體。錯配採用批次循環移位,由於數據按核心模式分組,很多供體仍共享標籤;它只是弱診斷,不能偽稱嚴格的隨機負對照。置零發生在 corrupted 基底,反向替換才使用 clean 基底,兩者回答不同問題。
六十四個診斷輸入並不代表六十四種獨立推理規則:每個核心模式有八個噪聲變體。未來若要估計跨問題的不確定性,應按核心模式或語義模板分組抽樣,同時增加任務種類,不能把大量相似改寫當成同樣多的獨立證據。
獨立審計用標量循環重算兩萬四千九百六十條記錄,最大絕對誤差為 ,並重新檢查驗證集選點及彙總指標。有限差分檢查覆蓋六組參數的選定元素,最大誤差為 ,不是每個參數都做了數值梯度檢查。全部數據、權重、逐例 logits、訓練曲線和日誌均保存在 code/results/。
第一層四點聯合效應與四個單點效應之和並不相等:種子 76 的逐例最大差約為 。第二層之後只有線性讀出,其 logit 差效應可加,誤差處於浮點精度。這個結構對照說明,組合替換必須實際運行,不能直接把熱圖格子相加。
失敗排查與解釋邊界
結果完全不變時,先查 hook 是否命中、位置是否對齊、供體是否來自正確樣本;結果異常完美時,檢查是否替換了整個狀態、答案位置或後續 logits。緩存應獨立複製,權重凍結,每次掃描從相同基線重啟。無替換和自身複製必須還原基線,整層恢復必須符合網絡結構預期。
真實文本還要檢查分詞:字符數相同不保證詞元數相同,詞元數相同也不保證語義位置對應。多詞元答案需要另設序列評分,不能隨意只取首詞元。local_gpt2_patch.py 會打印位置、檢查單詞元答案並移除 hook;當前缺少依賴和本地權重,僅通過語法檢查,模型運行及示例提示均待人工核驗。
恢復是特定輸入對、替換集合和指標下的證據。它不會自動證明該位置是唯一存儲點,也不會告訴我們上游如何寫入、下游如何讀取。自然輸入產生的供體激活與另一輸入的其餘激活拼接後,仍可能形成不自然的內部狀態。後續必須擴大輸入覆蓋並做組合、反向及路徑層面的驗證。
後續科研問題
第一,固定模型和輸入對,只改變擾動方式,定位排序是否穩定?應同時報告基線破壞強度,避免把更強破壞造成的恢復空間解釋為更重要的機制。
第二,在相同替換維數預算下,原座標與學習到的子空間誰更穩定?子空間只能在訓練或驗證數據上學習,再到獨立提示上比較,不能看完測試熱圖後挑方向。
第三,候選集合的聯合恢復能否跨改寫保持?先用掃描提出假設,再凍結集合做確認性實驗;如果只在發現它的句子上有效,應保留失敗例,而不是不斷擴大集合直到恢復滿分。
總結
可復現的激活替換不是一張熱圖,而是輸入對、替換座標、基線、指標和控制實驗組成的證據鏈。本篇跑通了小網絡的干預與審計,也明確留下真實語言模型尚未驗證的部分。讀者下一步應遷移這套檢查協議,再討論具體層和迴路的含義。
參考資料
以下均為一手來源,檢索日期為 2026-09-17,已實際打開。
- Kevin Meng、David Bau、Alex Andonian、Yonatan Belinkov. Locating and Editing Factual Associations in GPT. NeurIPS 2022;核對 arXiv v5,2023-01-13。
- Fred Zhang、Neel Nanda. Towards Best Practices of Activation Patching in Language Models: Metrics and Methods. ICLR 2024;v2,2024-01-17;全文。
- Stefan Heimersheim、Neel Nanda. How to use and interpret activation patching. 2024,v1,2024-04-23;全文。
- ROME 作者及貢獻者:causal_trace.py、nethook.py,檢索當日主分支。
- TransformerLens 維護者:patching.py,檢索當日主分支。