系列:开源 AI 论文复现实验与代码解读 · 第五轮第 076 篇
读者:研究生、科研新人和工程型研究者;检索与实验日期:2026-09-17。
摘要
模型的一层被替换后,错误答案恢复了,能否据此宣布找到了“知识存储位置”?本文从激活替换的三次前向计算出发,阅读 ROME 与 TransformerLens 官方代码,训练一个四百零二参数的小网络,实际检查替换方向、整层控制、组合效应和坐标旋转。目标是复现可审计的干预协议,理解证据的边界;本次没有运行语言模型,也不将玩具网络的成绩写成原论文复现结果。
目录
- 复现价值:从相关图到干预问题
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议与独立审计
- 失败排查与解释边界
- 后续科研问题
- 总结与参考资料
复现价值:从相关图到干预问题
机制可解释性试图说明神经网络内部怎样完成计算。注意力很大、神经元很活跃,只说明观察到的数值;激活替换则主动改变中间状态,再观察输出。激活是一次前向运行产生的向量,参数是训练得到的权重,替换前者不等于编辑后者。
论文报告:Meng 等人在 NeurIPS 二〇二二年的工作中,以 causal tracing 研究事实回忆,再提出权重编辑方法 ROME。本文核对的是二〇二三年一月修订的第五版,重点阅读追踪协议,不复述未经运行的编辑成绩。题名、作者与版本
另一个起点是 Zhang 与 Nanda 的 ICLR 二〇二四年论文:扰动方法、评分指标和替换范围可能改变定位结论。因此,本篇问题不是“哪一格最红”,而是“在什么输入对和干预下,这一格改变了什么”。论文版本页
核心思想与公式
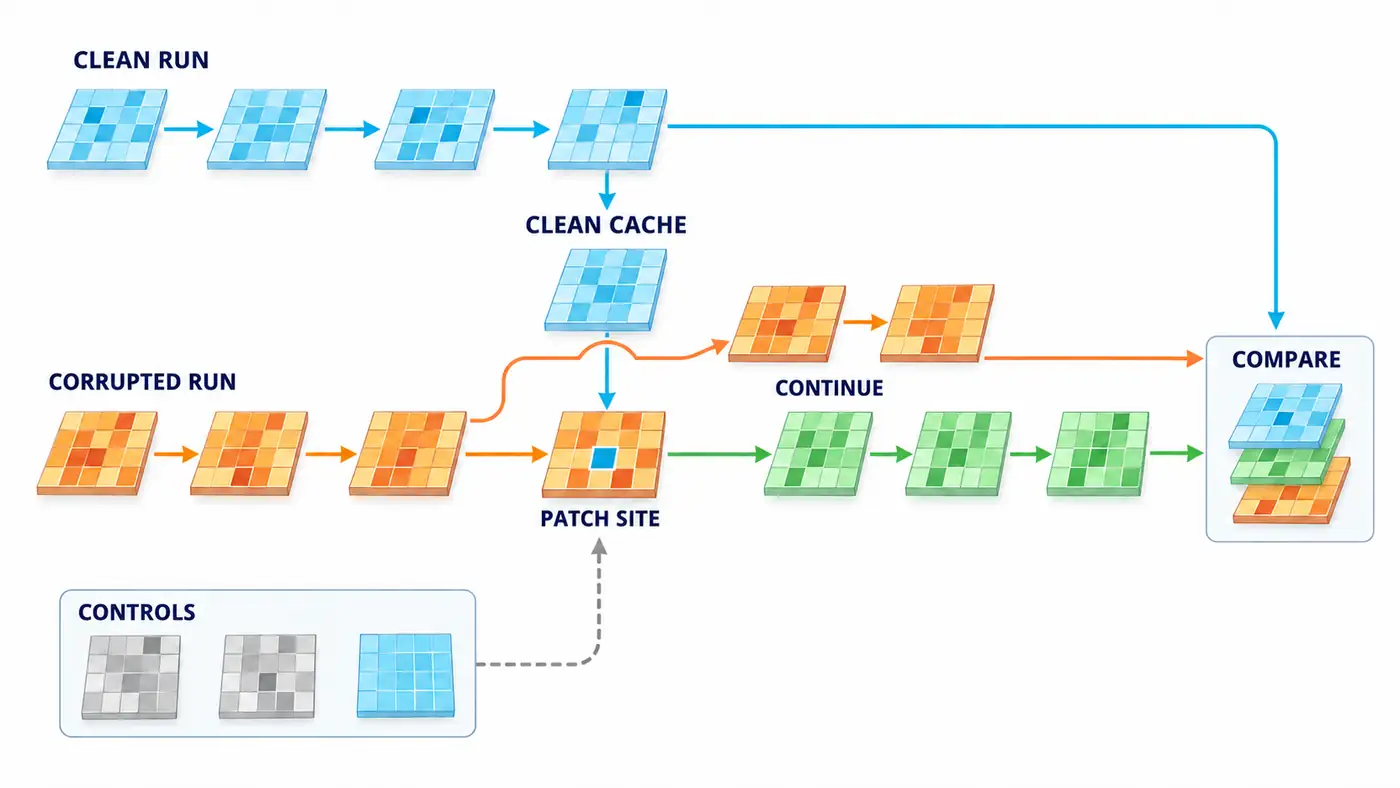
先运行原始输入 clean,保存激活;再运行对照输入 corrupted,保存基线;最后重新运行 corrupted,只在指定位置放回 clean 激活,继续计算。图中橙色分支在替换前分出,代表独立完成的未替换基线;格子是概念示意,不是实验热图。
$$ \widetilde h_S(x_b)=h_S(x_c),\qquad \widetilde h_{\bar S}(x_b)=h_{\bar S}(x_b). $$
$x_c,x_b$ 分别是原始和对照输入,$S$ 是本次替换的坐标集合,其余坐标保持对照值。在语言模型中,残差激活常为 $[B,T,d]$:批大小、词元数和隐藏宽度;替换一个位置通常替换整个 $d$ 维向量。本次小网络没有词元轴,隐藏层为 $[B,16]$,可以替换一个或多个神经元。
$$ m(x)=z_y(x)-z_{y'}(x),\qquad \Delta m=m_p-m_b,\qquad R=\frac{m_p-m_b}{m_c-m_b}. $$
$z$ 是 softmax 前的 logit,即未归一化类别分数;$y$ 是 clean 答案,$y'$ 是竞争答案,三个下标表示 patched、corrupted、clean。$R=0$ 表示回到对照分数,$R=1$ 表示回到原始分数;它不是概率,可以越界,不能截断成漂亮百分比。分母接近零时应保留原始差值并停止解释恢复率。本文同时保存目标概率变化,避免把分数移动与答案翻转混为一谈。指标与扰动定义
方向也决定问题:clean→corrupted 检查能否恢复,反向替换检查原始行为是否受损。恢复所需条件和破坏所需条件可能不同,冗余通路会让它们不对称。Heimersheim 与 Nanda 的方法讨论
官方代码阅读路线
第一站是 ROME 的 causal_trace.py。沿 calculate_hidden_flow 进入 trace_with_patch:批次零号样本保持 clean,其余样本接受嵌入噪声;指定层和位置再复制零号激活。输出取最后位置的目标词概率,并对受扰动样本求平均。应检查噪声范围、目标答案和批次索引,不能把这套概率协议直接当成本文的 logit 差协议。
第二站是 nethook.py。hook 是前向执行时的回调,可读取或替换模块输出。检查返回值是否为元组、缓存是否复制,以及离开上下文后是否移除 hook;否则一次扫描留下的干预可能污染下一次基线。
第三站是 TransformerLens 的 patching.py。generic_activation_patch 逐个索引重新运行 corrupted;layer_pos_patch_setter 对指定位置赋值。resid_pre、mlp_out 和 attention pattern 的含义、轴顺序不同,不能互换。残差位置扫描返回层×位置结果,但这并不自动证明一条完整计算回路。
上述链接均为实际打开的官方主分支,未锁定提交,动态版本兼容性待人工核验。本次完成静态阅读,未执行官方环境。附带的真实模型脚本只支持本地 GPT-2,替换整个 block 输出,不能称作单独替换前馈模块。
最小实验与实际结果
任务刻意简单:输入两个取值 $a,b\in{-1,1}$,选择符 $q$ 决定输出哪一个。$q=-1$ 选 $a$,$q=1$ 选 $b$;输入另含两个独立高斯噪声特征,标准差为 $0.3$,标签忽略它们。翻转被选值会改变答案,翻转未选值则不应改变答案。
模型是多层感知机,即 MLP:五维输入经过两个十六维 tanh 隐藏层,再得到两个类别的分数。数据种子为 760,八种核心模式各搭配不同噪声,生成训练五百一十二条、验证一百二十八条、诊断六十四条。三个集合没有重复浮点样本,但共享全部核心模式,因此只检查该任务内的行为,不能声称组合泛化。
tanh 是把实数压到负一与一之间的双曲正切函数,在这里提供非线性;Adam 是按梯度的一阶、二阶历史统计调整更新幅度的优化器。这些选择只是让小网络学会选择任务,并不模拟语言模型的注意力、分词或事实知识。
模型种子为 76、77、78;全批次 Adam,学习率 $0.01$,固定一千步。保存最终权重,验证曲线不用于早停。每层四个待替换神经元,按验证集单点平均 $\Delta m$ 选取,诊断集不参与选择。在文章目录执行:
python3 code/patching_numpy.py
python3 code/audit_results.py
依赖和环境说明见 code/README.md。本次实际环境为 Python 3.12.14、NumPy 2.3.5、CPU 双精度;输入为 [64,5],两层激活均为 [64,16],输出为 [64,2]。
本次实际验证:三个种子的 clean 准确率均为一;翻转被选值后,相对原答案的准确率均为零。下表是在同一诊断集上的三种子均值,恢复率先逐例计算再平均;标准差表示初始化差异,不是置信区间。
| 干预 | 相对原答案准确率 | 恢复率均值 ± 种子标准差 |
|---|---|---|
| 不替换 | 0.0000 | 0.0000 ± 0.0000 |
| 恢复第一层全部坐标 | 1.0000 | 1.0000 ± 0.0000 |
| 恢复第一层验证集所选四维 | 0.2865 | 0.3836 ± 0.0467 |
| 恢复第二层验证集所选四维 | 0.1615 | 0.4113 ± 0.0368 |
第二层恢复率稍高,答案准确率却更低,说明连续分数和离散决策并不等价。整层恢复成功是接口控制:这张无跳连网络的后续计算只依赖被恢复的整层状态,成功本来就是预期,不能当作精确定位知识的发现。
再做坐标对照:只在第二隐藏层之后插入正交变换 $h'=hQ$,恢复计算前乘 $Q^\top$。$Q$ 为 $[16,16]$,满足 $QQ^\top=I$;未干预输出不变,但替换一个新坐标等于改变原空间的一条方向。种子 76 的最大单坐标平均 $\Delta m$ 从 $2.6235$ 变为 $5.9706$,全部坐标效应总和仍约为 $23.7912$。
作者推断:这里的“集中程度”依赖被允许替换的坐标。实验没有证明原神经元无意义,也没有发现新的语言回路;它展示了单坐标排名与整个函数不是同一层面的对象。旋转发生在 tanh 之后,不能推广成任意旋转非线性层都保持等价。
评测协议与独立审计
先确认模型会做原任务、扰动确实改变目标行为,再谈恢复。翻转未选值时,三个种子的答案准确率仍为一,但 logit 差会移动;本文将该条件的恢复率统一记为空,只观察原始分数。这比把每种扰动都强行归一化更清楚。
每个种子保存八千三百二十条记录,包括无替换、自身复制、整层、单点、四点联合、反向、置零和错配供体。错配采用批次循环移位,由于数据按核心模式分组,很多供体仍共享标签;它只是弱诊断,不能伪称严格的随机负对照。置零发生在 corrupted 基底,反向替换才使用 clean 基底,两者回答不同问题。
六十四个诊断输入并不代表六十四种独立推理规则:每个核心模式有八个噪声变体。未来若要估计跨问题的不确定性,应按核心模式或语义模板分组抽样,同时增加任务种类,不能把大量相似改写当成同样多的独立证据。
独立审计用标量循环重算两万四千九百六十条记录,最大绝对误差为 $8.88\times10^{-15}$,并重新检查验证集选点及汇总指标。有限差分检查覆盖六组参数的选定元素,最大误差为 $7.85\times10^{-12}$,不是每个参数都做了数值梯度检查。全部数据、权重、逐例 logits、训练曲线和日志均保存在 code/results/。
第一层四点联合效应与四个单点效应之和并不相等:种子 76 的逐例最大差约为 $3.3617$。第二层之后只有线性读出,其 logit 差效应可加,误差处于浮点精度。这个结构对照说明,组合替换必须实际运行,不能直接把热图格子相加。
失败排查与解释边界
结果完全不变时,先查 hook 是否命中、位置是否对齐、供体是否来自正确样本;结果异常完美时,检查是否替换了整个状态、答案位置或后续 logits。缓存应独立复制,权重冻结,每次扫描从相同基线重启。无替换和自身复制必须还原基线,整层恢复必须符合网络结构预期。
真实文本还要检查分词:字符数相同不保证词元数相同,词元数相同也不保证语义位置对应。多词元答案需要另设序列评分,不能随意只取首词元。local_gpt2_patch.py 会打印位置、检查单词元答案并移除 hook;当前缺少依赖和本地权重,仅通过语法检查,模型运行及示例提示均待人工核验。
恢复是特定输入对、替换集合和指标下的证据。它不会自动证明该位置是唯一存储点,也不会告诉我们上游如何写入、下游如何读取。自然输入产生的供体激活与另一输入的其余激活拼接后,仍可能形成不自然的内部状态。后续必须扩大输入覆盖并做组合、反向及路径层面的验证。
后续科研问题
第一,固定模型和输入对,只改变扰动方式,定位排序是否稳定?应同时报告基线破坏强度,避免把更强破坏造成的恢复空间解释为更重要的机制。
第二,在相同替换维数预算下,原坐标与学习到的子空间谁更稳定?子空间只能在训练或验证数据上学习,再到独立提示上比较,不能看完测试热图后挑方向。
第三,候选集合的联合恢复能否跨改写保持?先用扫描提出假设,再冻结集合做确认性实验;如果只在发现它的句子上有效,应保留失败例,而不是不断扩大集合直到恢复满分。
总结
可复现的激活替换不是一张热图,而是输入对、替换坐标、基线、指标和控制实验组成的证据链。本篇跑通了小网络的干预与审计,也明确留下真实语言模型尚未验证的部分。读者下一步应迁移这套检查协议,再讨论具体层和回路的含义。
参考资料
以下均为一手来源,检索日期为 2026-09-17,已实际打开。
- Kevin Meng、David Bau、Alex Andonian、Yonatan Belinkov. Locating and Editing Factual Associations in GPT. NeurIPS 2022;核对 arXiv v5,2023-01-13。
- Fred Zhang、Neel Nanda. Towards Best Practices of Activation Patching in Language Models: Metrics and Methods. ICLR 2024;v2,2024-01-17;全文。
- Stefan Heimersheim、Neel Nanda. How to use and interpret activation patching. 2024,v1,2024-04-23;全文。
- ROME 作者及贡献者:causal_trace.py、nethook.py,检索当日主分支。
- TransformerLens 维护者:patching.py,检索当日主分支。