开源 AI 论文复现实验与代码解读 · 第五轮 / 075
面向研究生、科研新人和工程型研究者;检索与实验日期:2026-09-16。
摘要
把知识图谱接到大语言模型之前,先问一个小问题:检索到了答案实体,是否也保留了支持答案的路径?本文阅读 G-Retriever 官方实现,再训练一个十参数的图神经网络,比较完整结构、反向边和不同证据裁剪方法。三个种子的实际结果显示,答案节点召回很高,证据阅读仍可能失败。实验只验证图消息传递与证据接口,没有运行真实语言模型,也没有复现论文榜单。
目录
- 复现价值:区分节点、路径和回答
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议与独立审计
- 失败排查与证据边界
- 后续科研问题
- 总结与参考资料
复现价值:区分节点、路径和回答
图神经网络,即 GNN,通过边传递并聚合节点信息;大语言模型,即 LLM,处理文本及其向量表示。两者结合时,图可以提供关系结构,语言模型可以解释问题和生成回答,但接口接通不代表推理可靠。节点名字相似、答案实体入选、完整证据路径存在,是三个不同条件。
设问题要求从甲出发,先沿“合作”再沿“任职”关系寻找终点。只给模型甲和终点的名字,中间人物及两条有向边可能已经丢失。此时回答正确,可能来自参数记忆;回答错误,也不能立刻归咎于语言推理能力。复现的价值,是把这些可能性拆成可检查的输入输出。
论文报告:Yasunaga 等人的 QA-GNN 在问答语境与知识图谱之间建立联合图,并通过消息传递更新表示,发表于二〇二一年 NAACL。它是语言模型与图联合推理的前驱,不等于今天的生成式聊天模型。论文页面
He 等人的 G-Retriever 面向带文本属性的图,结合子图检索、图编码和语言生成。本文使用二〇二四年五月修订的预印本第三版;官方仓库给出的会议归属是同年 NeurIPS。这里不引用跨版本成绩,也不宣称检索能消除全部幻觉。版本页;官方说明
核心思想与公式
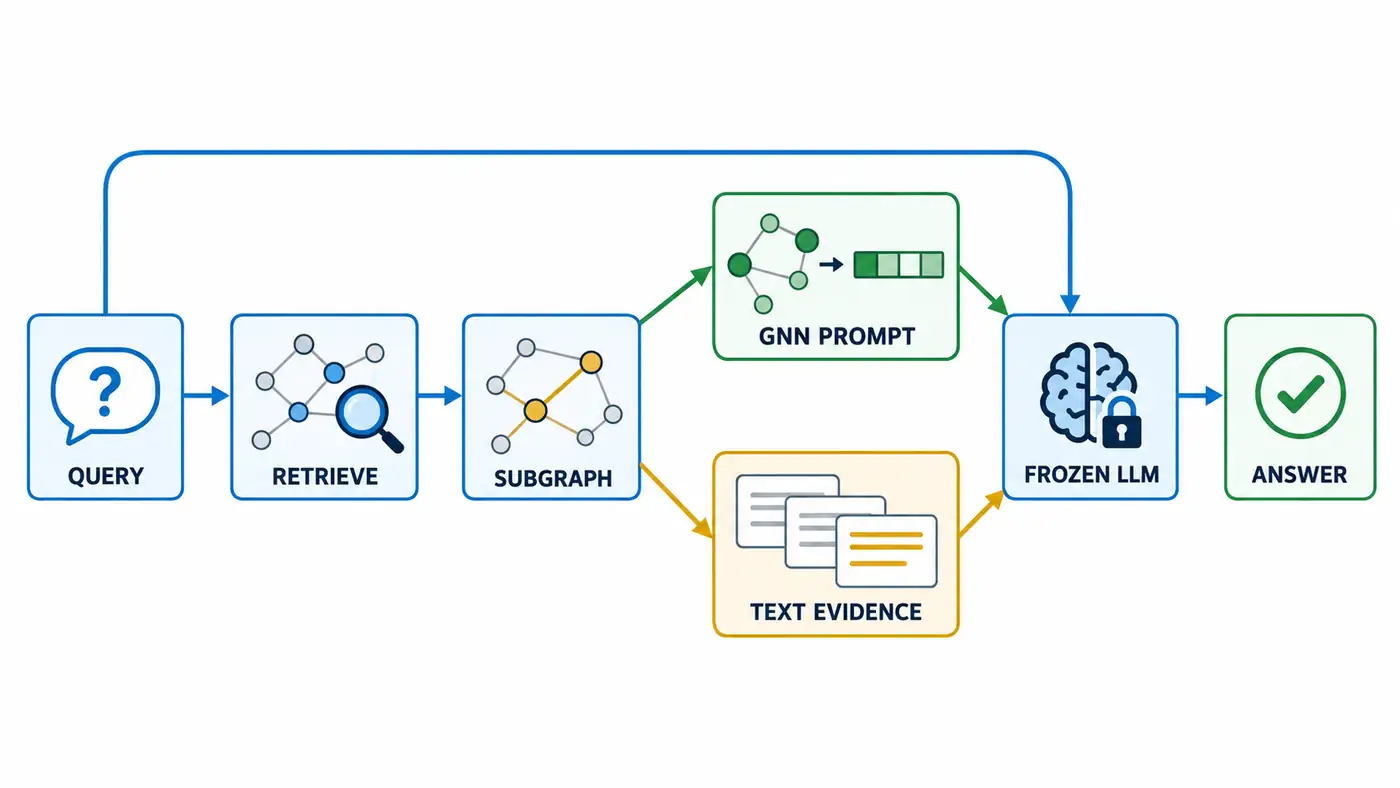
方法图表示原方法的冻结语言模型配置:同一子图分别形成图软提示和文本证据,问题也送入语言模型。软提示是连续向量,不是人工编写的句子。图中锁只表示语言模型参数冻结,图编码器和投影器仍可学习;这张图不是下方玩具实验的运行截图。
原方法将相关性与连通成本结合,用带奖赏的斯坦纳树问题选择子图。通俗地说,高相关节点值得保留,但连接它们也有代价,因此不能把检索理解成独立选出几个实体。随后图表示经投影进入语言模型的词向量空间,文本化的节点与边提供另一条证据通路。论文全文
为了隔离结构问题,本次采用两层关系门控消息传递:
$$ h^{(0)}=e_s,\qquad h^{(\ell)}=h^{(\ell-1)}\sum_{r=0}^{1}\alpha^{(\ell)}{q\ell,r}A_r, \qquad \alpha^{(\ell)}=\operatorname{softmax}_{r}(W^{(\ell)}). $$
每张图有十二个节点,$A_r$ 是形状为 $[12,12]$ 的有向邻接矩阵,行表示起点、列表示终点;$e_s$ 是源节点独热行向量。问题给出有序关系 $q_1,q_2$,两个 $W$ 都是 $[2,2]$ 的可训练参数。每层按问题关系混合两类边;两层后的 $h^{(2)}$ 是十二维加权路径计数,没有度数归一化。
$$ z_v=\exp(a)h^{(2)}v+b,\qquad \mathcal L=\frac{1}{BN}\sum{i,v}\left[\log(1+\exp z_{iv})-y_{iv}z_{iv}\right]. $$
$z_v$ 是节点属于答案集合的未归一化分数,$y$ 表示是否存在符合顺序的两跳路径,$B$ 为图数、$N=12$。标量 $a,b$ 加上八个门控参数,共十个参数。实现使用稳定的对数加法计算二元交叉熵;一个问题可以有多个答案,也可以没有答案,不能用单标签分类替代。
官方代码阅读路线
先读数据,再读模型,最后读训练循环,避免只看架构名称。
第一站是 webqsp.py。核对样本里的问题、答案、缓存图和文本描述如何按索引对应。训练、验证、测试拼接后依靠保存的索引划分,复现者必须检查缓存生成顺序是否一致;拼接本身不是泄漏证据。
第二站是 retrieval.py。节点相似度被转换为排名奖赏,边还涉及虚拟节点转换;返回时会把原节点编号重新映射到局部编号。应同时检查图结构和文本描述,防止两份证据讲的是不同实体。修改检索参数后也要重新生成缓存。
第三站对照 gnn.py 与 graph_llm.py。前者包含不同图编码器,不能假设每种实现都使用边属性;后者对节点表示均值池化、投影,再将一个图向量与文本嵌入拼接。投影输出维度写为四千零九十六,换语言模型前应核对嵌入宽度。描述会截断,图里有证据也不代表文本分支保留了它。
最后检查 train.py 的梯度清零、优化器步进和验证选模。当前代码每个批次都清零并步进,不能仅凭参数名 grad_steps 就认为实现了梯度累积。以上是静态源码核对,未运行官方环境;这些链接指向检索当日的主分支,没有锁定提交,后续兼容性待人工核验。
最小实验与实际结果
在文章目录执行:
python3 -m pip install -r code/requirements.txt
python3 code/experiment.py
python3 code/audit_results.py
本次实际使用 Python 3.12.14、NumPy 2.3.5 和 CPU。每个种子生成二百五十六张训练图、六十四张验证图、一百二十八张测试图;两类边各以概率零点一二独立采样,去除自环,源节点和问题关系随机抽取。三个种子共一千三百四十四张不同的图,节点编号只在本图内有效。
训练使用全批次 Adam,学习率零点零三,固定五百步;验证损失只记录,不选检查点、不调阈值。训练邻接张量为 [256,2,12,12],输出为 [256,12]。种子七十五的训练损失从零点三五零三降到零点零零零五四一,两层正确关系门控概率约为零点九八。完整数据、权重、曲线和逐题证据均保存在 code/results/。
本次实际验证:完整图上的答案集合完全匹配率,三个种子均为一;冻结权重后反转全部边、保持原答案不变,平均完全匹配率降到零点一三零二。移除全部边时模型输出空集,仍有零点三三五九的完全匹配率,因为测试集中确实存在空答案。后两项是输入损坏诊断,未重新训练,不能当作公平比较的独立模型。
接着按节点分数选取前三个候选,比较两种证据包。“诱导子图”只保留源节点和候选之间的边;“桥接保留”保存源节点的全部出边,以及进入候选的全部边,允许中间节点留在证据里。后者不读取答案标签,但会携带更多三元组。三元组就是“起点、关系、终点”三个字段。
阅读器是手写的确定性两跳遍历,只能从所给三元组返回候选中的终点。它不是 LLM,也没有模拟自然语言理解;这使失败可以定位到证据接口。
| 三候选证据包 | 非空题候选召回 | 答案微平均 F1 | 集合完全匹配率 | 平均三元组数 |
|---|---|---|---|---|
| 诱导子图 | 0.9312 | 0.1466 | 0.3724 | 2.43 |
| 桥接保留 | 0.9312 | 0.9256 | 0.8646 | 12.10 |
表中都是三个种子的均值。相同候选并不等于相同证据;桥接方案的增益伴随更大输入预算,不能写成同成本优势。候选增至十二个时,两种方案都恢复完整图,阅读器完全匹配率为一,属于协议上限检查。
评测协议与独立审计
微平均 F1 将全部问题的真正例、假正例和假负例合并计算,适合多答案集合。完全匹配率要求预测集合与答案集合相同,包括空集;候选召回仅对非空题计算,再逐题平均,避免把空题默认记成完美召回。主结果必须同时报告这些分母。
三个种子的波动来自重新采样图与初始化,不是置信区间。完整图高分并不意外:任务只需要两跳,模型结构恰好覆盖真实生成规则;它没有学习实体语义,也没有证明长路径泛化。训练、测试的图完全不同,仍然共享同一种图生成分布。
独立审计脚本没有导入训练脚本,使用标量循环重建全部真值和一万三千八百二十四个分数,最大差异约为一乘十的负十四次方;又重放三千零七十二条证据记录,检查候选排序、边来源、答案和指标。十个参数的有限差分梯度检查通过,同时重标节点、源节点和标签后,预测分数保持一致。排序遇到同分按编号打破,因此不宣称候选集合在同分时也置换不变。
失败排查与证据边界
种子七十五的第零题,从节点三沿两次关系零到节点十一,完整路径是“三到五到十一”。前三候选是十一、六、二,答案已经排第一,却没有中间节点五;诱导子图阅读器因此返回空集。这个案例保存在审计结果中,比一句“检索效果不佳”更能定位问题。
排查顺序应是:关系方向和类型是否正确,节点编号是否对齐,桥接节点是否被裁掉,文本化后是否截断,最后才检查生成器。若改成真实 LLM,要单独保存纯证据输入、生成文本和可验证引用;保存的本次记录把 prompt 与评分用 gold 分开,不能将整条评测记录送进模型。
作者推断:高节点召回不足以保证证据可用。本次零假正例来自阅读器只沿真实边遍历的设计,不能外推为生成模型没有幻觉。当前也未运行语义嵌入、斯坦纳树求解、图软提示训练、官方数据集或 GPU;这些完整复现环节均待人工核验。
后续科研问题
下一步先固定文本证据预算,比较纯文本、图提示、两者结合,判断新增收益来自哪里。再对证据做受控删边与同义改写:前者检验结构依赖,后者检验语言鲁棒性,不能混成一次扰动。最后增加三跳问题、关系组合外推和真实抽图噪声,分开报告节点召回、路径完整率、答案分数与引用正确率。
这些实验需要重新划分开发集,并提前冻结模型、预算和评测规则。尤其不要先观察测试错误,再挑最有利的删边方式宣布因果解释;本次桥接案例是机制诊断,不是证明某个真实语言模型采用了同样的内部推理。
总结
图增强推理的最小复现,应同时追踪候选实体、连接路径和阅读器输入。本文验证了一个具体失败机制:节点选对,路径仍可能被裁断。先建立这样的可审计接口,再接入真实 LLM,后续论文复现才有清楚的失败定位依据。
参考资料
以下一手资料均于 2026-09-16 实际打开;源码为当日主分支,非固定提交。
- Yasunaga、Ren、Bosselut、Liang、Leskovec,2021:QA-GNN: Reasoning with Language Models and Knowledge Graphs for Question Answering,NAACL。
- He、Tian、Sun、Chawla、Laurent、LeCun、Bresson、Hooi,2024:G-Retriever: Retrieval-Augmented Generation for Textual Graph Understanding and Question Answering,arXiv 第三版;全文。
- G-Retriever 作者仓库:环境与实验入口、数据接口、子图检索。
- 同一官方实现:图编码器、图与语言接口、训练与选模。