- 日期:2026-09-09
- 讀者:研究生、科研新人和工程型研究者
摘要
把權重從三十二位壓到四位,推理就會快八倍嗎?本文圍繞一個復現目標展開:在同一模型、同一測試序列上,分別驗證存儲壓縮、概率預測退化和計算開銷。我們閱讀 LLM.int8()、GPTQ、AWQ 及官方源碼,再用可回放的合成詞元模型完成真實整數打包與浮點推理。實驗觀察到文件變小,但逐次反量化讓前向變慢;這些是本機機制驗證,不是大模型論文成績。
復現價值:先說清“量化了什麼”
訓練後量化,即 PTQ,是在已有權重上降低表示精度,通常不重新訓練整個模型。W4A16 表示四位權重、十六位激活,激活是前向計算中的中間數值;它沒有承諾所有乘法都以四位執行。存儲格式、乘法輸入、累加精度和輸出精度必須分開記錄。
論文報告:Dettmers 等人的 LLM.int8() 結合逐向量尺度與混合精度分解,將異常值所在特徵維度交給高精度分支。它研究的是特定模型中異常值對計算的影響,不能簡化為“所有權重直接轉成 int8”。原論文
Frantar 等人的 GPTQ 利用近似二階信息,在量化一部分權重後補償剩餘權重。Lin 等人的 AWQ 則觀察激活,搜索通道尺度以保護重要權重。兩者都超出了直接舍入;本文實現的是便於比較的舍入基線,未實現這兩種算法。GPTQ 全文、AWQ 全文
四位也不只有整數均勻網格。NF4 是另一種四位數據類型,不能把 NF4、INT4 與“四位計算”當作同義詞。使用框架時應保存量化類型與計算 dtype,而不只記一個 load_in_4bit 開關。官方說明
核心思想與公式:舍入誤差會經過輸入放大
本次對每組權重使用對稱量化:
為位寬, 為組尺度, 為整數碼, 為恢復後的近似權重。全零組令尺度為一,避免除零。本例 INT4 使用負七到七的十五個等級;存儲時加八編碼,兩個四位碼裝入一字節,保留一個未用碼。這是刻意選擇的對稱基線,不等同於所有 INT4 格式。
若線性層寫作 ,則 形狀為 [N,d]、 為 [o,d]、輸出為 [N,o]。量化造成 ,因此相同權重均方誤差不保證相同輸出誤差。構造輸入對角陣的兩個幅值為一百和一,分別只在對應權重上加入零點一誤差,權重均方誤差都為 0.005,輸出平方誤差卻為 100 與 0.01。本次腳本實際檢查了這個反例。
組尺度也有成本。整張量共用一個尺度時,少數大幅值可能把網格間隔拉大,使小權重擠到零附近;縮小組長能局部適應範圍,卻需要保存更多尺度,並可能改變內核對齊和訪存。比較時應同時寫位寬、組長、分組軸與元數據精度,不能只把文件名中的“四位”當作實驗配置。
它解釋了為什麼校準需要輸入分佈:校準集是為估計激活或量化參數準備的數據,不應拿測試集充當。本文僅由權重絕對最大值確定尺度,無校準樣本;這既讓協議簡單,也限制了其處理敏感通道的能力。
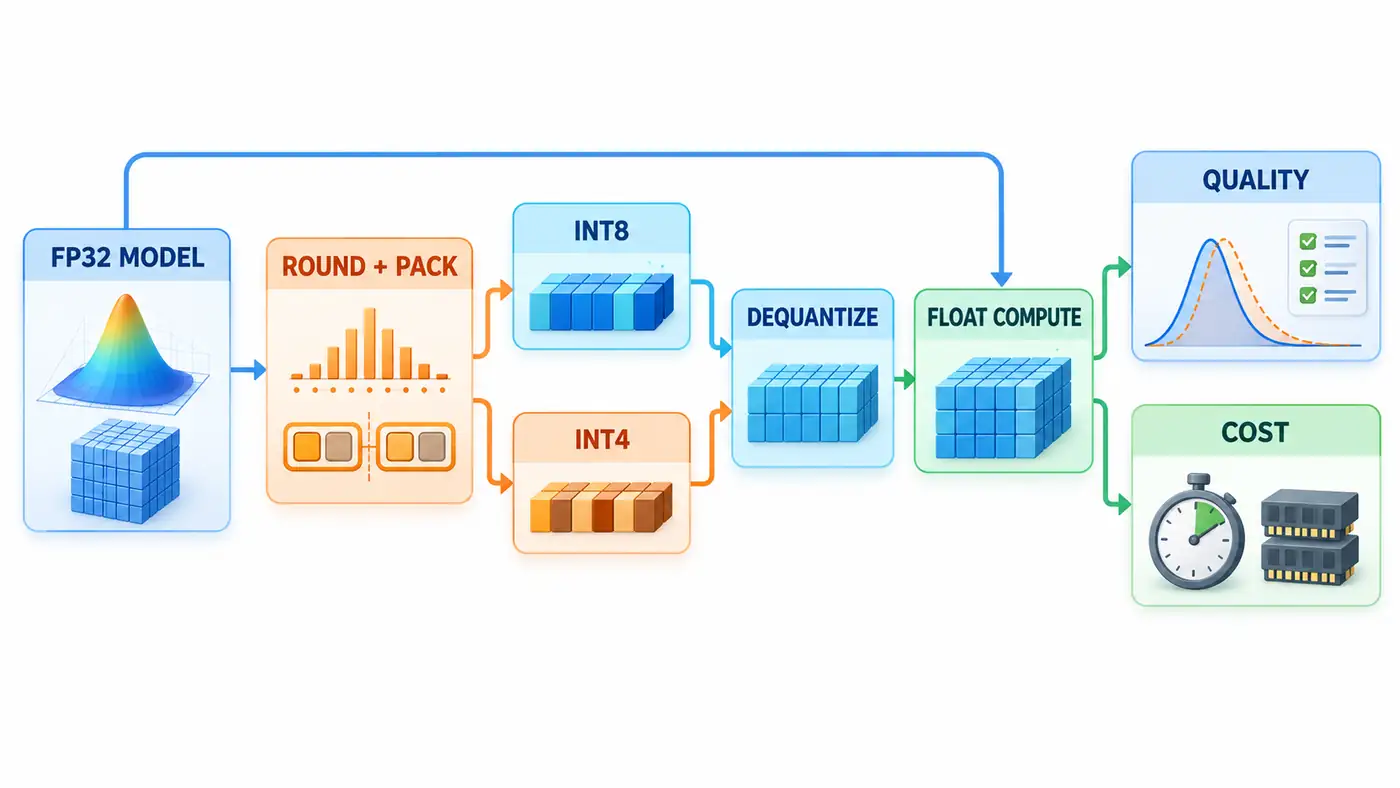
圖中藍色旁路是浮點基線,整數分支先反量化,再進入浮點計算。成本評測包括打包文件字節及前向計時;末端箭頭表示彙總測量,不表示僅在計算結束後測內存。
官方代碼閱讀路線:數值模擬與部署內核分開看
從 GPTQ 的 gptq.py 讀 add_batch,看輸入如何累積到二階統計矩陣;再讀 fasterquant 的阻尼、Cholesky 分解與逐列誤差補償。檢查組長和激活順序參數,因為它們改變量化過程。算法源碼
隨後沿 opt.py 的前向鉤子找到校準入口,再看 opt_eval 的分塊和標籤移位。理解“哪些詞元被評分”後才比較困惑度。倉庫提供的量化算法、評測腳本和底層內核是不同層次,不能只跑通算法便宣稱復現了加速。評測源碼、官方倉庫
AWQ 的 auto_scale.py 搜索候選尺度,用量化前後模塊輸出差異選取方案;這是離線搜索,並非重新訓練語言模型。quantizer.py 則清楚區分模擬量化與真實模塊替換,後者進入 WQLinear。尺度搜索、量化源碼
最後看 qmodule.py 的打包與 forward:它按輸入規模分派矩陣向量或矩陣矩陣 CUDA 路徑。低比特數據如何排列、在哪裡反量化、調用哪條內核,才連接到實際速度。本文閱讀檢索日 main,尚未鎖定提交,也未運行這些 CUDA 路徑,兼容性待人工核驗。模塊源碼
最小實驗:先訓練,再固定量化對照
code/minimal_quantization.py 使用 NumPy 訓練一個兩詞元上下文模型:詞表十六項,每個詞元嵌入八維,拼接後經過六十四維雙曲正切隱藏層,輸出十六類概率,共二千二百五十六個參數。輸入為 [B,2],輸出為 [B,16];這不是 Transformer,也沒有自然語言預訓練。
數據生成規則是以九成概率,根據前一個詞元和再前一個詞元的奇偶性產生後繼,其餘情況均勻隨機。訓練、開發、測試分別有二百五十六、六十四、一百二十八條獨立生成的序列,每條長三十四。前兩個詞元只作上下文,後面三十二個評分;完整序列沒有跨集合重複,但短上下文和規則共享,因此只檢驗同分布預測。
初始化種子固定為 68、69、70,各訓練八百步,批大小一百二十八,Adam 學習率 0.01。在預定四個檢查點用開發集負對數似然,即 NLL,選模型;三個種子均選中八百步。量化配方預先確定,測試集不參與選擇。
python3 code/minimal_quantization.py > code/smoke_test.txt
python3 code/audit_results.py
python3 -m py_compile code/minimal_quantization.py code/audit_results.py
環境與安裝步驟見 code/README.md;本次實際使用 Python 3.12.14、NumPy 2.3.5、macOS arm64 CPU。嵌入和兩層矩陣參與量化,偏置保留 FP32。G32 指按連續存儲順序展平,每三十二個值一組,可能跨行;它不等同於官方按輸入通道分組。
| 設置 | 測試困惑度均值 ± 標準差 | 模型載荷字節 |
|---|---|---|
| FP32 | 1.9580 ± 0.0141 | 9024 |
| INT8,G32 | 1.9583 ± 0.0141 | 2768 |
| INT4,每張量一組 | 1.9924 ± 0.0336 | 1420 |
| INT4,G32 | 1.9759 ± 0.0134 | 1680 |
以上為本次實際驗證。“±”是三個初始化的樣本標準差,不是置信區間。載荷包括整數權重、FP32 尺度與偏置,不含形狀清單和文件系統開銷。G32 的四位權重本體佔 1088 字節,尺度佔 272 字節,偏置佔 320 字節;所以整體壓縮比約 5.37,並非八倍。
種子六十八的單樣本前向中位數,浮點基線約 3.50 微秒;四位分組若每次解包、反量化後再算,約 22.42 微秒;提前恢復為浮點權重則約 3.71 微秒。每條路徑預熱二十次、測量一百零一次,原始樣本與九十分位數均已保存。這是微小 CPU 前向,不包括磁盤加載、採樣或完整生成循環,也不是整數內核速度。
語法檢查和 CPU smoke test 通過;獨立審計從磁盤重新解碼十二組模型,重算每組四千零九十六個詞元的 NLL,並核對字節數、困惑度和開發集選點。五類參數各一處的有限差分最大誤差約為 ,不是對所有梯度的窮舉證明。
評測協議:質量、延遲與顯存各有分母
困惑度定義為 , 是有效目標詞元的 NLL, 是目標總數。先累加損失和數量再指數化,不能平均不同長度批次的困惑度。正式語言模型應固定分詞器、文檔連接規則、上下文長度和滑窗步長;重疊部分只提供上下文,不能重複評分,計數應直接檢查移位後的有效標籤。官方評測說明
速度要分別測提示詞預填充與逐詞元解碼,並固定批量、輸入輸出長度、緩存精度、設備與軟件版本。GPU 計時需要預熱和同步,報告重複次數及分佈。AWQ 配套系統把即時反量化與內核融合結合起來;本文逐次恢復整個權重矩陣的實現缺少這種優化,不能據此判斷 AWQ 快慢。AWQ 系統部分
從本例遷移到官方實驗時,先選倉庫明確支持的模型,固定權重、分詞器與代碼版本,在量化之前跑通浮點評測。再凍結校準文檔、樣本數與截斷規則,按論文設置逐個改變位寬或組長;最後才接入部署內核。量化耗時、校準時的峰值資源與推理資源應分開報告,避免把離線準備成本藏進“加載一次即可”的表述。
顯存預算應包含量化權重、尺度和零點、未量化層、鍵值緩存及臨時工作區。鍵值緩存保存已處理詞元的注意力狀態,不會因為只量化權重自動縮小。本例沒有注意力緩存,恢復後的參數數組仍佔 9024 字節;進程還同時保留基線與中間數組,所以這個數也不是峰值內存。本機沒有執行 GPU 推理,峰值顯存與自然語言困惑度均待人工核驗。
失敗排查:優先找協議差異
若困惑度突然暴漲,先驗證打包往返、尺度順序、零點以及矩陣方向,再看是否誤量化了未支持模塊。逐層對比浮點與恢復後的輸出,可以把編碼錯誤同正常舍入誤差區分開;僅檢查文件能加載並不足夠。
若模型變小卻變慢,確認是否每步構造浮點副本、回退到通用算子,或測試規模太小而被調用開銷主導。本次確實觀察到了反量化開銷,但微秒級結果也受系統調度影響;不能把單次最快值當作穩定吞吐量。
分組也不保證每次更好。種子七十中,整張量 INT4 困惑度為 1.9561,G32 為 1.9612,與三種子均值的排序不同。權重誤差與概率損失並非一一對應,應保留逐條損失,在相同序列上做配對比較,不能只挑支持直覺的種子。
短序列中的詞元並不獨立。若要給量化前後損失差加誤差線,應先按整條序列聚合,再對序列做配對重採樣;把四千多個詞元當獨立樣本會誇大證據精度。當前三個種子共享數據切分,標準差只描述訓練初始化與抽樣變化,不代表換語料後的不確定性。原始序列和逐詞元損失已經保存,可支持後續審計。
後續科研問題
作者推斷:分組收益可能取決於組內動態範圍,也可能被不同層的敏感性抵消。下一步保持總字節預算相同,比較縮短組長、提高敏感層位寬和保留少量高精度層;否則額外尺度帶來的質量改善並非免費。
再將校準數據從同領域移到異領域,保持測試文檔隔離,比較直接舍入、GPTQ 與 AWQ 的輸出誤差和任務正確率。若困惑度接近而結構化回答退化,說明平均詞元損失遺漏了重要失敗切片;這需要真實任務證據,當前玩具模型不能回答。
總結
本次完成了從權重舍入、整數打包到獨立概率評測的可回放鏈路,驗證了體積縮小與速度提升需要分別舉證。論文給出減少量化誤差的方法,源碼展示計算路徑,而可信實驗需要同時保存位寬、尺度、評分協議和真實執行邊界。
參考資料
檢索日期:2026-09-09。正文鏈接均為實際打開的一手來源;動態代碼未鎖定提交,完整論文復現待人工核驗。
- Tim Dettmers、Mike Lewis、Younes Belkada、Luke Zettlemoyer,2022,LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale,arXiv v2,NeurIPS 2022。
- Elias Frantar、Saleh Ashkboos、Torsten Hoefler、Dan Alistarh,2023,GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,arXiv v2,ICLR 2023;預印本首發於2022。
- Ji Lin、Jiaming Tang 等,2024,AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,MLSys 2024;預印本首發於2023,本次閱讀 v6(2026修訂),HTML 正文題名另含 On-Device。
- 作者團隊,GPTQ 官方倉庫、AWQ 官方倉庫,閱讀檢索日 main,具體模塊見正文。
- Hugging Face,Bitsandbytes 量化文檔、固定長度模型困惑度評測,動態文檔。