- 系列:开源 AI 论文复现实验与代码解读|第五轮 068
- 日期:2026-09-09
- 读者:研究生、科研新人和工程型研究者
摘要
把权重从三十二位压到四位,推理就会快八倍吗?本文围绕一个复现目标展开:在同一模型、同一测试序列上,分别验证存储压缩、概率预测退化和计算开销。我们阅读 LLM.int8()、GPTQ、AWQ 及官方源码,再用可回放的合成词元模型完成真实整数打包与浮点推理。实验观察到文件变小,但逐次反量化让前向变慢;这些是本机机制验证,不是大模型论文成绩。
复现价值:先说清“量化了什么”
训练后量化,即 PTQ,是在已有权重上降低表示精度,通常不重新训练整个模型。W4A16 表示四位权重、十六位激活,激活是前向计算中的中间数值;它没有承诺所有乘法都以四位执行。存储格式、乘法输入、累加精度和输出精度必须分开记录。
论文报告:Dettmers 等人的 LLM.int8() 结合逐向量尺度与混合精度分解,将异常值所在特征维度交给高精度分支。它研究的是特定模型中异常值对计算的影响,不能简化为“所有权重直接转成 int8”。原论文
Frantar 等人的 GPTQ 利用近似二阶信息,在量化一部分权重后补偿剩余权重。Lin 等人的 AWQ 则观察激活,搜索通道尺度以保护重要权重。两者都超出了直接舍入;本文实现的是便于比较的舍入基线,未实现这两种算法。GPTQ 全文、AWQ 全文
四位也不只有整数均匀网格。NF4 是另一种四位数据类型,不能把 NF4、INT4 与“四位计算”当作同义词。使用框架时应保存量化类型与计算 dtype,而不只记一个 load_in_4bit 开关。官方说明
核心思想与公式:舍入误差会经过输入放大
本次对每组权重使用对称量化:
[ Q=2^{b-1}-1,\quad s=\max_i|w_i|/Q,\quad q_i=\operatorname{clip}(\operatorname{round}(w_i/s),-Q,Q),\quad \hat w_i=sq_i. ]
$b$ 为位宽,$s$ 为组尺度,$q_i$ 为整数码,$\hat w_i$ 为恢复后的近似权重。全零组令尺度为一,避免除零。本例 INT4 使用负七到七的十五个等级;存储时加八编码,两个四位码装入一字节,保留一个未用码。这是刻意选择的对称基线,不等同于所有 INT4 格式。
若线性层写作 $Y=XW^\top$,则 $X$ 形状为 [N,d]、$W$ 为 [o,d]、输出为 [N,o]。量化造成 $\Delta Y=X(\hat W-W)^\top$,因此相同权重均方误差不保证相同输出误差。构造输入对角阵的两个幅值为一百和一,分别只在对应权重上加入零点一误差,权重均方误差都为 0.005,输出平方误差却为 100 与 0.01。本次脚本实际检查了这个反例。
组尺度也有成本。整张量共用一个尺度时,少数大幅值可能把网格间隔拉大,使小权重挤到零附近;缩小组长能局部适应范围,却需要保存更多尺度,并可能改变内核对齐和访存。比较时应同时写位宽、组长、分组轴与元数据精度,不能只把文件名中的“四位”当作实验配置。
它解释了为什么校准需要输入分布:校准集是为估计激活或量化参数准备的数据,不应拿测试集充当。本文仅由权重绝对最大值确定尺度,无校准样本;这既让协议简单,也限制了其处理敏感通道的能力。
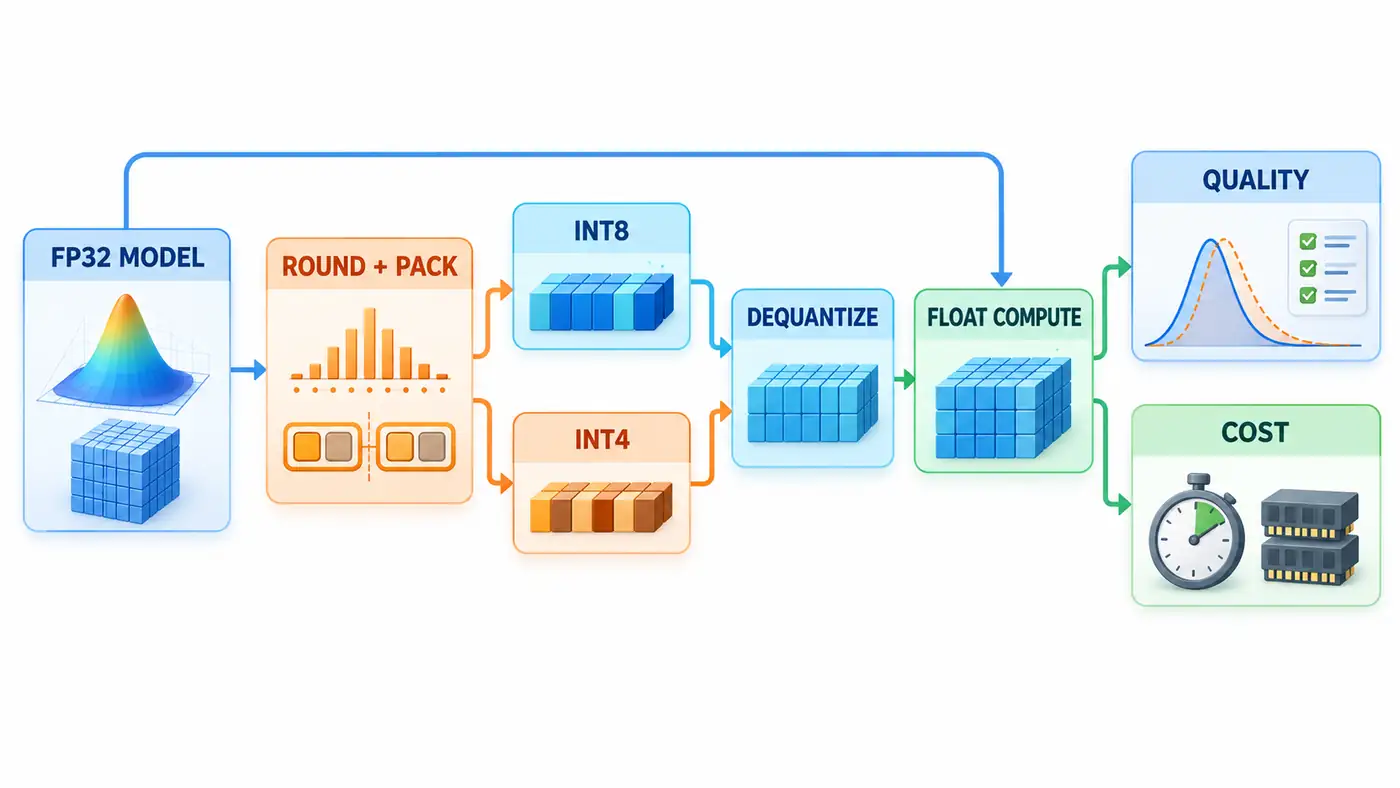
图中蓝色旁路是浮点基线,整数分支先反量化,再进入浮点计算。成本评测包括打包文件字节及前向计时;末端箭头表示汇总测量,不表示仅在计算结束后测内存。
官方代码阅读路线:数值模拟与部署内核分开看
从 GPTQ 的 gptq.py 读 add_batch,看输入如何累积到二阶统计矩阵;再读 fasterquant 的阻尼、Cholesky 分解与逐列误差补偿。检查组长和激活顺序参数,因为它们改变量化过程。算法源码
随后沿 opt.py 的前向钩子找到校准入口,再看 opt_eval 的分块和标签移位。理解“哪些词元被评分”后才比较困惑度。仓库提供的量化算法、评测脚本和底层内核是不同层次,不能只跑通算法便宣称复现了加速。评测源码、官方仓库
AWQ 的 auto_scale.py 搜索候选尺度,用量化前后模块输出差异选取方案;这是离线搜索,并非重新训练语言模型。quantizer.py 则清楚区分模拟量化与真实模块替换,后者进入 WQLinear。尺度搜索、量化源码
最后看 qmodule.py 的打包与 forward:它按输入规模分派矩阵向量或矩阵矩阵 CUDA 路径。低比特数据如何排列、在哪里反量化、调用哪条内核,才连接到实际速度。本文阅读检索日 main,尚未锁定提交,也未运行这些 CUDA 路径,兼容性待人工核验。模块源码
最小实验:先训练,再固定量化对照
code/minimal_quantization.py 使用 NumPy 训练一个两词元上下文模型:词表十六项,每个词元嵌入八维,拼接后经过六十四维双曲正切隐藏层,输出十六类概率,共二千二百五十六个参数。输入为 [B,2],输出为 [B,16];这不是 Transformer,也没有自然语言预训练。
数据生成规则是以九成概率,根据前一个词元和再前一个词元的奇偶性产生后继,其余情况均匀随机。训练、开发、测试分别有二百五十六、六十四、一百二十八条独立生成的序列,每条长三十四。前两个词元只作上下文,后面三十二个评分;完整序列没有跨集合重复,但短上下文和规则共享,因此只检验同分布预测。
初始化种子固定为 68、69、70,各训练八百步,批大小一百二十八,Adam 学习率 0.01。在预定四个检查点用开发集负对数似然,即 NLL,选模型;三个种子均选中八百步。量化配方预先确定,测试集不参与选择。
python3 code/minimal_quantization.py > code/smoke_test.txt
python3 code/audit_results.py
python3 -m py_compile code/minimal_quantization.py code/audit_results.py
环境与安装步骤见 code/README.md;本次实际使用 Python 3.12.14、NumPy 2.3.5、macOS arm64 CPU。嵌入和两层矩阵参与量化,偏置保留 FP32。G32 指按连续存储顺序展平,每三十二个值一组,可能跨行;它不等同于官方按输入通道分组。
| 设置 | 测试困惑度均值 ± 标准差 | 模型载荷字节 |
|---|---|---|
| FP32 | 1.9580 ± 0.0141 | 9024 |
| INT8,G32 | 1.9583 ± 0.0141 | 2768 |
| INT4,每张量一组 | 1.9924 ± 0.0336 | 1420 |
| INT4,G32 | 1.9759 ± 0.0134 | 1680 |
以上为本次实际验证。“±”是三个初始化的样本标准差,不是置信区间。载荷包括整数权重、FP32 尺度与偏置,不含形状清单和文件系统开销。G32 的四位权重本体占 1088 字节,尺度占 272 字节,偏置占 320 字节;所以整体压缩比约 5.37,并非八倍。
种子六十八的单样本前向中位数,浮点基线约 3.50 微秒;四位分组若每次解包、反量化后再算,约 22.42 微秒;提前恢复为浮点权重则约 3.71 微秒。每条路径预热二十次、测量一百零一次,原始样本与九十分位数均已保存。这是微小 CPU 前向,不包括磁盘加载、采样或完整生成循环,也不是整数内核速度。
语法检查和 CPU smoke test 通过;独立审计从磁盘重新解码十二组模型,重算每组四千零九十六个词元的 NLL,并核对字节数、困惑度和开发集选点。五类参数各一处的有限差分最大误差约为 $1.52\times10^{-11}$,不是对所有梯度的穷举证明。
评测协议:质量、延迟与显存各有分母
困惑度定义为 $\mathrm{PPL}=\exp(\sum_t\ell_t/M)$,$\ell_t$ 是有效目标词元的 NLL,$M$ 是目标总数。先累加损失和数量再指数化,不能平均不同长度批次的困惑度。正式语言模型应固定分词器、文档连接规则、上下文长度和滑窗步长;重叠部分只提供上下文,不能重复评分,计数应直接检查移位后的有效标签。官方评测说明
速度要分别测提示词预填充与逐词元解码,并固定批量、输入输出长度、缓存精度、设备与软件版本。GPU 计时需要预热和同步,报告重复次数及分布。AWQ 配套系统把即时反量化与内核融合结合起来;本文逐次恢复整个权重矩阵的实现缺少这种优化,不能据此判断 AWQ 快慢。AWQ 系统部分
从本例迁移到官方实验时,先选仓库明确支持的模型,固定权重、分词器与代码版本,在量化之前跑通浮点评测。再冻结校准文档、样本数与截断规则,按论文设置逐个改变位宽或组长;最后才接入部署内核。量化耗时、校准时的峰值资源与推理资源应分开报告,避免把离线准备成本藏进“加载一次即可”的表述。
显存预算应包含量化权重、尺度和零点、未量化层、键值缓存及临时工作区。键值缓存保存已处理词元的注意力状态,不会因为只量化权重自动缩小。本例没有注意力缓存,恢复后的参数数组仍占 9024 字节;进程还同时保留基线与中间数组,所以这个数也不是峰值内存。本机没有执行 GPU 推理,峰值显存与自然语言困惑度均待人工核验。
失败排查:优先找协议差异
若困惑度突然暴涨,先验证打包往返、尺度顺序、零点以及矩阵方向,再看是否误量化了未支持模块。逐层对比浮点与恢复后的输出,可以把编码错误同正常舍入误差区分开;仅检查文件能加载并不足够。
若模型变小却变慢,确认是否每步构造浮点副本、回退到通用算子,或测试规模太小而被调用开销主导。本次确实观察到了反量化开销,但微秒级结果也受系统调度影响;不能把单次最快值当作稳定吞吐量。
分组也不保证每次更好。种子七十中,整张量 INT4 困惑度为 1.9561,G32 为 1.9612,与三种子均值的排序不同。权重误差与概率损失并非一一对应,应保留逐条损失,在相同序列上做配对比较,不能只挑支持直觉的种子。
短序列中的词元并不独立。若要给量化前后损失差加误差线,应先按整条序列聚合,再对序列做配对重采样;把四千多个词元当独立样本会夸大证据精度。当前三个种子共享数据切分,标准差只描述训练初始化与抽样变化,不代表换语料后的不确定性。原始序列和逐词元损失已经保存,可支持后续审计。
后续科研问题
作者推断:分组收益可能取决于组内动态范围,也可能被不同层的敏感性抵消。下一步保持总字节预算相同,比较缩短组长、提高敏感层位宽和保留少量高精度层;否则额外尺度带来的质量改善并非免费。
再将校准数据从同领域移到异领域,保持测试文档隔离,比较直接舍入、GPTQ 与 AWQ 的输出误差和任务正确率。若困惑度接近而结构化回答退化,说明平均词元损失遗漏了重要失败切片;这需要真实任务证据,当前玩具模型不能回答。
总结
本次完成了从权重舍入、整数打包到独立概率评测的可回放链路,验证了体积缩小与速度提升需要分别举证。论文给出减少量化误差的方法,源码展示计算路径,而可信实验需要同时保存位宽、尺度、评分协议和真实执行边界。
参考资料
检索日期:2026-09-09。正文链接均为实际打开的一手来源;动态代码未锁定提交,完整论文复现待人工核验。
- Tim Dettmers、Mike Lewis、Younes Belkada、Luke Zettlemoyer,2022,LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale,arXiv v2,NeurIPS 2022。
- Elias Frantar、Saleh Ashkboos、Torsten Hoefler、Dan Alistarh,2023,GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,arXiv v2,ICLR 2023;预印本首发于2022。
- Ji Lin、Jiaming Tang 等,2024,AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,MLSys 2024;预印本首发于2023,本次阅读 v6(2026修订),HTML 正文题名另含 On-Device。
- 作者团队,GPTQ 官方仓库、AWQ 官方仓库,阅读检索日 main,具体模块见正文。
- Hugging Face,Bitsandbytes 量化文档、固定长度模型困惑度评测,动态文档。