檢索與實驗日期:2026-09-10。本文提供可運行的 NumPy 機制實驗,區分論文報告、本次實際驗證與作者推斷。
摘要
生成變快可能來自兩件不同的事:少重複計算歷史狀態,或一次目標模型調用提交多個詞元。本文把 KV Cache(鍵值緩存)和 speculative decoding(推測解碼)放進同一個小型因果解碼器,先檢查數值、概率和緩存狀態,再計時。實際結果既包含緩存帶來的耗時下降,也包含不合適草稿造成的變慢。讀者最終應能回答:程序究竟省下了什麼,又為猜錯付出了什麼?
目錄
- 復現價值與證據邊界
- 核心思想與公式
- 官方代碼閱讀路線
- 最小實驗與實際結果
- 評測協議
- 失敗排查
- 後續科研問題
- 總結與參考資料
復現價值:把正確性拆成三個問題
第一個問題是緩存與完整前綴重算的 logits 是否相同。Logits 是歸一化前的詞表分數;只比較最終詞元,可能掩蓋還沒改變最大值位置的數值錯誤。第二個問題是批量驗證的條件前綴是否正確。第三個問題是拒絕草稿後,採樣規則和兩套緩存能否共同恢復到已提交歷史。
**論文報告:**Leviathan、Kalman、Matias 的 ICML 2023 論文用廉價草稿構造候選,再由目標模型並行評分,通過接受規則保持目標分佈。其特定 T5-XXL 實驗報告約二至三倍加速;這依賴論文的模型、實現與硬件,本文不復現該數字。會議頁面
**本次實際驗證:**未訓練的小模型只承擔機制檢查,沒有自然語言準確率、困惑度或大模型吞吐結論。**作者推斷:**科研新人先獲得可定位的錯誤,比先得到一行速度比更有價值;否則算法錯誤可能被當成優化收益。
核心思想與公式:緩存歷史,驗證未來
緩存保存什麼
因果注意力只允許當前位置讀取自身及過去。固定模型和位置規則後,後續詞元不會改變過去的鍵和值,因此每層可以保留它們。Prefill 指首次處理提示詞;decode 指之後逐步產生新詞元。官方緩存解釋
對新增塊可寫成:
這裡省略批和頭維;新增輸入有 行,歷史有 行,注意力分數形狀是 [m,T+m]。 是每頭寬度, 把未來位置置為負無窮。單步雖不再重算曆史投影,仍須讀取歷史鍵值;分塊驗證也必須保持塊內因果遮罩。
由緩存數組形狀直接計數,標準全長緩存的有效載荷為:
為層數, 為批大小, 為鍵值頭數, 為每元素字節數,前面的二代表鍵和值。這是數組載荷預算,未包含模型、臨時分數矩陣、分配器和草稿緩存。本實驗單層鍵張量為 [2,29,8],省略大小為一的批維;兩層、雙精度共 14848 字節,與實際數組計數一致。
接受草稿為什麼不能隨意回退
令 為目標分佈, 為草稿分佈,均對應同一個已接受前綴。先從 抽取候選 ,再按下式接受;首次拒絕時從殘差分佈抽取修正詞元:
是詞表項,方括號取正部;被草稿抽到的項必有正的 。這裡的 是經過實際採樣變換後的歸一化概率。Chen 等人的獨立同期工作同樣使用修正拒絕採樣;浮點實現還受硬件數值精度約束。論文全文
本文用三項分佈作直觀演算:、,接受部分的概率質量為 (0.1,0.2,0.1),剩餘質量應補到後兩項。若拒絕後直接從原始 重抽,第一項會再次得到概率,最終成為 (0.16,0.56,0.28),已偏離目標。這是隨代碼驗證的具體反例。
草稿連續生成 項,目標一次前向取得 組條件概率。從左到右接受到首次拒絕為止;其後候選全部作廢。若全部接受,則再從最後一組目標概率抽取一個額外詞元。分佈相同不要求不同算法在同一隨機種子下產生逐字相同的樣本。算法一
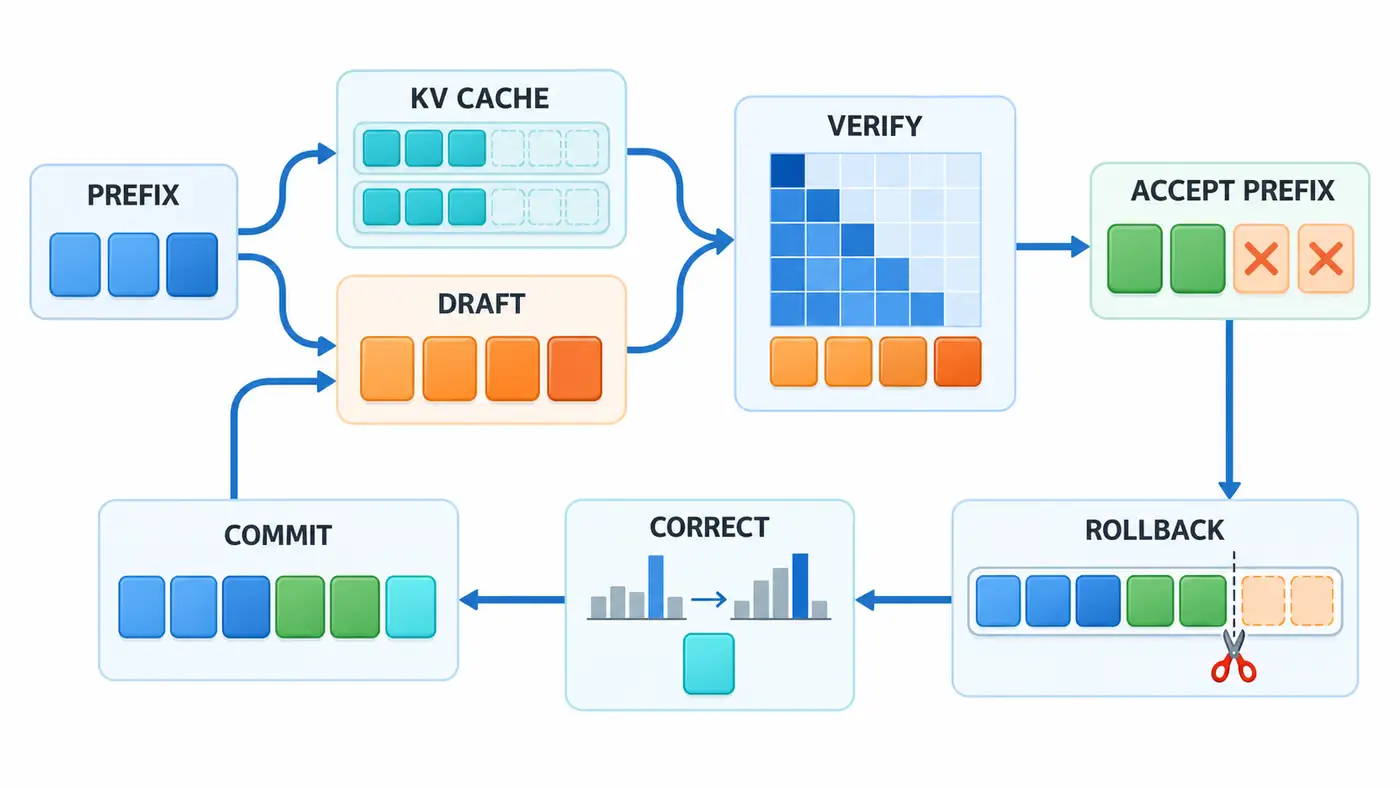
圖只展示首次拒絕分支:兩個綠色候選留下,兩個橙色後綴丟棄,補上一個青色詞元。三角網格是因果關係示意,不對應實驗的精確矩陣尺寸。提交詞元不代表其鍵值已計算完成;下一輪仍需處理尚未入緩存的尾部。
官方代碼閱讀路線:沿狀態變化讀
本文固定閱讀 Transformers v4.57.1 標籤,避免把當前主分支接口寫成永恆規則。它是官方框架實現,不冒稱原論文作者發佈的實驗代碼;本次沒有運行該框架或下載預訓練權重。
先在 generation/utils.py 找 _assisted_decoding,串起候選生成、取最後若干 logits、接受判斷和 crop(new_cur_len - 1)。再看 _speculative_sampling 中的概率比與正部歸一化;重點追蹤“哪一行預測哪一個候選”。該版本入口限制批大小為一,並排除部分靜態緩存路徑。生成源碼
隨後讀 candidate_generator.py 的 get_candidates 與 _update_past_and_masks。草稿狀態有自己的緩存、長度和遮罩,不能只修改目標模型。比較輸入長度、緩存長度和新增詞元數,有助於理解為何代碼中出現減一及額外裁剪。候選源碼
最後讀 cache_utils.py 的 DynamicLayer.update/crop:新增鍵值沿序列軸拼接,裁剪保留有效前綴。滑動窗口已經丟棄的狀態不能靠切片復原,該版本對此有顯式限制。這是實際實現的適用邊界。緩存源碼
若繼續接入預訓練模型,再核對官方生成策略文檔裡的 assistant 配置和分詞器條件;模型版本、設備兼容及真實任務表現均待人工核驗。生成策略
最小實驗:從數組到完整生成循環
code/minimal_decode.py 只依賴 NumPy。目標為兩層、草稿為一層;寬度十六、兩頭、前饋寬度三十二、詞表八項,採用歸一化前置結構、絕對位置向量與雙曲正切前饋層。兩者共享初始化規則的前段,但輸出頭不同;所有權重保持隨機初始化,不訓練。輸入是整數詞元,無分詞器、填充或結束符。
從本文目錄執行:
python3 -m pip install -r code/requirements.txt
python3 code/minimal_decode.py > code/smoke_test.txt
python3 -m py_compile code/minimal_decode.py code/audit_results.py
python3 code/audit_results.py
安裝行供讀者準備環境,本次使用已有 Python 3.12.14、NumPy 2.3.5,在 macOS arm64 CPU 執行。默認寫入腳本目錄,保留新一輪結果可指定 --out,審計時傳相同目錄。
第一組把二十九項序列拆成長度三、一、七、二、十六的塊。分塊 logits 與全量前向最大差異為 1.11e-15;替換末項沒有改變此前位置輸出。第二組固定八項提示,續寫四十八項,三種初始化種子與三種草稿長度組成九組對照:完整重算、緩存貪心和推測貪心的詞元完全一致。每輪還用完整前向重新核對驗證 logits 和裁剪後的兩套緩存。
第三組以溫度一進行隨機推測採樣,三個種子均通過逐輪狀態檢查;同分布草稿另測全接受和額外詞元分支。獨立三項分佈實驗抽樣二十萬次,正確實現頻率為 (0.099175,0.601680,0.299145);與目標的總變差距離為 0.00168,錯誤回退為 0.05903。總變差是各項概率絕對差之和的一半。代碼同時精確檢查相同分佈、不相交支持集和零概率項;有限抽樣只提供診斷證據,不能取代一般性證明。
評測協議:結果與成本分開報告
下表是種子六十九、同一提示和四十八項貪心輸出的實測。每條路徑預熱一次,再重複七次取中位數;完整循環含預填充、草稿、採樣和緩存複製,不含模型初始化、磁盤寫入與額外審計前向。
| 路徑 | 中位耗時 ms | 目標調用 | 草稿調用 | 目標層內投影位置總數 |
|---|---|---|---|---|
| 完整前綴重算 | 7.93 | 48 | 0 | 3024 |
| 僅鍵值緩存 | 4.54 | 48 | 0 | 110 |
| 緩存加四項推測 | 15.99 | 48 | 179 | 464 |
最後一列逐層累計處理的位置,不能當作浮點運算量。該草稿提出一百七十八項,實際僅接受一項;四十七輪目標驗證之外,還有一次預填充,所以目標調用沒有減少。它給出具體失敗原因:草稿算得多、保留得少,還引入額外分數矩陣和複製。
接受率必須聲明分母。種子七十一、四項草稿時,接受三十五項、提出四十九項、實際檢查三十九項;“接受/提出”和“接受/檢查”回答不同問題。論文式性能估算還依賴接受過程與計算並行性的假設,不能由一個百分比直接推出端到端時間。本文僅報告本機短序列觀測,七次重複不構成跨硬件置信區間。
失敗排查:讓錯誤有可見信號
如果貪心相同但 logits 不同,先查位置偏移、歸一化和遮罩;若替換末項會影響過去輸出,說明存在未來信息洩漏。若只在首次拒絕後出錯,打印裁剪前後長度,並核對下一次輸入的尾部。腳本目標緩存保留到已提交序列倒數第二項,非終止輪草稿有時還少一項,由下一輪補齊。
輸出預算只剩一項時,程序不再生成草稿,直接提交目標詞元。因此終止輪草稿緩存可以更短,不必為已經結束的生成補算。獨立審計曾用非終止輪的長度規則檢查此處而失敗;修正為逐輪追蹤實際有效前綴後通過。檢查不變量時也要明確它在哪些邊界成立。
如果頻率偏離目標,先用上述三項反例查殘差歸一化,不要先增加樣本量。首輪開發檢查曾把錯誤回退的距離閾值誤設為大於 0.1;解析計算說明它應為 0.06,因此改為核對解析錯誤分佈,並要求實測大於 0.04。這是測試閾值修正,未改動採樣算法;失敗和修正均記錄在驗證說明中。
如果顯存或耗時不降,區分有效載荷和峰值。NumPy 裁剪使用複製,以免切片保留被拒絕後綴的底層內存;代價也計入耗時。腳本未測進程峰值或 GPU 顯存,不能把緩存字節數寫成峰值佔用。結束符、批處理、旋轉位置編碼及低精度舍入目前均未驗證。
後續科研問題
**作者推斷:**可先研究“草稿該寫多長”,在開發集上根據每輪接受長度和真實耗時選策略,再固定到測試集。對照必須包含恆定長度及不使用草稿,記錄提前停止所節省的計算,而非只展示最高接受率。
另一個問題是成本來自哪裡。固定目標模型和輸出預算,分別改變提示長度、草稿大小及緩存複製方式,拆開預填充與續寫耗時;再檢查省下的調用是否被更大的驗證塊抵消。最後才遷移到公開預訓練模型與固定任務集合,補充多提示重複、結束符邊界和隨機採樣分佈診斷。這些是待執行研究計劃,並非本文實驗發現。
總結
可靠復現應同時守住數值、分佈與狀態三個不變量。本次小實驗驗證了緩存和推測解碼機制,也保留了一組明顯變慢的對照。讀者可以從失敗輪日誌入手,說明每個候選為何被保留或丟棄,再判斷增加的計算是否值得。
參考資料
以下一手資料均於 2026-09-10 實際打開;框架源碼固定 v4.57.1,未宣稱使用最新版本。
- Yaniv Leviathan、Matan Kalman、Yossi Matias,2023,Fast Inference from Transformers via Speculative Decoding,ICML,PMLR 202:19274–19286。會議頁;出版版全文。
- Charlie Chen、Sebastian Borgeaud、Geoffrey Irving、Jean-Baptiste Lespiau、Laurent Sifre、John Jumper,2023,Accelerating Large Language Model Decoding with Speculative Sampling,arXiv:2302.01318 v1。題錄與版本;全文。
- Hugging Face Transformers contributors,v4.57.1,Caching。文檔。
- Hugging Face Transformers contributors,v4.57.1,Generation strategies。文檔。
- Hugging Face Transformers contributors,v4.57.1,生成循環、候選生成與緩存實現。utils.py;candidate_generator.py;cache_utils.py。