开源 AI 论文复现实验与代码解读 · 第五轮 · 069 检索与实验日期:2026-09-10。本文提供可运行的 NumPy 机制实验,区分论文报告、本次实际验证与作者推断。
摘要
生成变快可能来自两件不同的事:少重复计算历史状态,或一次目标模型调用提交多个词元。本文把 KV Cache(键值缓存)和 speculative decoding(推测解码)放进同一个小型因果解码器,先检查数值、概率和缓存状态,再计时。实际结果既包含缓存带来的耗时下降,也包含不合适草稿造成的变慢。读者最终应能回答:程序究竟省下了什么,又为猜错付出了什么?
目录
- 复现价值与证据边界
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议
- 失败排查
- 后续科研问题
- 总结与参考资料
复现价值:把正确性拆成三个问题
第一个问题是缓存与完整前缀重算的 logits 是否相同。Logits 是归一化前的词表分数;只比较最终词元,可能掩盖还没改变最大值位置的数值错误。第二个问题是批量验证的条件前缀是否正确。第三个问题是拒绝草稿后,采样规则和两套缓存能否共同恢复到已提交历史。
**论文报告:**Leviathan、Kalman、Matias 的 ICML 2023 论文用廉价草稿构造候选,再由目标模型并行评分,通过接受规则保持目标分布。其特定 T5-XXL 实验报告约二至三倍加速;这依赖论文的模型、实现与硬件,本文不复现该数字。会议页面
**本次实际验证:**未训练的小模型只承担机制检查,没有自然语言准确率、困惑度或大模型吞吐结论。**作者推断:**科研新人先获得可定位的错误,比先得到一行速度比更有价值;否则算法错误可能被当成优化收益。
核心思想与公式:缓存历史,验证未来
缓存保存什么
因果注意力只允许当前位置读取自身及过去。固定模型和位置规则后,后续词元不会改变过去的键和值,因此每层可以保留它们。Prefill 指首次处理提示词;decode 指之后逐步产生新词元。官方缓存解释
对新增块可写成:
$$ K'=[K;XW_K],\quad V'=[V;XW_V],\quad O=\operatorname{softmax}(QK'^\top/\sqrt{d_h}+M)V'. $$
这里省略批和头维;新增输入有 $m$ 行,历史有 $T$ 行,注意力分数形状是 [m,T+m]。$d_h$ 是每头宽度,$M$ 把未来位置置为负无穷。单步虽不再重算历史投影,仍须读取历史键值;分块验证也必须保持块内因果遮罩。
由缓存数组形状直接计数,标准全长缓存的有效载荷为:
$$ \text{bytes}=2LBH_{kv}Td_hs. $$
$L$ 为层数,$B$ 为批大小,$H_{kv}$ 为键值头数,$s$ 为每元素字节数,前面的二代表键和值。这是数组载荷预算,未包含模型、临时分数矩阵、分配器和草稿缓存。本实验单层键张量为 [2,29,8],省略大小为一的批维;两层、双精度共 14848 字节,与实际数组计数一致。
接受草稿为什么不能随意回退
令 $p$ 为目标分布,$q$ 为草稿分布,均对应同一个已接受前缀。先从 $q$ 抽取候选 $x$,再按下式接受;首次拒绝时从残差分布抽取修正词元:
$$ a(x)=\min(1,p(x)/q(x)),\qquad r(x)=\frac{[p(x)-q(x)]+}{\sum_y[p(y)-q(y)]+}. $$
$x,y$ 是词表项,方括号取正部;被草稿抽到的项必有正的 $q(x)$。这里的 $p,q$ 是经过实际采样变换后的归一化概率。Chen 等人的独立同期工作同样使用修正拒绝采样;浮点实现还受硬件数值精度约束。论文全文
本文用三项分布作直观演算:$p=(0.1,0.6,0.3)$、$q=(0.7,0.2,0.1)$,接受部分的概率质量为 (0.1,0.2,0.1),剩余质量应补到后两项。若拒绝后直接从原始 $p$ 重抽,第一项会再次得到概率,最终成为 (0.16,0.56,0.28),已偏离目标。这是随代码验证的具体反例。
草稿连续生成 $\gamma$ 项,目标一次前向取得 $\gamma+1$ 组条件概率。从左到右接受到首次拒绝为止;其后候选全部作废。若全部接受,则再从最后一组目标概率抽取一个额外词元。分布相同不要求不同算法在同一随机种子下产生逐字相同的样本。算法一
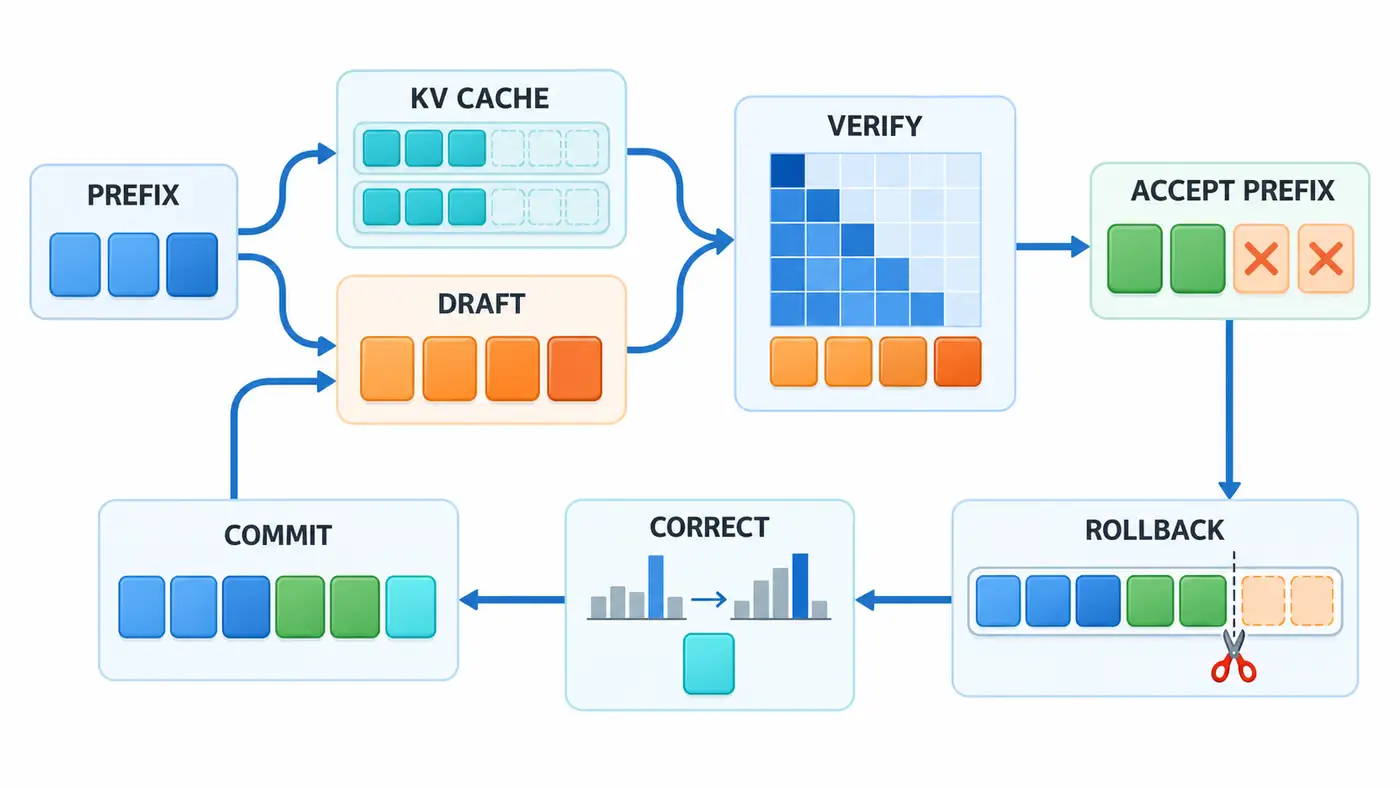
图只展示首次拒绝分支:两个绿色候选留下,两个橙色后缀丢弃,补上一个青色词元。三角网格是因果关系示意,不对应实验的精确矩阵尺寸。提交词元不代表其键值已计算完成;下一轮仍需处理尚未入缓存的尾部。
官方代码阅读路线:沿状态变化读
本文固定阅读 Transformers v4.57.1 标签,避免把当前主分支接口写成永恒规则。它是官方框架实现,不冒称原论文作者发布的实验代码;本次没有运行该框架或下载预训练权重。
先在 generation/utils.py 找 _assisted_decoding,串起候选生成、取最后若干 logits、接受判断和 crop(new_cur_len - 1)。再看 _speculative_sampling 中的概率比与正部归一化;重点追踪“哪一行预测哪一个候选”。该版本入口限制批大小为一,并排除部分静态缓存路径。生成源码
随后读 candidate_generator.py 的 get_candidates 与 _update_past_and_masks。草稿状态有自己的缓存、长度和遮罩,不能只修改目标模型。比较输入长度、缓存长度和新增词元数,有助于理解为何代码中出现减一及额外裁剪。候选源码
最后读 cache_utils.py 的 DynamicLayer.update/crop:新增键值沿序列轴拼接,裁剪保留有效前缀。滑动窗口已经丢弃的状态不能靠切片复原,该版本对此有显式限制。这是实际实现的适用边界。缓存源码
若继续接入预训练模型,再核对官方生成策略文档里的 assistant 配置和分词器条件;模型版本、设备兼容及真实任务表现均待人工核验。生成策略
最小实验:从数组到完整生成循环
code/minimal_decode.py 只依赖 NumPy。目标为两层、草稿为一层;宽度十六、两头、前馈宽度三十二、词表八项,采用归一化前置结构、绝对位置向量与双曲正切前馈层。两者共享初始化规则的前段,但输出头不同;所有权重保持随机初始化,不训练。输入是整数词元,无分词器、填充或结束符。
从本文目录执行:
python3 -m pip install -r code/requirements.txt
python3 code/minimal_decode.py > code/smoke_test.txt
python3 -m py_compile code/minimal_decode.py code/audit_results.py
python3 code/audit_results.py
安装行供读者准备环境,本次使用已有 Python 3.12.14、NumPy 2.3.5,在 macOS arm64 CPU 执行。默认写入脚本目录,保留新一轮结果可指定 --out,审计时传相同目录。
第一组把二十九项序列拆成长度三、一、七、二、十六的块。分块 logits 与全量前向最大差异为 1.11e-15;替换末项没有改变此前位置输出。第二组固定八项提示,续写四十八项,三种初始化种子与三种草稿长度组成九组对照:完整重算、缓存贪心和推测贪心的词元完全一致。每轮还用完整前向重新核对验证 logits 和裁剪后的两套缓存。
第三组以温度一进行随机推测采样,三个种子均通过逐轮状态检查;同分布草稿另测全接受和额外词元分支。独立三项分布实验抽样二十万次,正确实现频率为 (0.099175,0.601680,0.299145);与目标的总变差距离为 0.00168,错误回退为 0.05903。总变差是各项概率绝对差之和的一半。代码同时精确检查相同分布、不相交支持集和零概率项;有限抽样只提供诊断证据,不能取代一般性证明。
评测协议:结果与成本分开报告
下表是种子六十九、同一提示和四十八项贪心输出的实测。每条路径预热一次,再重复七次取中位数;完整循环含预填充、草稿、采样和缓存复制,不含模型初始化、磁盘写入与额外审计前向。
| 路径 | 中位耗时 ms | 目标调用 | 草稿调用 | 目标层内投影位置总数 |
|---|---|---|---|---|
| 完整前缀重算 | 7.93 | 48 | 0 | 3024 |
| 仅键值缓存 | 4.54 | 48 | 0 | 110 |
| 缓存加四项推测 | 15.99 | 48 | 179 | 464 |
最后一列逐层累计处理的位置,不能当作浮点运算量。该草稿提出一百七十八项,实际仅接受一项;四十七轮目标验证之外,还有一次预填充,所以目标调用没有减少。它给出具体失败原因:草稿算得多、保留得少,还引入额外分数矩阵和复制。
接受率必须声明分母。种子七十一、四项草稿时,接受三十五项、提出四十九项、实际检查三十九项;“接受/提出”和“接受/检查”回答不同问题。论文式性能估算还依赖接受过程与计算并行性的假设,不能由一个百分比直接推出端到端时间。本文仅报告本机短序列观测,七次重复不构成跨硬件置信区间。
失败排查:让错误有可见信号
如果贪心相同但 logits 不同,先查位置偏移、归一化和遮罩;若替换末项会影响过去输出,说明存在未来信息泄漏。若只在首次拒绝后出错,打印裁剪前后长度,并核对下一次输入的尾部。脚本目标缓存保留到已提交序列倒数第二项,非终止轮草稿有时还少一项,由下一轮补齐。
输出预算只剩一项时,程序不再生成草稿,直接提交目标词元。因此终止轮草稿缓存可以更短,不必为已经结束的生成补算。独立审计曾用非终止轮的长度规则检查此处而失败;修正为逐轮追踪实际有效前缀后通过。检查不变量时也要明确它在哪些边界成立。
如果频率偏离目标,先用上述三项反例查残差归一化,不要先增加样本量。首轮开发检查曾把错误回退的距离阈值误设为大于 0.1;解析计算说明它应为 0.06,因此改为核对解析错误分布,并要求实测大于 0.04。这是测试阈值修正,未改动采样算法;失败和修正均记录在验证说明中。
如果显存或耗时不降,区分有效载荷和峰值。NumPy 裁剪使用复制,以免切片保留被拒绝后缀的底层内存;代价也计入耗时。脚本未测进程峰值或 GPU 显存,不能把缓存字节数写成峰值占用。结束符、批处理、旋转位置编码及低精度舍入目前均未验证。
后续科研问题
**作者推断:**可先研究“草稿该写多长”,在开发集上根据每轮接受长度和真实耗时选策略,再固定到测试集。对照必须包含恒定长度及不使用草稿,记录提前停止所节省的计算,而非只展示最高接受率。
另一个问题是成本来自哪里。固定目标模型和输出预算,分别改变提示长度、草稿大小及缓存复制方式,拆开预填充与续写耗时;再检查省下的调用是否被更大的验证块抵消。最后才迁移到公开预训练模型与固定任务集合,补充多提示重复、结束符边界和随机采样分布诊断。这些是待执行研究计划,并非本文实验发现。
总结
可靠复现应同时守住数值、分布与状态三个不变量。本次小实验验证了缓存和推测解码机制,也保留了一组明显变慢的对照。读者可以从失败轮日志入手,说明每个候选为何被保留或丢弃,再判断增加的计算是否值得。
参考资料
以下一手资料均于 2026-09-10 实际打开;框架源码固定 v4.57.1,未宣称使用最新版本。
- Yaniv Leviathan、Matan Kalman、Yossi Matias,2023,Fast Inference from Transformers via Speculative Decoding,ICML,PMLR 202:19274–19286。会议页;出版版全文。
- Charlie Chen、Sebastian Borgeaud、Geoffrey Irving、Jean-Baptiste Lespiau、Laurent Sifre、John Jumper,2023,Accelerating Large Language Model Decoding with Speculative Sampling,arXiv:2302.01318 v1。题录与版本;全文。
- Hugging Face Transformers contributors,v4.57.1,Caching。文档。
- Hugging Face Transformers contributors,v4.57.1,Generation strategies。文档。
- Hugging Face Transformers contributors,v4.57.1,生成循环、候选生成与缓存实现。utils.py;candidate_generator.py;cache_utils.py。