檢索與實驗日期:2026-09-11。本文提供可運行的 CPU 機制實驗,區分論文報告、本次實際驗證與作者推斷。
摘要
訓練日誌中的輔助損失下降,專家就一定工作正常嗎?本文從 Switch Transformer 的單專家路由出發,用三十二個參數的混合專家模型,把軟概率、離散選擇、容量截斷和任務誤差拆開檢查。最小實驗既展示“損失等於一但全部選擇同一專家”的反例,也記錄九組實際訓練。目標是讓讀者能解釋一張路由熱力表,而不只是畫出顏色好看的圖。
目錄
- 復現價值與證據邊界
- 核心思想與公式
- 官方代碼閱讀路線
- 最小實驗與實際結果
- 評測協議
- 失敗排查
- 後續科研問題
- 總結與參考資料
復現價值:先知道自己在數什麼
MoE,即 Mixture of Experts(混合專家),讓輸入只調用部分專家參數。這裡的“專家”是一組可訓練函數,並不自動等於數學、編程或某個語種的知識模塊。Router(路由器)依據輸入給專家打分;top-1 表示每個 token 只選擇分數最高的一位。Token 在本文實驗裡是一行合成特徵,不是自然語言詞元。
**論文報告:**Fedus、Zoph、Shazeer 的 Switch Transformers 發表於 JMLR 2022,研究以單專家路由擴展稀疏模型,並討論容量、通信與訓練穩定性。論文的預訓練加速結論依賴其模型和計算條件,不能從激活專家數直接推導本機速度。論文頁面
**本次實際驗證:**訓練的是單層、標量輸出的合成迴歸模型;沒有預訓練權重、語言任務或分佈式通信。**作者推斷:**對科研新人而言,先復現“選擇是否正確、溢出如何統計、梯度流向哪裡”,比先復刻大模型參數量更容易得到可信證據。
核心思想與公式:三種負載不能混為一談
令輸入為 ,路由參數為 ,則:
是路由組內 token 數, 是輸入維度, 是專家數。 是歸一化前分數, 的形狀為 [T,E],每行和為一; 是長度為 的整數向量。本實驗分別取六十四、四、四,輸入最後一列恆為一,使路由器能夠學習偏置。
先數容量限制前的選擇比例,再統計平均概率:
是硬選擇頻率, 是軟概率質量,均為長度 的向量。反向傳播通過 ,不通過離散的 。本文把係數 放在總損失外層;原文公式四把係數寫進輔助項,比較日誌時必須確認是否已經乘過。Switch 正文公式四至六
當兩向量都均勻時,未加權的 ;但反過來不成立。把六十四行概率都設成 (0.25,0.25,0.25,0.25),代碼的並列規則全部選第零位,於是 ,損失仍為一。這是代入公式得到並實際執行的反例,不是對訓練最終狀態的假設。NumPy 明確規定並列最大值返回第一次出現的位置。argmax 文檔
容量 限制每個專家實際接收多少 token, 是容量係數,向上取整是本文的實現約定。設 表示是否被接收,本實驗輸出為:
是第 個線性專家;第一項是固定殘差路徑。溢出時僅跳過專家分支,樣本仍參與任務誤差。容量截斷後的接收計數之和可能小於 ,不能冒充前面的選擇頻率。
ST-MoE 另提出 router z-loss,本文寫為 。變量仍是路由分數矩陣;它懲罰對數歸一化常數,論文用它研究數值穩定性。它不是“專家均衡”的另一種寫法,也不等價於給每個分數逐項做平方懲罰。ST-MoE 全文第三節
官方代碼閱讀路線:追蹤掩碼的生命週期
先讀原論文指向的 Mesh TensorFlow moe.py,從 _switch_gating 依次定位概率、單專家選擇、density_1、density_1_proxy 和累計位置。輔助負載項先計算,之後才按容量修改掩碼。其主分支是本次訪問的快照,未固定提交;需要逐位復現實驗時,應另存提交號。作者代碼
再讀固定 v4.57.1 標籤的 Transformers 實現,這是官方框架移植,並非作者的原始訓練程序。沿 SwitchTransformersTop1Router.forward 查看 argmax、cumsum 與容量掩碼;這裡按序列位置累計,沒有執行類註釋所說的按概率排序。讀源碼時應核對實際運算,而不只轉述註釋。
隨後追蹤 SwitchTransformersSparseMLP.forward:它對截斷後的 router_mask 再取 argmax,全零溢出行會得到零號索引。若把這個返回值直接當作原始選擇,日誌可能混入錯誤計數。本文用“原本全選二號”的構造檢查了這種信息損失;這不是宣稱運行了完整框架。另需留意 _unpack_router_logits 會沿序列維拼接層的記錄,診斷單層失衡時應在拼接前取數據。固定版本源碼
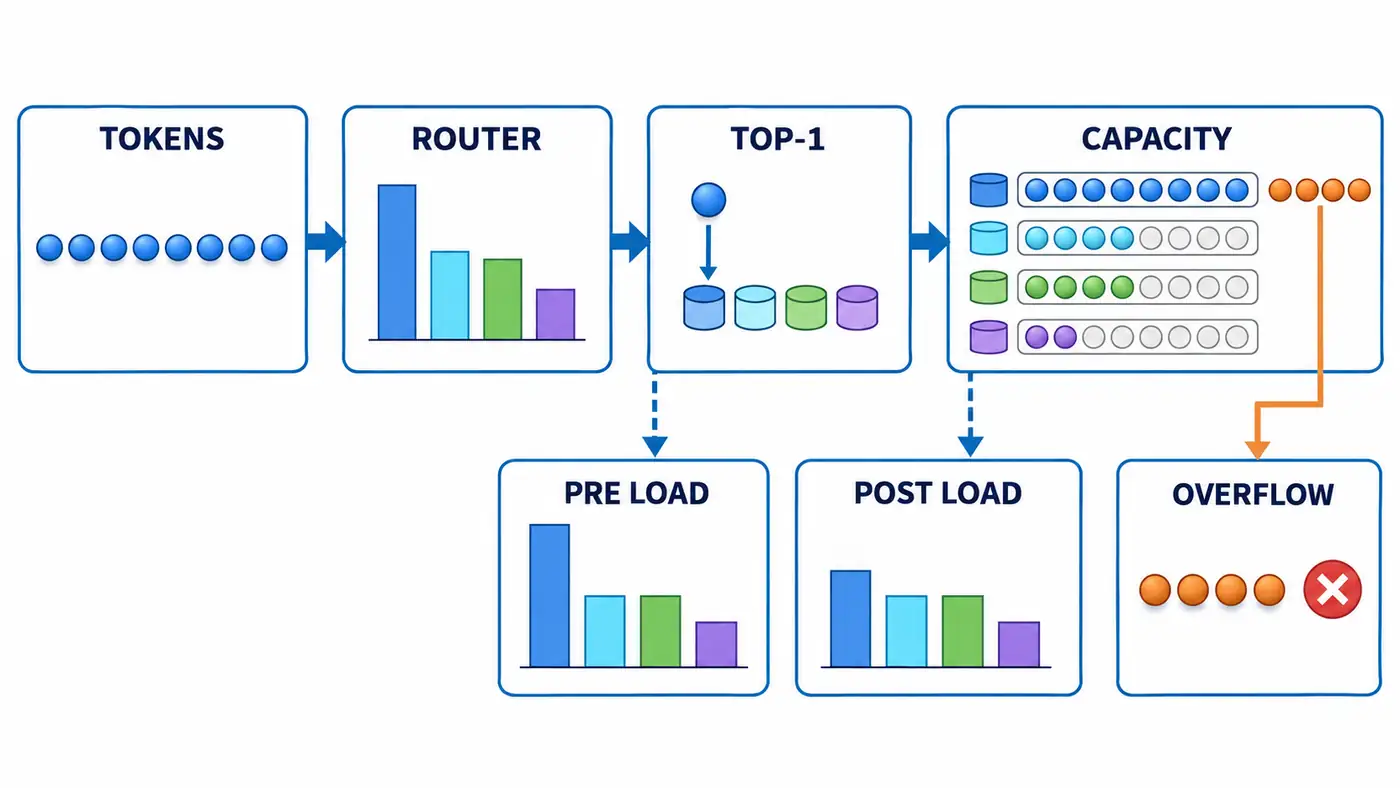
圖是診斷設置示意,珠子和柱高不對應實測樣本。上方讀出原始選擇,下方分別記錄截斷前後負載和溢出;同色代表同一專家。被截斷的柱子只能變短,圖中沒有宣稱專家經過訓練變得均衡。真實概率熱力表由腳本另行輸出。
最小實驗:反例、訓練與真實熱力表
進入本文 code/,使用 Python 3.12 執行:
python -m pip install -r requirements.txt
python minimal_moe.py --check-only
python minimal_moe.py
python audit_results.py
依賴固定為 NumPy 2.3.5。實際運行環境為 Python 3.12.14、CPU、雙精度。數據種子七千,訓練、驗證、測試各有二百五十六、一百二十八、二百五十六行,集合互不重疊。前三列獨立採樣標準正態;前兩列符號劃分四個區域,區域決定第三列的斜率和截距。區域標籤只生成目標,不作為路由監督。
路由矩陣和四個專家共三十二個參數。每個訓練種子使用相同初值和抽樣序列比較三種損失:任務均方誤差、加 、再加 。初始化把零號路由偏置加二,刻意製造擁擠;Adam 學習率零點零三,每步無放回抽六十四行,共六百步,訓練容量係數一點二五。三個種子為七十至七十二,不因結果好壞刪掉任何一組。
**本次實際驗證:**完全均勻概率反例中,六十四項全選零號,容量二十,只接收二十項,溢出率為 68.75%。另一構造把原始負載 [28,12,12,12] 截到每專家八項,得到 [8,8,8,8];均勻的接收柱狀圖隱藏了原始擁擠。全分數加一百後概率和選擇不變,但 z-loss 改變,進一步說明它不是負載指標。
九組訓練的固定終點測試結果如下;每項為三個種子的均值與樣本標準差,均衡損失、z-loss 均未乘權重:
MSE 是預測值與真實值之差的平方平均,越小越好;溢出比例則以全部有效輸入為分母。兩者回答不同問題:一個衡量任務誤差,一個衡量專家分支被跳過的頻率。實驗不計運行速度,因此也沒有據此報告吞吐提升。
| 訓練目標 | 測試 MSE | 溢出比例 | 均衡損失 | z-loss |
|---|---|---|---|---|
| 僅任務 | 0.982 ± 0.166 | 0.154 ± 0.065 | 1.295 ± 0.144 | 41.59 ± 8.18 |
| 加均衡項 | 0.933 ± 0.229 | 0.133 ± 0.101 | 1.298 ± 0.170 | 37.83 ± 5.74 |
| 再加 z 項 | 0.978 ± 0.048 | 0.118 ± 0.030 | 1.213 ± 0.041 | 21.09 ± 2.81 |
這組觀測不支持“加均衡項就必然降低均衡損失”。均衡組的種子七十一在測試中選擇計數為 [32,2,116,106],二號與三號擁擠,一號幾乎不用;但不能把有限窗口內低頻使用直接稱為永久塌縮。加 z 項後均值降低,也不證明覆現了大模型低精度穩定性收益:本次沒有出現或測試那種硬件數值故障。
打開 實際路由熱力表,可展開九組運行,逐行查看第一個固定測試批的四個概率、原始選擇與是否接收。色深等於概率,數字保留四位小數;熱力表只展示六十四行,彙總表則用全部測試行。完整精度概率、預測、權重和訓練曲線均在 results/,顏色不能代替這些數據。
評測協議:同時報告任務、分配和預算
本文預先固定六百步終點;驗證集只記錄曲線,不用於挑選檢查點,測試集也不用於調係數。每六十四行獨立執行容量限制,再平均批指標。尤其最大選擇比例和變異係數,應先逐批計算;先彙總全測試集再計算可能掩蓋局部擁擠。標準差只描述初始化和抽樣變化,不是置信區間。
還要分開記錄每個專家的原始計數、接收計數、零負載次數以及平均 token 熵。熵高代表單個輸入的路由不確定;它可能與固定並列造成的硬選擇集中同時出現。本文把塌縮視為待診斷的持續失衡現象,沒有設一個通用閾值就宣佈專家死亡。
保存權重後,本次額外掃了五種測試容量,保持輸入及順序不變。均衡組種子七十一的係數從一點二五改到四時,溢出從 24.22% 降為零,MSE 從 1.1139 降為 0.5358。這隔離了該模型對容量的敏感性,代價是允許更多專家計算;不能作為同預算方法改進,也不等價於重新訓練。
失敗排查:先排除觀測錯誤
遇到全部選同一專家,先檢查分數並列、初始偏置、有效 token 遮罩和數據順序,再調整輔助係數。本文沒有 padding;遷移到語言批次時,填充位置必須從分母和計數中排除,並保持不同方法的有效 token 集一致。
遇到均衡曲線下降但任務變差,應同時看未加權損失和加權貢獻。迴歸誤差的數值尺度與語言交叉熵不同,不能直接照搬論文係數。容量越緊,越可能讓序列後部跳過專家;重排 token 可以改變受影響的樣本,因此評測必須保存批內順序。
代碼通過全部參數的中心有限差分檢查,最大絕對誤差 2.79×10⁻¹⁰,擾動前後離散選擇與容量掩碼保持一致;這驗證局部梯度,不宣稱 argmax 可導。獨立標量審計又從保存權重重算四十五組容量評測及一萬一千五百二十個預測。官方框架運行、語言模型訓練、專家並行、低精度和論文基準均為待人工核驗。
後續科研問題
第一,專家真的分工了嗎?在固定數據分組上統計路由關聯後,再交換專家或屏蔽專家,觀察任務變化。僅憑某種顏色集中不能推出語義專長;路由差異也可能由位置或詞頻驅動。
第二,容量造成的錯誤是否集中在某些樣本?可以預先定義區域和位置切片,比較溢出樣本與接收樣本的誤差,再做固定預算下的順序擾動;需要保留配對樣本,避免用不同測試集解釋機制。
第三,局部均衡與全局均衡是否衝突?把同一批數據分到不同路由組,比較逐組統計和合並統計。在進入多機實驗前,這個小改動就能暴露統計口徑問題;是否改善通信效率仍須另行實測。
總結
理解 MoE 路由,需要把“想送給誰”“實際送了多少”“樣本最後表現如何”連在一起。本文的反例和負結果說明,任何單一輔助損失都不足以擔保專家健康。可複用的產物是可回放的選擇、掩碼、權重和評測協議;接入真實模型時,應首先守住這些檢查點。
參考資料
檢索日期:2026-09-11。以下一手鍊接均已實際打開;正文說明各自支持的論點。
- William Fedus、Barret Zoph、Noam Shazeer,Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity,JMLR 23(120),2022。出版頁面;出版全文。
- Barret Zoph 等八位作者,ST-MoE: Designing Stable and Transferable Sparse Expert Models,2022,arXiv v2,修訂於 2022-04-29。版本記錄;全文。
- TensorFlow Mesh 貢獻者,Switch 路由原始代碼,訪問時 master,未固定提交。moe.py。
- Hugging Face 貢獻者,Transformers v4.57.1,固定標籤源碼。Switch 實現。
- NumPy 貢獻者,NumPy 2.3 版本文檔。argmax 並列規則。