面向研究生、科研新人和工程型研究者;檢索與實驗日期:2026-09-12。
摘要
把圖片和句子編碼成向量,再比較相似度,看上去只需要一次矩陣乘法。真正容易出錯的是監督關係:一句“紅色方塊”可以描述多張圖,為什麼只有同一行的圖片才算正確?本文圍繞一個目標展開:從官方實現還原雙塔對齊,在 CPU 上訓練最小模型,再核對雙向檢索的正樣本和分母。本次實測發現,錯誤配對也能獲得很低的訓練損失;文搜圖的首位命中率達到滿分,也不等於找回了全部相關圖片。
目錄
- 復現價值:確定要驗證的命題
- 核心思想與公式
- 官方代碼閱讀路線
- 最小實驗與實際結果
- 評測協議:相關集合比行號重要
- 失敗排查與證據邊界
- 後續科研問題
- 總結與參考資料
復現價值:確定要驗證的命題
CLIP 是對比式語言圖像預訓練:兩個編碼器分別處理圖片和文本,將兩種輸入映射到可比較的表示空間。Radford、Kim 等人在 ICML 2021 發表原論文,研究大規模圖文監督能否支持遷移。這裡的“論文報告”只用於界定研究背景,不把論文中的自然圖像表現當成本次結果。論文出版頁
本次驗證的命題更窄:對齊損失能否學到給定配對關係,以及評測能否區分“關係學對”和“行號對上”。小模型的價值在於可以保存每次輸入、梯度和排名,排除下載權重、顯卡和分佈式訓練的干擾。代價同樣明確:簡單顏色形狀任務無法證明自然語言理解、開放詞彙遷移或真實圖像魯棒性。
核心思想與公式
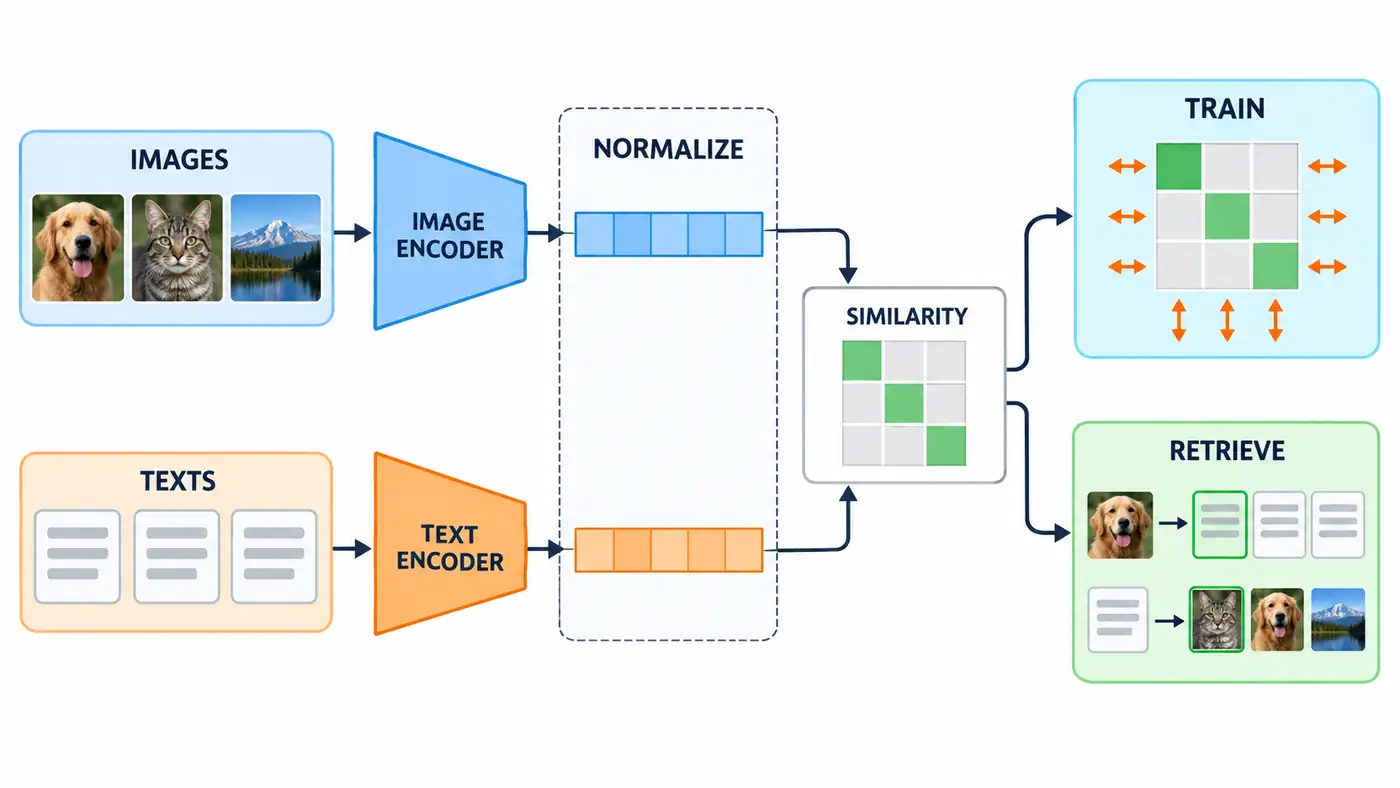
圖中兩條通道保持獨立,在相似度矩陣處比較。訓練和檢索是使用矩陣的兩種方式;綠色對角線示意單配對批次,不表示所有數據都只有一個正樣本。
記投影后的圖片表示為 ,文本表示為 ,則
每個向量有 個分量;一批 對輸入產生兩個 矩陣及一個 分數矩陣。歸一化去掉長度影響,點積成為餘弦相似度; 是對數尺度,常寫成溫度倒數的對數。尺度改變分佈尖銳度。
在第 張圖僅與第 條文本配對時,對稱目標可寫為
第一項逐行找文本,第二項逐列找圖片,各佔一半;同批其他條目充當負樣本。這對應原論文圖三的核心計算。論文正文
作者推斷:如果兩條描述完全相同,強行只獎勵其中一個行號,就把另一個語義正樣本當成競爭者。因此首先需要檢查數據標註是否支持這個目標,再討論更大批次是否帶來收益。相似度高只說明模型在這個表示空間裡更偏好該候選,不能獨立證明描述中的數量、關係和屬性都正確。
官方代碼閱讀路線
從 OpenAI 的 CLIP 倉庫進入,先對照接口輸入輸出,再深入網絡。倉庫提供模型和預處理加載接口,不能把成功運行推理示例等同於重跑了原始預訓練。以下屬於本次實際靜態核對,未執行官方模型。
第一站是 clip.py:load 同時返回模型與預處理。圖像要經過指定縮放、中心裁剪、RGB 轉換及通道標準化;tokenize 默認長度為 77,超長輸入默認報錯,可顯式選擇截斷。自己換一套裁剪而沿用同名權重,會改變實驗條件。
第二站是 model.py:追蹤 encode_image、encode_text 到 forward。文本取結束標記位置的表示後投影;兩個獨立編碼接口返回的特徵還需要歸一化,完整前向才計算帶指數尺度的點積及其轉置。手動調用編碼器時漏掉這一步,是可定位的實現偏差。
第三站看社區 OpenCLIP 的固定版本 v2.32.0 ClipLoss。它不是原作者完整訓練腳本,但可核對雙向交叉熵,以及多卡局部損失中的標籤偏移和特徵收集。把全局負樣本改為局部批次,會改變訓練問題,不能只比較代碼能否運行。
本次 OpenAI 源碼讀取的是當日 main,未固定提交;獲取提交號的網絡請求失敗。後續復現實驗應補記提交哈希、權重校驗值、依賴和數據版本。動態源碼是否變化、官方完整運行結果均為“待人工核驗”。
最小實驗與實際結果
代碼在 minimal_clip.py,環境和完整協議見 依賴說明。實際使用 Python 3.12.14、NumPy 2.3.5 和 CPU 雙精度運行,不依賴 PyTorch。實驗直接生成十六乘十六的 RGB 數組:紅綠藍三色與方塊、十字、圓環組合為九類,再隨機改變中心、亮度和背景噪聲;沒有使用預訓練圖像特徵。
每個種子生成一百零八張訓練圖、四十五張測試圖,分別每類十二張和五張。文本是九條兩詞描述,用六維詞袋錶示,即每一維指示一個顏色或形狀詞是否出現。圖片展平成七百六十八維;兩側各用無偏置線性映射投影到十六維,共一萬二千三百八十四個參數。
每批九張圖、每類一張,避免訓練批次重複描述。固定四百步、Adam 學習率 0.01、尺度十,不學習原模型的溫度。三個種子為 71、72、73,同時改變數據擾動、初始化及抽樣;訓練步數預先固定,不通過測試分數挑選檢查點。正常配對和循環錯配兩組共享初始化與圖像批次。
在代碼目錄執行:
python -m pip install -r requirements.txt
python -m py_compile minimal_clip.py audit_results.py
python minimal_clip.py
python audit_results.py
安裝命令供讀者使用;本次複用已有運行環境。腳本打印訓練像素、文本、嵌入和分數形狀,並保存數據、權重、每步 loss 與完整測試矩陣。
下表全部是本次合成任務實測,單位為百分比,報告三個種子的均值與樣本標準差;不是置信區間,也不是原論文復現分數。
| 實驗條件 | 圖搜文 Hit@1 | 文搜圖 Hit@1 |
|---|---|---|
| 未訓練初始化 | 2.96 ± 1.28 | 11.11 ± 11.11 |
| 正常圖文配對 | 88.89 ± 6.67 | 100.00 ± 0.00 |
| 固定循環錯配 | 1.48 ± 2.57 | 0.00 ± 0.00 |
種子七十一的正常組末批 loss 為 0.003447,錯配組為 0.003498,幾乎一樣低。這是故意構造的反例:優化器可以認真學會錯誤的數據關聯。因此“loss 下降”只說明擬合了指定訓練目標,不能代替獨立語義標籤評測。實際日誌
評測協議:相關集合比行號重要
圖搜文使用四十五張測試圖查詢九條描述,每圖一個相關候選;文搜圖使用九條描述查詢四十五張圖,每條描述有五張相關圖。兩邊均搜索完整測試圖庫,不用一個小批次的排名冒充完整檢索。匹配依據是顏色形狀組合,候選同分時按原始索引升序,協議在計算之前固定。
這裡 是查詢數, 是前 (k) 項, 是全部相關項集合。前者問“有沒有找到一個”,後者問“找回了多少相關項”。本文顯式分開命名,避免只寫含義不明的 R@K。文搜圖首位正確時,Hit@1 是一,相關項召回只有五分之一;同一次實驗的兩個值都正確。
另一個確定性檢查建立九組、每組三個完全等價成員的理想相似度矩陣。語義首位命中為一,若誤用行號作唯一答案則為三分之一。尺度十時,對角交叉熵為 1.098975;將所有同組正樣本概率相加再取負對數為 0.000363,相差恰為 ln(3)。這是代數診斷,不是多正樣本訓練方案優於原目標的實驗證據。
同時記錄首個相關結果倒數排名的均值 MRR,以及前一、三、五項的兩種指標。擴大圖庫會改變任務難度,增加重複項會改變概率分母;只有查詢、候選集合和相關性標註一致的分數才適合直接比較。
失敗排查與證據邊界
本次獨立審計未導入訓練函數,而從保存權重用標量乘加重建三千六百四十五個餘弦值,復算四百八十六個查詢的排名。與保存矩陣最大差為 1.22e-15;三十二個小型檢查參數的數值梯度最大誤差為 1.29e-9。訓練測試像素哈希無交集,語法、煙霧測試和結果審計均通過。審計記錄
正常組共十五次圖搜文首位錯誤,全部是顏色相同、形狀不同。作者推斷是顏色信息較易保留,平移後的輪廓較難由線性映射穩定區分;這還不是因果結論。要驗證原因,應分別固定位置、去除顏色或換用卷積編碼器,並保留相同測試協議。
排查順序可以從輸入開始:先看裁剪是否移除了對象、描述是否被截斷,再查歸一化與標籤置換,最後檢查負樣本和圖庫。給全部分數乘同一個正尺度,在嵌入和候選固定時不會改變排序,所以單改推理溫度不能修復這些排序錯誤;訓練中改變溫度會改變梯度,是另一個實驗。
數據哈希不重複只排除了完全相同的像素。本實驗訓練與測試共享九種組合,不能聲稱未見概念泛化。原版 CLIP 的模型卡還指出計數、細粒度識別及語言範圍等限制;英文合成描述的成功,不能外推為中文檢索有效。官方權重、真實數據集、多卡訓練、顯存和延遲均未測試,待人工核驗。
後續科研問題
第一個問題是正樣本如何定義。可在人工標註的一圖多文集合中比較單配對、批次去重和多正樣本目標,同時核對近義描述是否遺漏關鍵屬性。若把“紅色物體”與“紅色方塊”粗暴視作完全等價,也可能掩蓋形狀識別錯誤。
第二個問題是組合泛化。預先留出某些顏色形狀組合,保證訓練時每個單獨屬性仍出現,再與當前同類新樣本測試分開報告。這樣能檢驗模型是否重組屬性,而不是隻辨認熟悉的九個類別。
第三個問題是困難負樣本是否有效。加入同色不同形或同形不同色的候選,先統計錯誤類型,再比較方法增益與方差;固定圖庫並保留人工裁定,避免“難負樣本”其實是漏標正樣本。以上都是研究計劃,本次沒有執行或預告數值收益。
總結
復現 CLIP 的第一步,是把編碼、歸一化、配對和檢索評測接成可檢查的鏈條。本次最小實驗驗證了目標函數和排名協議,也暴露出低損失、錯誤配對和多正樣本之間的關係。讀者下一步應先復算保存的矩陣,再更換編碼器或真實數據;每擴大一層實驗範圍,就重新說明證據能支持什麼。
參考資料
以下一手鍊接均於 2026-09-12 實際打開,題名、作者或維護主體及版本已核對。
- Alec Radford、Jong Wook Kim 等十二位作者,2021,Learning Transferable Visual Models From Natural Language Supervision,ICML / PMLR 139:8748–8763;出版正文 PDF,用於雙向目標及研究背景。
- OpenAI,CLIP 官方倉庫,當日 main;clip.py 與 model.py,用於預處理、編碼與相似度路徑。提交號未固定,待人工核驗。
- ML Foundations / OpenCLIP 貢獻者,ClipLoss 實現,固定 v2.32.0 標籤,社區實現;用於損失和多卡標籤閱讀。
- OpenAI,CLIP Model Card,當日 main,模型日期標註 2021 年 1 月、含後續發佈記錄;用於能力與數據開放邊界。