- 日期:2026-09-08
- 讀者:研究生、科研新人和工程型研究者
摘要
訓練損失越來越低,小模型就越來越會聽指令嗎?本文將復現目標縮小為三個可檢查的問題:改變任務混合後學到了什麼,只監督回答與監督全文有何差別,換模板後還能否生成正確答案。我們閱讀指令微調論文及官方代碼,用真正訓練的微型循環語言模型檢查協議,並提供本地基礎模型的遷移腳本。結果保留低準確率、大種子波動與模板失效,不將玩具實驗包裝成論文成績。
復現價值:少量數據為何仍需要嚴格對照
監督微調,即 SFT,是用輸入及示範回答繼續優化模型。預訓練提供的能力、示範覆蓋的任務、輸出格式和評測方式共同決定收益,不能僅憑數據條數解釋結果。
論文報告:Zhou 等人的 LIMA 在已有六百五十億參數 LLaMA 上使用一千條精選示例研究對齊。它支持特定基礎模型和數據條件下的小樣本效果,不能證明一個從零訓練的小網絡也只需這些數據。LIMA 原論文
Wang 等人的 Tülu 工作比較多種開放指令數據,並發現不同數據對能力維度的幫助不同,沒有一種混合在全部評測中最優。對研究新人,這意味著先確定能力切片,再決定配比,不能只看平均偏好分。Tülu 論文
本文實際驗證的是訓練機制與測量鏈路。微型模型便於保存每個檢查點、核對梯度,卻缺少大規模預訓練知識。真實小模型接口另用 SmolLM2-135M 基礎模型作為準備對象;模型卡區分基礎與指令版本,二者不能混用後仍聲稱進行首次指令微調。官方模型卡
核心思想與公式:混合的是樣本,監督的是詞元
將一段對話序列化為詞元序列 ,只在回答位置計算損失:
模型輸出為 [B,T,V],分別表示批大小、預測位置數和詞表大小;掩碼 為 [B,T],回答及結束詞元處取一,提示詞和填充目標處取零。 必須大於零。模型仍讀取提示詞,梯度也能經隱藏狀態回傳;屏蔽提示詞的預測損失並不等於切斷輸入信息。
聊天模板負責把角色、內容和回合邊界變成模型看到的序列。同一句問題,角色標記或回答起始位置不同,都可能改變條件分佈。先打印最終詞元和有效標籤,再檢查推理前綴是否與訓練一致。框架官方文檔提醒:已經渲染好的模板再次分詞時,應避免重複添加特殊詞元。模板文檔
假設源 的抽樣概率為 、平均有效回答長度為 ,全局按有效詞元平均時,其期望監督佔比近似為 。這個估計假設長度穩定、沒有額外截斷;長答案源可能貢獻更多位置。若採用每樣本等權平均,權重關係又會變化,所以配比必須連同損失歸一化一起報告。
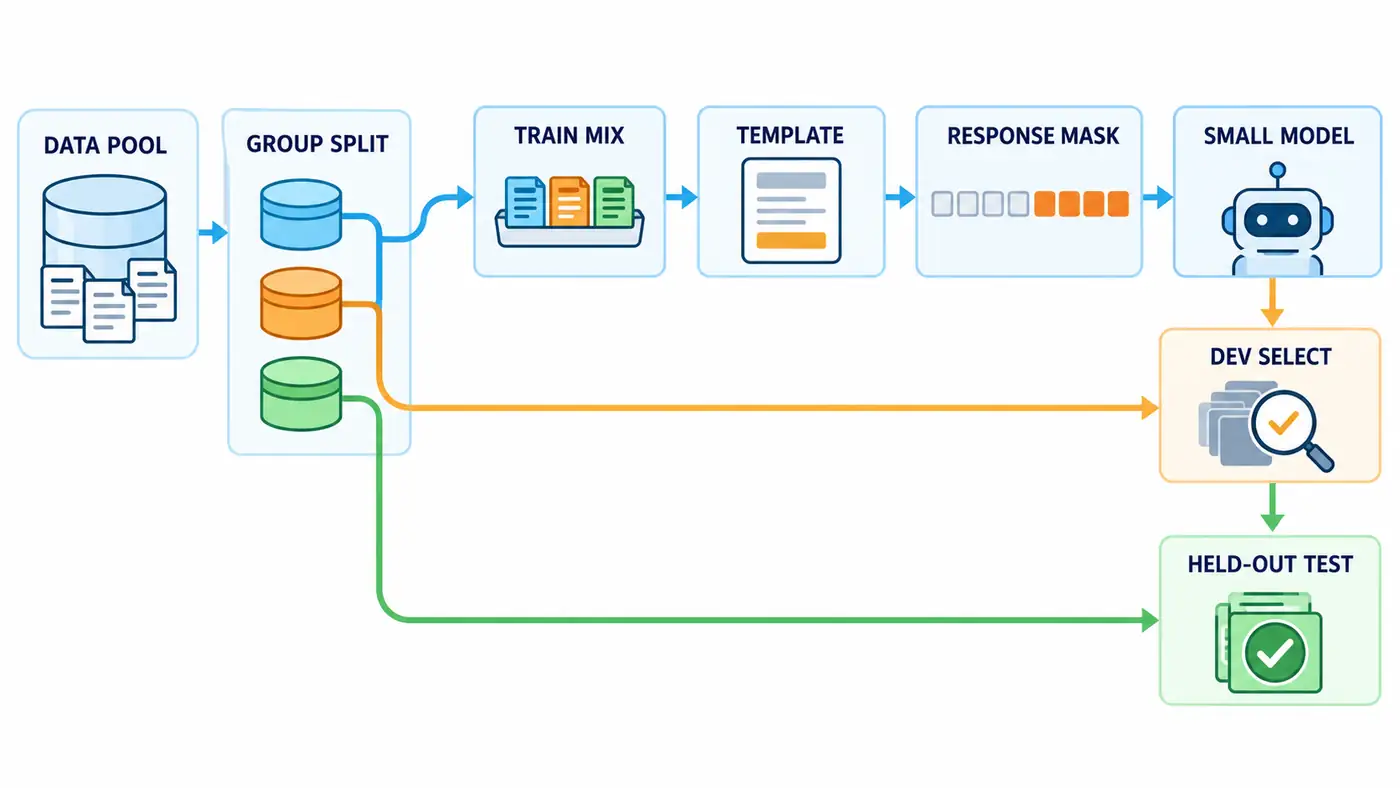
圖中先按問題組切分,再只混合訓練數據;開發集挑選檢查點,測試集僅檢驗凍結方案。開發和測試數據也需要一致的編碼與評分處理,圖中省略這些重複步驟,其箭頭不表示直接輸入未經處理的文本。
官方代碼閱讀路線:從數據入口走到 loss
先讀 Open Instruct README,確認研究版本和入口。當前倉庫已包含多代後訓練方案;閱讀今天的 main 不等於獲得二〇二三年論文的原始環境。本文記錄檢索日期,未鎖定提交,完整復現仍待人工核驗。官方倉庫
再看 dataset_transformation.py 的 load_dataset_configs:混合列表中的字符串 "1" 被解釋為一條樣本,"1.0" 才表示整個源的比例。隨後沿 _tokenize_tulu_sft_with_assistant_labels 看模板渲染、快速分詞器的字符偏移與回答標籤;初始標籤是 -100,再恢復可監督區域。不能拿簡單字符串搜索替代多輪迴合邊界推導。數據源碼
最後在 finetune.py 找 model(**batch)、outputs.loss 和反向傳播,並追蹤有效預測詞元統計。核對是否已經做過因果移位,避免再切一次標籤。倉庫分佈式路徑還有額外處理,本文沒有執行。訓練源碼
若使用 TRL,區分回答角色監督與 prompt-completion 的補全監督。assistant_only_loss=True 依賴模板能夠標記助手生成區域,不能只打開開關便假定掩碼正確。實際模板、版本與一條解碼後的有效標籤都應進入記錄。SFTTrainer 文檔
最小實驗:先建立能回放的因果語言模型
code/minimal_sft.py 使用 NumPy 實現循環神經網絡,即逐詞元更新隱藏狀態的 RNN,隱藏維度四十八、詞表十二項,共三千五百一十六個參數。它不是 Transformer,也不是自然語言預訓練模型。
任務為複製或逐位翻轉二進制字符串。先在三位字符串的十六條任務序列上全序列熱身六百步,再對四位字符串進行微調。這是合成熱身,不能等同於大規模文本預訓練。四位輸入先按原始字符串分組,訓練八組、開發四組、測試四組,每組兩種任務,因此同一個輸入不會跨集合。
每個種子的三個分支都從同一熱身權重開始,並重置優化器。單源分支把八條複製樣本各用兩次;平衡分支各用八條複製與翻轉樣本;全文分支使用相同平衡數據,但監督所有非填充目標。批大小十六,Adam 學習率 0.003,梯度範數上限一,全部訓練四百步。
python3 code/minimal_sft.py > code/smoke_test.txt
python3 -m py_compile code/minimal_sft.py code/local_hf_sft.py
需先按 code/README.md 準備環境。本次實際使用 Python 3.12.14、NumPy 2.3.5、CPU;系統 Python 缺少 NumPy。輸入 [16,12],輸出 [16,12,12]。預定在二十、一百、二百、四百步檢查開發集回答負對數似然,即 NLL,越低越好;只按它挑選檢查點,不按測試準確率挑選。
下表為初始化種子 67、68、69 的嚴格整串匹配率,要求內容和結束詞元均正確;貪心生成最多八個詞元。“±”為三個種子的樣本標準差,不是置信區間。
| 微調設置 | 同模板測試匹配率 | 換模板測試匹配率 | 每步監督詞元 |
|---|---|---|---|
| 僅複製,回答監督 | 0.125 ± 0.125 | 0.000 | 80 |
| 平衡混合,回答監督 | 0.333 ± 0.260 | 0.000 | 80 |
| 平衡混合,全文監督 | 0.167 ± 0.072 | 0.000 | 192 |
熱身模型在四位測試集上的整串匹配率均為零。混合分支均值較高但波動很大,每個種子只有八條測試記錄,不能據此推廣“平衡配比最優”。全文分支改變了監督位置和分母,雖然輸入與步數相同,卻不是固定監督詞元預算對照。
換模板將 USER/ASSISTANT 改為 TASK/INPUT/ANSWER 包裝。這些詞元雖在固定詞表中,卻未作為熱身或微調輸入出現;零分是極端分佈外壓力測試,不能證明真實模型對普通措辭改寫都會崩潰。
所有數據、逐條生成、開發曲線及權重均已保存。五類參數的有限差分梯度最大誤差約為 ,首回答位置、結束詞元計數及批均值檢查通過。另附 local_hf_sft.py,可從本地基礎模型加載、按回答掩碼訓練並在開發集選模型;本機無 torch,只有語法檢查通過,真實權重加載、訓練和接口兼容性待人工核驗。
評測協議:分別測擬合、泛化與格式
固定基礎模型與分詞器版本,保存模板原文、數據來源及去重規則。按問題家族切分比隨機拆行更重要:同一問題的改寫和兩個解題版本應同組。本文測試新輸入組合,任務類型仍見過,不能稱為跨任務泛化。
還應把評測前綴本身作為實驗材料保存。例如本例複製輸入的訓練序列以助手標記銜接四個回答詞元和結束標記;測試時只能提供助手標記以前的部分,不能把真實回答悄悄留在輸入中。保存逐條生成可以檢查這種洩漏,也便於重新計算更嚴格的指標。
任務正確率、格式合規率、回答 NLL 應分開。前者檢查自由生成,NLL 使用真實答案前綴,所以低 NLL 不保證長序列全部正確。自然語言任務還應記錄錯誤類型及原始輸出,避免清洗掉額外解釋之後,把格式違約隱藏在“正確答案”裡。
配比研究至少同時報告樣本數、有效回答詞元數、總輸入詞元和優化步數。長答案、截斷和重複採樣都會改變預算。本例單源重複數據用於匹配每步規模,但獨立樣本更少,這是配比比較的結構差異,不能說所有因素都相同。
三次初始化共享同一切分,其標準差只反映訓練敏感性。正式報告需要更多問題組與預先凍結的配方,可按問題組進行配對重採樣;僅擴大訓練種子數量並不能彌補測試覆蓋不足。
失敗排查:訓練下降時先看開發集
本次種子六十七的平衡分支,從一百到四百步,訓練回答 NLL 由 0.0588 降至 0.0021,開發 NLL 卻由 0.6055 升至 1.0407。因此選擇一百步檢查點。這裡觀察到了對訓練數據的進一步擬合沒有換來開發收益;不是“訓練越久必然退化”的普遍定律。
生成長度出錯時,先看結束詞元是否受監督以及最大生成長度。種子六十七的一個翻轉測試答案應為 0101,模型生成 01100 後才結束,說明錯誤同時涉及內容與停止,不能只歸為格式問題。
損失異常小也可能是監督了容易預測的模板、回答被截斷或全標籤無效。先解碼一條有效標籤,再檢查首回答詞元的預測位置。啟用樣本打包,即把多條記錄拼入一個序列時,還需確認跨樣本注意力與邊界處理;本次沒有打包,不能把吞吐量結果推給該功能。
後續科研問題
作者推斷:平衡混合的收益可能來自第二種任務的覆蓋,也可能與獨立樣本更多有關。下一步保持獨立輸入數一致,比較單源、多源與重複次數,再在固定有效詞元預算下重複,才能分離這些因素。
模板問題可從極端新標記轉向同詞表、同長度的包裝擾動,並加入多模板訓練對照。如果改善只發生在見過的包裝上,學到的可能仍是格式匹配。遷移到真實小模型後,還應加入原能力測試,觀察指令適配是否伴隨遺忘。
總結
本次完成了數據分組、響應監督、開發選擇和自由生成的可回放實驗,也發現了過擬合跡象與模板失效。論文提供研究假設,官方源碼暴露實際協議;可靠復現需要把二者與本機證據逐項對齊,而不是讓漂亮的訓練曲線替代獨立測試。
參考資料
檢索日期:2026-09-08。正文各鏈接均已實際打開,以下為核心版本與閱讀入口;動態代碼和模型運行兼容性待人工核驗。
- Chunting Zhou 等,2023,LIMA: Less Is More for Alignment,arXiv v1 全文。
- Yizhong Wang 等,2023,How Far Can Camels Go? Exploring the State of Instruction Tuning on Open Resources,arXiv v2,頁面註明 NeurIPS 2023 Datasets and Benchmarks camera-ready。
- AllenAI,Open Instruct 官方倉庫,本文閱讀檢索日 main 的數據與訓練模塊,非原論文提交快照。
- Hugging Face,聊天模板文檔、TRL SFTTrainer與SmolLM2-135M 基礎模型卡。