- 日期:2026-09-07
- 讀者:研究生、科研新人和工程型研究者
摘要
學生模型越來越像教師,是否意味著越來越正確?本文圍繞這個問題,閱讀經典知識蒸餾、序列級蒸餾與 MiniLLM 的論文和官方實現,實際訓練一個小型教師與四組學生。復現目標是辨認監督信息、溫度和評測口徑如何改變結論。實驗保留了一個不漂亮但有價值的結果:軟目標降低負對數似然,卻沒有超過真實標籤基線的準確率;教師錯誤也被學生繼承。這裡驗證損失機制與實驗協議,不宣稱復現大語言模型論文成績。
復現價值:先問教師究竟交出了什麼
知識蒸餾指用教師模型提供的監督訓練學生模型。教師可以交出完整輸出概率,也可以只交出生成文本。前者讓學生看見“第二可能答案”與最高分答案的差距,後者保存一條具體行為軌跡。學生容量較小、教師有偏差、遷移樣本覆蓋不足,都可能限制收益;參數少只是結構屬性,效果仍須獨立檢驗。
論文報告:Hinton、Vinyals 與 Dean 在 2015 年預印本中討論軟目標及溫度,展示圖像和語音任務中的知識遷移;這不是所有學生都能無損壓縮教師的定理。原論文
Kim 與 Rush 的 EMNLP 2016 工作將監督提升到完整輸出序列,用教師束搜索生成的序列訓練學生。束搜索是在每一步保留多個候選前綴的近似解碼;它不保證找到全局概率最大的句子。現代 response distillation,即響應蒸餾,也常將教師生成文本作為訓練標籤,但具體採樣與過濾策略不能自動等同於原論文。序列級蒸餾
核心思想與公式:概率、序列與損失方向
logit 是歸一化前的分數。對同一輸入,教師和學生的 logit 分別為 ,其中 是批大小, 是類別數。定義:
是溫度,增大它通常使概率更平緩; 是長度為 的真實標籤,CE 為交叉熵, 控制教師監督權重。KL 即兩種概率分佈差異的度量,這裡對類別求和、對樣本取平均。教師固定時,軟交叉熵與這個方向的 KL 相差教師熵,學生梯度相同。乘 用於補償高溫下梯度尺度,不能理解成溫度越高知識越多。公式與溫度討論
響應蒸餾則使用教師生成的 :
為序列長度上限, 標識有效響應詞元,提示詞與填充位置不參與平均,結束詞元是否保留須明確; 不能為零。模型輸出形狀為 [B,L,V], 為詞表大小。訓練時輸入已有前綴並預測下一詞元,必須對齊因果移位。完整文本可由學生自己的分詞器重新編碼;直接逐詞元匹配兩模型概率則要求詞表語義與上下文對齊。
MiniLLM 研究反向 KL,即 ,並配套設計採樣和優化。其序列期望依賴學生分佈,不能在固定教師響應上交換函數參數便聲稱實現了整套方法。本文采用 2024 年 v4;當前 arXiv v6 已將題名改為含 On-Policy 的版本。MiniLLM v4、版本記錄
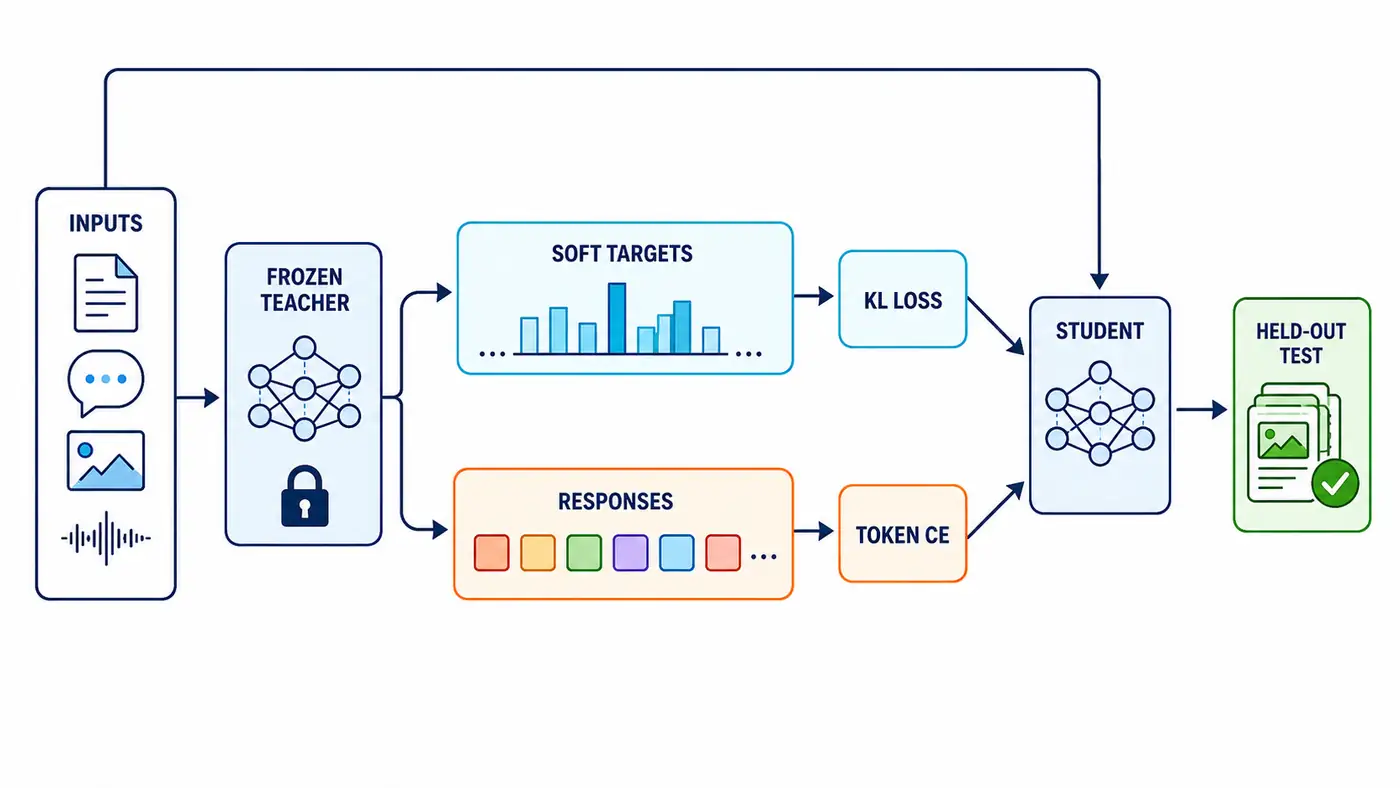
圖中兩條路線是替代選擇:概率進入 KL,響應進入詞元交叉熵;損失指向學生表示訓練監督,教師保持凍結。獨立測試集檢查訓練後的學生,不用於產生訓練目標。圖示概念關係,不表示本次已訓練語言模型。
官方代碼閱讀路線:沿著有效 token 找分母
先讀 PyTorch 官方教程的 train_knowledge_distillation:教師進入評估模式,在不記錄梯度的上下文中前向,學生保留梯度;然後核對兩邊溫度和混合權重。評估模式只改變 dropout 等模塊行為,本身不會阻止梯度構圖。這是框架教學代碼,並非 Hinton 論文的原始實現。官方教程
再讀 LMOps 的 minillm/finetune.py。get_distil_loss 在非模型並行分支計算教師 softmax 與學生 log-softmax 的軟交叉熵,用 label != -100 排除無效目標,最後除以有效位置數;該函數沒有顯式溫度縮放,不能把本文的溫度三實驗冒充官方默認值。訓練入口用 kd_ratio 混合真實標籤與教師損失。KD 源碼
響應路線先按倉庫 README 的 SeqKD 小節生成並處理偽響應,再運行微調。MiniLLM 路線另從 trainer.py 追蹤 rollout 收集、響應 logit 切片與模型更新,再讀 losses.py 中策略損失及正則;這些模塊說明它與離線響應擬合的差別。本文只閱讀,沒有啟動分佈式訓練;倉庫 main 未鎖定提交,後續運行兼容性待人工核驗。官方倉庫、訓練器、損失實現
最小實驗:真實訓練,明確縮小範圍
code/minimal_distillation.py 僅依賴 Python 標準庫。數據由二維座標和固定非線性評分規則生成三分類標籤。教師在六維多項式特徵上擬合十八個參數,學生在三維線性特徵上擬合九個參數;這是真實優化的分類模型,但不是預訓練神經語言模型。
教師訓練集三百六十條、遷移集九十條、測試集二百四十條,用不同數據種子生成。教師訓練四百步並凍結,學生均訓練二百五十步,學習率統一為 0.12;三個運行種子為 66、67、68,只改變初始化。同一個種子下,四組學生從完全相同權重出發。溫度一與三、軟監督權重 0.7 均預先固定,不用測試集選參。
PYTHONPYCACHEPREFIX=/private/tmp/codex-ai-066-pycache python3 -m py_compile code/minimal_distillation.py code/torch_loss_check.py
python3 code/minimal_distillation.py > code/smoke_test.txt
本次實際驗證:Python 3.9.6、CPU;教師特徵 [360,6],學生特徵 [90,3],測試 logit [240,3]。下表為三個初始化的均值,NLL 是真實標籤的負對數似然,越低越好;所有評測概率均使用溫度一。
| 學生監督 | 準確率 | 真實標籤 NLL | 與教師的 KL |
|---|---|---|---|
| 僅真實標籤 | 0.9542 | 0.2100 | 0.0438 |
| 僅教師最高分標籤 | 0.9333 | 0.2165 | 0.0485 |
| 真實標籤加軟目標,溫度一 | 0.9500 | 0.2223 | 0.0495 |
| 真實標籤加軟目標,溫度三 | 0.9500 | 0.1887 | 0.0347 |
教師準確率均為 0.9792。學生各組準確率的樣本標準差均為零,NLL 仍有微小波動,完整數值與權重保存在 code/results.json。零波動只說明這三個初始化得到相同數量的正確預測,不說明結果沒有統計不確定性。
溫度三改善了概率指標,卻未改善相對真實標籤基線的準確率。硬教師分支沒有真實標籤混合,因此表格也不能單獨證明“軟概率形式”優於硬目標;嚴格消融應額外匹配標籤混合比例。教師測試錯題共五條,各學生均複製其中四條錯誤,這個切片太小,適合作為警報而非穩定錯誤率估計。
本次另通過 KL 自比較、方向不對稱、大 logit 穩定性和有限差分梯度檢查;梯度最大誤差約為 。torch_loss_check.py 提供有效詞元、教師 detach 和掩碼梯度對照,但本機兩個 Python 環境均缺少 torch,只有語法檢查通過,運行待人工核驗。分類硬標籤分支不等於完整 response 蒸餾,本次沒有文本生成、序列訓練或原論文 benchmark。
評測協議:相似度不能代替正確性
正式復現先凍結教師檢查點、數據來源、分詞器與聊天模板,按問題家族切分訓練、開發、測試,執行去重和汙染檢查。用開發集選擇溫度、權重和停止步,再只對凍結方案報告測試結果。本文沒有開發集,直接用預定最終步,適合機制檢查,不承擔最優配置選擇。
同時報告任務指標、真實參考下的 NLL、教師一致率與教師錯題上的錯誤複製。語言任務要固定解碼溫度、最大新詞元數、停止條件,保存原始響應;開放答案結合獨立盲評,可驗證任務優先採用答案或執行檢查。僅複述教師措辭,不應自動得高分。
還要區分兩類波動:重複初始化衡量優化敏感性,重複採樣測試問題才涉及樣本不確定性。本文三個種子共享同一測試集,所以標準差不能充當總體準確率的置信區間。真實報告可在題目層面做配對重採樣,保留同一道題上基線與蒸餾模型的對應關係;同一家族多條改寫應作為一個抽樣單元,避免把相關記錄當成獨立證據。
成本也要公平:除了學生訓練步數,還要記錄教師預訓練或微調成本、生成詞元數、軟 logit 緩存體積和峰值內存。固定樣本數並不等於固定訓練詞元數。硬響應與軟分佈兩路線都應比較同架構、同初始化的真實標籤基線,再做固定詞元預算對照;改變數據量與損失形式時分別記錄,避免把額外監督的收益歸給公式。
失敗排查:先檢查方向,再檢查數據
KL 數值異常時,先確認函數輸入要求。PyTorch 的輸入通常是學生對數概率,目標是教師概率;batchmean 對二維分類張量除以批大小,但直接用於三維張量不會自動除以有效詞元總數。配套實現先選出有效位置變成 [M,V],再計算平均;空響應直接報錯。KLDivLoss 文檔
緩存也會造成隱蔽錯誤。保存軟目標時應同時記錄樣本編號、詞元編號、掩碼、教師版本和溫度;只按文件行號連接輸入與概率,重新排序後就可能訓練到別人的目標。若僅緩存最高几個概率,再歸一化會改變原來的分佈,必須說明遺漏概率質量如何處理。響應數據至少保留提示詞、原始生成文本、生成參數與過濾原因,不能只留下清理後的答案。
訓練很順卻生成退化時,打印一條完整的輸入、移位標籤和掩碼,檢查是否把提示詞計入損失、丟掉結束標記或重複移位。教師使用評估模式並凍結,隨機裁剪與預處理也應一致。若學生更像教師卻更不正確,查看錯誤複製、數據覆蓋與教師在目標領域的表現,不急著增加蒸餾權重。
後續科研問題
作者推斷:容量受限時,最有價值的監督可能只來自部分不確定區域。可先按教師置信度分桶,比較同預算的分桶溫度和固定溫度,並把教師錯誤單獨標記;收益是否來自過濾錯誤還是保留軟信息,需要分開消融。
另一個問題是前綴分佈。離線響應只覆蓋教師走過的路徑,學生自由生成會遇到自己的偏離。下一步可比較教師前綴與學生前綴上的監督,固定查詢預算並記錄錯誤出現位置;這才逐步接近在線蒸餾問題,而不是把分類實驗的結論直接移植到長文本。
總結
蒸餾復現需要同時說明教師提供什麼、學生在哪些輸入上學習、結果由誰判斷。本次建立了可回放的軟硬監督對照,並保留準確率未提升和教師錯誤傳播的事實。下一步應補齊張量運行驗證與真實序列實驗,繼續用獨立任務證據判斷收益。
參考資料
檢索日期:2026-09-07。以上正文鏈接均直接指向本次打開的一手資料。核心論文為 Geoffrey Hinton、Oriol Vinyals、Jeff Dean 的《Distilling the Knowledge in a Neural Network》(2015,arXiv v1);Yoon Kim、Alexander M. Rush 的《Sequence-Level Knowledge Distillation》(EMNLP 2016 定稿);Yuxian Gu、Li Dong、Furu Wei、Minlie Huang 的《MiniLLM: Knowledge Distillation of Large Language Models》(ICLR 2024,本文閱讀 arXiv v4)。MiniLLM 當前 v6 的題名與版本變化另見正文版本記錄。代碼鏈接為檢索日 main,PyTorch 損失接口採用固定 2.12 文檔;官方教程為動態頁面,依賴與模型運行兼容性待人工核驗。