- 日期:2026-09-06
- 讀者:研究生、科研新人和工程型研究者
摘要
生成一萬條指令很容易,解釋留下哪一千條卻很難。回答流暢可能掩蓋錯誤,高分樣本可能都來自同一模板,最難的題也可能只是標籤有誤。本文圍繞一個復現目標:在固定保留預算下,用可檢查的質量分類器、多樣性約束和難例配額選擇合成樣本,並保存每次選擇的證據。我們閱讀 Self-Instruct 與 DEITA 的官方實現,實際運行一個純 Python 實驗;驗證的是篩選行為,不聲稱復現論文的語言模型訓練收益。
復現價值:把“好數據”拆成三個可證偽的問題
質量問單條樣本是否值得學習,多樣性問它相對已選集合是否提供新信息,難度問當前學習者是否尚未掌握。三者不能共用一個未經定義的分數。重複的正確答案可能質量合格卻冗餘;罕見任務可能很有價值,也可能是生成器胡編;高損失同時可能來自知識缺口和錯誤標籤。
論文報告:Self-Instruct 通過種子指令引導生成,再過濾無效或相似樣本用於指令微調,證明了合成指令路線的可行性。其結論依賴當時的模型、生成設置和評測,不能理解成生成文本天然可靠。ACL 2023 論文
DEITA 將複雜度、質量和多樣性分別度量,再聯合選擇數據。它的研究對象包含來自不同來源的指令數據池,並非所有記錄都是同一種生成器產生。本文借用它的選擇思想處理受控合成數據,額外加入可執行檢查和難例配額;後兩者是教學實驗設計,不冒充原算法。DEITA 定稿 v2
核心思想與公式:分數是代理,集合才是輸出
quality classifier 指質量分類器:根據標註預測樣本屬於“可用”類別的程度。標籤要先寫清,本例只學習可讀算術解釋與空回答、重複填充之間的區別。令特徵矩陣為 ,採用邏輯迴歸:
是訓練樣本數, 包括截距、是否非空、截斷詞數和詞元去重比; 為四維參數, 是二元標籤,輸出 為長度 的向量。代碼優化時另加非截距參數的二範數正則。這個模型無法計算答案真偽,輸出也未經獨立概率校準,不能稱為“正確率”。
DEITA 使用另一種評分器:先對同源演化版本排序評分,再訓練模型預測複雜度和質量。官方推理在六個分值對應的 token 上歸一化得分並求期望,得到標量;並不是本文的二分類訓練。評分源碼
對已歸一化的向量 ,本例的多樣性規則為:
是已保留代表集合, 是表示維數, 是相似度上限;空集合直接接收第一條。一次候選比較產生長度 的分數。這裡明確使用相似度:越大越接近。本次向量是人工任務類別的獨熱編碼,即一個位置為一、其餘為零,不能據此證明真實語義覆蓋。
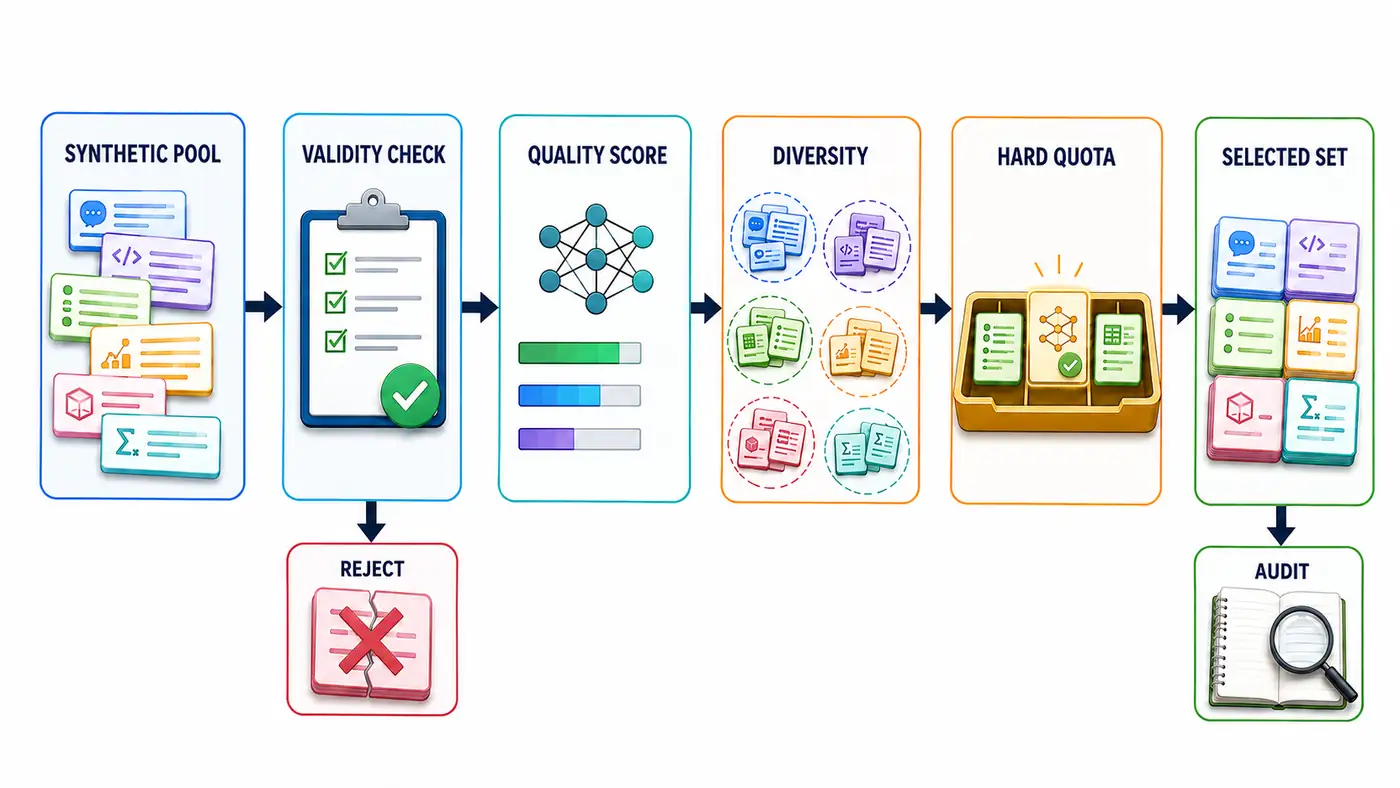
圖示先排除可驗證的無效樣本,再評分、構造多樣代表,最後在預算內安排難例並審計。圖中條形僅示意評分,卡片顏色僅示意任務差異。難例必須已經通過有效性與質量檢查,配額不能把錯誤答案重新引入訓練。
官方代碼閱讀路線:從字段追到不等號
先讀 Self-Instruct 的 bootstrap_instructions.py。它用最長公共子序列相關的 ROUGE-L 檢查指令相似度,超過 0.7 時跳過;同時過濾過短過長指令、非 ASCII 開頭等情況。後者服務於原始英文設置,複製到中文流程會直接誤刪正常指令。這個閾值也不是語義等價標準。指令生成源碼
再讀 prepare_for_finetuning.py 的解析與過濾函數:空輸出、輸入輸出相同、冒號結尾的疑似殘缺記錄會被過濾;同一非空輸入出現不同輸出時會丟棄該組實例。這有助於清理矛盾標籤,但開放寫作本來可能有多個合理答案,規則必須服從任務定義。實例清理源碼
DEITA 從 score_pipeline.py 追蹤多輪對話如何按位置組成指令回答對;然後看 filter_pipeline.py,分數列表被按行寫入向量表,選出的 idx 又索引原 JSON。若向量導出後單獨洗牌,即使長度一致也會靜默錯配。復現時應保存穩定樣本編號,並逐條核對原文摘要。評分管線、篩選管線
最後讀 combined_filter.py:逐輪質量與複雜度相乘,再求和排序。別被日誌裡拼接的加號誤導。進入 filter/base.py 後,名為 compute_distance 的 cosine 分支實際返回歸一化點積,嚴格大於閾值才排除。論文把該量叫距離,源碼揭示了具體方向;本例還測試恰等於閾值的行為。聯合排序、相似度篩選
最小實驗:讓高分、覆蓋與正確性分開變化
code/minimal_filter.py 用確定性模板構造數據,沒有調用語言模型。訓練集二十四條、開發集六條,按算術種子家族分開,但共享模板,因此只是控制實驗。開發集掃描五個閾值,以精確率與召回率的調和平均值 F1 選擇,平局時取最接近 0.5 的值;候選數據從不參與擬合或選閾值。
候選池十四條,含加法、排序、字符串反轉、平方和四類,以及一個流暢錯誤答案和一個空回答。平方和被手工定義為難例,不代表實際學生模型的困難程度。正確性檢查只比較結構化 answer 與內置運算結果,不審查自然語言解釋中的每句話。從文章目錄執行:
PYTHONPYCACHEPREFIX=/private/tmp/codex-ai-065-pycache python3 -m py_compile code/minimal_filter.py
python3 code/minimal_filter.py > code/smoke_test.txt
本次實際驗證:Python 3.9.6、CPU、種子 65;訓練、開發與候選特徵形狀分別為 [24,4]、[6,4]、[14,4]。訓練二元交叉熵從 0.693147 降到 0.027918,選定閾值為 0.5,十二條候選同時通過質量和結構檢查。開發模板太容易,這些數字不能作為真實質量分類器的泛化性能。
| 策略,保留預算均為三條 | 四類任務覆蓋率 | 難例條數 | 回答詞數合計 |
|---|---|---|---|
| 合格池隨機抽樣 | 0.75 | 1 | 46 |
| 僅質量排序 | 0.50 | 2 | 17 |
| 質量加多樣性 | 0.75 | 1 | 22 |
| 再加入難例配額 | 0.75 | 1 | 22 |
多樣性採用閾值 0.9,先遍歷全部合格候選得到代表集合,再截取預算。難例策略優先保留至多一個合法難例代表,然後按分數填充。這裡質量排序本已偏好短而詞彙不重複的平方和回答,難例配額沒有改變結果;隨機抽樣也達到相同覆蓋,不能宣稱聯合策略勝過隨機選擇。
錯誤答案的質量分數為 0.894078,與其正確版本完全相同,二者都越過質量閾值。原因是替換數字沒有改變四個特徵;結構檢查才將錯誤版本排除。它雖未進入本次前三名,仍證明閾值放行不是正確性保證。全部樣本、權重和選擇軌跡見 code/results.json;語法、空池、零向量拒絕及閾值邊界檢查均通過。
評測協議:固定預算,也保留獨立裁判
真實實驗先制定標註量表:任務是否可回答、答案是否正確、格式是否滿足要求、解釋是否支持結論。對歧義題單列待複核狀態,記錄標註者分歧。按原始種子、改寫家族及生成批次分組切分,避免同題換措辭同時出現在訓練與開發集。凍結閾值後,再在未見來源上測可用樣本精確率、召回率與分層誤刪率。
選擇結果至少同時報告質量、多樣性和成本。本例覆蓋率分母是預設四類任務,詞數是英文正則分詞結果,不是模型詞元數。正式微調應補充固定 tokenizer 下的訓練詞元預算,因為三條長答案可能比三條短答案消耗更多計算。先比較固定樣本數,再比較固定訓練詞元數;記錄優化步數、學習率、截斷長度與隨機種子。
還應單獨評估篩選器遷移。將某個生成器的輸出全部留作外部檢查,比較不同語言、模板與回答長度下的錯誤類型;同一來源隨機切分得到的好成績,可能只說明模型認出了文風。抽查被拒絕的數據與被保留的數據同樣重要,否則無法估計有價值難例被誤刪的比例。若採用分層抽樣複核,需要保存抽樣概率,不能把刻意多抽的難例比例當作總體比例。
下游評測必須獨立於生成器和過濾器。數學可用答案驗證,代碼可用隔離運行的測試,開放任務結合盲評與人工抽查;不能拿過濾器自己的均分當訓練效果。隨機、僅質量、質量加多樣性、再加難例至少做相同預算對照,重複多個種子並報告波動。本次只運行一個篩選種子,沒有訓練模型,也沒有誤差線,後續結果待人工核驗。
審計文件應保留生成來源、提示詞版本、原始響應、父樣本編號、評分器版本、排除原因和最終歸屬。若採用人工複核後的標籤,另存複核時間與依據,避免事後改標籤讓指標變好。去重與汙染檢查仍要獨立執行;多樣性高並不排除訓練集中出現測試題。
失敗排查:先檢查篩掉了誰
質量均分上漲而效果下降,先按長度、任務和來源查看保留率。本例短回答得分更高,說明一個看似合理的特徵組合也會學到捷徑。給流暢錯答、簡短正確答案與模板復讀分別建切片,才能看見總體均分隱藏的問題。
覆蓋率異常時檢查向量是否錯行、是否歸一化、零向量如何處理,以及相似度閾值方向。任務獨熱編碼讓本例的類別邊界過於理想;真實 embedding 可能聚合不同能力,也可能拆開同義改寫。增加難例比例卻使訓練不穩,則抽查高損失樣本的標籤、截斷和不可解條件,不要先歸因於模型容量。
後續科研問題
作者推斷,值得研究的是固定預算下的取捨,而非尋找通用高分閾值。可以固定長度分佈,檢驗質量分類器是否仍有篩選優勢;固定獨立正確性標籤,比較類別配額與神經表示篩選;再用凍結學生的錯誤率定義難度,研究合法難例從零到不同配額時的收益曲線。預先規定失敗標準,例如長尾任務下降或錯誤標籤保留率升高,使負結果同樣可報告。
總結
可復現的合成數據過濾,應輸出可回查的樣本集合及選擇理由。本次實際驗證了高分錯誤答案、質量排序的覆蓋不足,以及難例配額不產生增益的情況。下一步應擴展獨立標註與真實表示,再開展受控微調;官方權重推理、原論文訓練和跨領域收益均尚未驗證。
參考資料
檢索日期:2026-09-06。正文所引一手鍊接均已實際打開。OpenReview 遇到驗證頁,改用作者 arXiv 定稿核驗;官方分支按訪問日期記錄,未固定 commit,重跑兼容性待人工核驗。
- Yizhong Wang、Yeganeh Kordi、Swaroop Mishra、Alisa Liu、Noah A. Smith、Daniel Khashabi、Hannaneh Hajishirzi,2023,Self-Instruct: Aligning Language Models with Self-Generated Instructions,ACL 定稿全文、官方倉庫。預印本首發於 2022 年。
- Wei Liu、Weihao Zeng、Keqing He、Yong Jiang、Junxian He,2024,What Makes Good Data for Alignment? A Comprehensive Study of Automatic Data Selection in Instruction Tuning,ICLR 2024,arXiv v2 定稿說明、官方倉庫。v2 修訂日期為 2024-04-16。