- 日期:2026-09-05
- 讀者:研究生、科研新人和工程型研究者
摘要
一份語料刪掉很多行,是否意味著實驗更可信?未必。重複可以是完全相同的文檔、被複制的一段話,也可以是換了措辭的同一道題;高相似度還可能來自結論相反的句子。本文圍繞一個可執行目標:構建同時保留詞面證據、向量分數和數據來源的審計腳本,觀察去重怎樣漏掉改寫,又怎樣誤傷否定句。最小實驗不訓練語言模型,實際驗證的是候選發現與隔離協議;論文中的記憶、訓練效率和評測改善,不作為本次復現結果。
復現價值:先分清“刪重複”和“查汙染”
去重研究的是訓練集合內部的冗餘:重複樣本會改變採樣權重,使某些表達被反覆學習。汙染檢測研究的是訓練材料與評測題之間的重疊,關係到測試是否仍能測泛化。訓練集內部已經去重,也可能保留一份完整測試題;反過來,同主題文本並不自動構成題目洩漏。
論文報告:Lee 等人在 ACL 2022 的研究中同時考察近重複文檔、長重複子串與訓練驗證重疊,並觀察到去重後的記憶輸出減少。這個結論依賴其數據和訓練設置,不能推導為“任何數據刪得越多越好”。本文把輸出定義為可回查的文本對與處理清單,而非一個沒有分母的清洗率。論文與會議版本
汙染證據還要分層:找到相同片段,證明可見語料裡存在重疊;找到改寫題,支持進一步核查來源;證明某模型實際用過該材料,需要訓練清單、快照或受控實驗。僅憑答題正確、低困惑度或檢索相似度,都不能跨過最後一步。
核心思想與公式:三個尺度,兩個方向
第一層是規範化後的精確匹配。腳本採用 Unicode NFKC 規範化、大小寫摺疊和詞元提取,再計算 SHA256;哈希命中後仍比較規範化文本。這樣可消除本例中的大小寫和標點差異,但代碼、化學式、數字精度可能依賴這些差異,正式數據不能照搬同一規則。原文與變換版本必須同時保留。
第二層是 n-gram,即連續的 n 個詞元組成的片段。設文檔的片段集合為 ,定義:
是對稱的 Jaccard 相似度,適合比較全文重疊比例; 是查詢到文檔的定向覆蓋率,適合尋找短題被嵌入長文的情況。這裡 是基準文本, 是訓練文檔。分母為空時腳本返回零並單獨測試短文邊界,不能把兩個空集合判成重複。實驗取三詞片段,只為讓短例可觀察;中文應另定字級或分詞協議。
第三層是 embedding,即編碼器把文本映射成向量。若單位化後的表示為 ,則 的形狀為 ,元素 是餘弦相似度。 表示樣本數, 表示維數。候選發現只檢查上三角,避免自匹配與重複計數;跨集合矩陣則是 。向量接近表示編碼器認為相似,未必表示兩段話可互相替代。
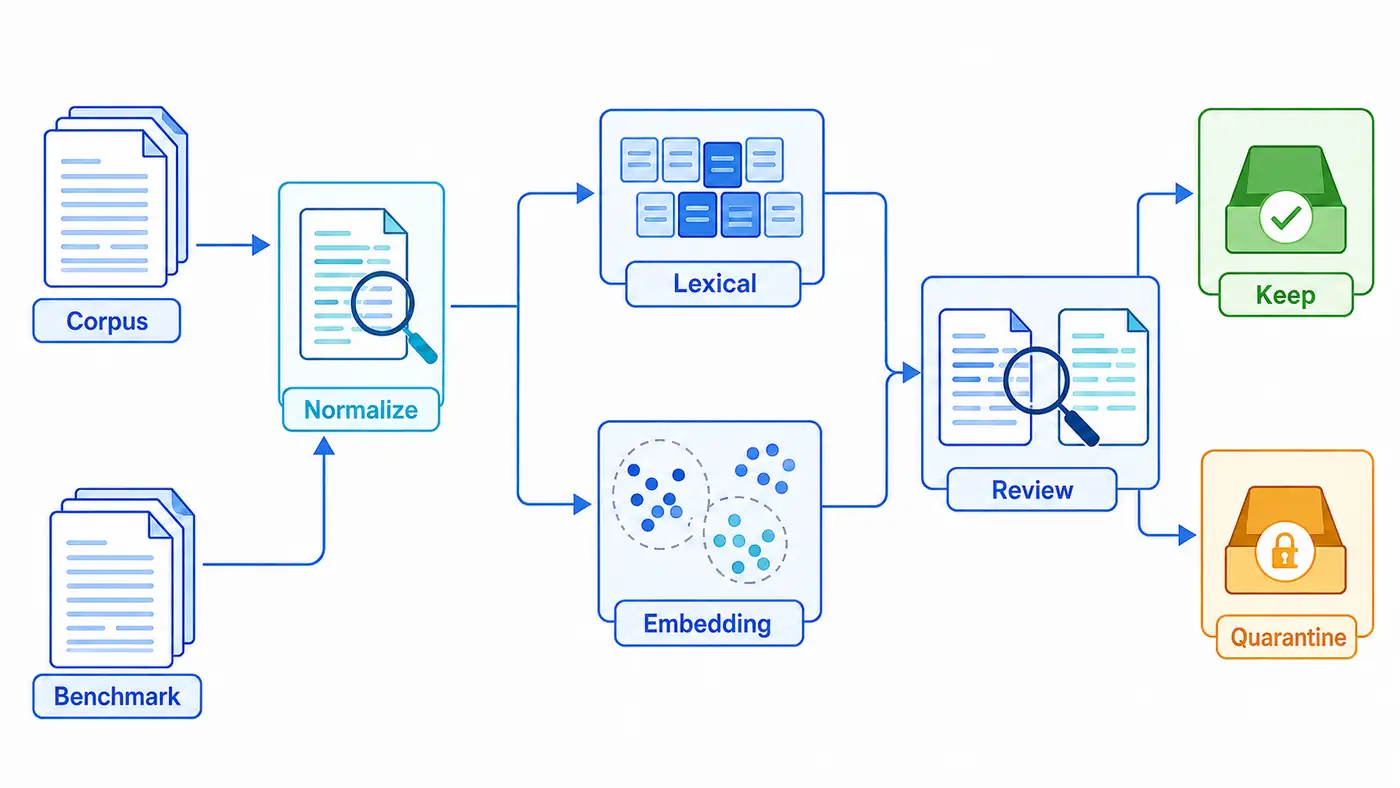
圖中語料與基準經過相同規範化,但始終保留各自的 split 標識;合流不代表把基準加入訓練。詞面與向量分支產生候選,經複核後決定保留或隔離。基準副本保持只讀,隔離清單針對待訓練材料。
官方代碼閱讀路線:從輸入契約走到刪除條件
先讀 Lee 等人的論文第 4 節,再看官方倉庫的 ExactSubstr 路線:scripts/make_suffix_array.py 調度索引構建,src/table.rs 處理後綴數組,src/main.rs 提供重複查詢。後綴數組對不同位置開始的序列排序,便於發現長公共片段;閱讀重點是字節位置如何映射回文檔邊界。倉庫發佈了 ExactSubstr 實現及 NearDup 文檔簇,不能把本文的兩兩 Jaccard 當成原版 NearDup。官方實現
接著讀 SemDeDup 的表示提取、聚類和簇內篩選。compute_pretrained_embeddings.py 將歸一化表示按全局索引寫入內存映射文件;semdedup.py 計算簇內相似矩陣,再沿上三角求每列最大值。當前源碼以 M > 1 - eps 標記刪除,因此固定分數時,增大 eps 會擴大刪除集合。README 對參數方向的描述與這一條件不一致,復現應以具體源碼和小例子確認,不能憑參數名猜測。代表樣本的排序同樣影響誰被保留。表示提取源碼、篩選源碼
論文報告:SemDeDup 使用預訓練表示發現語義冗餘,並在其圖文和語言實驗中研究數據效率;它不是一個自動判定所有近義文本都該刪除的標準。大型語料通過聚類縮小比較範圍,也可能遺漏簇邊界兩側的重複對。SemDeDup v3
最後讀 Yang 等人的改寫汙染論文與 LLM Decontaminator。論文說明改寫和翻譯可繞過字符串檢測;官方入口要求訓練集、測試集轉換為含 text 的 JSONL,再檢索候選並複核。閱讀時追蹤 top_k:沒有進入候選的題對,後續判斷器再強也無法找回。論文 v2、官方倉庫
最小實驗:讓漏檢和誤報同時出現
附帶腳本 code/minimal_dedup.py 構造六條訓練文本與三條基準文本。訓練側包含原句、大小寫標點變體、同義改寫、插入 never 的否定句、無關句,以及包含原句的長文。全文等義標籤只有三對正例,長文包含短句不屬於全文等義;這讓“全文去重”和“跨集合覆蓋”擁有明確不同的判據。
默認向量來自五組手寫同義詞映射後的詞袋,絕不是預訓練模型。它刻意保留一個可解釋缺陷:never 只增加一個維度,句子結論雖反轉,方向仍然接近。固定隨機種子為 64,詞表排序確定,輸入和腳本均記錄哈希。從文章目錄執行:
PYTHONPYCACHEPREFIX=/private/tmp/codex-ai-064-pycache python3 -m py_compile code/minimal_dedup.py
python3 code/minimal_dedup.py
本次實際驗證:Python 3.9.6 的 CPU 運行通過,向量形狀為 [9,26],比較了 15 對訓練文本與 18 對跨集合文本。精確匹配和閾值 0.5 的三詞 Jaccard 均得到 1 個真陽性、0 個假陽性、2 個假陰性;詞袋餘弦閾值 0.9 得到 3 個真陽性和 3 個假陽性,精確率 0.5、召回率 1.0。三個假陽性來自否定句與三條等義表述的組合。
跨集合覆蓋閾值 0.8 產生四對候選,其中原句在長文中的覆蓋率為 1,而全文 Jaccard 低於 0.5。腳本只自動隔離規範化精確重複的 t1,保留否定句 t3;其餘近似關係留待複核。全部分數、閾值掃描和輸入保存在 code/results.json,真實輸出見 code/smoke_test.txt。這組數據由作者構造,沒有獨立測試集,數字只說明程序行為。
可選分支可加載本地 SentenceTransformer 快照,依賴說明見 code/README.md。本次環境缺少相關依賴,真實模型推理未運行,待人工核驗。候選模型 all-MiniLM-L6-v2 為英文、384 維,模型卡說明默認截斷超過 256 word pieces 的輸入;它不能直接承擔中文長文實驗。不得將默認詞袋分數寫成該模型結果。模型卡
評測協議:分母、閾值和預算都要固定
首先定義標註單位。整篇等義、局部複製、題目改寫、通用模板共享應分開計數,並加入實體、數值、否定和條件改變的難負例。訓練去重報告成對精確率與召回率、保留文檔和詞元數量、各來源保留比例;汙染審計報告至少命中一次的基準題數除以基準總題數,不能把文本對數量當題目比例。
其次拆開檢索與判定。固定候選預算,測候選召回率,再測複核準確率;在開發集選擇閾值,凍結後評測。MinHash 用隨機簽名近似集合相似度,局部敏感哈希用於召回候選,兩者都不取代原文驗證。固定簽名種子、分桶方式和候選上限,再與小規模窮舉對照,才能知道漏檢來自索引還是判定。
執行層面還需要一個獨立的汙染登記表:每條記錄保存基準編號、訓練文檔編號、原始匹配片段、字符偏移、變換規則、候選分數、來源時間及複核結論。若只保存刪除後的數據,下次更新分詞器時就無法解釋樣本為什麼消失。先產生可逆隔離清單,核對代表選擇與來源比例,再派生新訓練快照;不得回寫基準題來讓重疊率變小。
數據切分也應先考慮重複家族。若改寫版本先隨機分到訓練與驗證,隨後僅在各自內部去重,洩漏仍然存在。可以按已核驗的家族或原始來源分組切分,並另外審計外部基準。這裡的家族來自可靠來源關係或人工確認,不能直接用相似圖連通分量替代。對人工抽查應記錄隨機種子和抽樣概率,分層抽到的高風險候選比例不能直接當作總體汙染率。
最後比較模型效果時,同時設計固定訓練詞元預算與固定遍歷輪數兩種協議。刪除樣本後訓練更快,可能只是總更新減少;只報耗時無法區分效率與訓練量。對“未命中”子集另報分數、樣本數和難度分佈,不能把篩掉容易題後的分數差直接歸因於汙染。模型版本、訓練快照不可見時,應寫“所審計語料未檢出”,而不是“模型無汙染”。
失敗排查:相似圖不是等價關係
若長文裡的短題漏檢,查分母、切塊和截斷;若中文召回崩潰,查分詞單位與多語言表示;若模板導致誤報,檢查公共免責聲明是否主導片段集合。若負例被刪除,優先回看否定詞、數字和條件是否被規範化抹去。原始偏移與變換日誌比單獨一個分數更有診斷價值。
另一類隱蔽錯誤是連通分量合併。腳本構造方向分別為零、二十、四十度的三個單位向量;閾值 0.9 下,相鄰兩對有邊,首尾卻不夠相似。若每個連通分量只留一條,就可能刪掉與代表並不近似的端點。該斷言已經運行通過。正式流程可檢查成員到代表的相似度,並抽查鏈條長度,不能把傳遞閉包誤寫成語義等價證明。
後續科研問題
作者推斷,值得繼續研究的不是尋找通用刪除閾值,而是在有限複核預算下保住信息多樣性。可以比較固定保留率時不同編碼器對否定和罕見實體的誤刪;比較隨機保留、中心樣本與困難樣本對下游泛化的影響;研究跨語言改寫汙染的候選召回。每個問題都應先定義獨立標註集、來源分層和失敗判據,再啟動訓練。
總結
可靠去重是一項證據管理實驗。詞面方法提供可定位的重疊,向量方法擴大候選範圍,人工或受控複核決定語義關係;來源記錄幫助判斷這些關係是否與訓練汙染有關。本文實際復現了漏改寫、誤判否定、長短文覆蓋和相似鏈四種邊界,並留下可重跑的日誌。下一步應把同樣協議遷移到有授權的真實語料,先核驗候選質量,再討論訓練收益。
參考資料
檢索日期:2026-09-05。上述鏈接均已實際打開。分支源碼隨訪問日期記錄,未聲稱固定 commit;官方訓練、大規模去重和真實編碼器結果均待人工核驗。
- Katherine Lee、Daphne Ippolito 等,2022,Deduplicating Training Data Makes Language Models Better,ACL 定稿全文。
- Amro Abbas、Kushal Tirumala、Dániel Simig、Surya Ganguli、Ari S. Morcos,2023,SemDeDup: Data-efficient learning at web-scale through semantic deduplication,論文、官方代碼。
- Shuo Yang、Wei-Lin Chiang、Lianmin Zheng、Joseph E. Gonzalez、Ion Stoica,2023,Rethinking Benchmark and Contamination for Language Models with Rephrased Samples,論文。
- Sentence Transformers,all-MiniLM-L6-v2 模型卡。