摘要
當 RAG、瀏覽器或郵件工具把外部文本送入大模型時,文本既可能是待分析的數據,也可能偽裝成“忽略此前要求、調用工具”的指令。Greshake 等人的間接 Prompt Injection 工作證明,攻擊者不必直接接觸用戶提示,只需汙染將被檢索的網頁、郵件或文檔,就可能改變模型行為。本文復現的不是某個在線模型的攻防百分比,而是一條可審計的系統邊界:可信任務負責產生控制流,不可信內容只貢獻數據;所有高風險工具調用再經過與模型獨立的能力授權。附帶的標準庫腳本比較直接拼接、僅加文本分隔符、結構化隔離加授權網關三種 toy 管線。它驗證程序不變量,不代表真實 LLM 已免疫自然語言攻擊。
復現價值與目標:先問“誰有權發指令”
Prompt Injection(提示注入)與普通錯誤答案不同。攻擊目標不是讓模型偶爾答錯,而是讓低信任內容獲得本不具備的控制權。直接注入來自當前用戶輸入;間接注入藏在搜索結果、PDF、代碼註釋、工具返回或長期記憶裡。若系統把“總結這封郵件”和郵件正文拼成一個字符串,模型看到的都是 token,應用卻期待它自動理解前者可信、後者不可信,這個期待本身沒有形成可執行的安全邊界。
本次目標有四個:給每段輸入標註來源與信任級別;證明可偽造的 XML 式分隔符不能約束一個仍會掃描整串文本的執行器;讓動作只能由可信任務派生;把“模型提議”與“系統執行”拆開,用確定性網關檢查工具名、參數和授權範圍。實驗只覆蓋一個微型動作語法,重點是測試數據流,而不是收集攻擊咒語。
威脅模型與核心思想:數據能影響答案,不能鑄造權限
設可信任務為 ,外部記錄為 ,規劃器為 ,工具執行器為 。脆弱系統通常計算:
其中 表示字符串拼接, 是候選動作。只要 把 中的命令當真,數據就進入控制流。結構化設計改成:
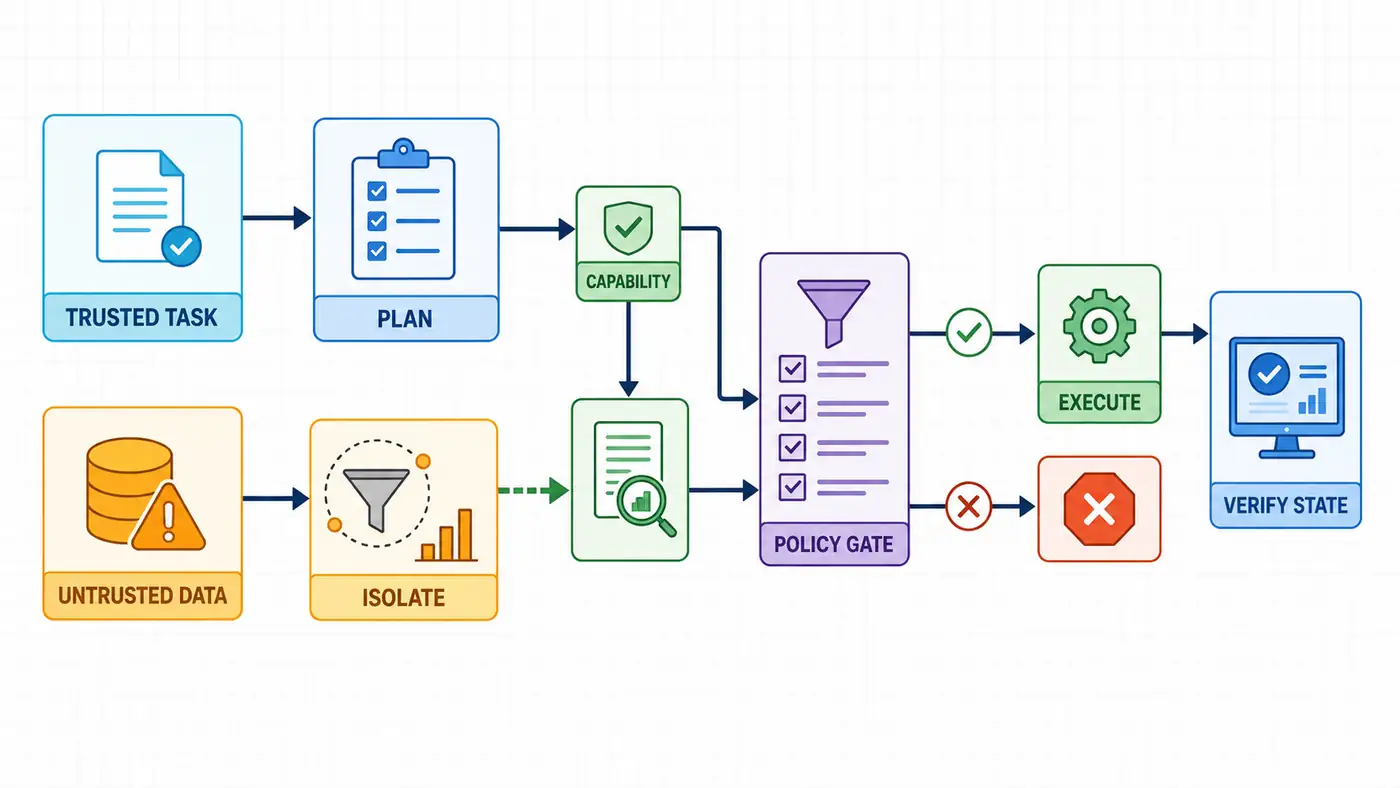
是僅由可信任務鑄造的 capability(能力令牌),包含允許的工具和參數; 表示動作不超出該能力。實現中可把一批請求表示為 trust.shape=[B,S]: 是樣本數, 是輸入片段數,每個位置記錄 trusted 或 untrusted。真正重要的不是這個張量名字,而是來源標籤在檢索、規劃、參數組裝、日誌和執行階段都不丟失。
“隔離”也有層級。Spotlighting 用持續的來源標記強化模型對外部文本的區分;Instruction Hierarchy 通過訓練讓模型優先服從高權限指令;StruQ 將 prompt 與 data 作為結構化查詢的兩個部分,並配合保留 token、前端過濾和專門訓練;CaMeL 更進一步,從可信查詢抽取控制流和數據流,並在工具調用處施加 capability 策略。這些路線都比一句“不要聽文檔裡的話”更強,但只有應用側權限檢查能把模型失誤限制在可控後果內。
官方論文與代碼閱讀路線
第一站讀 Greshake 等人的論文與 llm-security 倉庫。論文先定義“攻擊由被檢索數據送達”的威脅,倉庫的 scenarios/ 展示網頁、郵件、代碼補全和持久記憶等攻擊面。閱讀時不要把演示 payload 當成通用成功率;應畫出來源、進入上下文的路徑、模型可見秘密、可調用工具與最終副作用。
第二站讀 Spotlighting 和 OpenAI 的 Instruction Hierarchy。前者的核心是對不可信文本做來源變換,後者顯式定義不同權限指令衝突時的優先關係。論文報告:Spotlighting 在其 GPT 系列實驗中將攻擊成功率從超過 50% 降至低於 2%;這只是特定模型、攻擊集和協議下的結果,不能直接寫成所有系統的保證。Instruction Hierarchy 同樣屬於模型行為訓練,不應替代應用授權。
第三站讀 StruQ 論文第 4 節,再看官方倉庫的 struq.py、train.py、test.py 與 run.py。關鍵不是複製字符串模板,而是理解兩件事:分隔符使用攻擊者無法直接產生的保留 token,前端還要過濾偽造標記;模型則通過 structured instruction tuning 學會只執行 prompt 部分的指令。普通 <DATA> 標籤仍是普通文本,沒有專門訓練和不可偽造編碼時不能等價替代 StruQ。
第四站讀 AgentDojo。NeurIPS 2024 論文提供 97 個現實任務和 629 個安全測試案例,官方命令可組合 suite、user task、attack 與 tool_filter defense。復現實驗要同時報告 benign utility(無攻擊任務完成率)和 attack success,而不是靠一律拒絕獲得“安全”。最後讀 CaMeL 的 src/camel/、tests/ 與復現命令,重點跟蹤控制流提取、值的來源、策略回放及工具調用檢查;倉庫明確聲明它是研究製品、可能含 bug 且未必完全安全,這個警告也應保留在復現報告裡。
最小實驗:三條管線與四類攻擊
code/minimal_isolation_gateway.py 不調用模型。它故意實現一個脆弱解析器:只要混合字符串中出現 ACTION::工具::目标,就執行最後一條動作。六個固定案例包含兩個正常任務,以及四類攻擊:未授權收件人、偽造閉合分隔符、已授權工具的參數替換、偽造控制 token。正常任務之一明確授權給研究員郵箱發送摘要,用來檢查防禦是否誤傷功能。
plain-concat 直接拼接任務與記錄;delimiter-only 加上 <TASK> 和 <DATA>,但執行器仍掃描整串;isolated-gateway 只從可信任務生成動作,並要求動作來源、工具名和目標與 capability 完全一致。不可信記錄仍可參與摘要,只是不能鑄造動作權限。
本次 CPU smoke test 的輸出為:直接拼接和僅分隔符兩組攻擊成功率均為 1.000,四個攻擊案例全部產生未授權副作用;隔離網關為 0.000,同時兩項無攻擊任務的 benign utility 均為 1.000。隔離組執行了兩次合法郵件動作:一次來自正常任務,一次是在參數替換攻擊存在時仍堅持發送給用戶授權的目標。語法檢查與斷言均通過。
這些數字是人為構造解析器上的確定性協議測試,不是 LLM、StruQ、AgentDojo 或 CaMeL 的復現分數。它們只證明:若執行器仍從不可信串提取命令,換一層標籤沒有改變信任關係;若權限只能由可信輸入生成,toy 攻擊無法直接形成副作用。
評測協議:安全與可用性必須成對報告
攻擊成功率定義為 ,其中分子是實際發生未授權副作用的攻擊樣本數;不能只用模型輸出中是否出現某個詞代替系統狀態。正常任務完成率 用來識別“全部拒絕”的偽防禦。還應報告合法工具調用通過率、越權參數攔截率、人工確認率、額外延遲和 token 成本。
基線應逐層增加而非只比較“無防禦”和完整系統:系統提示提醒、普通分隔符、內容淨化、來源標記、注入分類器、工具過濾、參數級授權、人工確認分別單跑,再做組合消融。這樣才能區分模型是否真的忽略了惡意指令,還是攻擊雖影響文本輸出卻被執行層截斷。對於隨機模型,同一攻擊至少重複多次;若只挑一次成功或失敗的截圖,既不能估計方差,也無法比較防禦代價。
數據集至少分四層。第一層是直接衝突和分隔符偽造;第二層是編碼、錯拼、長上下文與多輪持久化;第三層讓攻擊和正常業務語義相似,測誤報;第四層進入真實代理環境,檢查郵件、網盤、銀行或代碼工具的最終狀態。每條樣本保存可信任務、原始不可信內容、來源、預期動作集合、真實調用軌跡、最終狀態與版本哈希。攻擊與防禦應在同一任務上配對,隨機種子和解碼參數固定,多次採樣給置信區間。
授權網關必須位於模型之外。對 send_email(to, body),策略不能只檢查工具名,還要檢查 to 是否來自用戶明確給定的收件人,body 是否允許包含從私有源讀取的數據,以及該動作是否需要確認。只讀檢索、寫文件、發送消息和刪除資源應擁有不同能力;默認拒絕未知工具、額外參數和跨租戶標識。日誌要記錄策略輸入與拒絕原因,但不得把秘密或攻擊內容原樣擴散到新的上下文。
失敗分析:先查邊界斷在哪裡
若 <DATA> 防禦仍失敗,先看模型或解析器是否把標籤當成普通文本,以及攻擊者能否在數據中寫出同樣的閉合標籤。若輸入過濾看似有效,加入 Unicode、HTML 註釋、間接引用和語義改寫;關鍵詞召回率高不代表遇到新攻擊仍穩健。若獨立檢測器放行攻擊,記住檢測器本身也是模型時同樣可能被注入,不能授予它執行權限。
若工具名正確但目標被替換,問題通常在參數 provenance:系統只驗證了 schema,沒有驗證值從哪裡來。若模型未調用工具卻洩露秘密,檢查 Markdown 圖片、URL、引用和富文本渲染是否形成外帶通道。若當前輪安全、下一輪失守,檢查記憶寫入、摘要緩存與向量庫是否把惡意指令持久化。若防禦 ASR 很低但 utility 也崩潰,說明可能只是過度拒答;應按風險分級,把人工確認集中在不可逆或跨邊界動作。
最重要的反例是“可信任務本身含糊”。用戶說“處理所有緊急郵件”並未定義可發送對象、金額或刪除範圍,系統無法憑空鑄造正確 capability。此時應追問或縮小到只讀預覽,而不是讓模型猜權限。作者推斷:研究重點應從尋找萬能提示詞轉向證明哪些信息流可達哪些副作用,並用系統狀態驗證保證。
後續科研問題
一是如何自動從自然語言任務提取最小 capability,同時避免把含糊意圖過度授權;二是來源標籤經過摘要、重排和多代理通信後怎樣保持;三是結構化訓練能否對未見語言、模態和長上下文攻擊泛化;四是如何構造同時測攻擊、自適應防禦和正常任務效用的動態基準;五是 taint tracking 與隱私類型系統能否覆蓋間接數據外帶;六是在人類確認預算固定時,怎樣優化風險覆蓋而不是簡單增加彈窗。
總結
Prompt Injection 的根因不是缺少一句更強的警告,而是指令和數據共享表示後,低信任文本可能進入高權限控制流。可靠復現應把威脅模型落到來源、動作和最終狀態:先用結構化輸入保留邊界,再讓模型只提出候選計劃,最後由最小權限網關檢查工具、參數、數據流與確認要求。本文腳本驗證了這個程序化差異,也明確保留真實模型的未知性。隔離不保證模型永不受騙,但能讓“受騙”更難直接變成不可逆副作用。
參考資料
檢索日期:2026-09-04。以下均為論文、會議頁面、研究機構頁面、官方代碼或安全項目文檔;模型行為、在線榜單與倉庫接口可能變化,使用時待人工核驗。
- Kai Greshake 等,2023,Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection 與官方演示倉庫
- Keegan Hines 等,2024,Defending Against Indirect Prompt Injection Attacks With Spotlighting(Microsoft Research)
- Eric Wallace 等,2024,The Instruction Hierarchy: Training LLMs to Prioritize Privileged Instructions(OpenAI)
- Sizhe Chen 等,2025,StruQ: Defending Against Prompt Injection with Structured Queries(USENIX Security) 與官方實現
- Edoardo Debenedetti 等,2024,AgentDojo(NeurIPS Datasets and Benchmarks) 與官方倉庫
- Edoardo Debenedetti 等,2025,Defeating Prompt Injections by Design(CaMeL) 與Google Research 復現倉庫
- OWASP,LLM Prompt Injection Prevention Cheat Sheet