- 系列:开源 AI 论文复现实验与代码解读|第五轮 064
- 日期:2026-09-05
- 读者:研究生、科研新人和工程型研究者
摘要
一份语料删掉很多行,是否意味着实验更可信?未必。重复可以是完全相同的文档、被复制的一段话,也可以是换了措辞的同一道题;高相似度还可能来自结论相反的句子。本文围绕一个可执行目标:构建同时保留词面证据、向量分数和数据来源的审计脚本,观察去重怎样漏掉改写,又怎样误伤否定句。最小实验不训练语言模型,实际验证的是候选发现与隔离协议;论文中的记忆、训练效率和评测改善,不作为本次复现结果。
复现价值:先分清“删重复”和“查污染”
去重研究的是训练集合内部的冗余:重复样本会改变采样权重,使某些表达被反复学习。污染检测研究的是训练材料与评测题之间的重叠,关系到测试是否仍能测泛化。训练集内部已经去重,也可能保留一份完整测试题;反过来,同主题文本并不自动构成题目泄漏。
论文报告:Lee 等人在 ACL 2022 的研究中同时考察近重复文档、长重复子串与训练验证重叠,并观察到去重后的记忆输出减少。这个结论依赖其数据和训练设置,不能推导为“任何数据删得越多越好”。本文把输出定义为可回查的文本对与处理清单,而非一个没有分母的清洗率。论文与会议版本
污染证据还要分层:找到相同片段,证明可见语料里存在重叠;找到改写题,支持进一步核查来源;证明某模型实际用过该材料,需要训练清单、快照或受控实验。仅凭答题正确、低困惑度或检索相似度,都不能跨过最后一步。
核心思想与公式:三个尺度,两个方向
第一层是规范化后的精确匹配。脚本采用 Unicode NFKC 规范化、大小写折叠和词元提取,再计算 SHA256;哈希命中后仍比较规范化文本。这样可消除本例中的大小写和标点差异,但代码、化学式、数字精度可能依赖这些差异,正式数据不能照搬同一规则。原文与变换版本必须同时保留。
第二层是 n-gram,即连续的 n 个词元组成的片段。设文档的片段集合为 $G_n(x)$,定义:
[ J(x,y)=\frac{|G_n(x)\cap G_n(y)|}{|G_n(x)\cup G_n(y)|},\qquad C(q,d)=\frac{|G_n(q)\cap G_n(d)|}{|G_n(q)|}. ]
$J$ 是对称的 Jaccard 相似度,适合比较全文重叠比例;$C$ 是查询到文档的定向覆盖率,适合寻找短题被嵌入长文的情况。这里 $q$ 是基准文本,$d$ 是训练文档。分母为空时脚本返回零并单独测试短文边界,不能把两个空集合判成重复。实验取三词片段,只为让短例可观察;中文应另定字级或分词协议。
第三层是 embedding,即编码器把文本映射成向量。若单位化后的表示为 $E\in\mathbb{R}^{N\times D}$,则 $S=EE^\top$ 的形状为 $N\times N$,元素 $S_{ij}$ 是余弦相似度。$N$ 表示样本数,$D$ 表示维数。候选发现只检查上三角,避免自匹配与重复计数;跨集合矩阵则是 $N_{test}\times N_{train}$。向量接近表示编码器认为相似,未必表示两段话可互相替代。
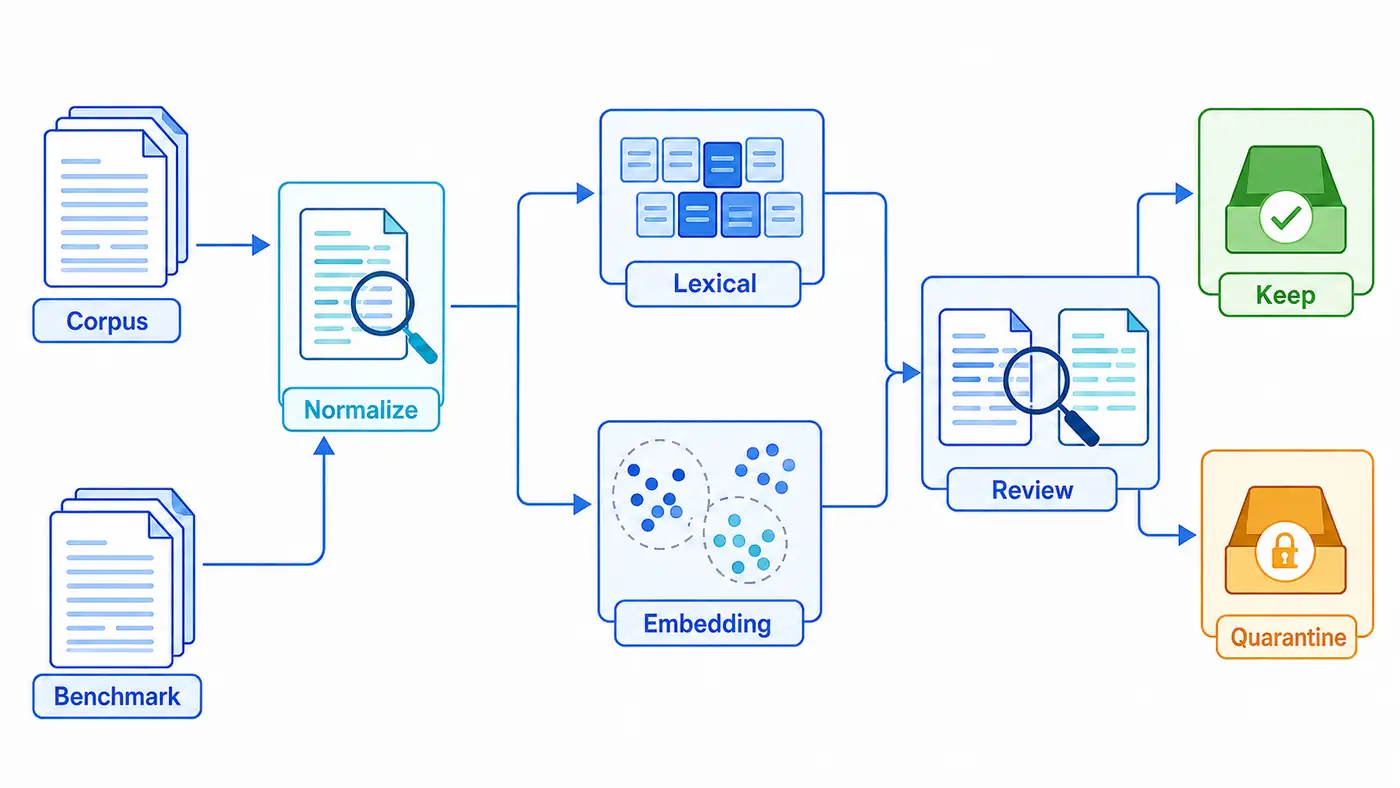
图中语料与基准经过相同规范化,但始终保留各自的 split 标识;合流不代表把基准加入训练。词面与向量分支产生候选,经复核后决定保留或隔离。基准副本保持只读,隔离清单针对待训练材料。
官方代码阅读路线:从输入契约走到删除条件
先读 Lee 等人的论文第 4 节,再看官方仓库的 ExactSubstr 路线:scripts/make_suffix_array.py 调度索引构建,src/table.rs 处理后缀数组,src/main.rs 提供重复查询。后缀数组对不同位置开始的序列排序,便于发现长公共片段;阅读重点是字节位置如何映射回文档边界。仓库发布了 ExactSubstr 实现及 NearDup 文档簇,不能把本文的两两 Jaccard 当成原版 NearDup。官方实现
接着读 SemDeDup 的表示提取、聚类和簇内筛选。compute_pretrained_embeddings.py 将归一化表示按全局索引写入内存映射文件;semdedup.py 计算簇内相似矩阵,再沿上三角求每列最大值。当前源码以 M > 1 - eps 标记删除,因此固定分数时,增大 eps 会扩大删除集合。README 对参数方向的描述与这一条件不一致,复现应以具体源码和小例子确认,不能凭参数名猜测。代表样本的排序同样影响谁被保留。表示提取源码、筛选源码
论文报告:SemDeDup 使用预训练表示发现语义冗余,并在其图文和语言实验中研究数据效率;它不是一个自动判定所有近义文本都该删除的标准。大型语料通过聚类缩小比较范围,也可能遗漏簇边界两侧的重复对。SemDeDup v3
最后读 Yang 等人的改写污染论文与 LLM Decontaminator。论文说明改写和翻译可绕过字符串检测;官方入口要求训练集、测试集转换为含 text 的 JSONL,再检索候选并复核。阅读时追踪 top_k:没有进入候选的题对,后续判断器再强也无法找回。论文 v2、官方仓库
最小实验:让漏检和误报同时出现
附带脚本 code/minimal_dedup.py 构造六条训练文本与三条基准文本。训练侧包含原句、大小写标点变体、同义改写、插入 never 的否定句、无关句,以及包含原句的长文。全文等义标签只有三对正例,长文包含短句不属于全文等义;这让“全文去重”和“跨集合覆盖”拥有明确不同的判据。
默认向量来自五组手写同义词映射后的词袋,绝不是预训练模型。它刻意保留一个可解释缺陷:never 只增加一个维度,句子结论虽反转,方向仍然接近。固定随机种子为 64,词表排序确定,输入和脚本均记录哈希。从文章目录执行:
PYTHONPYCACHEPREFIX=/private/tmp/codex-ai-064-pycache python3 -m py_compile code/minimal_dedup.py
python3 code/minimal_dedup.py
本次实际验证:Python 3.9.6 的 CPU 运行通过,向量形状为 [9,26],比较了 15 对训练文本与 18 对跨集合文本。精确匹配和阈值 0.5 的三词 Jaccard 均得到 1 个真阳性、0 个假阳性、2 个假阴性;词袋余弦阈值 0.9 得到 3 个真阳性和 3 个假阳性,精确率 0.5、召回率 1.0。三个假阳性来自否定句与三条等义表述的组合。
跨集合覆盖阈值 0.8 产生四对候选,其中原句在长文中的覆盖率为 1,而全文 Jaccard 低于 0.5。脚本只自动隔离规范化精确重复的 t1,保留否定句 t3;其余近似关系留待复核。全部分数、阈值扫描和输入保存在 code/results.json,真实输出见 code/smoke_test.txt。这组数据由作者构造,没有独立测试集,数字只说明程序行为。
可选分支可加载本地 SentenceTransformer 快照,依赖说明见 code/README.md。本次环境缺少相关依赖,真实模型推理未运行,待人工核验。候选模型 all-MiniLM-L6-v2 为英文、384 维,模型卡说明默认截断超过 256 word pieces 的输入;它不能直接承担中文长文实验。不得将默认词袋分数写成该模型结果。模型卡
评测协议:分母、阈值和预算都要固定
首先定义标注单位。整篇等义、局部复制、题目改写、通用模板共享应分开计数,并加入实体、数值、否定和条件改变的难负例。训练去重报告成对精确率与召回率、保留文档和词元数量、各来源保留比例;污染审计报告至少命中一次的基准题数除以基准总题数,不能把文本对数量当题目比例。
其次拆开检索与判定。固定候选预算,测候选召回率,再测复核准确率;在开发集选择阈值,冻结后评测。MinHash 用随机签名近似集合相似度,局部敏感哈希用于召回候选,两者都不取代原文验证。固定签名种子、分桶方式和候选上限,再与小规模穷举对照,才能知道漏检来自索引还是判定。
执行层面还需要一个独立的污染登记表:每条记录保存基准编号、训练文档编号、原始匹配片段、字符偏移、变换规则、候选分数、来源时间及复核结论。若只保存删除后的数据,下次更新分词器时就无法解释样本为什么消失。先产生可逆隔离清单,核对代表选择与来源比例,再派生新训练快照;不得回写基准题来让重叠率变小。
数据切分也应先考虑重复家族。若改写版本先随机分到训练与验证,随后仅在各自内部去重,泄漏仍然存在。可以按已核验的家族或原始来源分组切分,并另外审计外部基准。这里的家族来自可靠来源关系或人工确认,不能直接用相似图连通分量替代。对人工抽查应记录随机种子和抽样概率,分层抽到的高风险候选比例不能直接当作总体污染率。
最后比较模型效果时,同时设计固定训练词元预算与固定遍历轮数两种协议。删除样本后训练更快,可能只是总更新减少;只报耗时无法区分效率与训练量。对“未命中”子集另报分数、样本数和难度分布,不能把筛掉容易题后的分数差直接归因于污染。模型版本、训练快照不可见时,应写“所审计语料未检出”,而不是“模型无污染”。
失败排查:相似图不是等价关系
若长文里的短题漏检,查分母、切块和截断;若中文召回崩溃,查分词单位与多语言表示;若模板导致误报,检查公共免责声明是否主导片段集合。若负例被删除,优先回看否定词、数字和条件是否被规范化抹去。原始偏移与变换日志比单独一个分数更有诊断价值。
另一类隐蔽错误是连通分量合并。脚本构造方向分别为零、二十、四十度的三个单位向量;阈值 0.9 下,相邻两对有边,首尾却不够相似。若每个连通分量只留一条,就可能删掉与代表并不近似的端点。该断言已经运行通过。正式流程可检查成员到代表的相似度,并抽查链条长度,不能把传递闭包误写成语义等价证明。
后续科研问题
作者推断,值得继续研究的不是寻找通用删除阈值,而是在有限复核预算下保住信息多样性。可以比较固定保留率时不同编码器对否定和罕见实体的误删;比较随机保留、中心样本与困难样本对下游泛化的影响;研究跨语言改写污染的候选召回。每个问题都应先定义独立标注集、来源分层和失败判据,再启动训练。
总结
可靠去重是一项证据管理实验。词面方法提供可定位的重叠,向量方法扩大候选范围,人工或受控复核决定语义关系;来源记录帮助判断这些关系是否与训练污染有关。本文实际复现了漏改写、误判否定、长短文覆盖和相似链四种边界,并留下可重跑的日志。下一步应把同样协议迁移到有授权的真实语料,先核验候选质量,再讨论训练收益。
参考资料
检索日期:2026-09-05。上述链接均已实际打开。分支源码随访问日期记录,未声称固定 commit;官方训练、大规模去重和真实编码器结果均待人工核验。
- Katherine Lee、Daphne Ippolito 等,2022,Deduplicating Training Data Makes Language Models Better,ACL 定稿全文。
- Amro Abbas、Kushal Tirumala、Dániel Simig、Surya Ganguli、Ari S. Morcos,2023,SemDeDup: Data-efficient learning at web-scale through semantic deduplication,论文、官方代码。
- Shuo Yang、Wei-Lin Chiang、Lianmin Zheng、Joseph E. Gonzalez、Ion Stoica,2023,Rethinking Benchmark and Contamination for Language Models with Rephrased Samples,论文。
- Sentence Transformers,all-MiniLM-L6-v2 模型卡。