- 系列:开源 AI 论文复现实验与代码解读|第五轮 065
- 日期:2026-09-06
- 读者:研究生、科研新人和工程型研究者
摘要
生成一万条指令很容易,解释留下哪一千条却很难。回答流畅可能掩盖错误,高分样本可能都来自同一模板,最难的题也可能只是标签有误。本文围绕一个复现目标:在固定保留预算下,用可检查的质量分类器、多样性约束和难例配额选择合成样本,并保存每次选择的证据。我们阅读 Self-Instruct 与 DEITA 的官方实现,实际运行一个纯 Python 实验;验证的是筛选行为,不声称复现论文的语言模型训练收益。
复现价值:把“好数据”拆成三个可证伪的问题
质量问单条样本是否值得学习,多样性问它相对已选集合是否提供新信息,难度问当前学习者是否尚未掌握。三者不能共用一个未经定义的分数。重复的正确答案可能质量合格却冗余;罕见任务可能很有价值,也可能是生成器胡编;高损失同时可能来自知识缺口和错误标签。
论文报告:Self-Instruct 通过种子指令引导生成,再过滤无效或相似样本用于指令微调,证明了合成指令路线的可行性。其结论依赖当时的模型、生成设置和评测,不能理解成生成文本天然可靠。ACL 2023 论文
DEITA 将复杂度、质量和多样性分别度量,再联合选择数据。它的研究对象包含来自不同来源的指令数据池,并非所有记录都是同一种生成器产生。本文借用它的选择思想处理受控合成数据,额外加入可执行检查和难例配额;后两者是教学实验设计,不冒充原算法。DEITA 定稿 v2
核心思想与公式:分数是代理,集合才是输出
quality classifier 指质量分类器:根据标注预测样本属于“可用”类别的程度。标签要先写清,本例只学习可读算术解释与空回答、重复填充之间的区别。令特征矩阵为 $X\in\mathbb R^{N\times4}$,采用逻辑回归:
[ p_i=\sigma(w^\top x_i),\quad \mathcal L=-\frac1N\sum_i[y_i\log p_i+(1-y_i)\log(1-p_i)]. ]
$N$ 是训练样本数,$x_i$ 包括截距、是否非空、截断词数和词元去重比;$w$ 为四维参数,$y_i$ 是二元标签,输出 $p$ 为长度 $N$ 的向量。代码优化时另加非截距参数的二范数正则。这个模型无法计算答案真伪,输出也未经独立概率校准,不能称为“正确率”。
DEITA 使用另一种评分器:先对同源演化版本排序评分,再训练模型预测复杂度和质量。官方推理在六个分值对应的 token 上归一化得分并求期望,得到标量;并不是本文的二分类训练。评分源码
对已归一化的向量 $e_i\in\mathbb R^D$,本例的多样性规则为:
[ \max_{j\in S}e_i^\top e_j\leq\tau. ]
$S$ 是已保留代表集合,$D$ 是表示维数,$\tau$ 是相似度上限;空集合直接接收第一条。一次候选比较产生长度 $|S|$ 的分数。这里明确使用相似度:越大越接近。本次向量是人工任务类别的独热编码,即一个位置为一、其余为零,不能据此证明真实语义覆盖。
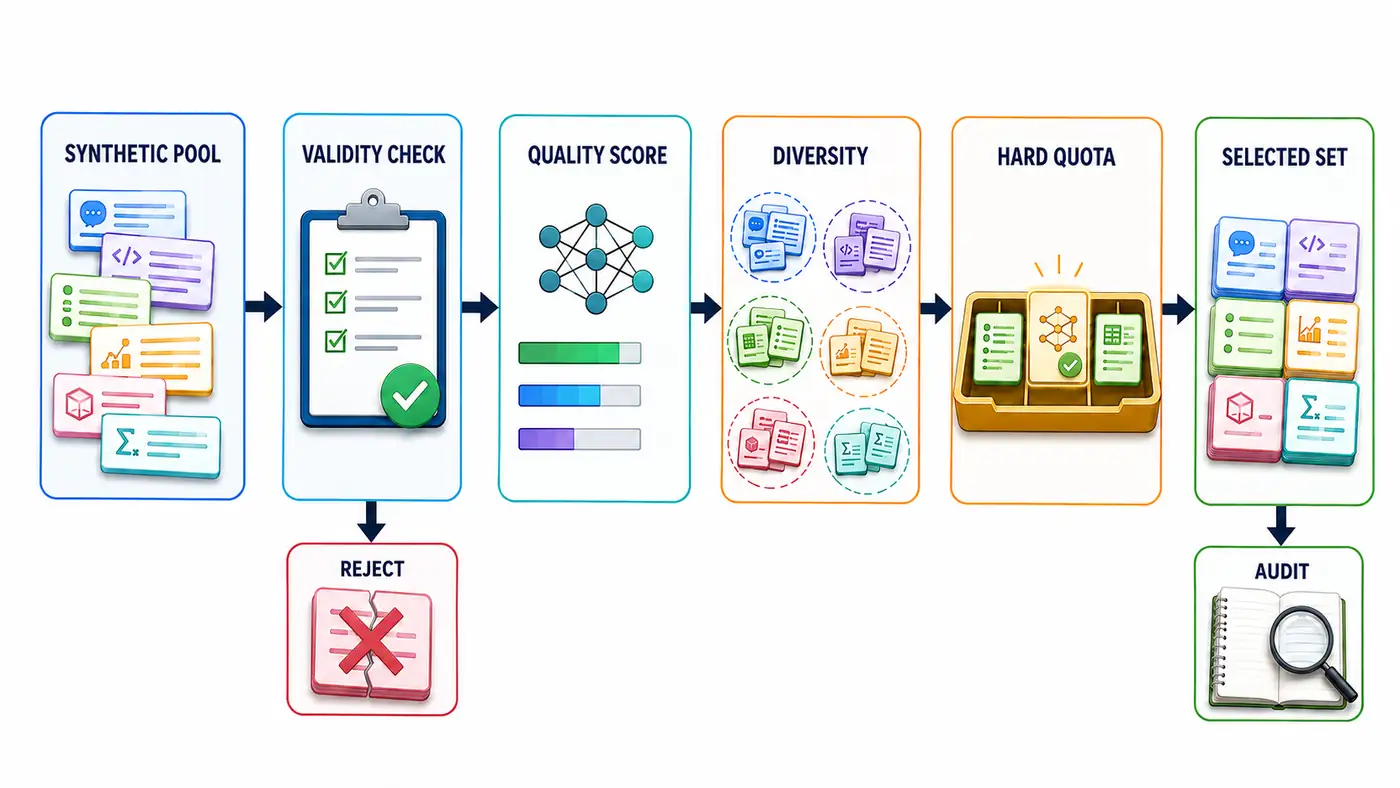
图示先排除可验证的无效样本,再评分、构造多样代表,最后在预算内安排难例并审计。图中条形仅示意评分,卡片颜色仅示意任务差异。难例必须已经通过有效性与质量检查,配额不能把错误答案重新引入训练。
官方代码阅读路线:从字段追到不等号
先读 Self-Instruct 的 bootstrap_instructions.py。它用最长公共子序列相关的 ROUGE-L 检查指令相似度,超过 0.7 时跳过;同时过滤过短过长指令、非 ASCII 开头等情况。后者服务于原始英文设置,复制到中文流程会直接误删正常指令。这个阈值也不是语义等价标准。指令生成源码
再读 prepare_for_finetuning.py 的解析与过滤函数:空输出、输入输出相同、冒号结尾的疑似残缺记录会被过滤;同一非空输入出现不同输出时会丢弃该组实例。这有助于清理矛盾标签,但开放写作本来可能有多个合理答案,规则必须服从任务定义。实例清理源码
DEITA 从 score_pipeline.py 追踪多轮对话如何按位置组成指令回答对;然后看 filter_pipeline.py,分数列表被按行写入向量表,选出的 idx 又索引原 JSON。若向量导出后单独洗牌,即使长度一致也会静默错配。复现时应保存稳定样本编号,并逐条核对原文摘要。评分管线、筛选管线
最后读 combined_filter.py:逐轮质量与复杂度相乘,再求和排序。别被日志里拼接的加号误导。进入 filter/base.py 后,名为 compute_distance 的 cosine 分支实际返回归一化点积,严格大于阈值才排除。论文把该量叫距离,源码揭示了具体方向;本例还测试恰等于阈值的行为。联合排序、相似度筛选
最小实验:让高分、覆盖与正确性分开变化
code/minimal_filter.py 用确定性模板构造数据,没有调用语言模型。训练集二十四条、开发集六条,按算术种子家族分开,但共享模板,因此只是控制实验。开发集扫描五个阈值,以精确率与召回率的调和平均值 F1 选择,平局时取最接近 0.5 的值;候选数据从不参与拟合或选阈值。
候选池十四条,含加法、排序、字符串反转、平方和四类,以及一个流畅错误答案和一个空回答。平方和被手工定义为难例,不代表实际学生模型的困难程度。正确性检查只比较结构化 answer 与内置运算结果,不审查自然语言解释中的每句话。从文章目录执行:
PYTHONPYCACHEPREFIX=/private/tmp/codex-ai-065-pycache python3 -m py_compile code/minimal_filter.py
python3 code/minimal_filter.py > code/smoke_test.txt
本次实际验证:Python 3.9.6、CPU、种子 65;训练、开发与候选特征形状分别为 [24,4]、[6,4]、[14,4]。训练二元交叉熵从 0.693147 降到 0.027918,选定阈值为 0.5,十二条候选同时通过质量和结构检查。开发模板太容易,这些数字不能作为真实质量分类器的泛化性能。
| 策略,保留预算均为三条 | 四类任务覆盖率 | 难例条数 | 回答词数合计 |
|---|---|---|---|
| 合格池随机抽样 | 0.75 | 1 | 46 |
| 仅质量排序 | 0.50 | 2 | 17 |
| 质量加多样性 | 0.75 | 1 | 22 |
| 再加入难例配额 | 0.75 | 1 | 22 |
多样性采用阈值 0.9,先遍历全部合格候选得到代表集合,再截取预算。难例策略优先保留至多一个合法难例代表,然后按分数填充。这里质量排序本已偏好短而词汇不重复的平方和回答,难例配额没有改变结果;随机抽样也达到相同覆盖,不能宣称联合策略胜过随机选择。
错误答案的质量分数为 0.894078,与其正确版本完全相同,二者都越过质量阈值。原因是替换数字没有改变四个特征;结构检查才将错误版本排除。它虽未进入本次前三名,仍证明阈值放行不是正确性保证。全部样本、权重和选择轨迹见 code/results.json;语法、空池、零向量拒绝及阈值边界检查均通过。
评测协议:固定预算,也保留独立裁判
真实实验先制定标注量表:任务是否可回答、答案是否正确、格式是否满足要求、解释是否支持结论。对歧义题单列待复核状态,记录标注者分歧。按原始种子、改写家族及生成批次分组切分,避免同题换措辞同时出现在训练与开发集。冻结阈值后,再在未见来源上测可用样本精确率、召回率与分层误删率。
选择结果至少同时报告质量、多样性和成本。本例覆盖率分母是预设四类任务,词数是英文正则分词结果,不是模型词元数。正式微调应补充固定 tokenizer 下的训练词元预算,因为三条长答案可能比三条短答案消耗更多计算。先比较固定样本数,再比较固定训练词元数;记录优化步数、学习率、截断长度与随机种子。
还应单独评估筛选器迁移。将某个生成器的输出全部留作外部检查,比较不同语言、模板与回答长度下的错误类型;同一来源随机切分得到的好成绩,可能只说明模型认出了文风。抽查被拒绝的数据与被保留的数据同样重要,否则无法估计有价值难例被误删的比例。若采用分层抽样复核,需要保存抽样概率,不能把刻意多抽的难例比例当作总体比例。
下游评测必须独立于生成器和过滤器。数学可用答案验证,代码可用隔离运行的测试,开放任务结合盲评与人工抽查;不能拿过滤器自己的均分当训练效果。随机、仅质量、质量加多样性、再加难例至少做相同预算对照,重复多个种子并报告波动。本次只运行一个筛选种子,没有训练模型,也没有误差线,后续结果待人工核验。
审计文件应保留生成来源、提示词版本、原始响应、父样本编号、评分器版本、排除原因和最终归属。若采用人工复核后的标签,另存复核时间与依据,避免事后改标签让指标变好。去重与污染检查仍要独立执行;多样性高并不排除训练集中出现测试题。
失败排查:先检查筛掉了谁
质量均分上涨而效果下降,先按长度、任务和来源查看保留率。本例短回答得分更高,说明一个看似合理的特征组合也会学到捷径。给流畅错答、简短正确答案与模板复读分别建切片,才能看见总体均分隐藏的问题。
覆盖率异常时检查向量是否错行、是否归一化、零向量如何处理,以及相似度阈值方向。任务独热编码让本例的类别边界过于理想;真实 embedding 可能聚合不同能力,也可能拆开同义改写。增加难例比例却使训练不稳,则抽查高损失样本的标签、截断和不可解条件,不要先归因于模型容量。
后续科研问题
作者推断,值得研究的是固定预算下的取舍,而非寻找通用高分阈值。可以固定长度分布,检验质量分类器是否仍有筛选优势;固定独立正确性标签,比较类别配额与神经表示筛选;再用冻结学生的错误率定义难度,研究合法难例从零到不同配额时的收益曲线。预先规定失败标准,例如长尾任务下降或错误标签保留率升高,使负结果同样可报告。
总结
可复现的合成数据过滤,应输出可回查的样本集合及选择理由。本次实际验证了高分错误答案、质量排序的覆盖不足,以及难例配额不产生增益的情况。下一步应扩展独立标注与真实表示,再开展受控微调;官方权重推理、原论文训练和跨领域收益均尚未验证。
参考资料
检索日期:2026-09-06。正文所引一手链接均已实际打开。OpenReview 遇到验证页,改用作者 arXiv 定稿核验;官方分支按访问日期记录,未固定 commit,重跑兼容性待人工核验。
- Yizhong Wang、Yeganeh Kordi、Swaroop Mishra、Alisa Liu、Noah A. Smith、Daniel Khashabi、Hannaneh Hajishirzi,2023,Self-Instruct: Aligning Language Models with Self-Generated Instructions,ACL 定稿全文、官方仓库。预印本首发于 2022 年。
- Wei Liu、Weihao Zeng、Keqing He、Yong Jiang、Junxian He,2024,What Makes Good Data for Alignment? A Comprehensive Study of Automatic Data Selection in Instruction Tuning,ICLR 2024,arXiv v2 定稿说明、官方仓库。v2 修订日期为 2024-04-16。