摘要
Tool Calling Agent(工具調用智能體)讓語言模型不只生成文字,還能選擇函數、填寫參數、讀取執行結果並繼續決策。ReAct 的關鍵貢獻,是把語言推理與環境動作交替寫進同一條軌跡;但“模型輸出了合法 JSON”遠不等於任務完成:工具可能不存在、參數類型錯誤、調用超時、觀察過期,甚至已經產生副作用後才返回超時。本文沿 ReAct 論文與官方代碼、Berkeley Function-Calling Leaderboard(BFCL)、τ-bench 和 ToolSandbox 拆解動作協議、錯誤語義與狀態驗收;附帶的無依賴腳本構造一個實驗室工具環境,實際驗證為什麼答案正確仍可能是失敗,以及冪等重試、步數上限和最終狀態檢查如何補上這一缺口。它不是任何真實大模型或公開榜單成績復現。
復現價值與目標:從“會調函數”到“能證明做對”
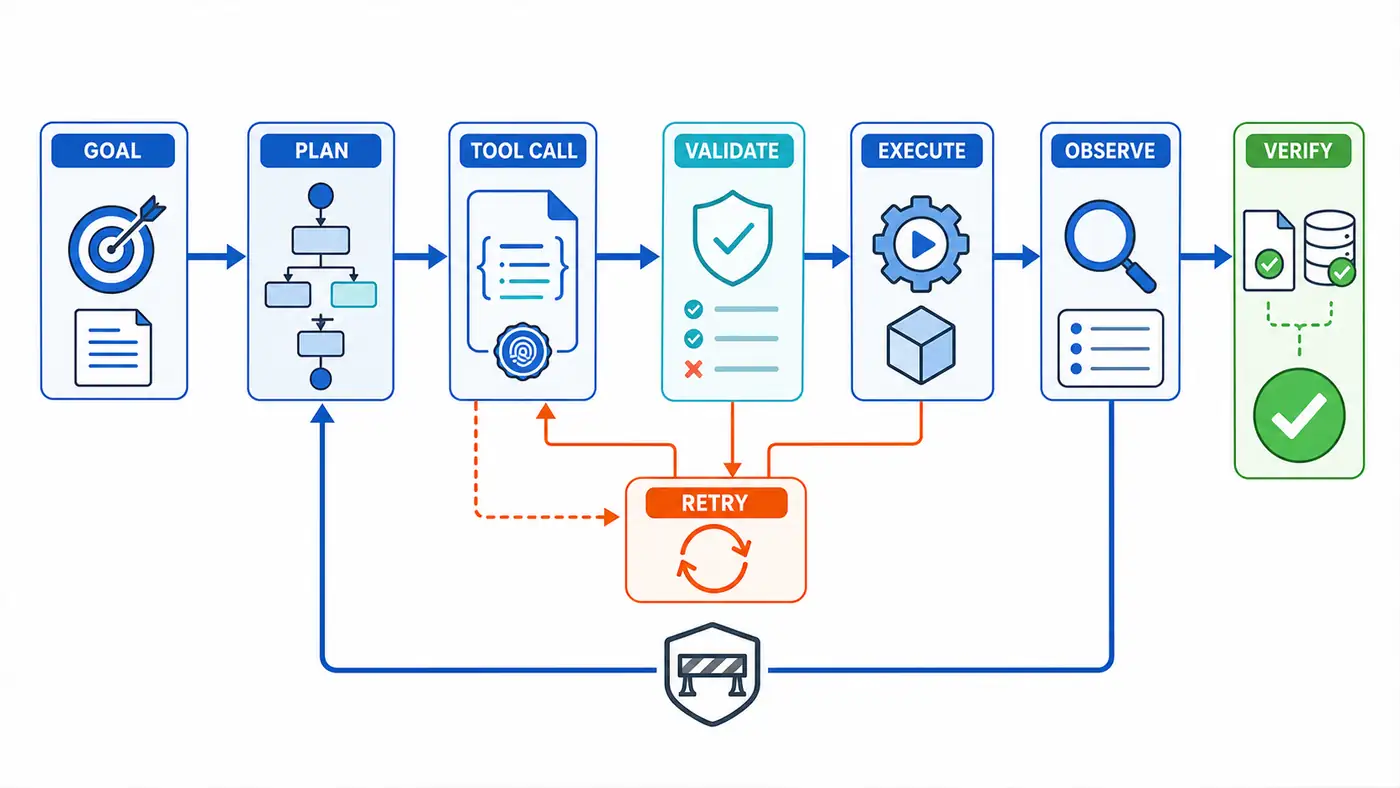
最小工具智能體常被寫成一個循環:把用戶目標和工具說明交給模型,若模型返回 tool call 就執行,再把 observation 放回上下文;若返回自然語言就結束。這個骨架容易運行,卻隱藏了三個彼此獨立的問題:模型是否選擇了正確動作;執行器是否按預期改變世界;最終世界狀態是否真的滿足目標且沒有額外副作用。
本次復現不追求接入最多 API,而是建立一個可審計合同:每次動作先做結構和參數驗證;錯誤帶有明確類別與是否可重試信息;有副作用的調用使用冪等鍵;軌跡受步數預算約束;最終答案和環境狀態分別驗收。實驗要回答四個問題:ReAct 形式化地增加了什麼;官方代碼怎樣連接動作與觀察;“提交後超時”為什麼會製造假成功;評測為何要從字符串匹配升級到執行、狀態與里程碑。
核心思想:交替推理只是策略,執行可靠性來自協議
ReAct 將環境動作空間 擴展為 ,其中 是語言思考空間。時間步 的上下文為:
是環境觀察, 是會影響環境的工具動作, 時只是把計劃、證據或異常處理寫回上下文,不直接改變環境。單條軌跡長度 可變;一個 batch 有 個任務時,日誌不是規則張量,而是 個不同長度的結構化事件序列。論文假設策略能從 observation 修正下一步,但沒有自動保證執行原子性、冪等性或最終狀態正確。
工程上還需要顯式狀態轉移:
是工具後端狀態, 是執行器, 是超時、限流或返回損壞等故障, 是機器可讀錯誤。關鍵邊界是:收到超時不代表 。服務可能先提交寫操作,再在響應途中斷開;若智能體換一個新請求標識重試,同一副作用就發生兩次。
論文與官方代碼閱讀路線
先讀 ReAct 第 2 節。論文把 thought 視為不觸發環境反饋的語言動作,把 action 交給外部環境;知識問答實驗使用 search[entity]、lookup[string]、finish[answer] 三種動作,並在 HotpotQA 與 FEVER 上交替生成 Thought、Action、Observation。論文報告:外部檢索降低了部分無依據事實,但 ReAct 也會陷入重複動作,非信息性搜索會讓後續推理難以恢復。這些是原論文特定模型、提示和任務下的觀察,不是所有工具框架的保證。
再看官方倉庫的數據流。wikienv.py 的 step() 只接受上述動作格式:合法搜索觸發網絡請求,lookup 在當前頁面繼續找句子,finish 結束 episode,其他輸出統一變成 Invalid action;同時累積步數和搜索調用時間。wrappers.py 的 HistoryWrapper 把每一步 Action/Observation 拼回歷史,HotPotQA wrapper 再從環境答案計算 EM/F1。Notebook 和 README 表明官方代碼是早期 GPT-3 prompting 實驗,依賴舊接口,並只對 HotpotQA、FEVER 的 500 個隨機開發樣本運行;閱讀它應關注協議邊界,而不是把舊依賴直接當現代函數調用模板。
最後讀評測演進。BFCL 單輪任務區分 AST 合法性、真實執行結果與“沒有合適工具時不調用”;V3 多輪任務加入最多 20 步的強制終止,並結合後端狀態與必要執行路徑,避免只匹配唯一軌跡。τ-bench 用對話結束後的數據庫目標狀態評測,並以多次試驗的 pass^k 討論一致可靠性。ToolSandbox 更進一步:用有向無環圖約束中間裡程碑順序,允許多條等價路線,只要求關鍵狀態、工具軌跡和最終回覆在正確次序出現。它們共同提示:ReAct 是生成策略,verifier(驗證器)才定義“完成”。
最小實驗:答案對了,狀態為什麼仍判錯
運行:
python3 code/minimal_tool_agent.py --check-only
腳本固定種子標識 60,完全確定性,不訪問網絡。環境暴露 find_sample、run_assay、read_assay 三個工具;目標是找到標籤 S-7,只運行一次 assay(檢測),並返回數值 7.4。run_assay 第一次被注入“提交後超時”:後端已經寫入一條實驗記錄,但調用者只看到 TIMEOUT_UNKNOWN_COMMIT。
本次 CPU smoke test 中,可靠控制器用同一個 idempotency_key 重試;後端識別重複請求並返回緩存結果,4 次調用後副作用計數仍為 1,答案與狀態都通過。對照控制器換新 key 重試,同樣 4 次調用、最終答案也為 7.4,卻留下 2 條 assay 記錄;答案檢查為真,狀態檢查為假,整體 task_pass=false。另兩個檢查顯示:參數類型錯誤可在一次結構化反饋後修復且不產生副作用;連續調用不存在的工具會在第 4 步強制終止。輸出中的短 SHA-256 digest 綁定完整軌跡,便於比較日誌是否被改寫。
這些數字只證明腳本里的協議性質,不代表 ReAct、某個語言模型或 BFCL/ToolSandbox 成績。toy planner 是手寫策略,因此沒有驗證模型能否自主識別錯誤類別;真正接入模型時,至少還要凍結模型版本、提示、工具 schema、解碼參數和執行環境鏡像。
工具錯誤分類:不要把所有異常都塞進一次重試
第一層是規劃錯誤:選錯工具、遺漏前置步驟、把不可完成任務硬猜成答案。第二層是調用錯誤:函數名不存在、JSON 無法解析、必填參數缺失、類型或枚舉不合法;這類錯誤應返回短而結構化的 schema 反饋,允許有限次數修復。第三層是執行錯誤:限流、臨時網絡中斷、權限拒絕、資源不存在;只有明確標記為 transient 的錯誤才適合自動重試。
第四層最危險,是結果不確定:超時發生在提交前還是提交後無法從客戶端判斷。有副作用的動作必須攜帶穩定冪等鍵,重試時複用它;若工具不支持冪等,應先查詢狀態或請求人工確認。第五層是 observation 錯誤:返回被截斷、版本過期、字段語義改變,模型可能在錯誤證據上繼續規劃。第六層是驗證錯誤:只檢查最終文案,漏掉重複寫入、越權訪問、錯誤順序或未滿足的中間約束。
作者推斷是:錯誤恢復策略應由工具合同決定,而不是由模型自由發揮。每個工具描述除參數 schema 外,還應給出只讀/寫入屬性、冪等性、可重試錯誤碼、超時語義、權限邊界和可驗證狀態。模型負責提出下一動作,執行器負責拒絕越界,驗證器負責判斷目標;三者不能合併成一句“請謹慎使用工具”的提示詞。
評測協議:四層分數與可回放日誌
第一層評估 call validity:工具選擇、參數名、類型、必填字段與不該調用時的拒絕率。第二層評估 execution validity:函數是否真實可執行、返回類型是否滿足合同。第三層評估 task success:最終狀態是否匹配目標,必要的只讀工具路徑是否出現,有序里程碑是否完成。第四層評估 side effects:重複寫入、無關修改、權限違規和 guardrail 破壞;答案正確但副作用不合格必須判失敗。
每個任務至少重複多個種子或採樣輪次,報告單次成功率、全 次均成功的可靠性、均值與置信區間;同時報無效調用率、錯誤恢復率、平均/最大步數、強制終止率、工具調用數、延遲和 token。動態榜單與在線 API 會變化,本文不轉述當前排名;真實復現前應鎖定 BFCL/ToolSandbox commit、數據版本和環境依賴。
日誌應保存 task id、模型與提示版本、原始模型輸出、解析後的 call、工具 schema hash、冪等鍵、開始/結束時間、錯誤碼、是否已提交、原始 observation、前後狀態摘要和 verifier 結果。對敏感工具要脫敏參數,但不能只保存最終答案。回放時先確認軌跡 digest,再在隔離環境重執行;否則“同一個答案”可能來自不同且不可接受的動作鏈。
失敗分析與排查順序
若 agent 循環,先查最近動作和 observation 是否完全重複,再檢查停止條件、已完成子目標和最大步數;盲目增加上下文只會把循環帶得更遠。若頻繁參數錯,比較模型實際看到的 schema 與執行器版本,給枚舉、格式和邊界值做單元測試。若重試後出現重複記錄,優先審計冪等鍵是否跨重試穩定、服務端是否在提交前緩存 key、超時是否暴露 commit 狀態。
若答案正確但任務失敗,比較 final answer verifier 與 state verifier:前者可能過嚴地要求措辭,後者也可能漏掉只讀必經路徑。BFCL V3 用狀態檢查配合必要路徑,ToolSandbox 用 milestone DAG,正是為了避免單一終態或單一路徑的偏差。若線上成功率波動大,不要只報平均值;檢查同一任務多輪試驗中最常見的首個分叉點,並將“工具隨機故障”和“模型決策變化”分別控制。
後續科研問題
一是如何從工具規範自動生成錯誤注入與狀態 verifier,而不依賴人工寫每個測試;二是怎樣估計長軌跡中一次局部錯誤對最終成功率的因果貢獻;三是讓模型看到多少內部錯誤細節,既足以恢復又不洩露敏感後端;四是可逆動作、事務和補償操作能否成為通用 agent 接口;五是如何同時優化成功率、最壞副作用和調用成本;六是自然語言 thought 是否真的幫助異常恢復,還是結構化狀態摘要與顯式計劃圖更可靠。可行的小課題是:在同一 stateful toy 環境中比較 ReAct、純函數調用和帶 verifier 的搜索策略,固定調用預算並公開全部軌跡。
總結
ReAct 的價值是讓模型在動作之間利用觀察更新計劃,但可靠工具智能體還需要嚴格的執行合同。合法 JSON 只證明“像一次調用”,最終文案正確也只證明“說對了”;真正的完成證據來自參數驗證、錯誤分類、冪等重試、步數預算、狀態/里程碑驗收和可回放日誌。先用本文腳本復現提交後超時與重複副作用,再接入真實模型,能把許多“偶爾能跑通”的 demo 轉化為可診斷、可比較的科研實驗。
參考資料
檢索日期:2026-09-01。以下均為論文、作者項目、官方代碼或研究機構頁面;動態榜單結果待人工核驗。
- Shunyu Yao 等,2023,ReAct: Synergizing Reasoning and Acting in Language Models(ICLR / arXiv v3)
- ReAct 作者團隊,論文項目頁
- Shunyu Yao 等,ReAct 官方提示與實驗代碼
- ReAct 官方代碼,
wikienv.py動作環境與wrappers.py軌跡/評測封裝 - UC Berkeley Gorilla 團隊,Berkeley Function-Calling Leaderboard 方法說明
- UC Berkeley Gorilla 團隊,BFCL V3:Multi-Turn & Multi-Step Function Calling
- UC Berkeley Gorilla 團隊,BFCL 官方評測代碼
- Shunyu Yao 等,2024,τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains與官方代碼
- Jiarui Lu 等,2025,ToolSandbox(Apple Machine Learning Research)與官方代碼
- Yangjun Ruan 等,2024,Identifying the Risks of LM Agents with an LM-Emulated Sandbox(ToolEmu, ICLR)