摘要
Tool Calling Agent(工具调用智能体)让语言模型不只生成文字,还能选择函数、填写参数、读取执行结果并继续决策。ReAct 的关键贡献,是把语言推理与环境动作交替写进同一条轨迹;但“模型输出了合法 JSON”远不等于任务完成:工具可能不存在、参数类型错误、调用超时、观察过期,甚至已经产生副作用后才返回超时。本文沿 ReAct 论文与官方代码、Berkeley Function-Calling Leaderboard(BFCL)、τ-bench 和 ToolSandbox 拆解动作协议、错误语义与状态验收;附带的无依赖脚本构造一个实验室工具环境,实际验证为什么答案正确仍可能是失败,以及幂等重试、步数上限和最终状态检查如何补上这一缺口。它不是任何真实大模型或公开榜单成绩复现。
复现价值与目标:从“会调函数”到“能证明做对”
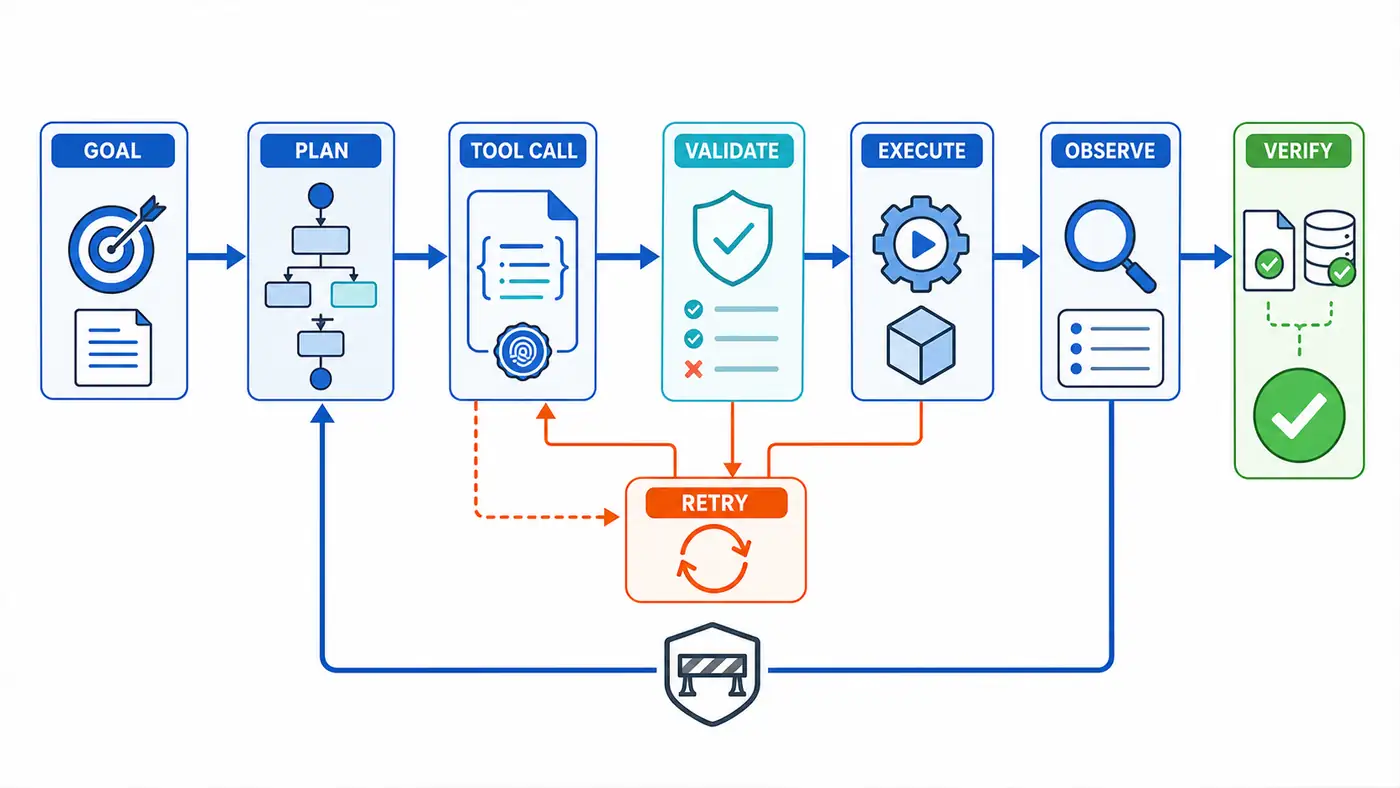
最小工具智能体常被写成一个循环:把用户目标和工具说明交给模型,若模型返回 tool call 就执行,再把 observation 放回上下文;若返回自然语言就结束。这个骨架容易运行,却隐藏了三个彼此独立的问题:模型是否选择了正确动作;执行器是否按预期改变世界;最终世界状态是否真的满足目标且没有额外副作用。
本次复现不追求接入最多 API,而是建立一个可审计合同:每次动作先做结构和参数验证;错误带有明确类别与是否可重试信息;有副作用的调用使用幂等键;轨迹受步数预算约束;最终答案和环境状态分别验收。实验要回答四个问题:ReAct 形式化地增加了什么;官方代码怎样连接动作与观察;“提交后超时”为什么会制造假成功;评测为何要从字符串匹配升级到执行、状态与里程碑。
核心思想:交替推理只是策略,执行可靠性来自协议
ReAct 将环境动作空间 (\mathcal A) 扩展为 (\hat{\mathcal A}=\mathcal A\cup\mathcal L),其中 (\mathcal L) 是语言思考空间。时间步 (t) 的上下文为:
[ c_t=(o_1,a_1,\ldots,o_{t-1},a_{t-1},o_t),\qquad \hat a_t\sim\pi_\theta(\cdot\mid c_t) ]
(o_t) 是环境观察,(a_t) 是会影响环境的工具动作,(\hat a_t\in\mathcal L) 时只是把计划、证据或异常处理写回上下文,不直接改变环境。单条轨迹长度 (T_i) 可变;一个 batch 有 (B) 个任务时,日志不是规则张量,而是 (B) 个不同长度的结构化事件序列。论文假设策略能从 observation 修正下一步,但没有自动保证执行原子性、幂等性或最终状态正确。
工程上还需要显式状态转移:
[ (s_{t+1},o_{t+1},e_{t+1})=E(s_t,a_t,\varepsilon_t) ]
(s_t) 是工具后端状态,(E) 是执行器,(\varepsilon_t) 是超时、限流或返回损坏等故障,(e_{t+1}) 是机器可读错误。关键边界是:收到超时不代表 (s_{t+1}=s_t)。服务可能先提交写操作,再在响应途中断开;若智能体换一个新请求标识重试,同一副作用就发生两次。
论文与官方代码阅读路线
先读 ReAct 第 2 节。论文把 thought 视为不触发环境反馈的语言动作,把 action 交给外部环境;知识问答实验使用 search[entity]、lookup[string]、finish[answer] 三种动作,并在 HotpotQA 与 FEVER 上交替生成 Thought、Action、Observation。论文报告:外部检索降低了部分无依据事实,但 ReAct 也会陷入重复动作,非信息性搜索会让后续推理难以恢复。这些是原论文特定模型、提示和任务下的观察,不是所有工具框架的保证。
再看官方仓库的数据流。wikienv.py 的 step() 只接受上述动作格式:合法搜索触发网络请求,lookup 在当前页面继续找句子,finish 结束 episode,其他输出统一变成 Invalid action;同时累积步数和搜索调用时间。wrappers.py 的 HistoryWrapper 把每一步 Action/Observation 拼回历史,HotPotQA wrapper 再从环境答案计算 EM/F1。Notebook 和 README 表明官方代码是早期 GPT-3 prompting 实验,依赖旧接口,并只对 HotpotQA、FEVER 的 500 个随机开发样本运行;阅读它应关注协议边界,而不是把旧依赖直接当现代函数调用模板。
最后读评测演进。BFCL 单轮任务区分 AST 合法性、真实执行结果与“没有合适工具时不调用”;V3 多轮任务加入最多 20 步的强制终止,并结合后端状态与必要执行路径,避免只匹配唯一轨迹。τ-bench 用对话结束后的数据库目标状态评测,并以多次试验的 pass^k 讨论一致可靠性。ToolSandbox 更进一步:用有向无环图约束中间里程碑顺序,允许多条等价路线,只要求关键状态、工具轨迹和最终回复在正确次序出现。它们共同提示:ReAct 是生成策略,verifier(验证器)才定义“完成”。
最小实验:答案对了,状态为什么仍判错
运行:
python3 code/minimal_tool_agent.py --check-only
脚本固定种子标识 60,完全确定性,不访问网络。环境暴露 find_sample、run_assay、read_assay 三个工具;目标是找到标签 S-7,只运行一次 assay(检测),并返回数值 7.4。run_assay 第一次被注入“提交后超时”:后端已经写入一条实验记录,但调用者只看到 TIMEOUT_UNKNOWN_COMMIT。
本次 CPU smoke test 中,可靠控制器用同一个 idempotency_key 重试;后端识别重复请求并返回缓存结果,4 次调用后副作用计数仍为 1,答案与状态都通过。对照控制器换新 key 重试,同样 4 次调用、最终答案也为 7.4,却留下 2 条 assay 记录;答案检查为真,状态检查为假,整体 task_pass=false。另两个检查显示:参数类型错误可在一次结构化反馈后修复且不产生副作用;连续调用不存在的工具会在第 4 步强制终止。输出中的短 SHA-256 digest 绑定完整轨迹,便于比较日志是否被改写。
这些数字只证明脚本里的协议性质,不代表 ReAct、某个语言模型或 BFCL/ToolSandbox 成绩。toy planner 是手写策略,因此没有验证模型能否自主识别错误类别;真正接入模型时,至少还要冻结模型版本、提示、工具 schema、解码参数和执行环境镜像。
工具错误分类:不要把所有异常都塞进一次重试
第一层是规划错误:选错工具、遗漏前置步骤、把不可完成任务硬猜成答案。第二层是调用错误:函数名不存在、JSON 无法解析、必填参数缺失、类型或枚举不合法;这类错误应返回短而结构化的 schema 反馈,允许有限次数修复。第三层是执行错误:限流、临时网络中断、权限拒绝、资源不存在;只有明确标记为 transient 的错误才适合自动重试。
第四层最危险,是结果不确定:超时发生在提交前还是提交后无法从客户端判断。有副作用的动作必须携带稳定幂等键,重试时复用它;若工具不支持幂等,应先查询状态或请求人工确认。第五层是 observation 错误:返回被截断、版本过期、字段语义改变,模型可能在错误证据上继续规划。第六层是验证错误:只检查最终文案,漏掉重复写入、越权访问、错误顺序或未满足的中间约束。
作者推断是:错误恢复策略应由工具合同决定,而不是由模型自由发挥。每个工具描述除参数 schema 外,还应给出只读/写入属性、幂等性、可重试错误码、超时语义、权限边界和可验证状态。模型负责提出下一动作,执行器负责拒绝越界,验证器负责判断目标;三者不能合并成一句“请谨慎使用工具”的提示词。
评测协议:四层分数与可回放日志
第一层评估 call validity:工具选择、参数名、类型、必填字段与不该调用时的拒绝率。第二层评估 execution validity:函数是否真实可执行、返回类型是否满足合同。第三层评估 task success:最终状态是否匹配目标,必要的只读工具路径是否出现,有序里程碑是否完成。第四层评估 side effects:重复写入、无关修改、权限违规和 guardrail 破坏;答案正确但副作用不合格必须判失败。
每个任务至少重复多个种子或采样轮次,报告单次成功率、全 (k) 次均成功的可靠性、均值与置信区间;同时报无效调用率、错误恢复率、平均/最大步数、强制终止率、工具调用数、延迟和 token。动态榜单与在线 API 会变化,本文不转述当前排名;真实复现前应锁定 BFCL/ToolSandbox commit、数据版本和环境依赖。
日志应保存 task id、模型与提示版本、原始模型输出、解析后的 call、工具 schema hash、幂等键、开始/结束时间、错误码、是否已提交、原始 observation、前后状态摘要和 verifier 结果。对敏感工具要脱敏参数,但不能只保存最终答案。回放时先确认轨迹 digest,再在隔离环境重执行;否则“同一个答案”可能来自不同且不可接受的动作链。
失败分析与排查顺序
若 agent 循环,先查最近动作和 observation 是否完全重复,再检查停止条件、已完成子目标和最大步数;盲目增加上下文只会把循环带得更远。若频繁参数错,比较模型实际看到的 schema 与执行器版本,给枚举、格式和边界值做单元测试。若重试后出现重复记录,优先审计幂等键是否跨重试稳定、服务端是否在提交前缓存 key、超时是否暴露 commit 状态。
若答案正确但任务失败,比较 final answer verifier 与 state verifier:前者可能过严地要求措辞,后者也可能漏掉只读必经路径。BFCL V3 用状态检查配合必要路径,ToolSandbox 用 milestone DAG,正是为了避免单一终态或单一路径的偏差。若线上成功率波动大,不要只报平均值;检查同一任务多轮试验中最常见的首个分叉点,并将“工具随机故障”和“模型决策变化”分别控制。
后续科研问题
一是如何从工具规范自动生成错误注入与状态 verifier,而不依赖人工写每个测试;二是怎样估计长轨迹中一次局部错误对最终成功率的因果贡献;三是让模型看到多少内部错误细节,既足以恢复又不泄露敏感后端;四是可逆动作、事务和补偿操作能否成为通用 agent 接口;五是如何同时优化成功率、最坏副作用和调用成本;六是自然语言 thought 是否真的帮助异常恢复,还是结构化状态摘要与显式计划图更可靠。可行的小课题是:在同一 stateful toy 环境中比较 ReAct、纯函数调用和带 verifier 的搜索策略,固定调用预算并公开全部轨迹。
总结
ReAct 的价值是让模型在动作之间利用观察更新计划,但可靠工具智能体还需要严格的执行合同。合法 JSON 只证明“像一次调用”,最终文案正确也只证明“说对了”;真正的完成证据来自参数验证、错误分类、幂等重试、步数预算、状态/里程碑验收和可回放日志。先用本文脚本复现提交后超时与重复副作用,再接入真实模型,能把许多“偶尔能跑通”的 demo 转化为可诊断、可比较的科研实验。
参考资料
检索日期:2026-09-01。以下均为论文、作者项目、官方代码或研究机构页面;动态榜单结果待人工核验。
- Shunyu Yao 等,2023,ReAct: Synergizing Reasoning and Acting in Language Models(ICLR / arXiv v3)
- ReAct 作者团队,论文项目页
- Shunyu Yao 等,ReAct 官方提示与实验代码
- ReAct 官方代码,
wikienv.py动作环境与wrappers.py轨迹/评测封装 - UC Berkeley Gorilla 团队,Berkeley Function-Calling Leaderboard 方法说明
- UC Berkeley Gorilla 团队,BFCL V3:Multi-Turn & Multi-Step Function Calling
- UC Berkeley Gorilla 团队,BFCL 官方评测代码
- Shunyu Yao 等,2024,τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains与官方代码
- Jiarui Lu 等,2025,ToolSandbox(Apple Machine Learning Research)与官方代码
- Yangjun Ruan 等,2024,Identifying the Risks of LM Agents with an LM-Emulated Sandbox(ToolEmu, ICLR)