摘要
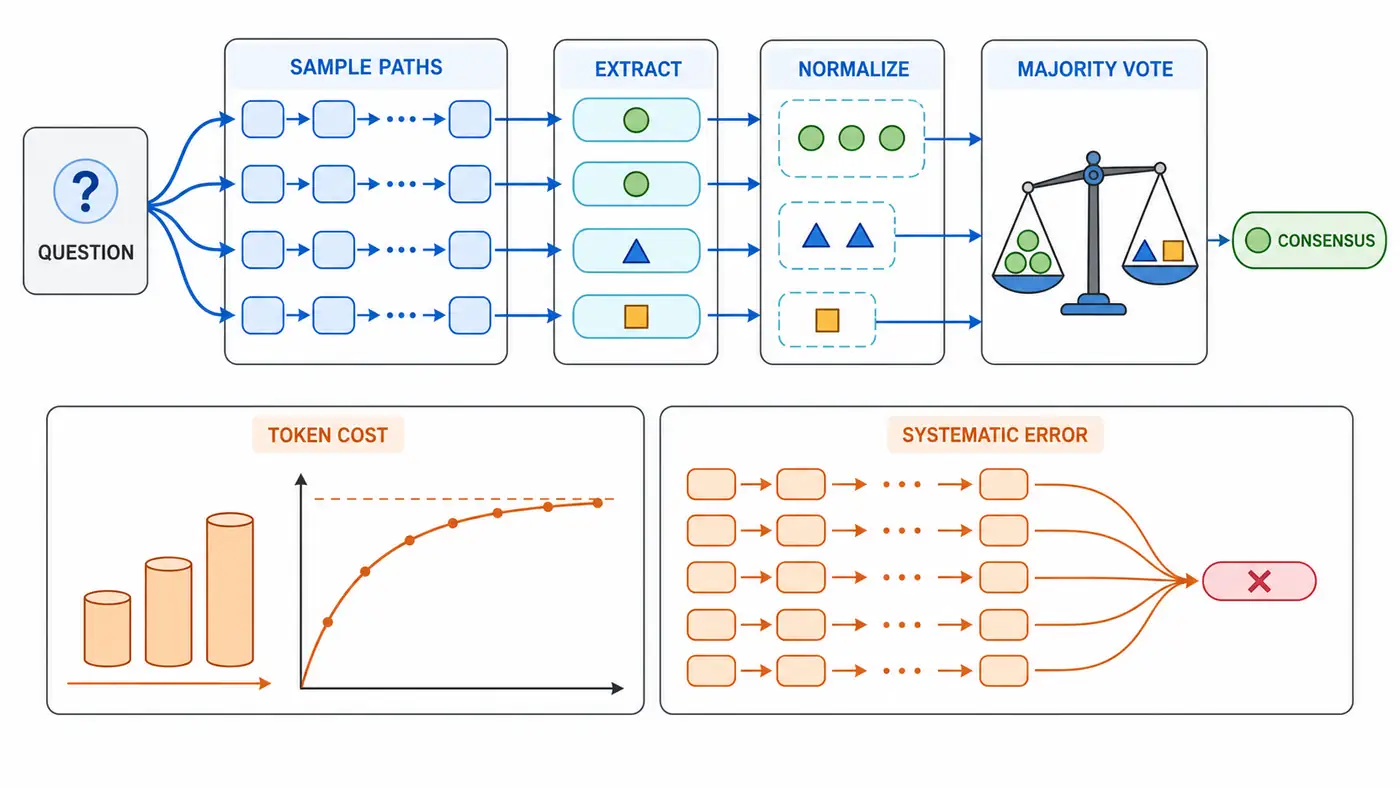
Self-Consistency(自一致性)不訓練新模型,而是在推理時讓同一個語言模型對同一道題採樣多條推理路徑,抽取每條路徑的最終答案,再以多數投票選擇共識答案。它把一次不穩定生成變成一個可審計的“採樣—歸一化—聚合”協議,但也把推理成本近似放大為採樣數倍。本文沿著 Wang 等人的 ICLR 2023 論文、Chain-of-Thought 原論文、GSM8K 官方數據代碼和 Google DeepMind 後續 OneTwo 實現,拆解公式、代碼合同與評測方法;附帶的無依賴腳本用受控模擬驗證何時投票有效、何時會把系統性錯誤放大。它不是 PaLM、GPT-3 或 GSM8K 成績復現。
復現價值與目標:把“多問幾遍”變成實驗協議
Chain-of-Thought(CoT,思維鏈)提示要求模型先生成中間推理再給答案。普通 CoT 常用貪心解碼,只保留局部概率最高的一條路徑;Self-Consistency 則主動引入隨機性,期望正確答案能由多種不同路徑抵達,而錯誤路徑更分散。真正值得復現的不是一行 Counter(...).most_common(1),而是它之前的四個合同:同一問題是否使用同一提示;採樣是否相互獨立;答案如何解析和歸一化;成本與準確率是否在同一預算下比較。
本文回答四個可檢查問題:多數投票對應什麼概率邊緣化;採樣數從 1 增加到 33 時,收益與 token 成本如何變化;答案格式、平票和解析失敗怎樣影響結果;當多個路徑共享同一誤解時,為什麼“更一致”不等於“更正確”。
核心思想:對推理路徑邊緣化
給定提示 (p) 和問題 (x),第 (i) 次採樣生成推理路徑 (r_i) 與答案 (a_i):
其中 (m) 是採樣條數,(r_i) 是長度不定的 token 序列,(a_i\in\mathcal A) 是經任務解析器映射後的離散答案。一個 batch 若有 (B) 道題、每題採樣 (m) 次,邏輯上得到 (B\times m) 個 completion;各路徑長度不同,實際 token 成本應求和,不能只報請求次數。
論文使用的無權多數投票是:
指示函數在第 (i) 條路徑答案等於 (a) 時取 1。這裡“邊緣化推理路徑”並不檢查每一步是否正確,而是丟棄 (r_i) 後統計終值。論文也比較按序列概率加權的聚合;其表 1 顯示,直接無權投票與長度歸一化加權結果相近,而未歸一化概率容易偏愛短輸出。這個結論屬於論文特定模型與任務的報告,不應當作所有模型的定律。
若答案只有對/錯兩類、每條路徑獨立且單次正確率為 (q>0.5),奇數 (m) 下多數正確的概率為:
公式說明獨立、同分布和 (q>0.5) 是關鍵假設。真實模型的路徑會共享提示、參數與知識缺口,錯誤高度相關;若某個錯誤答案本來就最常見,增大 (m) 只會更穩定地選錯。多類別錯誤若彼此分散,即便單條正確率略高於各個錯誤類別而未超過 0.5,多數模式仍可能獲益。
論文與官方代碼閱讀路線
先讀 Self-Consistency 論文第 2 節,追蹤 (r_i\rightarrow a_i)、任務相關解析器和多數投票公式;再讀第 3.1 節採樣設置。論文對 UL2/LaMDA 使用溫度 0.5、top-k 40,對 PaLM 使用溫度 0.7、top-k 40,對當時 GPT-3 使用溫度 0.7 且不做 top-k;主結果每次獨立採樣 40 條,並對完整實驗重複 10 次。不要把這些舊模型參數機械複製到新模型,而應把溫度、top-p/top-k、最大 token、停止串、模型版本和隨機種子保存為實驗配置。
原論文沒有公開官方實現倉庫,且部分論文模型不可公開獲得;因此不能聲稱“克隆官方代碼即可復現”。數據側可讀 GSM8K 官方倉庫:每行有 question 與 answer,最終數字位於 #### 後;dataset.py 用正則抽取並去掉逗號。這個細節直接決定 1,200、1200 是否進入同一投票桶,也提醒我們把 parser version 與 parser failure rate 寫進結果。
工程實現可參考 Google DeepMind 後續開源 OneTwo 的 v0.2.0 說明:它把 self-consistency 視為包裹單次策略的 meta-strategy,重複採樣後估計答案分佈,並顯式支持答案歸一化、加權投票、共識答案與完整分佈評測。它不是原論文配套代碼,但提供了更清晰的模塊邊界:sample() 只負責生成,parse() 只負責答案標準化,aggregate() 只負責投票,evaluate() 同時記錄正確性和成本。
閱讀自己的真實實現時,可以沿數據流做一次逐項追蹤。第一,確認生成接口返回的是 (m) 個獨立序列,而不是一個序列被複制、beam search 的近鄰或服務端緩存命中;保存每條響應的請求標識與原始文本。第二,檢查 answer parser 是在停止串截斷之後運行,且不會誤取推理中間出現的第一個數字。第三,在聚合前打印規範化答案及計數器,構造包含負數、小數、千分位、單位和無答案輸出的單元測試。第四,定義平票:隨機打破、固定字典序或首個樣本都會改變少量結果,必須在所有預算點保持一致。第五,不要只保存獲勝路徑;保留完整樣本池才能複查錯誤相關性、重算新的歸一化規則,並防止“看完結果再改 parser”造成評測洩漏。
最小實驗:不用大模型先驗證聚合與失敗邊界
運行:
python3 code/minimal_self_consistency.py --check-only
腳本固定隨機種子 59,不訪問網絡,也不生成自然語言推理。它先驗證四種答案格式歸一化,再對 2000 個模擬問題重複 20 輪,比較 (m\in{1,3,5,9,17,33})。diverse_errors 情形的單次分佈為正確答案 0.54、三個不同錯誤答案 0.16/0.15/0.15;systematic_error 情形為正確答案 0.42、同一個主錯誤 0.52、其餘 0.04/0.02。平票由最早出現的答案打破,這一規則寫死在代碼中,避免評測庫默認行為悄悄改變結果。
本次 CPU smoke test 中,分散錯誤的準確率從 (m=1) 的 0.5435 提升到 (m=17) 的 0.9520;系統性錯誤則從 0.4219 降到 0.3356。前者同時把每題按 128 token 上限估算的預算從 128 增至 2176,後者證明高共識也可能只是穩定偏差。二元獨立理論檢查在 (q=0.60,m=33) 時得到 0.8789。數字僅驗證投票機制與假設邊界,不代表任何語言模型、數據集或真實 API 成本。
還要謹慎解釋腳本中的 vote_share:單樣本時它恆為 1,並不意味著模型最有把握;樣本增加後,它才逐步接近經驗答案分佈的最大質量。在分散錯誤情形,正確桶最終佔約 0.54,卻能壓過每個約 0.15 的錯誤桶,所以準確率接近 1;這不是單條路徑變聰明,而是估計眾數更穩定。系統性錯誤情形中,錯誤桶約 0.52,採樣越多越能確認錯誤眾數。該對照也說明不能只畫“採樣數—準確率”一條曲線:至少還應畫獲勝票佔比、唯一答案數和錯誤答案集中度,否則無法區分隨機噪聲被平均與偏差被放大。
升級為真實模型的最小路徑
固定一個可公開獲取的模型與精確 revision,凍結 few-shot exemplars,先在小型 GSM8K 子集上保存每條原始 completion。對每題生成 1、3、5、10、20、40 條路徑時,最好一次生成最大池,再以前綴子集計算不同預算,保證橫向比較使用同一批樣本;同時另做多隨機種子重複,估計採樣波動。日誌至少包含 qid、sample id、解碼參數、原始文本、規範化答案、解析狀態、輸入/輸出 token、延遲與模型版本。
若服務支持並行請求,並行只降低牆鍾時間,不減少總 token 或費用。緩存必須以提示、模型版本和解碼參數為鍵;否則改了溫度卻複用舊樣本,會製造虛假的可復現性。論文使用 40 條不是通用最優點,應在本模型、本數據與本預算上畫 Pareto 前沿。
評測協議:準確率之外必須報告什麼
首先報 exact match,並把單路徑隨機採樣、單路徑貪心和 self-consistency 分開;(m=1) 的隨機樣本並不等於 temperature=0 的貪心基線。其次報每個 (m) 的均值、標準差或置信區間,並使用相同問題集合做成對比較。再次報總 completion、輸入/輸出 token、實際費用、p50/p95 延遲和解析失敗率。成本公式可寫成:
其中 (t_{\text{in/out}}) 是第 (i) 次請求的輸入/輸出 token,(c_{\text{in/out}}) 是對應單價;價格和模型接口隨時間變化,本文不寫死動態數字,實際運行前待人工核驗。
最後報告 winning vote share(獲勝答案票數佔比)、唯一答案數和準確率按共識區間的分桶結果。共識可作為不確定性信號,但不能直接當校準概率;應檢查“80% 共識”的題是否真的約有 80% 正確,並與拒答閾值共同評估覆蓋率—準確率。
成本曲線也不應只用“調用次數乘單價”。長推理題的輸出 token 方差可能遠大於短題,且固定最大長度會讓截斷率隨難度上升。建議對每道題分別計算從 (m=1) 到目標預算的增量成本與是否糾正答案,再彙總“每增加一千 token 帶來的準確率增益”。若第 20 到第 40 條路徑幾乎不改變獲勝桶,曲線已進入收益遞減區;若仍頻繁翻轉,說明模型在該問題族上不穩定,應該比較自適應停止、外部驗證器或工具執行,而不是默認繼續堆採樣。並行批處理的吞吐收益要與 token 成本分開呈現,因為它只改變等待時間,未減少計算總量。
失敗分析:投票最容易在哪些地方騙人
第一類是解析錯誤。不同等價形式被拆成多個桶會稀釋正確答案;過度歸一化又可能把單位、符號或選項語義不同的答案錯誤合併。解析失敗不能靜默丟棄,否則有效樣本數隨題目難度變化。
第二類是相關錯誤。相同模型共享錯誤知識、歧義理解和提示誘導,幾十條路徑可能只是同一誤解的表面改寫。應抽樣審計“高共識但錯誤”的題,比較推理路徑的語義多樣性,而不只統計詞面差異。
第三類是數據洩漏與非獨立請求。複用隨機種子、服務端確定性緩存或一次請求中的退化多樣性都會讓樣本看似很多、有效樣本量卻很小。第四類是預算不公平:用 40 條路徑對比一次貪心卻只報告準確率,無法回答額外 39 倍推理是否值得。
第五類是開放式答案。傳統多數投票要求可穩定歸一化的離散答案;摘要、長文本和多種等價證明沒有天然桶。Universal Self-Consistency 用模型選擇候選間最一致的解答,但引入了新的評審模型偏差與額外成本,不能與字符串投票混為一談。
後續科研問題
最直接的問題是自適應預算:簡單題在少量樣本已形成穩定優勢時能否提前停止,把預算留給困難題?Adaptive-Consistency 與 Early-Stopping Self-Consistency 已報告顯著節省,但在新模型、新任務上仍需重做停止誤差和最壞成本分析。第二,怎樣估計路徑相關性與有效樣本量,而不是默認獨立?第三,投票權重應來自序列概率、自評置信度、外部 verifier 還是執行結果?第四,能否對高共識錯誤做因果分類,區分知識缺失、題意誤讀、算術失誤和解析器缺陷?第五,固定 token 預算下,增加路徑數與延長單條推理應如何分配?這些問題比盲目把 (m) 從 40 加到 100 更有研究價值。
總結
Self-Consistency 是一個簡單但假設很強的測試時計算方法:保持問題與提示固定,採樣多條路徑,規範化終值並投票。它在正確答案比任一錯誤模式更穩定時有效,在系統性錯誤佔優時可能反噬。可靠復現必須把採樣參數、解析器、平票、重複實驗和 token 成本都當作協議的一部分。先用本文腳本驗證聚合,再接入真實模型和固定數據子集,能避免把“多調用幾次”誤寫成可比較的論文復現。
參考資料
檢索日期:2026-08-31。
- Xuezhi Wang 等,2023,Self-Consistency Improves Chain of Thought Reasoning in Language Models(Google Research / ICLR 2023)
- Xuezhi Wang 等,論文 arXiv v4 與完整附錄
- Jason Wei 等,2022,Chain-of-Thought Prompting Elicits Reasoning in Large Language Models(NeurIPS 2022)
- Karl Cobbe 等,2021,Training Verifiers to Solve Math Word Problems / GSM8K
- OpenAI,GSM8K 官方數據與代碼倉庫
- Google DeepMind,OneTwo 開源倉庫與 v0.2.0 self-consistency 說明
- Pranjal Aggarwal 等,2023,Let’s Sample Step by Step: Adaptive-Consistency(EMNLP 2023)
- Yiwei Li 等,2024,Escape Sky-high Cost: Early-stopping Self-Consistency(ICLR 2024)
- Xinyun Chen 等,2023,Universal Self-Consistency with Large Language Models(Google DeepMind)