摘要
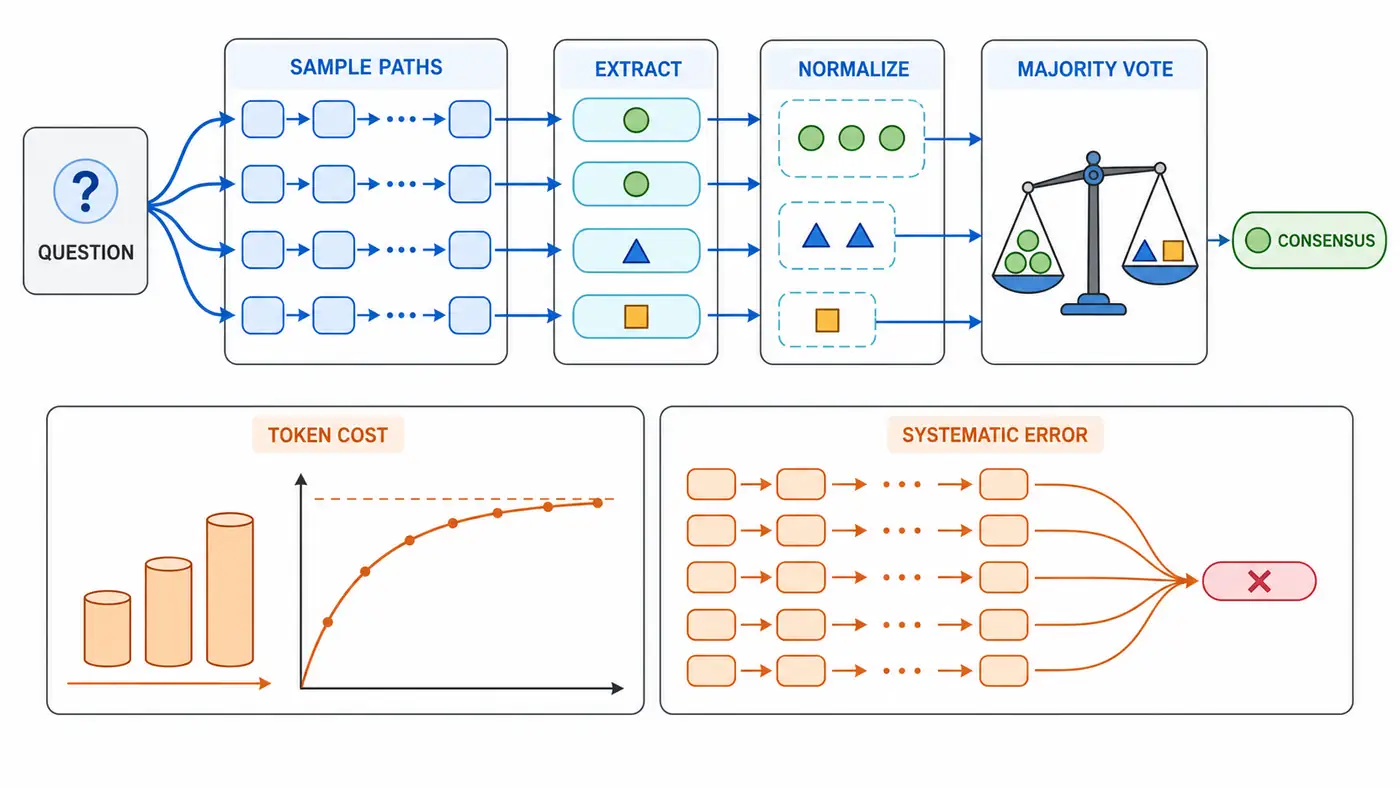
Self-Consistency(自一致性)不训练新模型,而是在推理时让同一个语言模型对同一道题采样多条推理路径,抽取每条路径的最终答案,再以多数投票选择共识答案。它把一次不稳定生成变成一个可审计的“采样—归一化—聚合”协议,但也把推理成本近似放大为采样数倍。本文沿着 Wang 等人的 ICLR 2023 论文、Chain-of-Thought 原论文、GSM8K 官方数据代码和 Google DeepMind 后续 OneTwo 实现,拆解公式、代码合同与评测方法;附带的无依赖脚本用受控模拟验证何时投票有效、何时会把系统性错误放大。它不是 PaLM、GPT-3 或 GSM8K 成绩复现。
复现价值与目标:把“多问几遍”变成实验协议
Chain-of-Thought(CoT,思维链)提示要求模型先生成中间推理再给答案。普通 CoT 常用贪心解码,只保留局部概率最高的一条路径;Self-Consistency 则主动引入随机性,期望正确答案能由多种不同路径抵达,而错误路径更分散。真正值得复现的不是一行 Counter(...).most_common(1),而是它之前的四个合同:同一问题是否使用同一提示;采样是否相互独立;答案如何解析和归一化;成本与准确率是否在同一预算下比较。
本文回答四个可检查问题:多数投票对应什么概率边缘化;采样数从 1 增加到 33 时,收益与 token 成本如何变化;答案格式、平票和解析失败怎样影响结果;当多个路径共享同一误解时,为什么“更一致”不等于“更正确”。
核心思想:对推理路径边缘化
给定提示 (p) 和问题 (x),第 (i) 次采样生成推理路径 (r_i) 与答案 (a_i):
[ (r_i,a_i)\sim P_\theta(r,a\mid p,x),\qquad i=1,\ldots,m ]
其中 (m) 是采样条数,(r_i) 是长度不定的 token 序列,(a_i\in\mathcal A) 是经任务解析器映射后的离散答案。一个 batch 若有 (B) 道题、每题采样 (m) 次,逻辑上得到 (B\times m) 个 completion;各路径长度不同,实际 token 成本应求和,不能只报请求次数。
论文使用的无权多数投票是:
[ \hat a=\arg\max_{a\in\mathcal A}\sum_{i=1}^{m}\mathbf 1[a_i=a] ]
指示函数在第 (i) 条路径答案等于 (a) 时取 1。这里“边缘化推理路径”并不检查每一步是否正确,而是丢弃 (r_i) 后统计终值。论文也比较按序列概率加权的聚合;其表 1 显示,直接无权投票与长度归一化加权结果相近,而未归一化概率容易偏爱短输出。这个结论属于论文特定模型与任务的报告,不应当作所有模型的定律。
若答案只有对/错两类、每条路径独立且单次正确率为 (q>0.5),奇数 (m) 下多数正确的概率为:
[ P_m=\sum_{k=(m+1)/2}^{m}{m\choose k}q^k(1-q)^{m-k} ]
公式说明独立、同分布和 (q>0.5) 是关键假设。真实模型的路径会共享提示、参数与知识缺口,错误高度相关;若某个错误答案本来就最常见,增大 (m) 只会更稳定地选错。多类别错误若彼此分散,即便单条正确率略高于各个错误类别而未超过 0.5,多数模式仍可能获益。
论文与官方代码阅读路线
先读 Self-Consistency 论文第 2 节,追踪 (r_i\rightarrow a_i)、任务相关解析器和多数投票公式;再读第 3.1 节采样设置。论文对 UL2/LaMDA 使用温度 0.5、top-k 40,对 PaLM 使用温度 0.7、top-k 40,对当时 GPT-3 使用温度 0.7 且不做 top-k;主结果每次独立采样 40 条,并对完整实验重复 10 次。不要把这些旧模型参数机械复制到新模型,而应把温度、top-p/top-k、最大 token、停止串、模型版本和随机种子保存为实验配置。
原论文没有公开官方实现仓库,且部分论文模型不可公开获得;因此不能声称“克隆官方代码即可复现”。数据侧可读 GSM8K 官方仓库:每行有 question 与 answer,最终数字位于 #### 后;dataset.py 用正则抽取并去掉逗号。这个细节直接决定 1,200、1200 是否进入同一投票桶,也提醒我们把 parser version 与 parser failure rate 写进结果。
工程实现可参考 Google DeepMind 后续开源 OneTwo 的 v0.2.0 说明:它把 self-consistency 视为包裹单次策略的 meta-strategy,重复采样后估计答案分布,并显式支持答案归一化、加权投票、共识答案与完整分布评测。它不是原论文配套代码,但提供了更清晰的模块边界:sample() 只负责生成,parse() 只负责答案标准化,aggregate() 只负责投票,evaluate() 同时记录正确性和成本。
阅读自己的真实实现时,可以沿数据流做一次逐项追踪。第一,确认生成接口返回的是 (m) 个独立序列,而不是一个序列被复制、beam search 的近邻或服务端缓存命中;保存每条响应的请求标识与原始文本。第二,检查 answer parser 是在停止串截断之后运行,且不会误取推理中间出现的第一个数字。第三,在聚合前打印规范化答案及计数器,构造包含负数、小数、千分位、单位和无答案输出的单元测试。第四,定义平票:随机打破、固定字典序或首个样本都会改变少量结果,必须在所有预算点保持一致。第五,不要只保存获胜路径;保留完整样本池才能复查错误相关性、重算新的归一化规则,并防止“看完结果再改 parser”造成评测泄漏。
最小实验:不用大模型先验证聚合与失败边界
运行:
python3 code/minimal_self_consistency.py --check-only
脚本固定随机种子 59,不访问网络,也不生成自然语言推理。它先验证四种答案格式归一化,再对 2000 个模拟问题重复 20 轮,比较 (m\in{1,3,5,9,17,33})。diverse_errors 情形的单次分布为正确答案 0.54、三个不同错误答案 0.16/0.15/0.15;systematic_error 情形为正确答案 0.42、同一个主错误 0.52、其余 0.04/0.02。平票由最早出现的答案打破,这一规则写死在代码中,避免评测库默认行为悄悄改变结果。
本次 CPU smoke test 中,分散错误的准确率从 (m=1) 的 0.5435 提升到 (m=17) 的 0.9520;系统性错误则从 0.4219 降到 0.3356。前者同时把每题按 128 token 上限估算的预算从 128 增至 2176,后者证明高共识也可能只是稳定偏差。二元独立理论检查在 (q=0.60,m=33) 时得到 0.8789。数字仅验证投票机制与假设边界,不代表任何语言模型、数据集或真实 API 成本。
还要谨慎解释脚本中的 vote_share:单样本时它恒为 1,并不意味着模型最有把握;样本增加后,它才逐步接近经验答案分布的最大质量。在分散错误情形,正确桶最终占约 0.54,却能压过每个约 0.15 的错误桶,所以准确率接近 1;这不是单条路径变聪明,而是估计众数更稳定。系统性错误情形中,错误桶约 0.52,采样越多越能确认错误众数。该对照也说明不能只画“采样数—准确率”一条曲线:至少还应画获胜票占比、唯一答案数和错误答案集中度,否则无法区分随机噪声被平均与偏差被放大。
升级为真实模型的最小路径
固定一个可公开获取的模型与精确 revision,冻结 few-shot exemplars,先在小型 GSM8K 子集上保存每条原始 completion。对每题生成 1、3、5、10、20、40 条路径时,最好一次生成最大池,再以前缀子集计算不同预算,保证横向比较使用同一批样本;同时另做多随机种子重复,估计采样波动。日志至少包含 qid、sample id、解码参数、原始文本、规范化答案、解析状态、输入/输出 token、延迟与模型版本。
若服务支持并行请求,并行只降低墙钟时间,不减少总 token 或费用。缓存必须以提示、模型版本和解码参数为键;否则改了温度却复用旧样本,会制造虚假的可复现性。论文使用 40 条不是通用最优点,应在本模型、本数据与本预算上画 Pareto 前沿。
评测协议:准确率之外必须报告什么
首先报 exact match,并把单路径随机采样、单路径贪心和 self-consistency 分开;(m=1) 的随机样本并不等于 temperature=0 的贪心基线。其次报每个 (m) 的均值、标准差或置信区间,并使用相同问题集合做成对比较。再次报总 completion、输入/输出 token、实际费用、p50/p95 延迟和解析失败率。成本公式可写成:
[ C(m)=\sum_{i=1}^{m}(c_{\text{in}}t^{(i)}{\text{in}}+c{\text{out}}t^{(i)}_{\text{out}}) ]
其中 (t_{\text{in/out}}) 是第 (i) 次请求的输入/输出 token,(c_{\text{in/out}}) 是对应单价;价格和模型接口随时间变化,本文不写死动态数字,实际运行前待人工核验。
最后报告 winning vote share(获胜答案票数占比)、唯一答案数和准确率按共识区间的分桶结果。共识可作为不确定性信号,但不能直接当校准概率;应检查“80% 共识”的题是否真的约有 80% 正确,并与拒答阈值共同评估覆盖率—准确率。
成本曲线也不应只用“调用次数乘单价”。长推理题的输出 token 方差可能远大于短题,且固定最大长度会让截断率随难度上升。建议对每道题分别计算从 (m=1) 到目标预算的增量成本与是否纠正答案,再汇总“每增加一千 token 带来的准确率增益”。若第 20 到第 40 条路径几乎不改变获胜桶,曲线已进入收益递减区;若仍频繁翻转,说明模型在该问题族上不稳定,应该比较自适应停止、外部验证器或工具执行,而不是默认继续堆采样。并行批处理的吞吐收益要与 token 成本分开呈现,因为它只改变等待时间,未减少计算总量。
失败分析:投票最容易在哪些地方骗人
第一类是解析错误。不同等价形式被拆成多个桶会稀释正确答案;过度归一化又可能把单位、符号或选项语义不同的答案错误合并。解析失败不能静默丢弃,否则有效样本数随题目难度变化。
第二类是相关错误。相同模型共享错误知识、歧义理解和提示诱导,几十条路径可能只是同一误解的表面改写。应抽样审计“高共识但错误”的题,比较推理路径的语义多样性,而不只统计词面差异。
第三类是数据泄漏与非独立请求。复用随机种子、服务端确定性缓存或一次请求中的退化多样性都会让样本看似很多、有效样本量却很小。第四类是预算不公平:用 40 条路径对比一次贪心却只报告准确率,无法回答额外 39 倍推理是否值得。
第五类是开放式答案。传统多数投票要求可稳定归一化的离散答案;摘要、长文本和多种等价证明没有天然桶。Universal Self-Consistency 用模型选择候选间最一致的解答,但引入了新的评审模型偏差与额外成本,不能与字符串投票混为一谈。
后续科研问题
最直接的问题是自适应预算:简单题在少量样本已形成稳定优势时能否提前停止,把预算留给困难题?Adaptive-Consistency 与 Early-Stopping Self-Consistency 已报告显著节省,但在新模型、新任务上仍需重做停止误差和最坏成本分析。第二,怎样估计路径相关性与有效样本量,而不是默认独立?第三,投票权重应来自序列概率、自评置信度、外部 verifier 还是执行结果?第四,能否对高共识错误做因果分类,区分知识缺失、题意误读、算术失误和解析器缺陷?第五,固定 token 预算下,增加路径数与延长单条推理应如何分配?这些问题比盲目把 (m) 从 40 加到 100 更有研究价值。
总结
Self-Consistency 是一个简单但假设很强的测试时计算方法:保持问题与提示固定,采样多条路径,规范化终值并投票。它在正确答案比任一错误模式更稳定时有效,在系统性错误占优时可能反噬。可靠复现必须把采样参数、解析器、平票、重复实验和 token 成本都当作协议的一部分。先用本文脚本验证聚合,再接入真实模型和固定数据子集,能避免把“多调用几次”误写成可比较的论文复现。
参考资料
检索日期:2026-08-31。
- Xuezhi Wang 等,2023,Self-Consistency Improves Chain of Thought Reasoning in Language Models(Google Research / ICLR 2023)
- Xuezhi Wang 等,论文 arXiv v4 与完整附录
- Jason Wei 等,2022,Chain-of-Thought Prompting Elicits Reasoning in Large Language Models(NeurIPS 2022)
- Karl Cobbe 等,2021,Training Verifiers to Solve Math Word Problems / GSM8K
- OpenAI,GSM8K 官方数据与代码仓库
- Google DeepMind,OneTwo 开源仓库与 v0.2.0 self-consistency 说明
- Pranjal Aggarwal 等,2023,Let’s Sample Step by Step: Adaptive-Consistency(EMNLP 2023)
- Yiwei Li 等,2024,Escape Sky-high Cost: Early-stopping Self-Consistency(ICLR 2024)
- Xinyun Chen 等,2023,Universal Self-Consistency with Large Language Models(Google DeepMind)