摘要
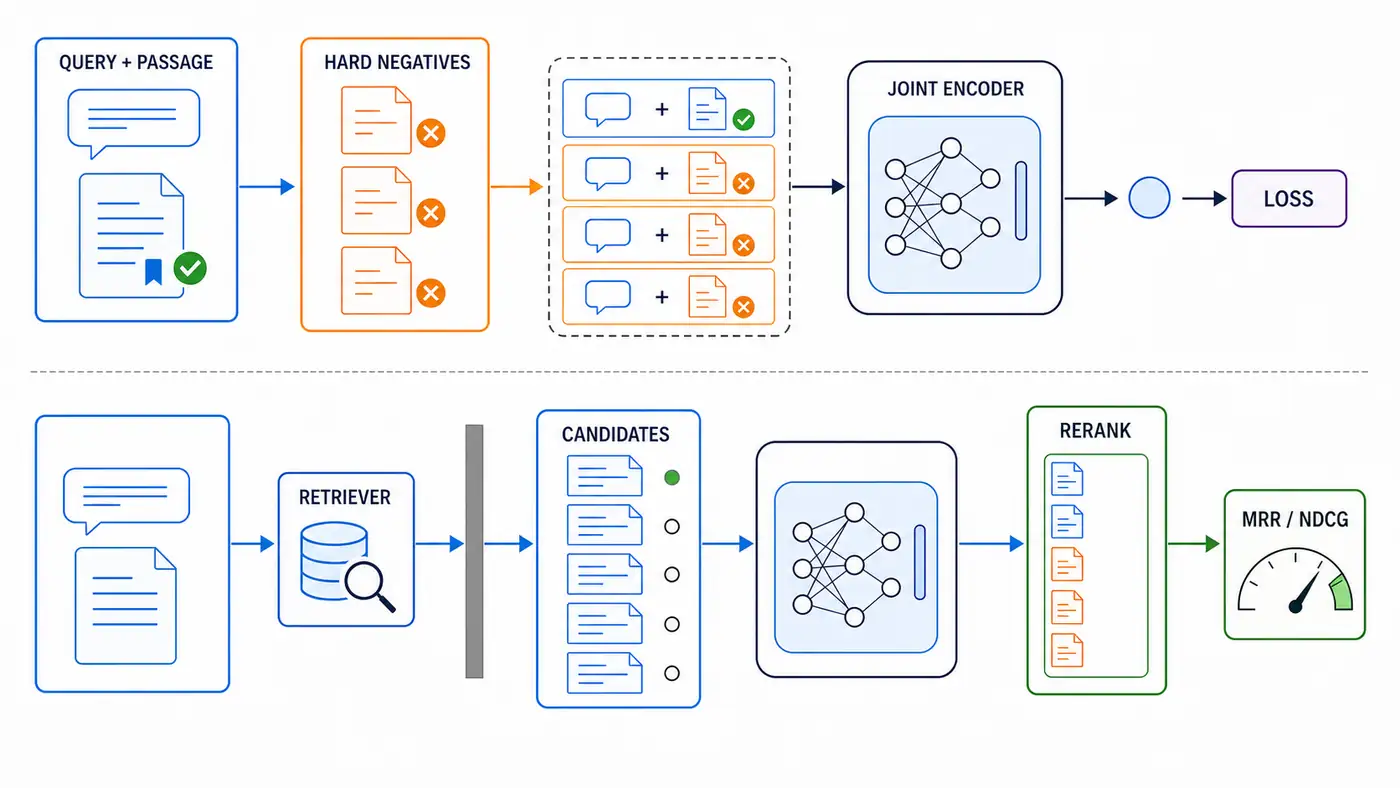
檢索系統常先從百萬文檔中召回幾十到上千個候選,再用更精細的模型重排。Cross-Encoder(交叉編碼器)把 query 與 passage 拼成一條序列,讓兩側 token 在每一層直接交互;它通常比雙塔打分更細,卻必須為每個候選重新前向計算。本文沿著 monoBERT 與 Sentence Transformers 官方實現,復現“候選集→聯合打分→重排→MRR/NDCG”的最小協議,並單獨考察 hard negative(困難負樣本):與問題高度相似、但實際上不相關的候選。附帶腳本只驗證數據、loss、排序和召回上限,不是 MS MARCO 成績復現。
復現價值與目標:重排器不是第二個檢索器
雙塔檢索把文檔預編碼為向量,適合大規模召回;Cross-Encoder 必須同時看到一對文本,適合在較小候選集內做精排。最容易誤解之處是:重排器只能改變已有候選的順序,相關文檔若未被第一階段召回,後面再強的模型也無從打分。
本次復現圍繞四個可檢查問題:輸入究竟是一對文本還是兩個獨立向量;點式二分類 loss 如何對應排序;隨機負樣本與困難負樣本提供了什麼不同信號;候選 Recall、MRR 與 NDCG 應如何分開報告。我們不下載大模型,而用白盒線性 pair scorer 模擬 Cross-Encoder 的接口,以便在 CPU 上看到每一步。
核心思想:聯合編碼、標量分數與訓練目標
1. query 與 passage 在進入模型前就合併
對查詢 和候選段落 ,BERT 式重排器構造:
若 batch 有 對文本、截斷長度為 ,輸入 ID 與 attention mask 的形狀均為 。Transformer 輸出最後一層隱藏狀態 ,再從 [CLS] 位置取 ,經線性頭得到一個標量 logit:
其中 是隱藏維度, 不是概率;需要時可用 轉為 。Sentence Transformers 文檔特別提醒,MS MARCO 系列模型默認返回 logits,但 sigmoid 是單調函數,所以不會改變同一查詢下的排序。
與雙塔的本質區別不是“多一層 MLP”,而是 query token 與 passage token 能通過 self-attention 逐層影響彼此。代價也很直接:若每個查詢重排 個候選,就要計算 個聯合序列,文檔側結果無法像雙塔 embedding 那樣離線複用。
2. 點式 BCE 足夠構成強基線
給相關標籤 ,二元交叉熵可寫為:
monoBERT 原論文把相關與不相關 passage 當作二分類樣本,並在 BM25 召回候選上逐對打分。當前 Sentence Transformers 官方示例仍把 BCE 作為強基線,同時提供 RankNet、ListNet、ListMLE 與面向 NDCG 的 LambdaLoss。論文報告的是特定數據與版本下的結果;本文實際驗證的只是 BCE 能否把正負 pair 分開,並不推斷某種 loss 普遍更優。
3. hard negative 教模型識別“相關話題”與“回答問題”的差別
隨機負樣本通常與 query 毫無關係,模型很快學會主題分類,卻未必能區分同一主題裡的近鄰。例如問題是“居里夫人出生在哪裡”,負樣本“皮埃爾·居里出生在巴黎”包含人物姓氏、出生關係和地點,表面高度匹配但答案實體錯誤。這種候選就是困難負樣本。
困難負樣本通常由 BM25 或雙塔檢索 top-k 挖出,再排除已標註正例並做過濾。若只相信稀疏 qrels,未標註的真實相關段落會被錯當負例,形成 false negative(假負樣本)。RocketQA 將這一問題明確化:用 cross-encoder 置信度去噪,再訓練 dense retriever。當前 Sentence Transformers 的 mine_hard_negatives 也暴露排名區間、絕對/相對 margin、最大分數與採樣策略。這裡的關鍵不是“越難越好”,而是難度與標籤可信度同時受控。
官方代碼閱讀路線:先追數據合同,再追模型類
第一站讀 Nogueira 與 Cho 的論文第 2 節:它限定任務是第二階段 reranking,將 query 作為 sentence A、passage 作為 sentence B,以 [CLS] 分類概率排序。隨後看官方 dl4marco-bert 倉庫:convert_msmarco_to_tfrecord.py 固化 query、passage、label 與最大長度,run_msmarco.py 負責訓練和輸出 run 文件,metrics.py 實現評測。倉庫 README 使用 BM25 top-1000 開發候選;這條候選來源必須進入實驗記錄。
第二站看 Sentence Transformers 當前代碼。examples/cross_encoder/training/ms_marco/training_ms_marco_bce.py 把 MS MARCO 的 query、passage_text、is_selected 映射成帶 0/1 標籤的文本對,再交給 BinaryCrossEntropyLoss。若研究排序目標,則轉到同目錄的 Lambda、ListNet、RankNet 腳本,核對輸入是 pair 還是每個 query 的 document list,不能只替換 loss 名稱。
第三站讀 sentence_transformers/util/hard_negatives.py。重點不是調用函數,而是審計 range_min/range_max、margin、正例排除、輸出格式和 miner 版本。一次挖掘應保存 query ID、candidate ID、miner 分數、qrels 判定和過濾原因,否則很難定位假負樣本。
最小實驗:白盒 pair scorer 驗證協議
運行:
python3 code/minimal_reranker.py --check-only
腳本固定隨機種子 58,構造 4 個查詢;每個查詢含一個正例、一個無關 easy negative 和一個主題相近但答案錯誤的 hard negative。特徵張量形狀打印為 [batch, vocab+2]:這只是可解釋的聯合 pair 特徵,模擬“一對文本→一個標量”的接口,不包含 Transformer/self-attention。
我們訓練兩次相同的 BCE scorer。第一次只見正例與隨機負例;第二次加入困難負例。候選初始順序故意把 hard negative 放在正例前。腳本還刪除最後一個查詢的正例,再次重排,用斷言驗證 candidate Recall@3 從 1.0 降為 0.75 後無法恢復。實際輸出來自本次 CPU smoke test;由於詞表、查詢和候選都很小,數字只能說明協議與失敗邊界,不能外推到 monoBERT、MS MARCO 或真實泛化能力。
將 toy 替換為真實模型時,最小升級路線是:固定一個公開 checkpoint;凍結 BM25 或雙塔候選 run;保存 tokenization 與截斷統計;分批調用 CrossEncoder;輸出 qid, pid, score, rank;用同一 qrels 同時報候選 Recall@K、重排 MRR@10 和 NDCG@10。訓練升級則應先抽樣人工審計 hard negatives,再比較 random-only、hard-only 和混合採樣。
分三層復現,避免把“能跑”誤寫成“復現論文”
第一層是協議復現,也就是本文腳本完成的工作:確認每條樣本包含 query、passage、label,確認一個 pair 只產生一個分數,確認排序指標按 query 聚合,並用缺失正例測試召回上限。它不需要預訓練模型,適合先發現 ID 錯位、排序方向反了、未命中查詢被跳過等基礎錯誤。
第二層是 checkpoint 推理復現。選定一個明確版本的開源 Cross-Encoder,在固定的候選 run 上只做推理;同時跑“保持第一階段原順序”的對照。這裡的研究問題是:聯合編碼是否真的改善同一批候選,而不是檢索器、候選數或 qrels 發生了變化。應記錄模型 commit、tokenizer 文件哈希、最大長度、推理精度和每批 pair 數。若官方模型卡報告 MS MARCO 分數,但本地使用了不同候選或評測腳本,只能稱遷移驗證,不能稱復現該數字。
第三層才是訓練復現。固定訓練 query 集後,先生成 random-only 數據,再用同一個 miner 產生 hard-only 與 mixed 兩套數據;正例、優化器、訓練步數和驗證候選保持一致。每個實驗至少運行多個隨機種子,報告均值與離散程度,並保存最優 checkpoint 的選擇規則。如果只發布最佳一次,採樣波動與選擇偏差會被誤寫成方法收益。
hard-negative 文件必須可審計
建議把挖掘結果保存為一行一個 pair 的 JSONL,至少含 qid、positive_pid、negative_pid、miner、miner_rank、miner_score、qrel_label、filter_reason 和語料版本。訓練加載器再從這份不可變清單生成 pair 或 list,而不是每個 epoch 在線重挖。這樣一旦結果下降,可以判斷是 miner 換了、過濾閾值變了,還是模型訓練本身不穩定。
人工審計不必覆蓋全部數據。可以從 rank 1–10、11–50 與 51–200 分層抽樣,並將負例標為“明確不相關”“相關但不回答”“另一種正確答案”“無法判斷”。前兩類才是可信訓練負例;後一類應排除或保留軟標籤。若不同標註者頻繁分歧,說明任務定義或 qrels 不足,而不是簡單提高 margin 就能解決。
評測協議:把召回上限、排序質量和成本拆開
MRR(Mean Reciprocal Rank)取第一個相關文檔名次的倒數再求平均:
若某查詢候選中沒有相關文檔,該項必須記 0,而不是從分母刪除。NDCG@k 允許分級相關標籤,並按位置折損收益;只有二元且每個 query 單正例時,它與首個正例名次高度相關。候選 Recall@K 則回答“正例是否進入了重排池”。因此應同時報告 retriever → candidate Recall 與 reranker → MRR/NDCG,並固定候選集合比較模型。
還要記錄吞吐、P50/P95 延遲、平均 token 數、截斷率和每 query 的候選數。把 K 從 50 增到 100 可能提高召回,卻近似翻倍聯合前向次數;如果不同模型使用不同 K,最終分數不可直接歸因於重排器。動態榜單、託管 checkpoint 與框架接口可能變化,本文未運行的版本均待人工核驗。
為了定位變化,逐 query 日誌比單個平均數更重要。每條查詢應保留重排前後 top-k、相關標籤、分數差和截斷長度,再按問題長度、實體密度、詞面重合度、是否含數字以及是否多答案分桶。若平均 MRR 上升只來自詞面高度重合的查詢,而專有名詞或長文檔桶下降,結論應寫成“特定子集改善”,而不是“重排器整體更懂語義”。
本文的證據邊界也應明確:論文與官方代碼支撐 Cross-Encoder 的結構、monoBERT 的訓練形式和公開實現路徑;本次實際運行只支撐 toy pair scorer 的 loss、排序與候選上限斷言;關於真實語料中假負樣本比例、不同 loss 的優劣和線上延遲,均屬於待實驗問題。作者推斷是:先把 hard-negative 清單和候選 run 變成可審計研究對象,通常比盲目擴大模型更能提高復現可信度。
失敗分析與排查順序
訓練 loss 下降,MRR 不升。 先檢查 batch 是否按 query 分組、label 與 passage ID 是否錯位,再看負樣本是否太容易。隨機負樣本上的分類準確率高,並不代表能重排檢索器 top-k。
加入 hard negatives 後全面下降。 抽樣復標最靠前負例,統計假負率;按 miner、rank 區間與 query 類型分桶。若只用極難樣本,模型可能把合理語義相似都壓低;混入隨機或中等難度負樣本,並用 margin 避免與正例分數過近的可疑項。
重排後 top-1 變好,NDCG@10 變差。 檢查點式 BCE 是否只學到“最像正例”的局部規則;若任務有多級相關性,可在同一候選集上比較 listwise/pairwise 目標。但必須保持 miner、batch、qrels 與評測腳本不變,避免把數據變化誤認作 loss 改進。
長 passage 表現異常。 保存截斷前後 token 長度,並確認 query 預留長度與 passage 截斷方向。關鍵信息在尾部時,512 token 上限可能切掉證據;這不是排序 loss 能修復的問題。
離線很好,在線變慢或漂移。 核對線上候選 K、最大長度、padding、mixed precision、batching 與 sigmoid 設置。sigmoid 不改排序,但閾值、校準與跨 query 分數比較會受影響;模型分數不能未經驗證就當概率。
後續科研問題
- 在固定標註預算下,人工復標 top-rank hard negatives 與擴大隨機負樣本,哪一個更改善跨域 NDCG?
- 能否用多標註者分歧或生成式證據檢查,估計 hard-negative 的假負概率,而不是二元刪除?
- pointwise、pairwise 與 listwise loss 的收益來自目標本身,還是來自不同的數據組織和採樣?
- 候選 K、序列長度和模型規模構成怎樣的成本—召回—排序前沿?
- 當 query 有多意圖或多個正確段落時,單正例 MRR 是否掩蓋了覆蓋與多樣性失敗?
這些問題都要求保留候選 run 和逐 query 日誌。沒有可回放候選,研究者無法判斷收益來自第一階段、困難負樣本、聯合編碼還是評測口徑。
總結
Cross-Encoder 的優勢來自 query 與 passage 的聯合 token 交互,限制則是每個候選都要重新計算。BCE 是可靠起點,hard negative 決定模型是否真正學會細粒度相關性,但挖得太難或標籤不全會製造假負樣本。一次可信復現應固定候選集,分別報告候選 Recall 與重排 MRR/NDCG,保存負樣本來源和截斷統計,並明確“重排無法救回未召回文檔”。先把協議跑通,再放大模型,得到的失敗證據比單個排行榜數字更有科研價值。
參考資料
檢索日期:2026-08-30。以下均為原論文、官方項目頁、官方代碼或官方框架文檔。
- Nogueira & Cho, 2019, Passage Re-ranking with BERT
- NYU DL, dl4marco-bert 官方復現倉庫
- Nguyen et al., 2016, MS MARCO: A Human Generated MAchine Reading COmprehension Dataset
- Microsoft, MS MARCO 官方項目頁
- Sentence Transformers, Cross-Encoder Usage 官方文檔
- Sentence Transformers, MS MARCO Cross-Encoder 訓練示例
- Sentence Transformers,
mine_hard_negatives官方源碼 - Qu et al., 2021, RocketQA: An Optimized Training Approach to Dense Passage Retrieval for Open-Domain Question Answering(NAACL / ACL Anthology)
- PaddlePaddle, RocketQA 官方代碼倉庫