摘要
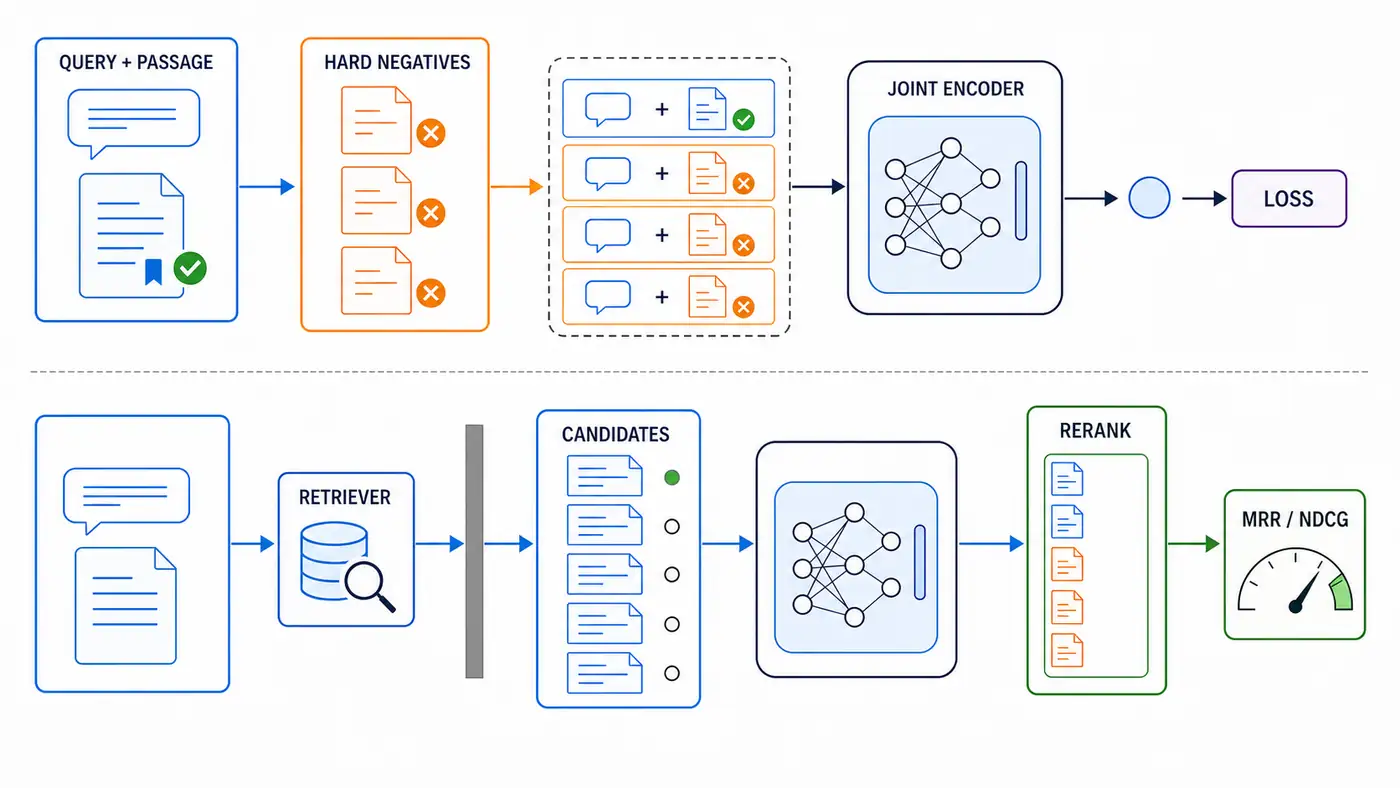
检索系统常先从百万文档中召回几十到上千个候选,再用更精细的模型重排。Cross-Encoder(交叉编码器)把 query 与 passage 拼成一条序列,让两侧 token 在每一层直接交互;它通常比双塔打分更细,却必须为每个候选重新前向计算。本文沿着 monoBERT 与 Sentence Transformers 官方实现,复现“候选集→联合打分→重排→MRR/NDCG”的最小协议,并单独考察 hard negative(困难负样本):与问题高度相似、但实际上不相关的候选。附带脚本只验证数据、loss、排序和召回上限,不是 MS MARCO 成绩复现。
复现价值与目标:重排器不是第二个检索器
双塔检索把文档预编码为向量,适合大规模召回;Cross-Encoder 必须同时看到一对文本,适合在较小候选集内做精排。最容易误解之处是:重排器只能改变已有候选的顺序,相关文档若未被第一阶段召回,后面再强的模型也无从打分。
本次复现围绕四个可检查问题:输入究竟是一对文本还是两个独立向量;点式二分类 loss 如何对应排序;随机负样本与困难负样本提供了什么不同信号;候选 Recall、MRR 与 NDCG 应如何分开报告。我们不下载大模型,而用白盒线性 pair scorer 模拟 Cross-Encoder 的接口,以便在 CPU 上看到每一步。
核心思想:联合编码、标量分数与训练目标
1. query 与 passage 在进入模型前就合并
对查询 q 和候选段落 di,BERT 式重排器构造:
xi=[CLS]q[SEP]di[SEP]
若 batch 有 B 对文本、截断长度为 L,输入 ID 与 attention mask 的形状均为 [B,L]。Transformer 输出最后一层隐藏状态 Hi∈RL×h,再从 [CLS] 位置取 hi∈Rh,经线性头得到一个标量 logit:
si=w⊤hi+b
其中 h 是隐藏维度,si 不是概率;需要时可用 σ(si) 转为 [0,1]。Sentence Transformers 文档特别提醒,MS MARCO 系列模型默认返回 logits,但 sigmoid 是单调函数,所以不会改变同一查询下的排序。
与双塔的本质区别不是“多一层 MLP”,而是 query token 与 passage token 能通过 self-attention 逐层影响彼此。代价也很直接:若每个查询重排 K 个候选,就要计算 K 个联合序列,文档侧结果无法像双塔 embedding 那样离线复用。
2. 点式 BCE 足够构成强基线
给相关标签 yi∈{0,1},二元交叉熵可写为:
LBCE=−B1i∑[yilogσ(si)+(1−yi)log(1−σ(si))]
monoBERT 原论文把相关与不相关 passage 当作二分类样本,并在 BM25 召回候选上逐对打分。当前 Sentence Transformers 官方示例仍把 BCE 作为强基线,同时提供 RankNet、ListNet、ListMLE 与面向 NDCG 的 LambdaLoss。论文报告的是特定数据与版本下的结果;本文实际验证的只是 BCE 能否把正负 pair 分开,并不推断某种 loss 普遍更优。
3. hard negative 教模型识别“相关话题”与“回答问题”的差别
随机负样本通常与 query 毫无关系,模型很快学会主题分类,却未必能区分同一主题里的近邻。例如问题是“居里夫人出生在哪里”,负样本“皮埃尔·居里出生在巴黎”包含人物姓氏、出生关系和地点,表面高度匹配但答案实体错误。这种候选就是困难负样本。
困难负样本通常由 BM25 或双塔检索 top-k 挖出,再排除已标注正例并做过滤。若只相信稀疏 qrels,未标注的真实相关段落会被错当负例,形成 false negative(假负样本)。RocketQA 将这一问题明确化:用 cross-encoder 置信度去噪,再训练 dense retriever。当前 Sentence Transformers 的 mine_hard_negatives 也暴露排名区间、绝对/相对 margin、最大分数与采样策略。这里的关键不是“越难越好”,而是难度与标签可信度同时受控。
官方代码阅读路线:先追数据合同,再追模型类
第一站读 Nogueira 与 Cho 的论文第 2 节:它限定任务是第二阶段 reranking,将 query 作为 sentence A、passage 作为 sentence B,以 [CLS] 分类概率排序。随后看官方 dl4marco-bert 仓库:convert_msmarco_to_tfrecord.py 固化 query、passage、label 与最大长度,run_msmarco.py 负责训练和输出 run 文件,metrics.py 实现评测。仓库 README 使用 BM25 top-1000 开发候选;这条候选来源必须进入实验记录。
第二站看 Sentence Transformers 当前代码。examples/cross_encoder/training/ms_marco/training_ms_marco_bce.py 把 MS MARCO 的 query、passage_text、is_selected 映射成带 0/1 标签的文本对,再交给 BinaryCrossEntropyLoss。若研究排序目标,则转到同目录的 Lambda、ListNet、RankNet 脚本,核对输入是 pair 还是每个 query 的 document list,不能只替换 loss 名称。
第三站读 sentence_transformers/util/hard_negatives.py。重点不是调用函数,而是审计 range_min/range_max、margin、正例排除、输出格式和 miner 版本。一次挖掘应保存 query ID、candidate ID、miner 分数、qrels 判定和过滤原因,否则很难定位假负样本。
最小实验:白盒 pair scorer 验证协议
运行:
python3 code/minimal_reranker.py --check-only
脚本固定随机种子 58,构造 4 个查询;每个查询含一个正例、一个无关 easy negative 和一个主题相近但答案错误的 hard negative。特征张量形状打印为 [batch, vocab+2]:这只是可解释的联合 pair 特征,模拟“一对文本→一个标量”的接口,不包含 Transformer/self-attention。
我们训练两次相同的 BCE scorer。第一次只见正例与随机负例;第二次加入困难负例。候选初始顺序故意把 hard negative 放在正例前。脚本还删除最后一个查询的正例,再次重排,用断言验证 candidate Recall@3 从 1.0 降为 0.75 后无法恢复。实际输出来自本次 CPU smoke test;由于词表、查询和候选都很小,数字只能说明协议与失败边界,不能外推到 monoBERT、MS MARCO 或真实泛化能力。
将 toy 替换为真实模型时,最小升级路线是:固定一个公开 checkpoint;冻结 BM25 或双塔候选 run;保存 tokenization 与截断统计;分批调用 CrossEncoder;输出 qid, pid, score, rank;用同一 qrels 同时报候选 Recall@K、重排 MRR@10 和 NDCG@10。训练升级则应先抽样人工审计 hard negatives,再比较 random-only、hard-only 和混合采样。
分三层复现,避免把“能跑”误写成“复现论文”
第一层是协议复现,也就是本文脚本完成的工作:确认每条样本包含 query、passage、label,确认一个 pair 只产生一个分数,确认排序指标按 query 聚合,并用缺失正例测试召回上限。它不需要预训练模型,适合先发现 ID 错位、排序方向反了、未命中查询被跳过等基础错误。
第二层是 checkpoint 推理复现。选定一个明确版本的开源 Cross-Encoder,在固定的候选 run 上只做推理;同时跑“保持第一阶段原顺序”的对照。这里的研究问题是:联合编码是否真的改善同一批候选,而不是检索器、候选数或 qrels 发生了变化。应记录模型 commit、tokenizer 文件哈希、最大长度、推理精度和每批 pair 数。若官方模型卡报告 MS MARCO 分数,但本地使用了不同候选或评测脚本,只能称迁移验证,不能称复现该数字。
第三层才是训练复现。固定训练 query 集后,先生成 random-only 数据,再用同一个 miner 产生 hard-only 与 mixed 两套数据;正例、优化器、训练步数和验证候选保持一致。每个实验至少运行多个随机种子,报告均值与离散程度,并保存最优 checkpoint 的选择规则。如果只发布最佳一次,采样波动与选择偏差会被误写成方法收益。
hard-negative 文件必须可审计
建议把挖掘结果保存为一行一个 pair 的 JSONL,至少含 qid、positive_pid、negative_pid、miner、miner_rank、miner_score、qrel_label、filter_reason 和语料版本。训练加载器再从这份不可变清单生成 pair 或 list,而不是每个 epoch 在线重挖。这样一旦结果下降,可以判断是 miner 换了、过滤阈值变了,还是模型训练本身不稳定。
人工审计不必覆盖全部数据。可以从 rank 1–10、11–50 与 51–200 分层抽样,并将负例标为“明确不相关”“相关但不回答”“另一种正确答案”“无法判断”。前两类才是可信训练负例;后一类应排除或保留软标签。若不同标注者频繁分歧,说明任务定义或 qrels 不足,而不是简单提高 margin 就能解决。
评测协议:把召回上限、排序质量和成本拆开
MRR(Mean Reciprocal Rank)取第一个相关文档名次的倒数再求平均:
MRR=∣Q∣1q∈Q∑rankq1
若某查询候选中没有相关文档,该项必须记 0,而不是从分母删除。NDCG@k 允许分级相关标签,并按位置折损收益;只有二元且每个 query 单正例时,它与首个正例名次高度相关。候选 Recall@K 则回答“正例是否进入了重排池”。因此应同时报告 retriever → candidate Recall 与 reranker → MRR/NDCG,并固定候选集合比较模型。
还要记录吞吐、P50/P95 延迟、平均 token 数、截断率和每 query 的候选数。把 K 从 50 增到 100 可能提高召回,却近似翻倍联合前向次数;如果不同模型使用不同 K,最终分数不可直接归因于重排器。动态榜单、托管 checkpoint 与框架接口可能变化,本文未运行的版本均待人工核验。
为了定位变化,逐 query 日志比单个平均数更重要。每条查询应保留重排前后 top-k、相关标签、分数差和截断长度,再按问题长度、实体密度、词面重合度、是否含数字以及是否多答案分桶。若平均 MRR 上升只来自词面高度重合的查询,而专有名词或长文档桶下降,结论应写成“特定子集改善”,而不是“重排器整体更懂语义”。
本文的证据边界也应明确:论文与官方代码支撑 Cross-Encoder 的结构、monoBERT 的训练形式和公开实现路径;本次实际运行只支撑 toy pair scorer 的 loss、排序与候选上限断言;关于真实语料中假负样本比例、不同 loss 的优劣和线上延迟,均属于待实验问题。作者推断是:先把 hard-negative 清单和候选 run 变成可审计研究对象,通常比盲目扩大模型更能提高复现可信度。
失败分析与排查顺序
训练 loss 下降,MRR 不升。 先检查 batch 是否按 query 分组、label 与 passage ID 是否错位,再看负样本是否太容易。随机负样本上的分类准确率高,并不代表能重排检索器 top-k。
加入 hard negatives 后全面下降。 抽样复标最靠前负例,统计假负率;按 miner、rank 区间与 query 类型分桶。若只用极难样本,模型可能把合理语义相似都压低;混入随机或中等难度负样本,并用 margin 避免与正例分数过近的可疑项。
重排后 top-1 变好,NDCG@10 变差。 检查点式 BCE 是否只学到“最像正例”的局部规则;若任务有多级相关性,可在同一候选集上比较 listwise/pairwise 目标。但必须保持 miner、batch、qrels 与评测脚本不变,避免把数据变化误认作 loss 改进。
长 passage 表现异常。 保存截断前后 token 长度,并确认 query 预留长度与 passage 截断方向。关键信息在尾部时,512 token 上限可能切掉证据;这不是排序 loss 能修复的问题。
离线很好,在线变慢或漂移。 核对线上候选 K、最大长度、padding、mixed precision、batching 与 sigmoid 设置。sigmoid 不改排序,但阈值、校准与跨 query 分数比较会受影响;模型分数不能未经验证就当概率。
后续科研问题
- 在固定标注预算下,人工复标 top-rank hard negatives 与扩大随机负样本,哪一个更改善跨域 NDCG?
- 能否用多标注者分歧或生成式证据检查,估计 hard-negative 的假负概率,而不是二元删除?
- pointwise、pairwise 与 listwise loss 的收益来自目标本身,还是来自不同的数据组织和采样?
- 候选 K、序列长度和模型规模构成怎样的成本—召回—排序前沿?
- 当 query 有多意图或多个正确段落时,单正例 MRR 是否掩盖了覆盖与多样性失败?
这些问题都要求保留候选 run 和逐 query 日志。没有可回放候选,研究者无法判断收益来自第一阶段、困难负样本、联合编码还是评测口径。
总结
Cross-Encoder 的优势来自 query 与 passage 的联合 token 交互,限制则是每个候选都要重新计算。BCE 是可靠起点,hard negative 决定模型是否真正学会细粒度相关性,但挖得太难或标签不全会制造假负样本。一次可信复现应固定候选集,分别报告候选 Recall 与重排 MRR/NDCG,保存负样本来源和截断统计,并明确“重排无法救回未召回文档”。先把协议跑通,再放大模型,得到的失败证据比单个排行榜数字更有科研价值。
参考资料
检索日期:2026-08-30。以下均为原论文、官方项目页、官方代码或官方框架文档。
- Nogueira & Cho, 2019, Passage Re-ranking with BERT
- NYU DL, dl4marco-bert 官方复现仓库
- Nguyen et al., 2016, MS MARCO: A Human Generated MAchine Reading COmprehension Dataset
- Microsoft, MS MARCO 官方项目页
- Sentence Transformers, Cross-Encoder Usage 官方文档
- Sentence Transformers, MS MARCO Cross-Encoder 训练示例
- Sentence Transformers,
mine_hard_negatives 官方源码
- Qu et al., 2021, RocketQA: An Optimized Training Approach to Dense Passage Retrieval for Open-Domain Question Answering(NAACL / ACL Anthology)
- PaddlePaddle, RocketQA 官方代码仓库
Companion Code
配套示例代码
与正文对应的教学示例。请先阅读运行说明,下载所需文件并保留目录结构;也可以展开源码对照阅读。
展开查看完整源码minimal_reranker.py · 194 行
#!/usr/bin/env python3
"""Dependency-free protocol smoke test for reranking and hard negatives.

This is deliberately a transparent linear pair scorer, not a Transformer and
not a reproduction of MS MARCO numbers. It verifies the data contract, binary
cross-entropy, candidate-only reranking, MRR/NDCG, and the recall ceiling.
"""

from __future__ import annotations

import argparse
import math
import random
import re
from dataclasses import dataclass


SEED = 58


@dataclass(frozen=True)
class Case:
    query: str
    positive: str
    hard: str
    easy: str


CASES = [
    Case(
        "where was marie curie born",
        "marie curie was born in warsaw",
        "marie curie was born in paris and studied physics",
        "plants absorb carbon dioxide during photosynthesis",
    ),
    Case(
        "who wrote pride and prejudice",
        "jane austen wrote pride and prejudice",
        "charles dickens wrote pride and prejudice adaptations",
        "tokyo is the capital of japan",
    ),
    Case(
        "what is the capital of japan",
        "tokyo is the capital of japan",
        "kyoto was the capital of japan for centuries",
        "leonardo da vinci painted the mona lisa",
    ),
    Case(
        "which gas do plants absorb",
        "plants absorb carbon dioxide during photosynthesis",
        "plants absorb oxygen during respiration",
        "jane austen wrote pride and prejudice",
    ),
]


def tokens(text: str) -> list[str]:
    return re.findall(r"[a-z]+", text.lower())


def make_vocab(cases: list[Case]) -> list[str]:
    texts = [value for case in cases for value in (case.positive, case.hard, case.easy)]
    return sorted({token for text in texts for token in tokens(text)})


def pair_features(query: str, passage: str, vocab: list[str]) -> list[float]:
    q = set(tokens(query))
    p = set(tokens(passage))
    overlap = len(q & p) / max(len(q), 1)
    # Passage unigrams plus a query-passage interaction feature make both
    # inputs observable to one scorer. A real Cross-Encoder learns far richer
    # token interactions through self-attention.
    return [1.0, overlap] + [float(token in p) for token in vocab]


def sigmoid(value: float) -> float:
    if value >= 0:
        return 1.0 / (1.0 + math.exp(-value))
    exp_value = math.exp(value)
    return exp_value / (1.0 + exp_value)


def score(weights: list[float], features: list[float]) -> float:
    return sum(weight * feature for weight, feature in zip(weights, features))


def binary_cross_entropy(logit: float, label: int) -> float:
    # Stable BCE-with-logits expression.
    return max(logit, 0.0) - logit * label + math.log1p(math.exp(-abs(logit)))


def examples(cases: list[Case], include_hard: bool) -> list[tuple[str, str, int, str]]:
    rows = []
    for case in cases:
        rows.append((case.query, case.positive, 1, "positive"))
        rows.append((case.query, case.easy, 0, "easy"))
        if include_hard:
            rows.append((case.query, case.hard, 0, "hard"))
    return rows


def train(cases: list[Case], vocab: list[str], include_hard: bool, steps: int) -> tuple[list[float], float, float]:
    rng = random.Random(SEED)
    weights = [rng.uniform(-0.01, 0.01) for _ in range(2 + len(vocab))]
    rows = examples(cases, include_hard)

    def mean_loss() -> float:
        return sum(
            binary_cross_entropy(score(weights, pair_features(query, passage, vocab)), label)
            for query, passage, label, _ in rows
        ) / len(rows)

    initial_loss = mean_loss()
    learning_rate = 0.08
    for _ in range(steps):
        rng.shuffle(rows)
        for query, passage, label, _ in rows:
            features = pair_features(query, passage, vocab)
            prediction = sigmoid(score(weights, features))
            for i, feature in enumerate(features):
                weights[i] -= learning_rate * (prediction - label) * feature
    return weights, initial_loss, mean_loss()


def reciprocal_rank(rank: int | None) -> float:
    return 0.0 if rank is None else 1.0 / rank


def ndcg_at_3(rank: int | None) -> float:
    return 0.0 if rank is None or rank > 3 else 1.0 / math.log2(rank + 1)


def evaluate(weights: list[float], vocab: list[str], drop_last_positive: bool) -> dict[str, float]:
    ranks: list[int | None] = []
    for index, case in enumerate(CASES):
        candidates = [("hard", case.hard), ("positive", case.positive), ("easy", case.easy)]
        if drop_last_positive and index == len(CASES) - 1:
            candidates = [(name, text) for name, text in candidates if name != "positive"]
        ranked = sorted(
            candidates,
            key=lambda item: score(weights, pair_features(case.query, item[1], vocab)),
            reverse=True,
        )
        labels = [name for name, _ in ranked]
        rank = labels.index("positive") + 1 if "positive" in labels else None
        ranks.append(rank)
        printable_rank = "missing" if rank is None else str(rank)
        print(f"q{index}: rank={printable_rank} order={','.join(labels)}")

    n = len(ranks)
    return {
        "candidate_recall@3": sum(rank is not None for rank in ranks) / n,
        "mrr": sum(reciprocal_rank(rank) for rank in ranks) / n,
        "ndcg@3": sum(ndcg_at_3(rank) for rank in ranks) / n,
    }


def run(steps: int, check_only: bool) -> None:
    vocab = make_vocab(CASES)
    easy_weights, easy_start, easy_end = train(CASES, vocab, include_hard=False, steps=steps)
    hard_weights, hard_start, hard_end = train(CASES, vocab, include_hard=True, steps=steps)

    print(f"seed={SEED} vocab={len(vocab)} pair_features=(batch, {len(vocab) + 2})")
    print(f"easy-only rows={len(examples(CASES, False))} loss={easy_start:.4f}->{easy_end:.4f}")
    print(f"mixed rows={len(examples(CASES, True))} loss={hard_start:.4f}->{hard_end:.4f}")
    print("easy-only reranking:")
    easy_metrics = evaluate(easy_weights, vocab, drop_last_positive=False)
    print("hard-negative reranking:")
    hard_metrics = evaluate(hard_weights, vocab, drop_last_positive=False)
    print("hard-negative reranking with one missing positive:")
    ceiling_metrics = evaluate(hard_weights, vocab, drop_last_positive=True)
    for name, values in (("easy", easy_metrics), ("hard", hard_metrics), ("ceiling", ceiling_metrics)):
        print(name + ": " + " ".join(f"{key}={value:.3f}" for key, value in values.items()))

    assert len(pair_features(CASES[0].query, CASES[0].positive, vocab)) == len(vocab) + 2
    assert easy_end < easy_start and hard_end < hard_start
    assert hard_metrics["mrr"] > easy_metrics["mrr"]
    assert hard_metrics["candidate_recall@3"] == 1.0
    assert ceiling_metrics["candidate_recall@3"] == 0.75
    assert ceiling_metrics["mrr"] <= ceiling_metrics["candidate_recall@3"]
    if check_only:
        print("check-only: PASS")


def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser()
    parser.add_argument("--steps", type=int, default=180)
    parser.add_argument("--check-only", action="store_true")
    return parser.parse_args()


if __name__ == "__main__":
    args = parse_args()
    run(steps=args.steps, check_only=args.check_only)