摘要
稠密检索(dense retrieval)把查询和文档分别压缩为定长向量,再用点积或余弦相似度找最近邻。它真正值得复现的不是“调用一个 embedding API”,而是三个可检验环节:双塔如何产生向量,负样本如何塑造空间,离线索引与在线查询如何组成评测协议。本文以 DPR 和 Contriever 为两条主线,阅读官方实现,并提供一个无第三方依赖的最小实验。脚本只验证机制与日志,不声称复现论文规模的 BERT、Wikipedia、Natural Questions 或 BEIR 结果。
复现价值与目标:把向量接口还原成训练问题
词面检索会奖励共同词项;稠密检索希望把“红色星球”和“Mars”也拉近。代价是:相关性不再由可读的词频公式直接决定,而由训练对、负样本、池化、归一化和索引共同决定。因此,本次目标不是追逐一个排行榜数字,而是回答四个问题:
- 查询塔和文档塔输出的张量形状是什么?
- 一个 batch 为什么同时提供正样本和负样本?
- 为什么文档可以离线编码,而查询必须在线编码?
- Recall@k 上升时,是否只是训练集记忆、假负样本泄漏或评测口径改变?
核心思想:双塔、分数矩阵与对比损失
1. 两个编码器先分开读,再在向量空间相遇
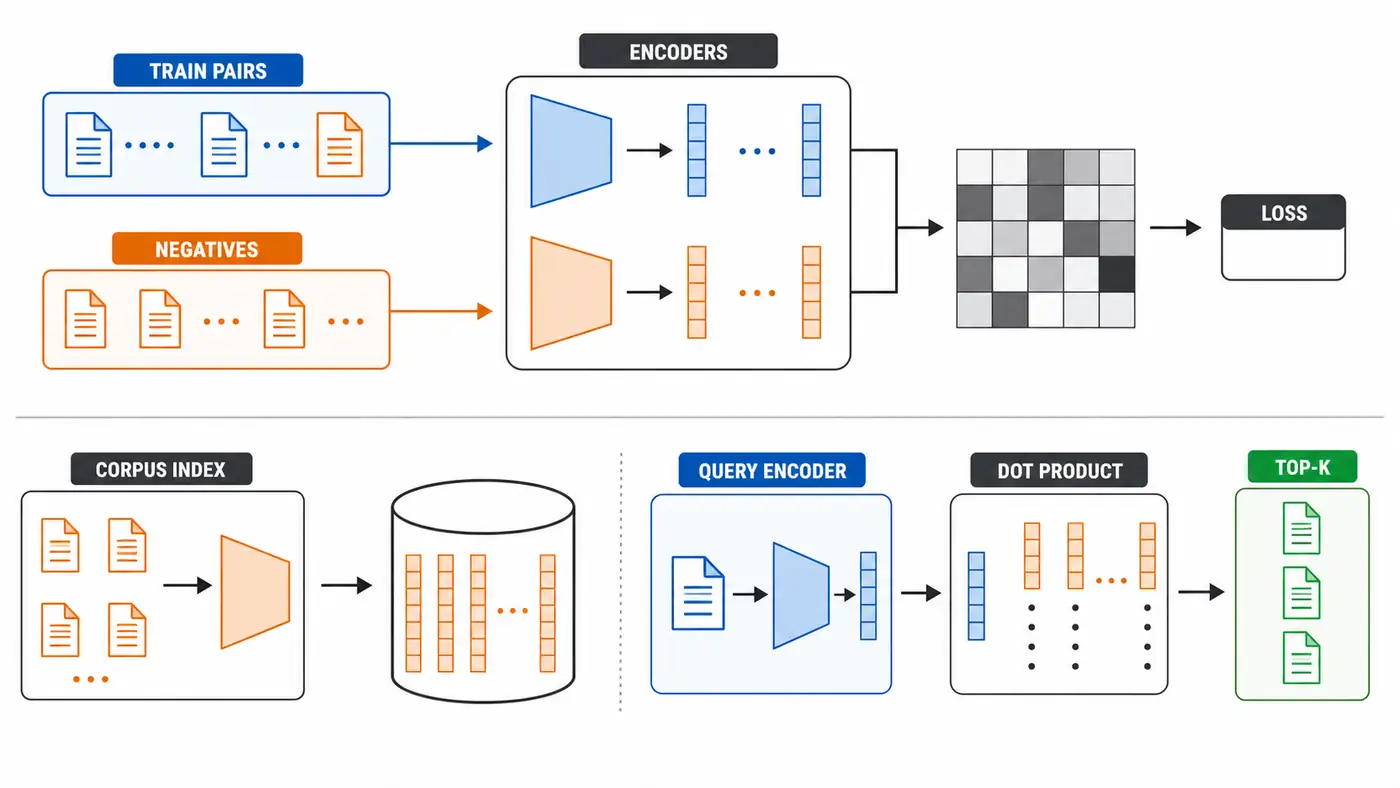
给定查询 (q_i) 和文档 (p_j),双塔分别计算:
hiq=fq(qi)∈Rd,hjp=fp(pj)∈Rd
其中 (f_q) 是查询编码器,(f_p) 是文档编码器,(d) 是向量维度。若一个 batch 有 (B) 个查询和 (B) 个正文档,则两侧张量形状都是 ([B,d])。它们之间没有逐 token 的 cross-attention;这正是文档向量能被预计算的原因。
相似度常取点积:
sij=τ(hiq)⊤hjp
因此一次矩阵乘法得到 ([B,B]) 的分数矩阵。温度 (τ>0) 控制 softmax 的尖锐程度;若向量先做 L2 归一化,点积等价于余弦相似度。是否归一化不能靠习惯猜测,必须与训练和索引配置一致。
2. 对角线是正样本,其余位置成为 batch 内负样本
若第 (i) 个查询的正文档也是第 (i) 行文档,损失为:
L=−B1i=1∑Blog∑j=1Bexp(sij)exp(sii)
分母中的其余 (B-1) 个文档就是 in-batch negatives(批内负样本)。batch 变大通常意味着更多对比项,但也更容易把未标注的相关文档错当作负样本。硬负样本则是“看起来很像却不是标注答案”的文档;它能增加训练信号,也可能放大标注缺口。
3. DPR 与 Contriever 改变的是监督来源,不是检索骨架
DPR(Karpukhin 等,EMNLP 2020)用问答监督训练查询编码器和 passage 编码器,论文实现以 BERT 表示和点积打分为核心,并组合随机或 BM25 困难负样本。论文摘要报告:在其开放域问答设置中,DPR 相比强 Lucene-BM25 的 top-20 passage retrieval accuracy 有 9–19 个百分点的绝对提升。这是论文报告,不是本文 toy 数据的结论。
Contriever(Izacard 等,TMLR 2022)关注无监督迁移:从同一文本构造两个扰动视图,以裁剪、删除等增强形成伪正对,再做对比预训练。官方模型默认对最后一层 token 表示做 mask 后平均池化;官方页面报告其无监督模型在 BEIR 的 Recall@100 上超过 BM25 的 15 个数据集中的 11 个。它没有证明稠密检索在任何领域都胜过 BM25;指标、数据集和迁移条件缺一不可。
数据与负样本合同:模型开始训练前先冻结证据
稠密检索最容易被忽略的输入不是文本,而是相关性关系。每个样本至少应保留 query_id、原始 query、positive_passage_ids、负样本 ID 与来源;passage 表必须有稳定的文档 ID、标题、正文和切分版本。一个查询可能有多个正确文档,所以不能把训练时选中的单个正样本误当成唯一真值。若 qrels 允许三个相关文档,预测命中另外两个也应算正确;否则所谓“困难负样本”可能只是漏标正样本。
负样本来源决定模型学到什么边界。随机负样本很快会变得太容易;batch 内负样本便宜,却依赖 batch 的主题分布;BM25 负样本词面相似,适合逼迫模型区分实体与关系;由旧稠密模型挖出的近邻更接近当前决策边界,但会继承旧模型偏差。实验日志应分别记录四类负样本的数量、被判为假负的比例和损失贡献,不能只写一个笼统的 num_negatives。
训练、验证和测试还要按信息来源切分。如果同一文章的相邻 passage 同时出现在训练与测试中,模型可能靠局部措辞而非可迁移语义命中。对 Contriever 式自监督训练,还应保存增强前文本、两次增强后的视图和随机种子;删除词、裁剪长度或采样窗口的改变,本质上改变了“什么应当保持不变”的学习假设。对 DPR 式问答监督,则要记录答案字符串如何映射到 passage,以及没有唯一证据时如何选正样本。
官方代码阅读路线:先跟数据流,不先追配置项
阅读 DPR 仓库可按四步走。第一,看 dpr/models/biencoder.py 中查询塔与上下文塔怎样返回表示;第二,看 BiEncoderNllLoss.calc 如何形成分数矩阵、做 log_softmax,再把正样本位置交给 NLL;第三,看 generate_dense_embeddings.py 如何分片生成文档向量;第四,看 dense_retriever.py 如何装载 FAISS 索引并输出 top-k。官方仓库已于 2023 年归档,所以复现时应固定 commit 和依赖,而不是假设最新 Transformers 一定兼容。
阅读 Contriever 仓库时,先看 src/contriever.py:forward 对 padding 位置清零,再按有效 token 数做平均池化。随后看 src/inbatch.py 的对比学习入口、generate_passage_embeddings.py 的分片保存,以及 passage_retrieval.py 的查询编码、索引加载、近邻搜索和 answer match。官方 README 还特别说明 Natural Questions 的答案预处理与 DPR 版本略有不同;若不记录数据版本,两个“Recall@k”可能并不可比。
最小实验:手写一遍比封装调用更有解释力
code/minimal_dense_retrieval.py 只用 Python 标准库,固定随机种子 57。它为查询塔和文档塔维护两套独立的 24 维词向量表,对句子做平均池化,手工计算 6×6 点积分数、softmax 交叉熵及梯度,再把 10 篇 passage 编成离线索引。运行:
python3 code/minimal_dense_retrieval.py --check-only
本次实际验证:查询向量形状为 ([6,24]),passage 索引为 ([10,24]),训练分数矩阵为 ([6,6]);240 步后损失从 1.7899 降到 0.0044,toy 集 Recall@1、Recall@3 和 MRR 都为 1.0,断言通过。这个结果只证明梯度、索引、qrels 和指标实现自洽。训练查询与测试查询相同、语料只有十篇,因此满分主要是记忆能力检查,不能外推为 DPR 或 Contriever 的泛化结果。
若要升级为论文级复现,应把词表平均替换成官方 checkpoint,严格复用 passage 切分、query/answer 预处理和负样本文件;生成文档 embedding 时记录模型哈希、维度、归一化与 dtype;最后才在 exact search 与 FAISS 近似索引之间比较质量—延迟差异。大模型下载、完整 Wikipedia 索引和 BEIR 评测本次均未运行,待人工核验。
从 toy 到官方模型:分三段复现,不一次放大所有变量
第一段是协议复现:保留本文的小语料,用标准库或小型神经网络确认正样本下标、分数方向、Recall/MRR 与输出 ID 映射。此时目标是让故意交换 qrels、翻转分数或打乱 passage ID 时测试必然失败。若错误注入后指标仍不变,评测脚本比模型更值得怀疑。
第二段是模型复现:语料与 qrels 不变,只替换为官方 DPR 或 Contriever checkpoint。先用精确矩阵乘法,不启用近似索引;抽查同一段文本经过批处理与单条编码所得向量是否一致,padding 是否进入平均池化,模型是否处于 eval 模式。DPR 查询塔与文档塔不能交换;Contriever 的池化和文本规范化必须跟 checkpoint 配置一致。这样得到的是模型接口验证,仍不是论文 benchmark 复现。
第三段才是系统复现:换成论文数据版本,分片生成全量 passage embedding,构建 FAISS 索引,再跑官方评测。每个分片应记录 passage ID 范围、向量行数、维度、校验和与生成耗时;合并后检查 ID 唯一性和总数。先用少量 query 对照 exact top-k,再启用近似参数。只有数据、模型、exact search 都对齐后,ANN 的速度与召回损失才有解释意义。
这三段每次只替换一层,因此失败能被定位:协议段失败是实现或 qrels 问题,模型段失败是预处理或 checkpoint 问题,系统段失败才主要考虑分片、索引和资源配置。直接从 toy 跳到百万文档,会把所有错误都伪装成“模型效果不好”。
评测协议:先冻结 qrels,再谈模型优劣
| 问题 |
指标 |
必须固定的口径 |
| 前 k 个结果是否覆盖相关文档 |
Recall@k |
每个查询的相关文档集合、去重规则 |
| 第一个相关文档排得多靠前 |
MRR@k |
截断深度、无命中时记零 |
| 多级相关性排序是否合理 |
nDCG@k |
relevance grade 与折扣公式 |
| 索引是否值得部署 |
QPS、P50/P95 延迟、内存 |
硬件、batch、精度、索引参数 |
开放域问答常用 answer string 是否出现在 passage 中来判命中,但字符串规则会受大小写、别名、分词和规范化影响。纯检索数据则使用 qrels(query relevance labels,查询—文档相关性标注)。二者不能混成同一个“accuracy”。至少同时报告 BM25、exact dense search 和近似 dense search;若只在一个域内微调再测试,不能据此宣称零样本泛化。BEIR 的价值正是跨任务、跨领域检查这种迁移,但平均分仍应配合逐数据集结果阅读。
失败分析:从症状回到可证伪原因
损失下降但 Recall 不升。 先查正样本下标是否对应分数矩阵对角线,再查训练与检索是否使用同一 tokenizer、池化和归一化。toy 集若训练满分而留出集崩溃,是过拟合证据,不是索引 bug。
语义近、事实错的文档排在前面。 这通常暴露负样本不够难。加入 BM25 或旧模型挖出的 hard negatives,同时审计它们是否其实也是相关文档;否则模型会被迫分开两个都正确的答案。
exact search 正常,FAISS 结果下降。 固定同一批向量逐 query 对比 top-k ID,检查距离类型、归一化、向量顺序和文档 ID 映射,再调 nprobe、图搜索深度或量化配置。近似索引的误差不能算到编码器头上。
换域后 BM25 反超。 先按查询类型、文档长度和专有名词比例分桶。稠密模型可能学到训练域的语义捷径,而词面信号对编号、实体名和术语更稳。合理基线是报告稀疏、稠密与 hybrid,而不是删掉“不够先进”的 BM25。
结果无法复现。 保存 query、正样本 ID、负样本来源、模型与数据哈希、每个 checkpoint 的 Recall 曲线,以及检索输出而非只存聚合分数。索引必须能追溯到生成它的模型;模型更新但索引未重建,会产生最隐蔽的版本错配。
后续科研问题
- 在固定训练预算下,增加 batch 内负样本与提高 hard-negative 质量,哪一个更有效?应同时测假负率。
- Contriever 式自监督增强在医学缩写、代码标识符或多语言文本上,会不会删除真正决定相关性的 token?
- 向量归一化、温度和 embedding 维度如何共同改变难例的局部邻域,而不只是平均 Recall?
- 当语料持续更新时,旧 passage embedding 的漂移如何被检测?能否用小规模 exact-search 哨兵集触发重建索引?
- 稠密检索的错误究竟来自表示、标注还是 ANN 索引?需要把 encoder error 与 search error 分开报告。
这些问题都可以从本文脚本扩展:增加留出查询、构造一词之差的假负样本、记录每步相似度矩阵,再替换为真实 checkpoint。研究价值来自控制变量和失败证据,而不是把模型名字换得更大。
总结
双塔检索的关键约束很简单:查询和文档先独立编码,训练用对比损失塑造空间,推理时文档离线建索引、查询在线找近邻。DPR 说明有监督问答对与困难负样本能训练强检索器;Contriever 说明无监督对比预训练可以改善跨域起点。但任何“稠密优于稀疏”的结论都依赖数据、指标和版本。最小复现应先让分数矩阵、qrels、索引和日志可检查,再逐步放大模型与语料。
参考资料
检索日期:2026-08-29。
- Karpukhin et al., 2020, Dense Passage Retrieval for Open-Domain Question Answering(EMNLP / ACL Anthology)
- Meta AI Research, DPR 官方代码仓库(已归档)
- Izacard et al., 2022, Unsupervised Dense Information Retrieval with Contrastive Learning(TMLR / OpenReview PDF)
- Meta AI Research, Contriever 官方代码仓库(已归档)
- Thakur et al., 2021, BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models(NeurIPS Datasets and Benchmarks)
- Meta AI Research, FAISS Getting Started
Companion Code
配套示例代码
与正文对应的教学示例。请先阅读运行说明,下载所需文件并保留目录结构;也可以展开源码对照阅读。
展开查看完整源码minimal_dense_retrieval.py · 182 行
#!/usr/bin/env python3
"""Dependency-free toy reproduction of dual-tower dense retrieval.

This is a protocol check, not a reproduction of DPR/Contriever benchmark
numbers. It makes the score matrix, in-batch contrastive loss, offline passage
index, online top-k search, and retrieval metrics directly inspectable.
"""

from __future__ import annotations

import argparse
import math
import random
import re
from dataclasses import dataclass


SEED = 57
DIM = 24


@dataclass(frozen=True)
class Example:
    query: str
    passage: str


TRAIN = [
    Example("where was marie curie born", "marie curie was born in warsaw poland"),
    Example("who wrote pride and prejudice", "jane austen wrote pride and prejudice"),
    Example("what planet is called the red planet", "mars is known as the red planet"),
    Example("which gas do plants absorb", "plants absorb carbon dioxide during photosynthesis"),
    Example("what is the capital of japan", "tokyo is the capital city of japan"),
    Example("who painted the mona lisa", "leonardo da vinci painted the mona lisa"),
]

CORPUS = [ex.passage for ex in TRAIN] + [
    "pierre curie was born in paris france",
    "venus is sometimes called earths sister planet",
    "plants release oxygen as a product of photosynthesis",
    "kyoto was an imperial capital of japan",
]
QRELS = {i: i for i in range(len(TRAIN))}


def tokenize(text: str) -> list[str]:
    return re.findall(r"[a-z]+", text.lower())


def build_vocab(texts: list[str]) -> list[str]:
    return sorted({token for text in texts for token in tokenize(text)})


def init_table(vocab: list[str], rng: random.Random) -> dict[str, list[float]]:
    return {token: [rng.uniform(-0.08, 0.08) for _ in range(DIM)] for token in vocab}


def mean_vector(text: str, table: dict[str, list[float]]) -> list[float]:
    tokens = tokenize(text)
    return [sum(table[token][j] for token in tokens) / len(tokens) for j in range(DIM)]


def dot(left: list[float], right: list[float]) -> float:
    return sum(a * b for a, b in zip(left, right))


def softmax(row: list[float]) -> list[float]:
    offset = max(row)
    exps = [math.exp(value - offset) for value in row]
    total = sum(exps)
    return [value / total for value in exps]


def score_matrix(queries: list[list[float]], passages: list[list[float]], temperature: float) -> list[list[float]]:
    return [[dot(query, passage) / temperature for passage in passages] for query in queries]


def contrastive_loss(scores: list[list[float]]) -> float:
    return -sum(math.log(max(softmax(row)[i], 1e-12)) for i, row in enumerate(scores)) / len(scores)


def train_step(
    query_table: dict[str, list[float]],
    passage_table: dict[str, list[float]],
    learning_rate: float,
    temperature: float,
) -> float:
    queries = [mean_vector(ex.query, query_table) for ex in TRAIN]
    passages = [mean_vector(ex.passage, passage_table) for ex in TRAIN]
    scores = score_matrix(queries, passages, temperature)
    batch = len(TRAIN)
    d_scores = []
    for i, row in enumerate(scores):
        probs = softmax(row)
        probs[i] -= 1.0
        d_scores.append([value / batch for value in probs])

    d_queries = [
        [sum(d_scores[i][k] * passages[k][j] for k in range(batch)) / temperature for j in range(DIM)]
        for i in range(batch)
    ]
    d_passages = [
        [sum(d_scores[i][k] * queries[i][j] for i in range(batch)) / temperature for j in range(DIM)]
        for k in range(batch)
    ]

    for i, ex in enumerate(TRAIN):
        query_tokens = tokenize(ex.query)
        passage_tokens = tokenize(ex.passage)
        for token in query_tokens:
            for j in range(DIM):
                query_table[token][j] -= learning_rate * d_queries[i][j] / len(query_tokens)
        for token in passage_tokens:
            for j in range(DIM):
                passage_table[token][j] -= learning_rate * d_passages[i][j] / len(passage_tokens)
    return contrastive_loss(scores)


def retrieval_metrics(scores: list[list[float]], qrels: dict[int, int]) -> dict[str, float]:
    reciprocal_ranks = []
    hit_at_1 = 0
    hit_at_3 = 0
    for query_id, positive_id in qrels.items():
        ranking = sorted(range(len(scores[query_id])), key=lambda i: scores[query_id][i], reverse=True)
        rank = ranking.index(positive_id) + 1
        reciprocal_ranks.append(1.0 / rank)
        hit_at_1 += int(rank <= 1)
        hit_at_3 += int(rank <= 3)
    n = len(qrels)
    return {"recall@1": hit_at_1 / n, "recall@3": hit_at_3 / n, "mrr": sum(reciprocal_ranks) / n}


def run(steps: int, check_only: bool) -> None:
    rng = random.Random(SEED)
    vocab = build_vocab([ex.query for ex in TRAIN] + CORPUS)
    query_table = init_table(vocab, rng)
    passage_table = init_table(vocab, rng)  # independent DPR-style tower
    temperature = 0.10

    initial_queries = [mean_vector(ex.query, query_table) for ex in TRAIN]
    initial_passages = [mean_vector(ex.passage, passage_table) for ex in TRAIN]
    initial_loss = contrastive_loss(score_matrix(initial_queries, initial_passages, temperature))
    for _ in range(steps):
        train_step(query_table, passage_table, learning_rate=0.35, temperature=temperature)

    query_vectors = [mean_vector(ex.query, query_table) for ex in TRAIN]
    positive_vectors = [mean_vector(ex.passage, passage_table) for ex in TRAIN]
    final_matrix = score_matrix(query_vectors, positive_vectors, temperature)
    final_loss = contrastive_loss(final_matrix)
    passage_index = [mean_vector(passage, passage_table) for passage in CORPUS]  # offline
    retrieval_scores = score_matrix(query_vectors, passage_index, temperature=1.0)  # online exact search
    metrics = retrieval_metrics(retrieval_scores, QRELS)

    print(f"seed={SEED} vocab={len(vocab)}")
    print(f"query_vectors=({len(query_vectors)}, {DIM}) passage_index=({len(passage_index)}, {DIM})")
    print(f"train_score_matrix=({len(final_matrix)}, {len(final_matrix[0])})")
    print(f"loss: {initial_loss:.4f} -> {final_loss:.4f}")
    print("metrics: " + " ".join(f"{key}={value:.3f}" for key, value in metrics.items()))
    for i, ex in enumerate(TRAIN):
        top_id = max(range(len(CORPUS)), key=lambda j: retrieval_scores[i][j])
        print(f"q{i}: top1={top_id} positive={QRELS[i]} text={CORPUS[top_id]}")

    assert len(query_vectors) == 6 and len(query_vectors[0]) == DIM
    assert len(passage_index) == 10 and len(passage_index[0]) == DIM
    assert len(final_matrix) == 6 and len(final_matrix[0]) == 6
    assert final_loss < initial_loss
    assert all(0.0 <= value <= 1.0 for value in metrics.values())
    if check_only:
        assert metrics["recall@1"] == 1.0
        print("check-only: PASS")


def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser()
    parser.add_argument("--steps", type=int, default=240)
    parser.add_argument("--check-only", action="store_true")
    return parser.parse_args()


if __name__ == "__main__":
    args = parse_args()
    run(steps=args.steps, check_only=args.check_only)