摘要
稠密檢索(dense retrieval)把查詢和文檔分別壓縮為定長向量,再用點積或餘弦相似度找最近鄰。它真正值得復現的不是“調用一個 embedding API”,而是三個可檢驗環節:雙塔如何產生向量,負樣本如何塑造空間,離線索引與在線查詢如何組成評測協議。本文以 DPR 和 Contriever 為兩條主線,閱讀官方實現,並提供一個無第三方依賴的最小實驗。腳本只驗證機制與日誌,不聲稱復現論文規模的 BERT、Wikipedia、Natural Questions 或 BEIR 結果。
復現價值與目標:把向量接口還原成訓練問題
詞面檢索會獎勵共同詞項;稠密檢索希望把“紅色星球”和“Mars”也拉近。代價是:相關性不再由可讀的詞頻公式直接決定,而由訓練對、負樣本、池化、歸一化和索引共同決定。因此,本次目標不是追逐一個排行榜數字,而是回答四個問題:
- 查詢塔和文檔塔輸出的張量形狀是什麼?
- 一個 batch 為什麼同時提供正樣本和負樣本?
- 為什麼文檔可以離線編碼,而查詢必須在線編碼?
- Recall@k 上升時,是否只是訓練集記憶、假負樣本洩漏或評測口徑改變?
核心思想:雙塔、分數矩陣與對比損失
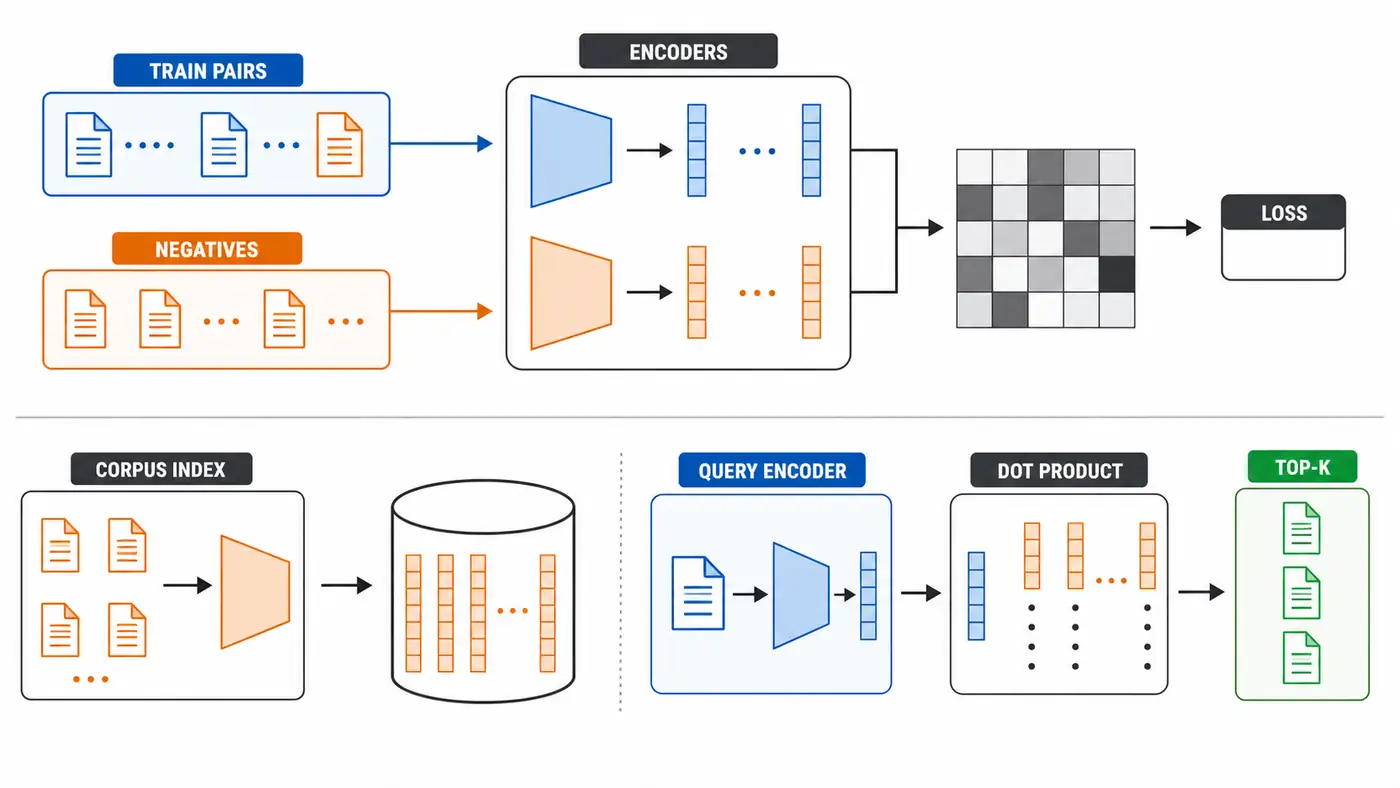
1. 兩個編碼器先分開讀,再在向量空間相遇
給定查詢 (q_i) 和文檔 (p_j),雙塔分別計算:
其中 (f_q) 是查詢編碼器,(f_p) 是文檔編碼器,(d) 是向量維度。若一個 batch 有 (B) 個查詢和 (B) 個正文檔,則兩側張量形狀都是 ([B,d])。它們之間沒有逐 token 的 cross-attention;這正是文檔向量能被預計算的原因。
相似度常取點積:
因此一次矩陣乘法得到 ([B,B]) 的分數矩陣。溫度 (τ>0) 控制 softmax 的尖銳程度;若向量先做 L2 歸一化,點積等價於餘弦相似度。是否歸一化不能靠習慣猜測,必須與訓練和索引配置一致。
2. 對角線是正樣本,其餘位置成為 batch 內負樣本
若第 (i) 個查詢的正文檔也是第 (i) 行文檔,損失為:
分母中的其餘 (B-1) 個文檔就是 in-batch negatives(批內負樣本)。batch 變大通常意味著更多對比項,但也更容易把未標註的相關文檔錯當作負樣本。硬負樣本則是“看起來很像卻不是標註答案”的文檔;它能增加訓練信號,也可能放大標註缺口。
3. DPR 與 Contriever 改變的是監督來源,不是檢索骨架
DPR(Karpukhin 等,EMNLP 2020)用問答監督訓練查詢編碼器和 passage 編碼器,論文實現以 BERT 表示和點積打分為核心,並組合隨機或 BM25 困難負樣本。論文摘要報告:在其開放域問答設置中,DPR 相比強 Lucene-BM25 的 top-20 passage retrieval accuracy 有 9–19 個百分點的絕對提升。這是論文報告,不是本文 toy 數據的結論。
Contriever(Izacard 等,TMLR 2022)關注無監督遷移:從同一文本構造兩個擾動視圖,以裁剪、刪除等增強形成偽正對,再做對比預訓練。官方模型默認對最後一層 token 表示做 mask 後平均池化;官方頁面報告其無監督模型在 BEIR 的 Recall@100 上超過 BM25 的 15 個數據集中的 11 個。它沒有證明稠密檢索在任何領域都勝過 BM25;指標、數據集和遷移條件缺一不可。
數據與負樣本合同:模型開始訓練前先凍結證據
稠密檢索最容易被忽略的輸入不是文本,而是相關性關係。每個樣本至少應保留 query_id、原始 query、positive_passage_ids、負樣本 ID 與來源;passage 表必須有穩定的文檔 ID、標題、正文和切分版本。一個查詢可能有多個正確文檔,所以不能把訓練時選中的單個正樣本誤當成唯一真值。若 qrels 允許三個相關文檔,預測命中另外兩個也應算正確;否則所謂“困難負樣本”可能只是漏標正樣本。
負樣本來源決定模型學到什麼邊界。隨機負樣本很快會變得太容易;batch 內負樣本便宜,卻依賴 batch 的主題分佈;BM25 負樣本詞面相似,適合逼迫模型區分實體與關係;由舊稠密模型挖出的近鄰更接近當前決策邊界,但會繼承舊模型偏差。實驗日誌應分別記錄四類負樣本的數量、被判為假負的比例和損失貢獻,不能只寫一個籠統的 num_negatives。
訓練、驗證和測試還要按信息來源切分。如果同一文章的相鄰 passage 同時出現在訓練與測試中,模型可能靠局部措辭而非可遷移語義命中。對 Contriever 式自監督訓練,還應保存增強前文本、兩次增強後的視圖和隨機種子;刪除詞、裁剪長度或採樣窗口的改變,本質上改變了“什麼應當保持不變”的學習假設。對 DPR 式問答監督,則要記錄答案字符串如何映射到 passage,以及沒有唯一證據時如何選正樣本。
官方代碼閱讀路線:先跟數據流,不先追配置項
閱讀 DPR 倉庫可按四步走。第一,看 dpr/models/biencoder.py 中查詢塔與上下文塔怎樣返回表示;第二,看 BiEncoderNllLoss.calc 如何形成分數矩陣、做 log_softmax,再把正樣本位置交給 NLL;第三,看 generate_dense_embeddings.py 如何分片生成文檔向量;第四,看 dense_retriever.py 如何裝載 FAISS 索引並輸出 top-k。官方倉庫已於 2023 年歸檔,所以復現時應固定 commit 和依賴,而不是假設最新 Transformers 一定兼容。
閱讀 Contriever 倉庫時,先看 src/contriever.py:forward 對 padding 位置清零,再按有效 token 數做平均池化。隨後看 src/inbatch.py 的對比學習入口、generate_passage_embeddings.py 的分片保存,以及 passage_retrieval.py 的查詢編碼、索引加載、近鄰搜索和 answer match。官方 README 還特別說明 Natural Questions 的答案預處理與 DPR 版本略有不同;若不記錄數據版本,兩個“Recall@k”可能並不可比。
最小實驗:手寫一遍比封裝調用更有解釋力
code/minimal_dense_retrieval.py 只用 Python 標準庫,固定隨機種子 57。它為查詢塔和文檔塔維護兩套獨立的 24 維詞向量表,對句子做平均池化,手工計算 6×6 點積分數、softmax 交叉熵及梯度,再把 10 篇 passage 編成離線索引。運行:
python3 code/minimal_dense_retrieval.py --check-only
本次實際驗證:查詢向量形狀為 ([6,24]),passage 索引為 ([10,24]),訓練分數矩陣為 ([6,6]);240 步後損失從 1.7899 降到 0.0044,toy 集 Recall@1、Recall@3 和 MRR 都為 1.0,斷言通過。這個結果只證明梯度、索引、qrels 和指標實現自洽。訓練查詢與測試查詢相同、語料只有十篇,因此滿分主要是記憶能力檢查,不能外推為 DPR 或 Contriever 的泛化結果。
若要升級為論文級復現,應把詞表平均替換成官方 checkpoint,嚴格複用 passage 切分、query/answer 預處理和負樣本文件;生成文檔 embedding 時記錄模型哈希、維度、歸一化與 dtype;最後才在 exact search 與 FAISS 近似索引之間比較質量—延遲差異。大模型下載、完整 Wikipedia 索引和 BEIR 評測本次均未運行,待人工核驗。
從 toy 到官方模型:分三段復現,不一次放大所有變量
第一段是協議復現:保留本文的小語料,用標準庫或小型神經網絡確認正樣本下標、分數方向、Recall/MRR 與輸出 ID 映射。此時目標是讓故意交換 qrels、翻轉分數或打亂 passage ID 時測試必然失敗。若錯誤注入後指標仍不變,評測腳本比模型更值得懷疑。
第二段是模型復現:語料與 qrels 不變,只替換為官方 DPR 或 Contriever checkpoint。先用精確矩陣乘法,不啟用近似索引;抽查同一段文本經過批處理與單條編碼所得向量是否一致,padding 是否進入平均池化,模型是否處於 eval 模式。DPR 查詢塔與文檔塔不能交換;Contriever 的池化和文本規範化必須跟 checkpoint 配置一致。這樣得到的是模型接口驗證,仍不是論文 benchmark 復現。
第三段才是系統復現:換成論文數據版本,分片生成全量 passage embedding,構建 FAISS 索引,再跑官方評測。每個分片應記錄 passage ID 範圍、向量行數、維度、校驗和與生成耗時;合併後檢查 ID 唯一性和總數。先用少量 query 對照 exact top-k,再啟用近似參數。只有數據、模型、exact search 都對齊後,ANN 的速度與召回損失才有解釋意義。
這三段每次只替換一層,因此失敗能被定位:協議段失敗是實現或 qrels 問題,模型段失敗是預處理或 checkpoint 問題,系統段失敗才主要考慮分片、索引和資源配置。直接從 toy 跳到百萬文檔,會把所有錯誤都偽裝成“模型效果不好”。
評測協議:先凍結 qrels,再談模型優劣
| 問題 | 指標 | 必須固定的口徑 |
|---|---|---|
| 前 k 個結果是否覆蓋相關文檔 | Recall@k | 每個查詢的相關文檔集合、去重規則 |
| 第一個相關文檔排得多靠前 | MRR@k | 截斷深度、無命中時記零 |
| 多級相關性排序是否合理 | nDCG@k | relevance grade 與折扣公式 |
| 索引是否值得部署 | QPS、P50/P95 延遲、內存 | 硬件、batch、精度、索引參數 |
開放域問答常用 answer string 是否出現在 passage 中來判命中,但字符串規則會受大小寫、別名、分詞和規範化影響。純檢索數據則使用 qrels(query relevance labels,查詢—文檔相關性標註)。二者不能混成同一個“accuracy”。至少同時報告 BM25、exact dense search 和近似 dense search;若只在一個域內微調再測試,不能據此宣稱零樣本泛化。BEIR 的價值正是跨任務、跨領域檢查這種遷移,但平均分仍應配合逐數據集結果閱讀。
失敗分析:從症狀回到可證偽原因
損失下降但 Recall 不升。 先查正樣本下標是否對應分數矩陣對角線,再查訓練與檢索是否使用同一 tokenizer、池化和歸一化。toy 集若訓練滿分而留出集崩潰,是過擬合證據,不是索引 bug。
語義近、事實錯的文檔排在前面。 這通常暴露負樣本不夠難。加入 BM25 或舊模型挖出的 hard negatives,同時審計它們是否其實也是相關文檔;否則模型會被迫分開兩個都正確的答案。
exact search 正常,FAISS 結果下降。 固定同一批向量逐 query 對比 top-k ID,檢查距離類型、歸一化、向量順序和文檔 ID 映射,再調 nprobe、圖搜索深度或量化配置。近似索引的誤差不能算到編碼器頭上。
換域後 BM25 反超。 先按查詢類型、文檔長度和專有名詞比例分桶。稠密模型可能學到訓練域的語義捷徑,而詞面信號對編號、實體名和術語更穩。合理基線是報告稀疏、稠密與 hybrid,而不是刪掉“不夠先進”的 BM25。
結果無法復現。 保存 query、正樣本 ID、負樣本來源、模型與數據哈希、每個 checkpoint 的 Recall 曲線,以及檢索輸出而非只存聚合分數。索引必須能追溯到生成它的模型;模型更新但索引未重建,會產生最隱蔽的版本錯配。
後續科研問題
- 在固定訓練預算下,增加 batch 內負樣本與提高 hard-negative 質量,哪一個更有效?應同時測假負率。
- Contriever 式自監督增強在醫學縮寫、代碼標識符或多語言文本上,會不會刪除真正決定相關性的 token?
- 向量歸一化、溫度和 embedding 維度如何共同改變難例的局部鄰域,而不只是平均 Recall?
- 當語料持續更新時,舊 passage embedding 的漂移如何被檢測?能否用小規模 exact-search 哨兵集觸發重建索引?
- 稠密檢索的錯誤究竟來自表示、標註還是 ANN 索引?需要把 encoder error 與 search error 分開報告。
這些問題都可以從本文腳本擴展:增加留出查詢、構造一詞之差的假負樣本、記錄每步相似度矩陣,再替換為真實 checkpoint。研究價值來自控制變量和失敗證據,而不是把模型名字換得更大。
總結
雙塔檢索的關鍵約束很簡單:查詢和文檔先獨立編碼,訓練用對比損失塑造空間,推理時文檔離線建索引、查詢在線找近鄰。DPR 說明有監督問答對與困難負樣本能訓練強檢索器;Contriever 說明無監督對比預訓練可以改善跨域起點。但任何“稠密優於稀疏”的結論都依賴數據、指標和版本。最小復現應先讓分數矩陣、qrels、索引和日誌可檢查,再逐步放大模型與語料。
參考資料
檢索日期:2026-08-29。
- Karpukhin et al., 2020, Dense Passage Retrieval for Open-Domain Question Answering(EMNLP / ACL Anthology)
- Meta AI Research, DPR 官方代碼倉庫(已歸檔)
- Izacard et al., 2022, Unsupervised Dense Information Retrieval with Contrastive Learning(TMLR / OpenReview PDF)
- Meta AI Research, Contriever 官方代碼倉庫(已歸檔)
- Thakur et al., 2021, BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models(NeurIPS Datasets and Benchmarks)
- Meta AI Research, FAISS Getting Started