日期:2026-08-28
適合讀者:研究生、科研新人、希望建立可審計 RAG 實驗的工程型研究者
檢索日期:2026-08-28
摘要
很多 RAG 演示把“上傳文檔後能回答”當作完成,但科研復現真正要回答四個不同問題:候選段落是否被檢索到,排序是否把證據推到前面,生成內容是否逐條引用,以及引用是否真的支持相鄰陳述。只看最終答案,很難知道改動影響的是哪一環。
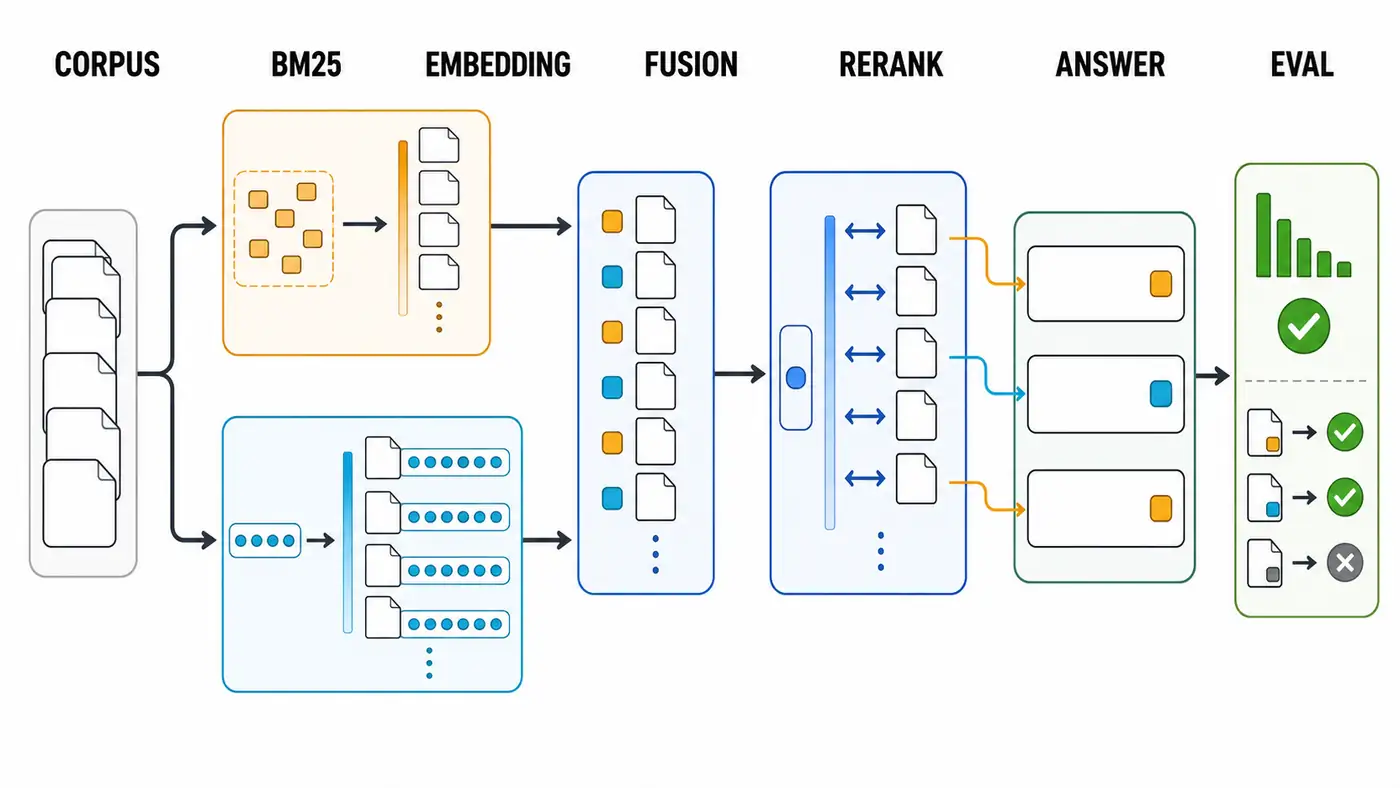
本文建立一個最小、可拆解的基線:同一語料和查詢上分別運行 BM25 稀疏檢索與 Embedding 稠密檢索,用融合結果形成候選集,再由 Reranker 二階段重排,最後用帶穩定文檔 ID 的證據生成引用,並分開報告檢索與引用指標。配套腳本固定 seed,提供純標準庫協議 smoke test,也保留 Sentence Transformers 的真實雙編碼器和 Cross-Encoder 可選入口。
證據邊界需要先說清:本文沒有復現 RAG、DPR、BEIR 或 ALCE 的論文數值,也沒有下載大規模語料或神經模型。本次實際驗證只涵蓋一手資料核對、代碼語法、六段 toy corpus 的確定性運行和引用評測單元測試;toy 後端中的特徵哈希向量與透明交互分數不是訓練好的 Embedding/Reranker,不能外推為真實檢索質量。
復現價值與目標:先把系統拆成可證偽的鏈
原始 RAG 論文把外部文檔看作非參數記憶,並將檢索器與生成器結合用於知識密集任務。本文不追求端到端訓練,而是復現更基礎的實驗賬本:凍結語料快照、切分規則、查詢集和 gold support;保存每階段的 doc ID 與分數;最後讓每個回答陳述指向可回查證據。
最小目標不是證明某一檢索器“最好”,而是定位誤差。若 gold 段落從未進入 top-100,是召回失敗;進入候選卻沒到 top-5,是排序失敗;證據正確但答案說錯,是生成或提示失敗;答案有 [d3] 卻不被 d3 支撐,則是歸因失敗。四者必須使用不同指標,不能被一個總分抹平。
數據合同與逐樣本日誌
一套可復現 RAG 實驗,首先需要數據合同,而不是模型名稱。語料表至少保存 doc_id、來源 URI、快照或文件哈希、chunk_id、標題、正文、原文字符區間和切分器版本。doc_id 必須跨運行穩定;若重新切分,應生成新版本並保留父文檔關係,不能讓同一個 ID 悄悄指向另一段文字。動態網頁還要保存抓取時間,否則幾週後即使 URL 相同,證據內容也可能已經改變。
查詢表至少保存 query_id、原始問題、gold support ID、是否可回答、數據切分和標註說明。gold support 的含義也要寫清:它是“包含答案字符串”,還是“足以獨立支撐陳述”?前者適合便宜的 answer matching,後者才接近引用評測。多跳問題若要求兩段證據,命中其中一段不能算完整召回;不可回答問題則需要把正確拒答納入協議,而不是強迫系統總找一條引用。
每個查詢應寫一行 JSONL 日誌,依次記錄 BM25 與 Embedding 的排名和原始分數、融合候選、Rerank 分數、送入生成器的實際文本、模型輸出、解析出的引用 ID、延遲與錯誤。這樣一次最終答案失敗可以回放到具體階段,也能檢查 top-k 之後是否又被去重、權限過濾或上下文截斷悄悄刪掉。只保存平均 Recall 和最終回答,會失去最有研究價值的失敗軌跡。
語料、查詢和模型都應分版本。若用 dev set 選擇 chunk 長度、融合權重或候選 k,最終 test 必須保持封存;若持續增加文檔,應把時間切分和索引時間寫入結果。否則“新方法提升”可能只是索引看到了更新後的證據,或測試查詢近重複洩漏進訓練集合。
核心模塊:四步而不是一個黑盒
1. BM25:詞面匹配的強基線
BM25 對查詢詞 t 和文檔 d 的常見單項得分可寫為:
其中 f(t,d) 是詞頻,|d| 是文檔 token 數,avgdl 是語料平均長度;k1 控制詞頻飽和,b 控制長度歸一化。實現中的張量並不複雜,本質是“查詢詞 × 候選文檔”的分數表。難點反而是分詞、大小寫、中文切詞、停用詞與字段權重:預處理一變,所謂 BM25 對照組就不再相同。Lucene 官方 BM25Similarity 的默認值為 k1=1.2, b=0.75,本文 toy 也使用這組值,但不聲稱與 Lucene 的分詞和 IDF 細節完全等價。
2. Embedding:把查詢和文檔獨立編碼
雙塔稠密檢索分別計算查詢向量 與文檔向量 ,再用內積或餘弦相似度排序:
文檔向量可離線索引,查詢只編碼一次,因此能擴展到大語料。DPR 論文使用獨立的 question encoder 與 passage encoder,並用批內負例訓練。稠密檢索能跨越部分詞面差異,卻會受模型領域、query/document 前綴、池化、截斷、歸一化和索引近似誤差影響。本文腳本的默認 256 維特徵哈希只是檢查“編碼—相似度—排序”接口;--backend neural 才調用固定模型名的 Sentence Transformer。
3. Rerank:只對小候選集做聯合閱讀
Cross-Encoder 將 [query, passage] 一起送入 Transformer,輸出一個相關性標量 。它允許 query token 與 passage token 交互,通常比獨立向量更精細,卻必須對每個候選重新前向計算。因此合理協議是先讓 BM25/Embedding 取 top-k,再重排幾十或幾百條,而不是對全庫逐條打分。
候選集合並也必須寫明。本文示例用 Reciprocal Rank Fusion:對每條排序中的名次 r 累加 。這種融合不要求 BM25 與餘弦分數同尺度,適合作為透明基線;它不是論文中唯一或默認方案。Reranker 只能重排已召回候選,漏掉的 gold 文檔無法被“救回”。
4. 引用:存在、正確與完整是三回事
引用標記存在,只能證明格式正確。至少應區分:validity 檢查 doc ID 是否存在;citation precision 檢查單個引用是否相關或支持陳述;citation recall/completeness 檢查每個可驗證陳述是否被引用集合完整支持。ALCE 論文使用 NLI 模型評估陳述與引用段落的蘊含關係,並明確區分 citation recall 與 precision。
本文 toy evaluator 不運行 NLI,而使用人工給定的 claim→support doc 集合作為 oracle。它故意放入一個錯誤引用和一個不存在的 ID,確保測試能分別得到 2/3 validity、1/3 precision、1/2 recall。真實實驗必須把 oracle 標註或 NLI 判斷誤差一起報告,不能把自動 entailment 當作事實裁判。
官方論文與代碼閱讀路線
第一站讀 RAG 論文第 2 節:作者把檢索文檔作為 latent variable,並區分整段輸出共用文檔的 RAG-Sequence 與每個 token 可依賴不同文檔的 RAG-Token。本文的工程管線不是這兩種概率模型的等價復刻,只借用了“檢索外部記憶再生成”的問題結構。
第二站讀 DPR 論文第 3 節和作者倉庫。先看 generate_dense_embeddings.py 如何生成 passage 向量,再看 dense_retriever.py 中 query vector、index 和 search_knn 如何連接,最後檢查 QA validation 的 answer matching。倉庫已被歸檔為只讀,復現時應記錄 commit,而不是假定依賴仍能無縫安裝。
第三站讀 Sentence Transformers 官方 Retrieve & Re-Rank 示例:bi-encoder 負責快速候選檢索,CrossEncoder 只重排候選。把示例換成自己數據時,最先固定模型卡、最大長度、是否歸一化、batch size、設備和候選 k。
第四站讀 ALCE 的 retrieval.py、eval.py 與配置。它不僅給最終回答打分,還保存 top-100 檢索結果,並在 citation quality 中區分支撐完整性與無關引用。大型索引成本很高,作者倉庫也明確給出磁盤和 GPU 負擔;這正說明“下載成功”不等於“協議已經復現”。
最小實驗:怎樣運行與記錄
純標準庫檢查無需安裝依賴:
python3 code/minimal_rag_baseline.py --check-only
python3 code/minimal_rag_baseline.py --backend toy --top-k 4
真實神經後端需聯網下載模型,本文未運行:
python3 -m pip install -r code/requirements.txt
python3 code/minimal_rag_baseline.py --backend neural --top-k 4
腳本打印 BM25、dense 與 reranked doc ID,隨後計算 Recall@3 和 MRR。這裡的 Recall@k 定義為:對每個查詢,top-k 中只要出現任一 gold support 就記為 1,再對查詢平均;MRR 使用第一個相關文檔名次的倒數。若一個查詢有多條必要證據,應另報 set recall 或 nDCG,不能讓“命中任意一條”掩蓋多跳缺證據。
正式最小復現建議至少比較四組:BM25;Embedding;BM25+Embedding 融合;融合+Reranker。每組使用同一 corpus snapshot、chunk、query、gold、過濾規則與 k,記錄逐查詢排名,而不只報均值。生成階段再增加 closed-book、gold-context 和 retrieved-context 三個對照,以區分模型能力上限、檢索損失與生成損失。
評測協議與報告表
檢索層優先報告 Recall@k、MRR 或 nDCG@k,並同時給候選規模、延遲和索引大小。Rerank 層既要看重排後的 top-k,也要報告 first-stage oracle recall:若 gold 不在候選集,二階段沒有改進空間。端到端層報告任務指標與逐樣本答案,但必須並列 citation validity、precision、recall,最好再由人工抽樣核對 NLI 誤判。
切分是最容易被忽視的變量。chunk 太短會丟上下文,太長會稀釋關鍵詞並增加 Cross-Encoder/生成器截斷;overlap 會製造近重複,令 Recall 看似改善卻增加冗餘引用。應凍結 chunk 代碼與語料哈希,統計長度分佈、重複率、空塊和被截斷比例。
至少運行多個 seed 的環節是模型訓練與生成採樣;確定性 BM25 不需要偽造 seed 方差。ANN 索引、GPU kernel 或 sampling 可能帶來非確定性,應記錄庫版本、硬件和參數。若只運行一次神經檢索,結果應標成探索性而非穩定結論。
失敗分析:按階段排查
第一類是詞表錯配。BM25 找不到同義表達,Embedding 又因領域外模型把縮寫或專名壓錯位置。先檢查逐查詢 top-20、token 化和 query/document 輸入模板,再決定是否混合檢索或微調;不要直接調生成 prompt 掩蓋召回失敗。
第二類是分數不可比。直接相加 BM25、cosine 和 Cross-Encoder logits 會讓某一路因尺度佔優。可先用 RRF,或只在 dev set 上擬合歸一化與權重;一旦用 test set 調權重,就發生評測洩漏。
第三類是重排退化。通用 reranker 可能不理解本領域相關性,或候選過長被截掉證據。應比較 rerank 前後逐查詢名次,並保留 hard negatives。平均分提升但關鍵長文檔下降,仍可能損害最終引用。
第四類是“引用裝飾”。模型引用了真實 doc ID,卻把段落沒有說過的結論掛上去;也可能每句話堆五個來源來提高召回。修復需要 claim-level 對齊、無關引用懲罰和人工抽查,而不是隻檢查括號格式。
第五類是答案指標掩蓋證據錯誤。Exact Match 可能因模型參數記憶而正確,即使檢索到錯誤文檔;反過來,證據正確也可能因答案表述與 gold 不同被判錯。closed-book 與 gold-context 對照能幫助識別這兩種情況。
後續科研問題
- 在固定延遲預算下,更多 first-stage candidates 與更強 Reranker 應如何分配計算?
- BM25 與 Embedding 的失敗查詢是否互補,互補性會隨領域和 chunk 長度怎樣變化?
- 用 hard negatives 微調 Reranker 後,提升來自真實證據識別,還是數據集詞面捷徑?
- citation recall 與 precision 的自動 NLI 判斷對長陳述、多來源和矛盾證據有多穩健?
- 將“拒答”作為合法輸出後,檢索置信度、證據衝突和回答正確率如何共同校準?
總結
一個可信的 RAG Baseline 不是把向量庫、LLM 和界面接起來,而是建立可回放的證據鏈:BM25 提供詞面基線,Embedding 提供語義候選,Reranker 對小集合聯合打分,生成器只能引用穩定 doc ID,評測則把召回、排序、答案和引用支撐分開。
本文完成的是協議級最小復現:公式、模塊、官方代碼路線、確定性腳本和故意失敗的引用單元測試已經對齊;大規模索引、真實神經模型與論文 benchmark 尚未運行。下一步應先在凍結小數據上跑四組消融並保存逐查詢日誌,再考慮擴大語料或更換生成模型。
參考資料
檢索日期:2026-08-28。官方文檔、倉庫和模型默認值會變化;真實復現需鎖定版本、commit、模型 revision 與語料快照。
- Patrick Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020。
- Vladimir Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering, EMNLP 2020。
- Stephen Robertson et al., Okapi at TREC-3, NIST TREC-3 Proceedings, 1994;該官方目錄收錄原始論文與作者信息。
- Apache Lucene, BM25Similarity API,參數語義與默認值。
- Nandan Thakur et al., BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models, 2021;官方倉庫。
- Sentence Transformers, Retrieve & Re-Rank 官方示例。
- Tianyu Gao et al., Enabling Large Language Models to Generate Text with Citations, EMNLP 2023;ALCE 作者倉庫。
- Meta Research, DPR 官方參考倉庫 與
dense_retriever.py。 - Sentence Transformers,
cross-encoder/ms-marco-MiniLM-L6-v2模型卡,配套腳本可選神經 Reranker 的模型來源與用法。