日期:2026-08-27
適合讀者:研究生、科研新人、希望檢查偏好對齊實驗的工程讀者
檢索日期:2026-08-27
摘要
DPO(Direct Preference Optimization,直接偏好優化)常被說成“不需要 reward model 的 RLHF”。這句話只對了一半:DPO 確實省去了單獨擬合顯式獎勵模型和用 PPO 在線採樣更新策略的階段,但它仍然依賴人類或其他標註者給出的偏好對,並通過策略相對參考模型的對數概率比定義“隱式獎勵”。
本文圍繞一個可驗收目標:用三元組 prompt/chosen/rejected 構造最小偏好數據,從公式推到每樣本 loss,再用小腳本驗證損失下降、隱式獎勵 margin 上升。這不是論文規模復現,而是一個能暴露符號、mask、模板和參考模型錯誤的最小檢查點。
目錄
- DPO 究竟省掉了什麼
- 偏好數據的最小單元
- 從 KL 約束目標到 DPO loss
- 官方代碼閱讀路線
- 最小實驗與評測協議
- 失敗分析與證據邊界
- 後續科研問題
- 總結與參考資料
DPO 究竟省掉了什麼
經典 RLHF 管線通常有三步:先做監督微調(SFT),再用回答排序訓練 reward model,最後用 PPO 等強化學習方法在獎勵和偏離參考策略之間取捨。InstructGPT 論文是這條管線的代表之一。DPO 論文的關鍵做法,是將 KL 約束獎勵最大化問題中的最優策略寫成閉式,再把 reward 重參數化為當前策略與參考策略的 log-ratio。這樣可以直接對偏好對做二元分類式訓練。
因此,“reward-free”最穩妥的解釋是:不再訓練一個獨立、可查詢的顯式 reward model,也不需要訓練期間從策略反覆採樣再由該模型打分。它不等於“沒有獎勵假設”,更不等於“沒有人類偏好成本”。偏好標籤是 DPO 的監督信號,參考模型則給出相對尺度。
偏好數據的最小單元
一條 DPO 樣本是 (x, y_w, y_l):x 是 prompt,y_w 是被偏好的 chosen completion,y_l 是 rejected completion。兩個回答必須對應同一個 prompt;否則模型可能學到 prompt 差異,而不是回答質量差異。TRL 當前官方文檔支持普通字符串格式和對話消息格式,並推薦顯式保留 prompt。
{
  "prompt": "用一句话解释梯度下降。",
  "chosen": "沿损失增长最快方向的反方向更新参数。",
  "rejected": "随机改变参数。"
}
數據驗收不能只看三個字段存在。至少要檢查:兩個回答不完全相同;對話模板後 prompt token 前綴一致;不會因截斷把 chosen 的關鍵結論刪掉、卻保留 rejected;訓練 loss 只累加 completion token,不把 prompt 重複計入偏好對比;數據切分不按單條隨機後洩漏近重複 prompt。
還要做一份“偏好對體檢表”。對每條樣本記錄兩個回答的 token 數、長度差、來源模型、採樣參數、標註規則和標註者一致性。若 chosen 幾乎總是更長,或 rejected 總來自一個更弱模型,訓練集就存在可被輕易利用的捷徑。對對話數據,應以完整會話或 prompt 族為單位劃分訓練與測試,而不是將同一問題的改寫版隨機打散。
平局和弱偏好也不該被強制寫成硬標籤。若標註者無法區分兩個回答,可刪除該對、保留軟偏好概率,或至少在分析中單獨分層。否則一個隨意決定的 chosen 會被 loss 當成確定性證據,這是標籤噪聲,不是更多監督。
從 KL 約束目標到 DPO loss
論文從一個 KL 約束的獎勵最大化目標出發。給定 prompt x,參考策略為 pi_ref,待訓練策略為 pi_theta,可將目標寫成:
r(x,y) 是回答獎勵,beta>0 是獎勵與偏離參考策略之間的尺度參數。其最優解滿足 pi_r(y|x) ∝ pi_ref(y|x) exp(r(x,y)/beta)。整理後,獎勵可表示為 beta * log(pi_r/pi_ref) 加上一個只與 x 有關的歸一化項。在 Bradley–Terry 偏好模型中比較同一 prompt 的兩個回答時,這個歸一化項相消,得到:
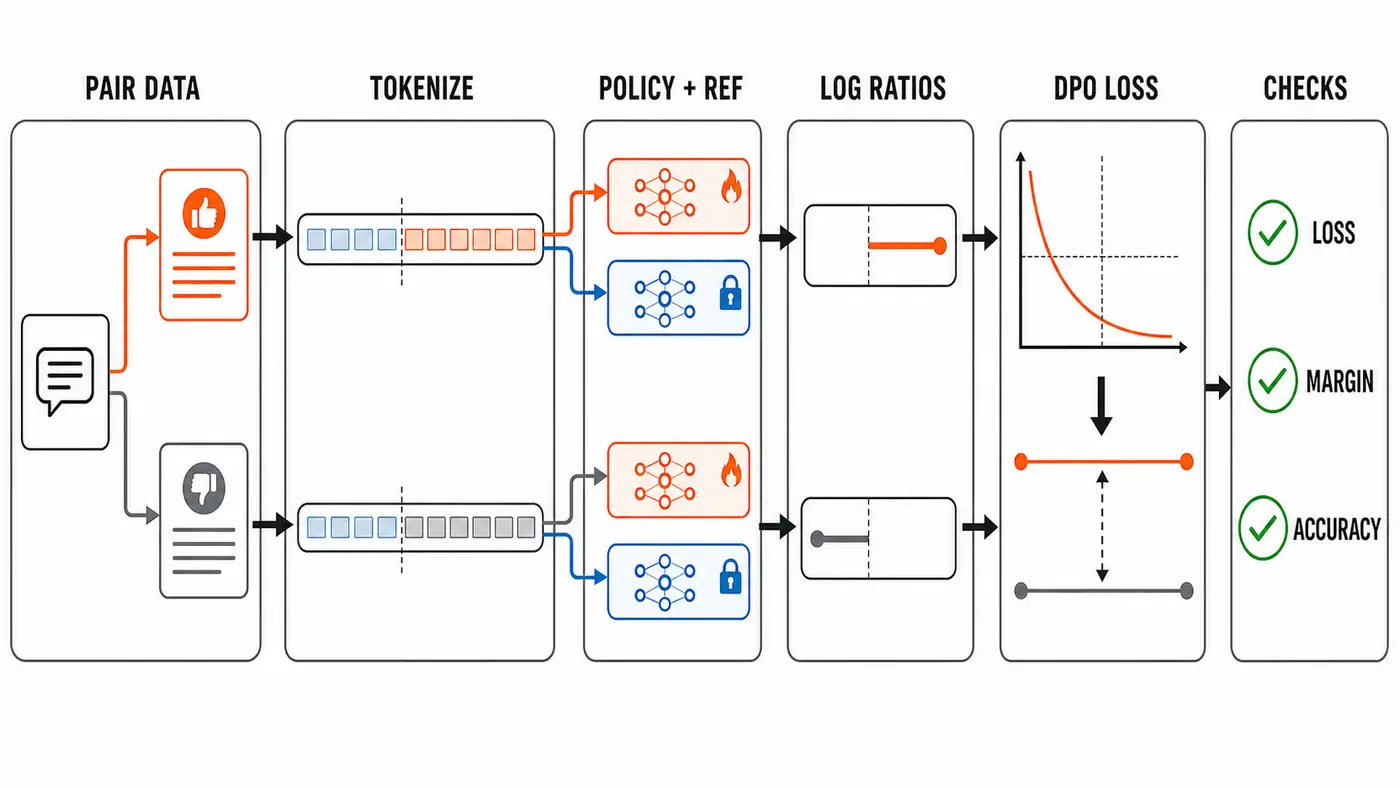
對 batch size 為 B、序列長度為 T、詞表大小為 V 的自迴歸模型,原始 logits 形狀是 [B,T,V]。用 label 取出目標 token 的 log-prob,再乘 completion mask 並沿 T 求和,得到 chosen/rejected 各一個 [B] 序列 log-prob。當前策略和參考策略各做一次,最終產生 [B] reward margin 和標量 batch loss。這個形狀鏈是檢查 mask 和符號的最快方法。
重要的是,DPO 優化的是“相對參考模型的 chosen/rejected 優勢”,不是單獨最大化 chosen 的絕對概率。因而 loss 下降並不保證 chosen log-prob 一定上升;它也可能主要通過壓低 rejected 來擴大 margin。
可以用一個數值例子檢查理解。當 policy 與 reference 完全相同時,兩個 log-ratio 都為零,每對 loss 是 -log sigmoid(0)=log 2,約為 0.6931。若後續 chosen 的相對 log-prob 增加 0.8,rejected 的相對 log-prob 減少 0.2,當 beta=0.1 時,DPO logit 為 0.1*(0.8-(-0.2))=0.1,loss 降至約 0.6444。這也說明 beta 與優化步長會耦合:不能只看 beta 的名義就猜訓練強度,應聯合觀察 margin、KL 代理量和生成質量。
官方代碼閱讀路線
作者參考倉庫給出了一條清晰路線:先用 preference_datasets.py 看偏好對如何組織,再看 trainers.py 中 policy/reference log-prob、DPO loss 和訓練循環,最後回到 train.py 核對配置傳遞。倉庫 README 將管線分為 SFT 和偏好學習兩階段,並建議偏好數據與 SFT 分佈儘量一致。
若需要現代工程實現,再讀 TRL 的 DPOTrainer。順序是:數據格式與 chat template;prompt/chosen/rejected 的分詞和 EOS;padding 與 truncation;policy 和 reference 的前向;默認 sigmoid loss;最後是 rewards/chosen、rewards/rejected、rewards/margins 和 rewards/accuracies 日誌。當前 TRL 還支持多種 DPO 變體,但最小復現應先固定默認 sigmoid loss,避免把框架開關當成原始論文結論。文檔和默認值會變,真實實驗須記錄 TRL、Transformers、tokenizer 與模型 revision,本文的當前 API 細節標記為待人工複核。
代碼層還有一筆容易被忽略的資源賬:每個 batch 需要 chosen 和 rejected 兩支,policy 與 reference 又各需要 log-prob。天真寫法可能做四次前向,成熟實現則會盡量拼接兩支減少調度開銷。參考 log-prob 若不隨訓練改變,還可預計算並隨數據保存,以空間換訓練時間;但必須一起鎖定 tokenizer、模板、截斷和 reference revision,否則緩存值會靜默過期。
當 policy 使用 LoRA 時,可以通過禁用 adapter 來得到基座 reference,避免再駐留一份完整模型。但這種優化不能只看顯存是否下降,必須用固定 batch 對比“禁用 adapter 的 policy”與單獨 reference 的 log-prob;兩者不一致時,優先排查已合併權重、dropout 狀態、精度和 adapter 切換邏輯。
最小實驗與評測協議
配套腳本位於 code/minimal_dpo.py。不安裝任何依賴也能運行標準庫檢查:
python3 code/minimal_dpo.py --check-only
腳本先驗證三元組,再用三對手工 sequence log-prob 計算 DPO loss,最後對每對的策略 margin 做解析梯度更新。本次實際 smoke test 中,loss 從 0.693147 下降到 0.415586,平均隱式 reward margin 從 0 上升到 0.663086,三對的 reward accuracy 由 0 變為 1。這些數字只證明腳本的 loss 方向和檢查量一致,不是語言模型對齊結果。
安裝 PyTorch 後可運行一個 [3,2] logits 的 toy 優化:
python3 -m pip install -r code/requirements.txt
python3 code/minimal_dpo.py --steps 80 --seed 7
真實小模型實驗應至少有四組記錄。數據層記錄標註規則、平局處理、長度分佈、近重複去重和切分;模型層記錄 SFT checkpoint、reference 構造、chat template 和是否使用 LoRA;優化層記錄 beta、學習率、有效 batch、序列長度和 seed;評測層同時報告 held-out DPO loss、reward accuracy/margin、生成長度、與 reference 的 KL 代理量和獨立人評或任務指標。
不要只報 reward accuracy。它只問隱式 reward 是否把 chosen 排在 rejected 之上,不能證明模型對新 prompt 的生成更真實、更有用或更安全。最好預先凍結評測 prompt、解碼參數和 rubric,對 SFT/reference 與 DPO checkpoint 做盲測對比,並保留逐樣本輸出。
一個可操作的三層驗收順序是:先做數學單元測試,用四個已知 log-prob 確認符號和 logsigmoid;再做過擬合測試,確認幾十個偏好對能被小模型記住,並抽樣查看 chosen/rejected 的概率變化;最後才做泛化評測,在未見 prompt 上比較生成和任務指標。第一層失敗是實現錯,第二層失敗多半是優化或數據管線錯,只有前兩層通過後,第三層失敗才值得討論方法與數據假設。
為了評估方差,至少對小實驗運行多個 seed,報告均值、標準差和逐 seed 日誌。若資源只夠跑一次,應將結果明確標成探索性運行,並優先保留逐樣本輸出、長度、margin 和失敗類型,而不是隻保留一個總分。
最終產物應讓第三方能回放:保留原始偏好對的不可變版本或校驗和、預處理腳本、模板、完整啟動命令、環境鎖定文件、每次評測的逐樣本 JSONL 和失敗樣例標註。只有 checkpoint 而沒有數據與協議,無法證明兩次 DPO 實驗真的在比較同一個問題。
失敗分析與證據邊界
第一類是數據假對齊。chosen 和 rejected 使用了不同 system prompt、不同對話歷史或不同截斷規則,模型會讀取這些捷徑。修復方法是在分詞後直接比較兩支 prompt token 前綴,並統計被截斷比例。
第二類是 loss 符號或 mask 錯。將 chosen/rejected 對調、把參考 log-ratio 減反,或把 padding/prompt token 算進 sequence log-prob,都可能讓 loss 看似正常下降。一個必做單元測試是:手工提高 chosen 相對 policy log-prob 後,loss 必須下降,reward margin 必須上升。
第三類是 reference 錯位。參考模型應凍結,其 tokenizer、模板和 completion mask 應與 policy 可比。若誤把參考模型也更新,log-ratio 標尺會漂移;若 LoRA 訓練中沒有正確切換 adapter,policy 和 reference 甚至可能實際指向同一狀態。
第四類是偏好過優化。偏好數據可能把“更長、更有格式、更自信”誤當質量,訓練可以成功擴大 margin,卻放大這些標註偏差。應分長度區間報告準確率,檢查選中答案的長度優勢,並對可驗證任務加入真實性或執行結果指標。
證據上需嚴格分層。DPO 論文報告了在情感控制、摘要和單輪對話任務上與 PPO 管線的對比;本文沒有重跑這些設置。本次實際驗證只包括一手資料打開核對、Python 語法檢查和標準庫 toy loss smoke test。PyTorch toy 與真實語言模型微調未運行,不應被寫成論文復現結果。
後續科研問題
- 在相同 SFT checkpoint 上,beta 和學習率是否可分辨,還是隻通過有效梯度尺度耦合?
- 將偏好對按長度差、難度和標註者一致性分層後,哪一類對最能改善獨立人評?
- 與完全凍結參考模型相比,週期性更新 reference 會如何改變穩定性和過擬合?
- 當 chosen 和 rejected 都很差時,成對相對偏好是否需要質量下限或 SFT loss 作為護欄?
- 在代碼、數學等可執行任務上,把測試結果與人類偏好分開記錄,能否識別“更討喜但更不正確”的訓練方向?
總結
DPO 的最小實質是:對同一 prompt 的 chosen/rejected 回答,比較當前策略相對參考策略的兩個 log-ratio,再用 -log sigmoid 擴大偏好 margin。它繞過了顯式 reward model 和 PPO 訓練環,卻沒有繞過偏好數據、參考策略、長度偏差和評測設計。
對科研復現而言,最有價值的第一步不是立即微調數十億參數模型,而是用手工 log-prob 確認符號和 mask,再用小模型固定數據、reference、beta 和解碼協議。只有當“loss 按預期變化”和“獨立評測真正改善”同時成立,才能把訓練成功解釋為偏好對齊成功。
若只有前者而沒有後者,應停止擴大訓練,回到數據偏差、參考模型和評測協議重新排查,而不是繼續追求更小的訓練 loss。
參考資料
檢索日期:2026-08-27。以下優先選用論文頁、會議頁、作者倉庫和官方框架文檔。TRL 代碼與默認配置會變,實際運行前需再核對鎖定版本。
- Rafael Rafailov, Archit Sharma, Eric Mitchell, Stefano Ermon, Christopher D. Manning, Chelsea Finn, Direct Preference Optimization: Your Language Model is Secretly a Reward Model, arXiv 2023,v3 2024。
- NeurIPS 2023, DPO conference page。
- Eric Mitchell et al., DPO official reference implementation,包含數據處理、trainer 與 SFT/DPO 配置。
- Hugging Face TRL, DPOTrainer documentation,數據格式、loss、日誌指標與 PEFT 集成。
- Hugging Face TRL,
dpo_trainer.py,當前訓練器源碼。 - Long Ouyang et al., Training language models to follow instructions with human feedback, arXiv 2022 / NeurIPS 2022。
- Yuntao Bai et al., Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback, arXiv 2022。