日期:2026-08-26
適合讀者:研究生、科研新人、希望把參數高效微調做清楚的工程讀者
檢索日期:2026-08-26
摘要
LoRA 和 QLoRA 常被概括成“省顯存微調大模型”,但復現實驗裡真正容易出錯的並不是口號,而是三筆賬:哪些權重被凍結,低秩增量的形狀是不是對的,4-bit 量化到底省的是基座權重、梯度還是優化器狀態。本文的目標不是在本機復現 Guanaco 或 GPT-3 規模實驗,而是把 LoRA 的公式、官方代碼、最小 PyTorch 層、QLoRA 顯存預算和失敗排查串成一條可檢查路線。
本次實際驗證受限於當前工作區沒有安裝 PyTorch:配套腳本完成了 Python 語法檢查,並運行了不依賴 PyTorch 的參數/顯存預算檢查;toy LoRA 訓練代碼需要安裝依賴後再人工運行。文中涉及論文大模型指標時只引用論文報告或官方倉庫說明,不把本地 toy 檢查外推為原論文復現。
目錄
- 為什麼先復現 LoRA 而不是直接跑 PEFT
- LoRA 的公式和張量形狀
- 官方代碼閱讀路線
- QLoRA 多省顯存,省在哪裡
- 最小實驗與驗收協議
- 如何報告復現實驗邊界
- 失敗排查清單
- 可以繼續研究的問題
- 總結與參考資料
為什麼先復現 LoRA 而不是直接跑 PEFT
參數高效微調(Parameter-Efficient Fine-Tuning, PEFT)指的是不更新模型全部參數,而只訓練少量新增參數或少量原參數。它適合科研新人入門,因為實驗規模可以小很多;也容易誤導人,因為庫調用太簡單,隱藏了關鍵約束。若只寫 get_peft_model(model, config),很難看出 LoRA 增量究竟加在什麼矩陣上,也難以判斷訓練參數比例是否符合預期。
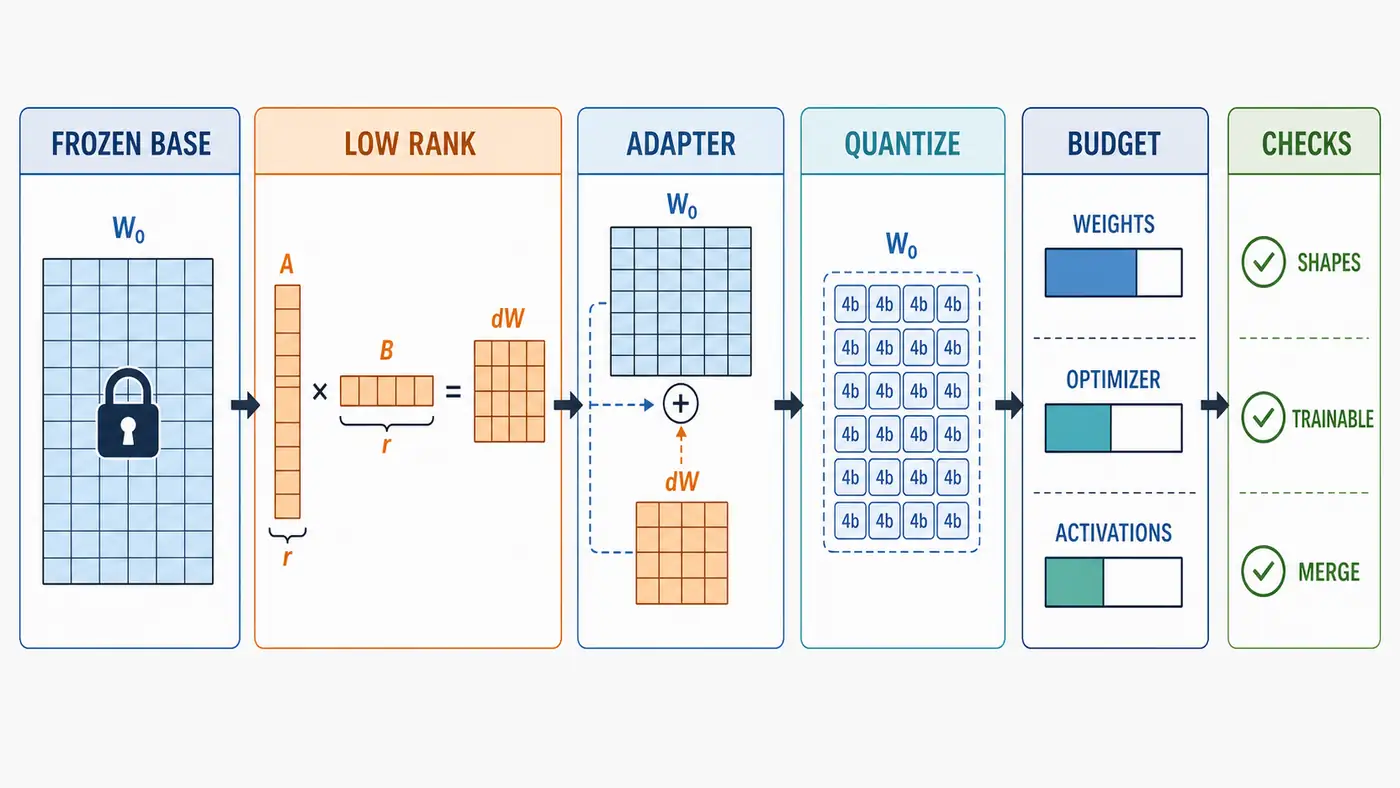
LoRA 論文的核心假設是:下游任務所需的權重更新 Delta W 可能具有低內在秩,因此不必完整學習一個與原矩陣同形狀的更新。對一個線性層,原始權重 W0 凍結,只訓練兩個小矩陣 A 和 B,前向時使用 W0 + Delta W,其中 Delta W = B A。這樣復現時的第一條驗收標準就很明確:基座權重必須 requires_grad=False,只有 LoRA 參數和必要的任務頭參與優化。
這和“只凍結一部分層”不同。LoRA 仍然讓輸入經過原模型的同一計算路徑,只是在目標線性層旁邊並聯一個低秩增量。推理時,若不需要動態切換 adapter,可以把 B A 合併回原權重,避免額外矩陣乘法。這也是 LoRA 相比傳統 adapter 的一個重要工程賣點。
LoRA 的公式和張量形狀
設某個線性層輸入 x 形狀為 [B, T, d_in],原始權重 W0 形狀為 [d_out, d_in]。全量微調會直接更新 W0 中的 d_out * d_in 個參數;LoRA 凍結 W0,學習:
於是前向計算可以寫成:
這裡 r 是 rank,alpha/r 是縮放因子。若 d_in=d_out=4096 且 r=8,全量更新需要約 1677 萬參數,而 LoRA 增量只有 8*(4096+4096)=65536 個參數。這個數量級差異解釋了為什麼訓練優化器狀態會明顯變小;但它不表示激活顯存、KV cache 或數據加載開銷自動消失。
初始化也有復現意義。PEFT 文檔說明默認初始化會讓 LoRA 起步時近似 no-op:A 隨機初始化,B 初始化為零。這樣第 0 步模型輸出與凍結基座一致,訓練不會在一開始破壞預訓練行為。若為了調試把兩者都隨機化,應明確標註這不再是常用初始化。
官方代碼閱讀路線
Microsoft 的 loralib 是閱讀 LoRA 實現的最短路徑。建議先看 loralib/layers.py 中的 Linear:它創建 lora_A、lora_B,設置 self.scaling = lora_alpha / r,並把預訓練 weight.requires_grad 設為 False。前向函數先計算普通 F.linear(x, weight),再加上 x @ A^T @ B^T * scaling。訓練/評估模式切換中還包含 merge/unmerge 邏輯,用來把低秩更新加回原權重或撤銷。
Hugging Face PEFT 則展示了科研復現實驗會遇到的配置層。LoraConfig 裡最容易影響結果的是 r、lora_alpha、target_modules、lora_dropout 和 bias。如果目標模塊名寫錯,訓練參數可能為零;如果只給 q_proj、v_proj 加 LoRA,和 QLoRA 風格的 target_modules="all-linear" 就不是同一實驗。正式報告應打印 trainable parameter ratio,並保存 adapter 配置。
QLoRA 官方倉庫的閱讀重點不是把整套訓練腳本複製到本機,而是看它如何加載量化模型、調用 prepare_model_for_kbit_training,再添加 LoRA 模塊。這樣能明確一件事:QLoRA 不是“訓練 4-bit 權重”,而是把凍結基座以 4-bit 存儲/計算,並把梯度反傳到 LoRA adapter。
QLoRA 多省顯存,省在哪裡
QLoRA 的關鍵增量有三項:NormalFloat 4-bit(NF4)、double quantization 和 paged optimizers。NF4 是面向近似正態分佈權重的 4-bit 數據類型;double quantization 繼續量化量化常數,減少平均存儲開銷;paged optimizers 用來緩解長序列或大 batch 下的瞬時顯存峰值。論文報告稱 QLoRA 可在單張 48GB GPU 上微調 65B 模型,但這個結論依賴具體模型、序列長度、batch、checkpointing、優化器和硬件,不能從 toy 腳本直接推出。
顯存預算要拆開看。全量 fp16 微調通常要存基座權重、梯度、優化器狀態和激活;LoRA 凍結基座後,梯度和 Adam 狀態主要只為 adapter 保留;QLoRA 進一步把凍結基座權重壓到 4-bit。配套腳本位於 code/minimal_lora_qlora_budget.py,默認用一個 7B 參數模型和 2000 萬 LoRA 參數做粗略賬本:
python3 code/minimal_lora_qlora_budget.py --check-only
本次實際運行的標準庫檢查輸出了單層 base_weight、lora_A、lora_B、delta_W 形狀,並給出 full fp16、LoRA fp16 base、QLoRA 4-bit base 三種粗略 tracked memory。注意它沒有統計激活、臨時 kernel、allocator 碎片、CUDA 上下文、checkpoint 保存和 tokenizer batch,因此只能作為復現實驗前的預算草稿。
最小實驗與驗收協議
安裝 PyTorch 後,可以運行一個 CPU toy 訓練:
python3 -m pip install -r code/requirements.txt
python3 code/minimal_lora_qlora_budget.py --steps 40 --seed 7
toy 模型只有一個凍結線性層和一個 LoRA 增量,用合成二分類任務檢查 LoRA 參數是否能被優化。驗收不應只看 loss 是否下降,還要檢查四個不變量:凍結權重梯度為空,LoRA 參數數等於 r*(d_in+d_out),第 0 步 no-op 初始化不會改變基座輸出,訓練日誌記錄 seed、rank、alpha、學習率和 batch size。
若擴展到真實模型,建議把評測協議分成三層。第一層是配置可複查:模型名、revision、tokenizer、數據集版本、target modules、rank、alpha、dropout、量化配置全部寫入日誌。第二層是資源可複查:峰值顯存、每步時間、有效 batch、序列長度、gradient checkpointing 是否開啟。第三層才是任務指標:驗證集 loss、準確率、MT-Bench 或 Vicuna 這類對話評測。動態榜單和閉源評測器版本必須標註“待人工核驗”。
如何報告復現實驗邊界
LoRA/QLoRA 的復現報告尤其需要把“配置成功”和“方法有效”分開。配置成功只說明 adapter 已經插入、參數量符合預期、訓練循環能跑通;方法有效還需要在固定數據切分、固定評測腳本和合理 baseline 下比較指標。很多失敗記錄之所以後來無法複查,是因為只保存了最終 checkpoint,卻沒有保存 adapter 配置、量化配置和訓練日誌。
建議每次實驗至少保存五類材料。第一是 config.json 或命令行參數,裡面應包含 rank、alpha、dropout、target modules、是否訓練 bias、是否合併 adapter。第二是環境信息,包括 PyTorch、Transformers、PEFT、bitsandbytes、CUDA、GPU 型號和驅動版本。第三是資源日誌,至少記錄峰值顯存、每步耗時、序列長度、batch size 和 gradient accumulation。第四是數據記錄,包括數據集版本、過濾規則、模板、最大長度和隨機種子。第五是評測輸出,最好保留逐樣本預測或打分明細,而不只是一行平均分。
對論文指標的引用也要謹慎。LoRA 論文報告了在 RoBERTa、DeBERTa、GPT-2、GPT-3 等模型上的參數效率和質量對照;QLoRA 論文報告了 4-bit 微調大模型的顯存可行性和對話模型結果。本文沒有復現這些規模實驗,因此只能說“論文報告”或“官方倉庫說明”,不能寫成本機結論。本文真正驗證的是:腳本中的 LoRA 參數形狀、參數比例公式和粗略顯存賬本可以在無 PyTorch 環境下運行;PyTorch toy 訓練與真實 QLoRA 訓練仍待安裝依賴和硬件後驗證。
還有一個常被忽略的邊界是隨機性。LoRA 參數很少,不代表實驗方差一定小。小數據集、短訓練步數、不同 prompt 模板、不同 tokenizer 截斷策略,都可能讓最終指標明顯波動。可靠報告應至少跑多個 seed,或把單 seed 結果明確標成探索性結果。若預算不足以多 seed,也應優先保留 loss 曲線、驗證集逐項輸出和失敗樣本,而不是隻保留最好一次的截圖。
失敗排查清單
第一,訓練參數為零。通常是 target_modules 沒匹配到真實層名,或 adapter 注入後沒有打印 trainable 參數。不同架構的投影層命名不同,不能把 LLaMA 的 q_proj 原樣套到所有模型。
第二,顯存沒有明顯下降。常見原因是仍在全量更新 embedding、LM head 或 bias;序列太長導致激活成為主要開銷;或者沒有啟用 gradient checkpointing。LoRA 主要減少可訓練權重、梯度和優化器狀態,不會免費消除前向激活。
第三,QLoRA 量化配置不一致。Hugging Face 文檔中典型配置包括 load_in_4bit=True、bnb_4bit_quant_type="nf4"、bnb_4bit_use_double_quant=True 和合適的 compute dtype。若庫版本、硬件後端或 dtype 不同,顯存和速度都可能變化。
第四,把 adapter merge 後繼續訓練。merge 適合推理或導出;若訓練階段反覆 merge/unmerge,要確認沒有把低秩更新重複加到權重上。官方實現中維護 merged 狀態,就是為了避免這類錯誤。
第五,報告方式混淆。論文報告的 65B 單卡結論、官方倉庫的 Guanaco 結果、本機 toy script 的參數檢查屬於三種證據。科研博客必須分開寫:論文聲稱什麼,本次實際驗證什麼,作者據此推斷什麼。
第六,忽略 merge 校驗。adapter 合併前後應在同一輸入上比較 logits 差異;若誤差異常,優先檢查 dtype、縮放因子、是否重複合併以及權重轉置方向。這個檢查很便宜,卻能提前發現導出階段的嚴重問題。
復現日誌越細,後續排錯成本越低。
可以繼續研究的問題
- 在相同訓練預算下,LoRA rank 從 4、8、16 到 64 時,驗證集收益和顯存增量是否線性?
q_proj/v_proj、attention 全投影、MLP 全線性層和all-linear的差異,是否來自容量還是目標模塊位置?- NF4、FP4、INT8 在同一模型、同一數據上的困惑度退化和訓練穩定性如何比較?
- LoRA adapter merge 前後,logit 最大誤差在不同 dtype 下是否可接受?
- 小數據指令微調中,LoRA 的過擬合表現是否比全量微調更輕,還是隻是訓練參數少導致收斂慢?
這些問題都比“能不能省顯存”更適合作為研究入口,因為它們把方法、預算、指標和失敗模式放在同一個可復現框架內。
總結
LoRA 的最小復現可以濃縮成一句話:凍結 W0,訓練 A 和 B,用 B A 近似下游任務所需的權重更新。QLoRA 則在這個基礎上把凍結基座量化到 4-bit,並繼續只訓練 LoRA adapter。理解這兩點後,顯存預算就不再是玄學:基座權重、可訓練參數、優化器狀態、激活峰值必須分別估算。
本文完成了源碼閱讀、公式對齊、預算腳本和正式配圖。本機尚未安裝 PyTorch,因此 toy 訓練與真實模型 QLoRA 仍標註為待人工核驗。下一步最值得做的是在固定模型 revision 和數據集切分後,比較 full fine-tuning、LoRA 和 QLoRA 的顯存、速度與驗證指標,而不是隻報告一個漂亮的 adapter 參數比例。
參考資料
檢索日期:2026-08-26。以下鏈接優先採用論文頁、官方倉庫和官方文檔;PEFT、Transformers 與 bitsandbytes 文檔會隨版本變化,正式復現實驗應記錄本地包版本、GPU 型號和模型 revision。
- Edward J. Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, arXiv 2021 / ICLR 2022。
- Microsoft, LoRA official repository,
loralibPyTorch 實現。 - Microsoft,
loralib/layers.py,LoRA Linear、merge/unmerge 與凍結權重邏輯。 - Tim Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, arXiv 2023 / NeurIPS 2023。
- Artidoro Pagnoni et al., QLoRA official repository,訓練腳本、配置和 Guanaco 說明。
- Hugging Face PEFT, LoRA documentation,
LoraConfig、初始化和 target modules。 - Hugging Face PEFT, Quantization guide,LoRA 與 4-bit/8-bit 量化結合流程。
- Hugging Face Transformers, bitsandbytes quantization documentation,
BitsAndBytesConfig、NF4 與 nested quantization。 - Hugging Face bitsandbytes, Linear4bit / LinearNF4 reference,4-bit 線性層和 NF4 API 說明。