日期:2026-08-25
適合讀者:研究生、科研新人、希望把 Transformer 內部診斷做紮實的工程讀者
檢索日期:2026-08-25
摘要
Attention 熱力圖很容易讓人產生一種錯覺:顏色越亮,那個 token 就“解釋”了模型為什麼這樣預測。這個說法只對了一半。熱力圖確實展示了某一層、某個 head 在 softmax 後給不同 Key 位置分配的權重;但它通常不能單獨證明輸入特徵對最終輸出的因果貢獻。本文的復現目標不是下載一個大模型展示漂亮截圖,而是把注意力矩陣的來源、形狀、可視化協議和解釋邊界拆清楚:先用最小腳本生成可檢查的 toy attention,再對照 BERTViz、Hugging Face 輸出格式和解釋性論文,建立一套“能看、會疑、可複查”的實驗記錄。
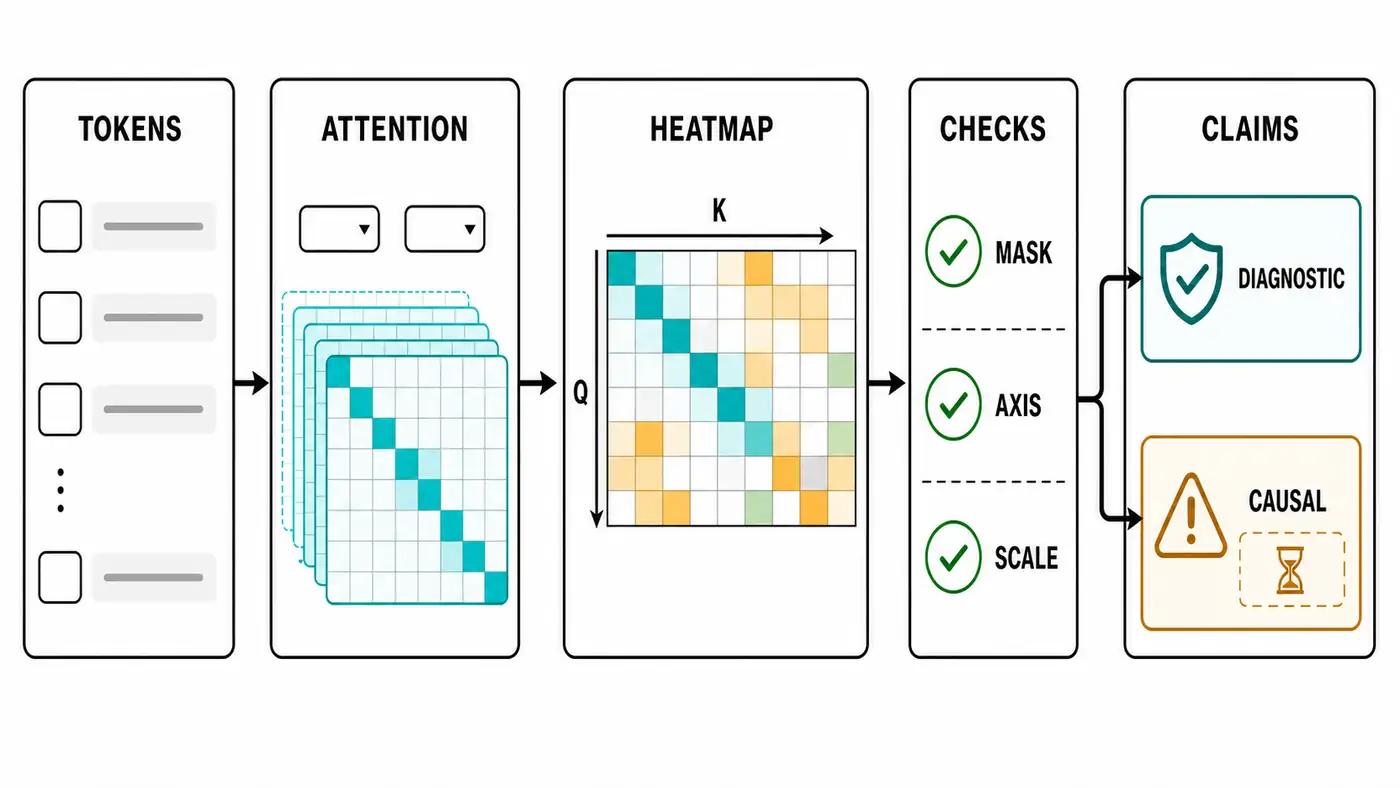
本次實際驗證受限於本地環境:torch、numpy、matplotlib 均未安裝,因此沒有運行真實 BERT 或導出 toy PNG 熱力圖;配套腳本的標準庫形狀與 mask 檢查已通過,圖像導出路徑需安裝依賴後人工核驗。文章所需的正式封面和方法圖已用內置 imagegen 補齊,並完成視覺檢查。
目錄
- 為什麼 Attention 圖值得復現
- 熱力圖到底畫的是什麼
- 最小代碼:從 score 到矩陣
- 官方工具怎麼讀:BERTViz 與 Transformers
- 解釋邊界:診斷不等於因果
- 評測協議與失敗排查
- 可以繼續研究的問題
- 總結與參考資料
為什麼 Attention 圖值得復現
注意力機制最初的吸引力之一,是它把序列中“誰看誰”的關係變成了一個概率分佈。《Attention Is All You Need》中的 scaled dot-product attention 會對 Query 與所有 Key 的相似度做歸一化,再用這些權重加權 Value。於是研究者自然想把權重畫成矩陣:行是 Query token,列是 Key token,顏色越深表示該 Query 越多地使用該 Key 的 Value。
這張圖的復現價值在於調試,而不是美化論文。對工程讀者來說,它能快速暴露三類問題:mask 是否寫反,padding 位置是否仍被關注,某些 head 是否退化為只看自己或只看特殊符號。對研究生來說,它是一種提出假設的入口:如果某個 head 總是關注分隔符,它可能承擔句邊界聚合;如果某個 head 常看相鄰位置,它可能近似局部卷積。但這些都只是可檢驗假設,不是最終解釋。
本文把目標限定為“可視化協議復現”。我們不聲稱復現 BERT 論文中的語法 head 數字,也不把 toy 結果外推到真實語言模型。可信的復現記錄應先回答:矩陣從哪裡取、形狀是什麼、softmax 維度是否正確、圖中顏色是否保留了數值含義、結論是否經過替代歸因方法或干預實驗對照。
熱力圖到底畫的是什麼
Transformer 自注意力的核心公式是:
其中 Q、K、V 分別是 Query、Key、Value;若 batch 大小為 B,序列長度為 T,head 數為 H,每個 head 維度為 D,則 QK^T 的形狀是 [B,H,T,T]。最後兩個維度最重要:第一個 T 是正在提問的 Query 位置,第二個 T 是可被查看的 Key 位置。M 是 mask,通常在 softmax 前把不可見或 padding 的 Key 加上極小值。
熱力圖畫的是 A 中某一層、某個 head、某個樣本的 [T,T] 切片。它不是 embedding 相似度圖,也不是梯度圖,更不是 token 重要性排行榜。因為最終輸出 O 還會經過 Value 向量、輸出投影、殘差連接、LayerNorm、前饋網絡以及後續層。一個 Key 獲得高權重,只說明它的 Value 被當前 Query 位置較多混入;它是否推動了最終分類 logit,還要看後續計算。
Hugging Face Transformers 的模型輸出文檔也把 attentions 描述為每層一個張量,形狀為 [batch_size, num_heads, sequence_length, sequence_length],並說明它是 attention softmax 後用於加權平均的權重。這一定義適合作為工程復現實驗的接口契約:若你的可視化工具期望同樣佈局,就能和大多數 Hugging Face 模型對接。
最小代碼:從 score 到矩陣
配套腳本位於 code/attention_visualization_toy.py。它不下載模型,也不依賴 PyTorch 計算圖,只用標準庫構造一組 token、手寫 Q/K 向量、計算 scaled dot-product score,並對 [PAD] 列施加 mask。默認檢查命令是:
python3 code/attention_visualization_toy.py --check-only
腳本會打印 token 列表、矩陣形狀、每行 softmax 是否求和為 1、被屏蔽的 [PAD] 列最大概率是否為 0。這個檢查比一張圖更基礎:如果行和不是 1,說明 softmax 維度或數值穩定性有問題;如果 padding 列不是 0,說明 mask 語義可能寫反;如果形狀不是 [T,T],說明 Query/Key 維度已經混亂。
安裝 matplotlib 後可以導出一個教學熱力圖:
python3 -m pip install -r code/requirements.txt
python3 code/attention_visualization_toy.py --out-dir code/outputs --save-png
這張圖只能說明繪圖管線可用,不能說明任何真實模型行為。真實復現時,應把 toy 矩陣替換為模型返回的 outputs.attentions[layer][batch, head],同時保存模型名、revision、tokenizer 版本、輸入文本、特殊 token、是否啟用 dropout、設備和隨機種子。
官方工具怎麼讀:BERTViz 與 Transformers
BERTViz 是 Jesse Vig 發佈的開源 Transformer attention 可視化工具,對應 ACL 2019 系統演示論文。它提供 head view、model view 和 neuron view:head view 適合看單層單頭的 token 對齊,model view 適合概覽多層多頭,neuron view 則進一步追蹤 Query 與 Key 向量中特定維度如何貢獻 attention score。閱讀它的官方倉庫時,應先看 README 的數據流:加載 Hugging Face 模型,設置 output_attentions=True,tokenize 輸入,運行模型,取出 attention,再把 tokens 與 attention 傳給 model_view 或 head_view。
這條路線提醒我們,可視化工具不是“解釋器”,而是一個交互式張量瀏覽器。BERTViz 倉庫也明確提示,attention 權重不一定是預測解釋;長輸入或大模型還會帶來響應速度和可視化規模問題。工程復現時不要一次顯示所有層和所有頭,而應先選擇少量輸入、固定層頭、保存截圖和原始矩陣,再逐步擴大範圍。
Hugging Face 文檔提供了另一個關鍵約束:模型輸出中的 attentions 是 tuple,每層一個張量。不同模型可能有 encoder attention、decoder attention 和 cross attention;句子對任務還會涉及 token type 和特殊符號。如果沒有把 token 列表與矩陣軸嚴格對齊,熱力圖的行列標籤就會錯位,後續解釋全部失效。
解釋邊界:診斷不等於因果
Jain 與 Wallace 在 NAACL 2019 的《Attention is not Explanation》中直接挑戰了“attention 等於解釋”的常見說法。他們報告,學習到的 attention 權重經常與梯度類特徵重要性不相關,而且可以找到很不一樣的 attention 分佈,卻產生近似相同的預測。這並不意味著 attention 圖毫無價值,而是說明標準 attention 權重不能自動升級為因果解釋。
Clark 等人在 BlackboxNLP 2019 對 BERT attention 做了更細的觀察:一些 head 會關注分隔符、固定位置偏移或廣泛分佈,也有 head 與句法、共指等語言現象對應得較好。這裡的關鍵是“對應”與“導致”不同。一個 head 看起來像句法關係,說明模型內部存在可診斷模式;若要證明它對預測必要,還需要遮蔽、置換、head ablation、counterfactual input 或梯度歸因等實驗。
Captum 這類解釋工具提供了另一種視角:它關心某個輸出標量相對於輸入特徵的歸因,例如 Integrated Gradients 會沿基線到輸入的路徑積分梯度。注意力熱力圖和梯度歸因回答的問題不同:前者問“這個模塊如何混合 Value”,後者問“輸入變化如何影響某個輸出”。可信分析最好把兩者並列,而不是用其中一個替代另一個。
評測協議與失敗排查
Attention 可視化復現至少應記錄六項協議。
| 檢查項 | 記錄內容 | 常見失敗 |
|---|---|---|
| 輸入 | 原文、token、特殊符號 | WordPiece 後標籤錯位 |
| 張量 | layer、head、shape | [B,H,T,T] 軸順序讀錯 |
| mask | padding 或 causal 規則 | True/1 語義寫反 |
| 數值 | 行和、最大值、熵 | softmax 維度錯誤 |
| 圖像 | colormap、歸一化範圍 | 每張圖獨立縮放導致誤讀 |
| 結論 | 診斷、推斷、實測區分 | 把亮色格子當因果證據 |
最常見的失敗是軸讀反。許多圖默認把 x 軸畫在下方、y 軸畫在左側,但論文或工具可能把 Query 和 Key 的方向說法不同。寫文章時必須明確“行是 Query,列是 Key”,並用一個手工構造的矩陣驗證方向。
第二類失敗是顏色歸一化。若每個 head 單獨按最大值歸一化,弱信號也可能顯得很亮;若所有層統一色標,局部結構又可能不明顯。科研報告中最好保存原始數值,並說明色標策略。
第三類失敗是選擇性展示。只挑一張符合敘事的 head 圖,很容易製造故事。更穩妥的做法是先定義選擇規則,例如固定第 6 層第 3 頭,或按熵、對角線權重、特殊 token 權重排序,再報告多個樣本。
第四類失敗是把模型處於訓練態。dropout 會讓 attention 權重不穩定;正式可視化前應切到 eval 模式,並記錄版本和 seed。本次腳本沒有運行真實模型,因此這些真實模型結論均標註為待人工核驗。
復現實驗記錄還應避免“截圖即數據”。建議每次可視化同時保存三份材料:一份 JSON 或 CSV 原始矩陣,一份帶 token 標籤的 PNG,一份簡短日誌說明輸入、模型、層、頭、色標範圍和選擇理由。PNG 適合閱讀,矩陣適合複查,日誌適合讓他人在一個月後知道你當時到底畫了什麼。若只保存 notebook 輸出,後來模型權重、tokenizer 或依賴版本變化時,很難判斷差異來自模型行為還是環境漂移。
對於論文報告,最好把結論分成三檔。第一檔是直接觀測,例如“該 head 在這個樣本上對 [SEP] 分配了最高權重”。第二檔是統計描述,例如“在 200 個樣本中,該 head 的分隔符平均注意力更高”。第三檔才是解釋性推斷,例如“該 head 可能承擔句邊界聚合功能”。只有第三檔需要格外謹慎,最好配合 ablation 或替代歸因方法;否則讀者會把一個可視化現象誤讀成機制證明。
可以繼續研究的問題
- 對同一輸入,attention 權重、Integrated Gradients、occlusion 和 head ablation 的排序一致性有多高?
- 哪些 head 的模式跨樣本穩定,哪些只是在個例圖中看起來有解釋性?
- 如果遮蔽最高權重連接,輸出變化是否顯著大於遮蔽低權重連接?
- 長上下文模型中,attention 可視化是否能幫助診斷 lost-in-the-middle,還是會被稀疏和高效 attention 後端限制?
- 多模態模型的 cross attention 圖能否對應圖像區域證據,還是同樣需要干預實驗驗證?
這些問題的共同點是:先把可視化變成可復現測量,再討論解釋。熱力圖是研究入口,不是結論本身。
總結
Attention 熱力圖最適合承擔三件事:檢查實現、發現模式、生成假設。它可以告訴我們某層某頭如何分配權重,也能幫助定位 mask、token 對齊和特殊符號依賴問題。但它不能單獨回答“模型為什麼預測這個類別”。從復現角度看,最重要的不是畫出漂亮矩陣,而是保存原始 attention、明確 Query/Key 方向、固定可視化協議,並把論文報告、本次實際驗證和作者推斷分開。
本文的最小腳本已完成標準庫 smoke test;正式配圖已補齊並通過檢查。下一步若要擴展成真實模型復現實驗,應在安裝依賴後運行 toy heatmap 導出命令,再接入 Hugging Face 模型的 output_attentions=True 輸出,保存原始矩陣、PNG 和協議日誌。
參考資料
檢索日期:2026-08-25。以下鏈接優先採用論文頁面、官方倉庫或官方文檔;動態文檔和倉庫內容可能更新,正式實驗應記錄訪問日期、模型 revision 與本地依賴版本。
- Ashish Vaswani et al., Attention Is All You Need, arXiv 2017,當前 arXiv 頁面顯示 v7 修訂於 2023-08-02。
- Sarthak Jain and Byron C. Wallace, Attention is not Explanation, NAACL 2019。
- Kevin Clark et al., What Does BERT Look at? An Analysis of BERT’s Attention, BlackboxNLP 2019。
- Jesse Vig, A Multiscale Visualization of Attention in the Transformer Model, ACL System Demonstrations 2019。
- Jesse Vig, BERTViz official repository,attention 可視化工具與示例。
- Hugging Face, Transformers model outputs documentation,
attentions輸出格式說明。 - Captum, Model Interpretability for PyTorch API,梯度、擾動和層歸因方法索引。