日期:2026-08-24
適合讀者:研究生、科研新人、希望真正理解 Transformer 代碼的工程讀者
檢索日期:2026-08-24
摘要
很多人第一次接觸 Transformer,是從 nn.TransformerEncoderLayer、BERT 或 Hugging Face 模型開始的:幾行代碼就能得到輸出,卻不容易說清每一維張量為何這樣變化,padding mask 究竟屏蔽誰,殘差連接與 LayerNorm 的順序又為何影響訓練穩定性。
本文不復現原論文在 WMT 機器翻譯上的完整結果,而是完成一個更小、也更適合作為科研起點的目標:只使用 PyTorch 的基礎張量運算和 nn.Linear,實現一個可讀的 Transformer Encoder,包括正弦位置編碼、多頭自注意力、前饋網絡、殘差連接、LayerNorm、padding mask、參數初始化與最小測試。配套腳本還設計了一個“判斷序列首尾 token 是否相同”的合成任務,用來檢查模型是否能建立跨位置關係。
需要先說明證據邊界:當前工作區的 Python 環境沒有安裝 PyTorch,因此本文附帶的腳本已通過語法檢查,但 CPU 訓練與數值結果尚未實際運行,相關輸出應在安裝依賴後人工核驗。本文不會把預期現象寫成實測結論。
目錄
- 為什麼要從零復現 Encoder
- 原論文中的 Encoder 到底包含什麼
- 從公式到張量形狀
- 最小 PyTorch 實現怎麼讀
- 最小實驗與驗收標準
- 與 PyTorch 官方實現對照
- 最容易踩的復現陷阱
- 可以繼續研究的問題
- 總結與參考資料
為什麼要從零復現 Encoder
“會調用 Transformer”和“理解 Transformer”之間,差的往往不是更多公式,而是把公式、張量和代碼逐項對齊的能力。研究生做論文復現時,真正消耗時間的通常不是寫出 model(x),而是回答這些細節:輸入是 [batch, length, hidden] 還是 [length, batch, hidden]?mask 中的 True 表示保留還是屏蔽?多頭拆分後為什麼要 transpose?殘差分支加的是歸一化前還是歸一化後的表示?為什麼輸出形狀正確,loss 卻一直是 nan?
從零實現一個 Encoder 的價值,是建立一份可檢查的“結構賬本”。每個模塊都應有輸入形狀、輸出形狀、數學含義和不變量。這樣再閱讀 BERT、Vision Transformer、CLIP 或多模態模型時,看到的就不再是一組陌生類名,而是同一基本結構在位置編碼、歸一化、激活函數和注意力模式上的變體。
這也決定了本文的復現邊界。原始 Transformer 是編碼器-解碼器機器翻譯系統,論文的 WMT 結果依賴數據處理、訓練預算、學習率調度、label smoothing、beam search 和 checkpoint averaging。一個本地小腳本不可能證明這些結果。我們只復現 Encoder 的計算圖與關鍵不變量,把“大結果復現”拆成可驗證的第一步。
原論文中的 Encoder 到底包含什麼
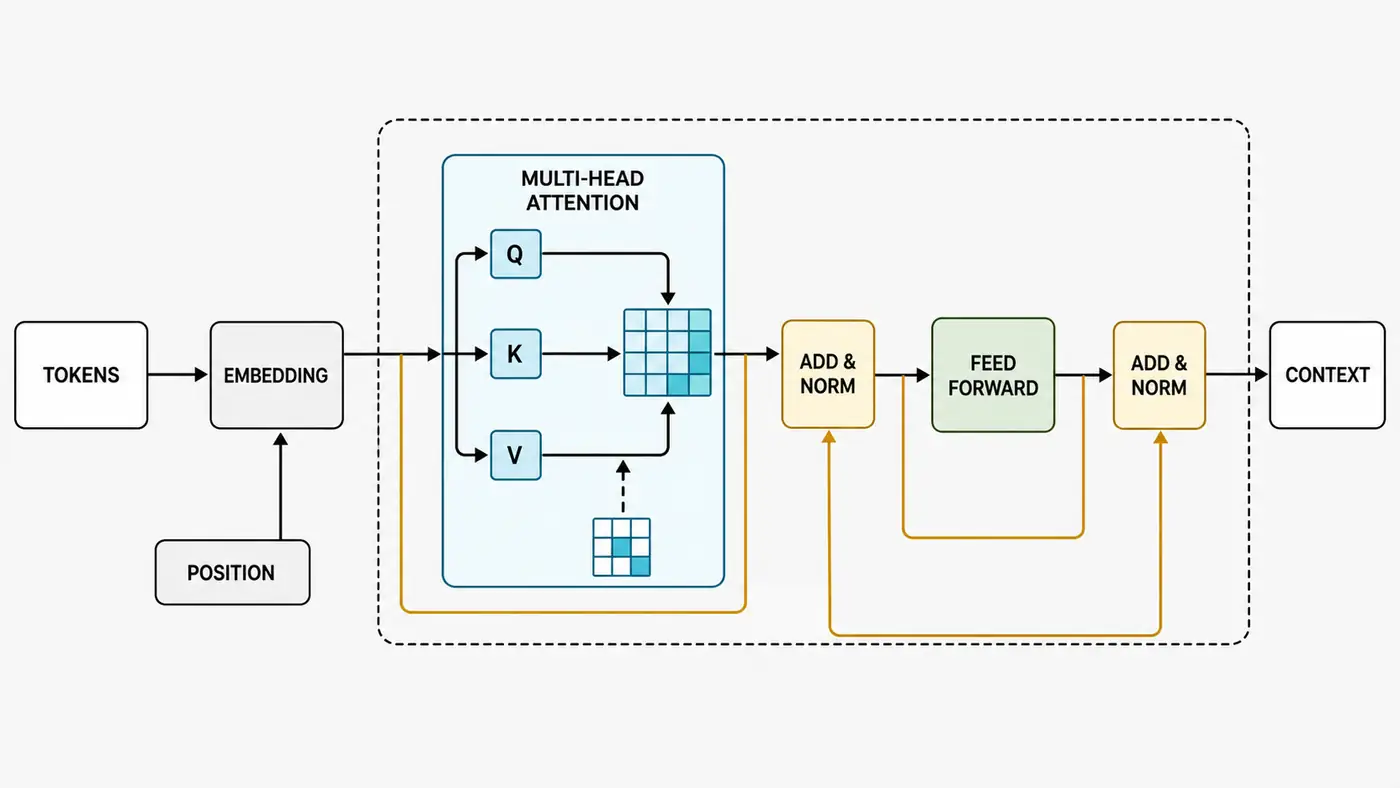
2017 年的《Attention Is All You Need》用自注意力替代循環網絡和卷積,讓一個序列中的所有位置可以並行計算。原論文的 Encoder 由 N 個相同結構的層堆疊而成,每層包含兩個子層:Multi-Head Self-Attention 和 Position-wise Feed-Forward Network。每個子層外都有殘差連接與 LayerNorm。
對輸入 token 序列,最底部先查 embedding,再乘以 sqrt(d_model),隨後加上同維度的位置編碼。位置編碼是必要的,因為自注意力本身只根據內容計算 token 間關係;如果交換兩個 token,同時交換對應的 Q、K、V,純注意力不會自動知道順序發生了變化。
原論文使用正弦和餘弦函數構造固定位置編碼:
偶數維和奇數維使用不同相位,不同維度對應不同頻率。實現時最重要的不是背公式,而是確認 PE 的形狀可廣播到 [B,T,d_model],並作為 buffer 跟隨模型移動設備,卻不參與梯度更新。
Encoder 輸出仍然是長度為 T 的序列表示,而不是一個分類結果。每個位置都已通過自注意力融合全序列信息。BERT 後來把這種雙向 Encoder 表示用於預訓練,再針對分類、問答等任務增加輸出頭;這也是“Encoder 不是隻為機器翻譯服務”的典型例子。
從公式到張量形狀
1. Scaled Dot-Product Attention
注意力的核心公式是:
若輸入 x 為 [B,T,d_model],先通過線性映射得到 Q、K、V。拆成 h 個頭後,三者形狀都變為 [B,h,T,d_head],其中 d_head=d_model/h。因此 d_model 必須能被頭數整除。
Q @ K.transpose(-2,-1) 得到 [B,h,T,T]。前一個 T 表示“哪個 Query 正在提問”,後一個 T 表示“它能查看哪些 Key”。除以 sqrt(d_head) 是為了控制點積方差;維度增大時,未經縮放的分數容易進入 softmax 的飽和區,梯度會變得不友好。
mask 應在 softmax 前作用於 score。對 padding mask,True 通常表示對應 Key 是填充位置,需把該列 score 設成一個極小值。這裡尤其容易寫反:屏蔽的是 Key 維,也就是 [B,1,1,T] 廣播到所有頭和所有 Query,而不是隨手把輸出位置清零。PyTorch 官方 MultiheadAttention 文檔同樣規定,二值 key_padding_mask 中的 True 表示忽略該 Key。
2. Multi-Head 的意義
單頭注意力只在一個投影空間內計算關係。多頭注意力讓不同頭擁有獨立的 Q、K、V 子空間,再把各頭結果拼回 [B,T,d_model],最後通過輸出投影 W^O 混合。
這不意味著每個頭必然學出人類可命名的語言學關係。注意力權重可以用於診斷,但“某個頭看向某個 token”不能直接等同於因果解釋。下一篇的 Attention 可視化會專門討論這一邊界。
3. Position-wise FFN
前饋網絡獨立作用於每個位置:
它先把 d_model 擴展到 d_ff,經過 ReLU,再投影回 d_model。注意力負責跨位置混合,FFN 負責對每個位置做非線性特徵變換。兩者分工不同,不能因為“attention is all you need”就刪掉 FFN。
4. 殘差與 LayerNorm
原論文寫法是 LayerNorm(x + Sublayer(x)),即 Post-LN。PyTorch 的 TransformerEncoderLayer 默認 norm_first=False,也對應先做子層與殘差,再歸一化;設置 norm_first=True 則變為 Pre-LN。後續研究表明,兩種順序會改變深層 Transformer 的梯度行為和 warm-up 需求。因此復現時必須把歸一化順序視為實驗變量,不能只看模塊是否都存在。
最小 PyTorch 實現怎麼讀
配套腳本位於 code/minimal_transformer_encoder.py。建議不要從 main() 開始,而按以下路徑閱讀。
第一步看 MultiHeadSelfAttention.forward()。重點追蹤 QKV 合併投影、view、permute、score 矩陣、mask 廣播、softmax、各頭拼接這七個動作。只要其中一次維度交換錯了,代碼可能仍能運行,卻把 batch、head 或 sequence 的語義混在一起。
第二步看 EncoderLayer.forward()。腳本同時保留 Post-LN 和 Pre-LN 兩條路徑,默認使用原論文式 Post-LN。這裡應明確殘差分支中的 x 指向哪一階段,避免無意中把 norm(x) 與未歸一化的殘差相加。
第三步看 TransformerEncoder.forward()。它完成 embedding 縮放、位置編碼和 N 層堆疊。這裡用 ModuleList 創建獨立層,而不是重複引用同一個 layer 對象;否則看起來堆疊了 N 層,實際卻共享全部參數。
第四步看 run_invariant_checks()。它不檢查“模型聰不聰明”,只檢查更基礎、也更可靠的事實:輸出是否為 [2,5,64],每層注意力是否為 [2,4,5,5],softmax 後每行是否求和為 1,被 padding mask 屏蔽的 Key 概率是否為 0。復現項目應先通過這些不變量,再談訓練曲線。
最小實驗與驗收標準
安裝依賴後,可先只運行結構檢查:
python3 -m pip install -r code/requirements.txt
python3 code/minimal_transformer_encoder.py --check-only
再運行合成任務:
python3 code/minimal_transformer_encoder.py --steps 80 --seed 7
任務隨機生成長度為 12 的 token 序列,並平衡構造兩類樣本:正類的首 token 與尾 token 相同,負類則確保兩者不同。分類頭只讀取第一個位置的 Encoder 表示,因此模型若要利用最後一個 token,必須通過層內信息交互把遠端信息傳回首位置。這個任務不是 benchmark,也不能證明實現等價於原論文訓練系統;它只是一個便宜的端到端連通性檢查。
建議把驗收分成四層。
| 層級 | 檢查內容 | 失敗時優先排查 |
|---|---|---|
| 結構 | 所有張量形狀與頭數一致 | view、permute、d_model % n_heads |
| 數值 | loss、梯度和 attention 無 nan/inf |
mask、學習率、初始化、全 padding 行 |
| 學習 | 固定 seed 後 loss 有下降趨勢 | 標籤構造、梯度是否更新、dropout、任務是否可學 |
| 對照 | 與官方層在相同配置下輸出形狀和 mask 語義一致 | batch_first、Pre/Post-LN、激活、bias、dropout |
本次實際驗證結果是:腳本已通過 Python 語法編譯;當前環境因缺少 torch,未執行結構斷言和訓練循環。安裝依賴後,首先應運行 --check-only,再觀察 toy loss,而不是直接引用一個未經運行的準確率。
與 PyTorch 官方實現對照
PyTorch 官方 TransformerEncoderLayer 明確由 self-attention 和 feed-forward network 構成,並提供 d_model、nhead、dim_feedforward、dropout、activation、batch_first 與 norm_first 等參數。把本文實現與官方層逐項對照,可以得到一張最實用的閱讀表。
| 本文模塊 | PyTorch 官方對應 | 需要核對的語義 |
|---|---|---|
MultiHeadSelfAttention |
nn.MultiheadAttention |
輸入佈局、mask 中 True 的含義、是否返回每個 head 權重 |
EncoderLayer |
nn.TransformerEncoderLayer |
Post-LN / Pre-LN、激活函數、dropout 位置 |
ModuleList[layers] |
nn.TransformerEncoder |
層數、參數是否獨立、最終 norm |
| 手寫 attention 公式 | scaled_dot_product_attention |
數值穩定性、融合 kernel、mask 類型 |
手寫版本適合學習和插樁,不適合直接替代生產實現。PyTorch 當前教程建議用 scaled_dot_product_attention、Nested Tensor、torch.compile() 和 FlexAttention 等底層組件構建更靈活高效的層。這裡的差異不是“公式變了”,而是官方實現還要處理 kernel 調度、不同 dtype、設備、稀疏長度、編譯和性能快路徑。
最容易踩的復現陷阱
第一,忘記 embedding 縮放或位置編碼。小任務也許仍能擬合,但這已經不是原論文的輸入構造,不能把結果當成同一實現。
第二,softmax 維度寫錯。attention 應沿最後一個 Key 維歸一化。如果沿 head 或 Query 維做 softmax,輸出形狀仍完全正確,錯誤卻很隱蔽。
第三,mask 語義混亂。不同庫可能用 1 表示保留,也可能用 True 表示屏蔽。不要憑記憶轉換;先讀當前版本文檔,再寫一個兩行樣例驗證被屏蔽位置的概率確實為 0。
第四,所有 Key 都被屏蔽。若某個樣本的一行 score 全是極小值,softmax 可能產生無意義分佈,部分實現或 dtype 下還可能出現 nan。數據管線應保證至少有一個有效 token,或顯式定義空序列行為。
第五,混淆 Encoder 自注意力和 Decoder 因果注意力。Encoder 通常允許每個位置查看整個輸入,不應默認加上三角 causal mask。把 Decoder 的“不能看未來”照搬到 BERT 風格 Encoder,會悄悄改變任務定義。
第六,層複製成參數共享。[layer] * N 只是把同一個 Python 對象引用 N 次。若論文沒有明確共享參數,應為每層實例化獨立模塊。
第七,只報告最終 loss。一個可信復現還應記錄 PyTorch 版本、設備、seed、數據生成方式、參數量、訓練步數、優化器與提交版本。toy task 的成功只能說明實現具有基本學習能力,不能外推到翻譯質量、長序列能力或真實語料性能。
可以繼續研究的問題
- 在層數從 2 增加到 24 時,Post-LN 與 Pre-LN 的梯度範數、warm-up 需求和收斂速度如何變化?
- 固定參數量後,增加 head 數是否總能提升合成關係任務?當
d_head太小時會發生什麼? - 正弦位置編碼、可學習絕對位置編碼、RoPE 與 ALiBi 在長度外推上的差異,如何用可控數據驗證?
- 手寫 attention 與 PyTorch
scaled_dot_product_attention在 CPU、CUDA、不同 dtype 下的數值誤差與速度差異多大? - padding mask、causal mask 和任意稀疏 mask 能否統一為一個經過單元測試的接口?
- 注意力權重與模型預測之間是否具有因果關係?遮蔽高權重連接後,輸出變化是否真的更大?
這些問題都適合從本文腳本擴展。研究價值不在於再造一個更大的 Transformer,而在於把一個變量、一個假設和一個測量協議說清楚。
總結
復現 Transformer Encoder 的第一步,不是追求與原論文相同的 BLEU,而是建立公式、張量、代碼和測試之間的對應關係:QKV 如何拆頭,score 為什麼除以 sqrt(d_head),mask 在哪個維度生效,注意力後為何還需要 FFN,殘差與 LayerNorm 的順序又如何成為可研究變量。
本文的最小實現刻意保留可讀性,並用形狀、概率和 mask 不變量約束正確性。它已經完成靜態語法驗證,但由於當前環境沒有 PyTorch,運行時結果仍標註為待人工核驗。這樣的邊界說明不是缺點,而是復現記錄最重要的一部分:只報告真正做過的驗證。
參考資料
檢索日期:2026-08-24。PyTorch 文檔會隨版本變化;正式復現實驗應同時記錄本地 torch.__version__、設備與提交版本。
- Vaswani et al., Attention Is All You Need, 2017;arXiv 當前頁面包含 2023 年修訂版本。
- Harvard NLP, The Annotated Transformer,帶註釋的 PyTorch 實現與 notebook。
- PyTorch, TransformerEncoderLayer,當前官方 API 說明。
- PyTorch, MultiheadAttention,輸入形狀、
key_padding_mask與attn_mask語義。 - PyTorch Tutorials, Transformer building blocks,
scaled_dot_product_attention、Nested Tensor 與自定義層的當前建議。 - Harvard NLP, the_annotated_transformer.py,位置編碼、模型構造、初始化與訓練代碼路徑。
- Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, 2018。
- Xiong et al., On Layer Normalization in the Transformer Architecture, ICML 2020。