日期:2026-08-24
摘要
很多人第一次接触 Transformer,是从 nn.TransformerEncoderLayer、BERT 或 Hugging Face 模型开始的:几行代码就能得到输出,却不容易说清每一维张量为何这样变化,padding mask 究竟屏蔽谁,残差连接与 LayerNorm 的顺序又为何影响训练稳定性。
本文不复现原论文在 WMT 机器翻译上的完整结果,而是完成一个更小、也更适合作为科研起点的目标:只使用 PyTorch 的基础张量运算和 nn.Linear,实现一个可读的 Transformer Encoder,包括正弦位置编码、多头自注意力、前馈网络、残差连接、LayerNorm、padding mask、参数初始化与最小测试。配套脚本还设计了一个“判断序列首尾 token 是否相同”的合成任务,用来检查模型是否能建立跨位置关系。
需要先说明证据边界:当前工作区的 Python 环境没有安装 PyTorch,因此本文附带的脚本已通过语法检查,但 CPU 训练与数值结果尚未实际运行,相关输出应在安装依赖后人工核验。本文不会把预期现象写成实测结论。
目录
为什么要从零复现 Encoder
原论文中的 Encoder 到底包含什么
从公式到张量形状
最小 PyTorch 实现怎么读
最小实验与验收标准
与 PyTorch 官方实现对照
最容易踩的复现陷阱
可以继续研究的问题
总结与参考资料
为什么要从零复现 Encoder
“会调用 Transformer”和“理解 Transformer”之间,差的往往不是更多公式,而是把公式、张量和代码逐项对齐的能力。研究生做论文复现时,真正消耗时间的通常不是写出 model(x),而是回答这些细节:输入是 [batch, length, hidden] 还是 [length, batch, hidden]?mask 中的 True 表示保留还是屏蔽?多头拆分后为什么要 transpose?残差分支加的是归一化前还是归一化后的表示?为什么输出形状正确,loss 却一直是 nan?
从零实现一个 Encoder 的价值,是建立一份可检查的“结构账本”。每个模块都应有输入形状、输出形状、数学含义和不变量。这样再阅读 BERT、Vision Transformer、CLIP 或多模态模型时,看到的就不再是一组陌生类名,而是同一基本结构在位置编码、归一化、激活函数和注意力模式上的变体。
这也决定了本文的复现边界。原始 Transformer 是编码器-解码器机器翻译系统,论文的 WMT 结果依赖数据处理、训练预算、学习率调度、label smoothing、beam search 和 checkpoint averaging。一个本地小脚本不可能证明这些结果。我们只复现 Encoder 的计算图与关键不变量,把“大结果复现”拆成可验证的第一步。
原论文中的 Encoder 到底包含什么
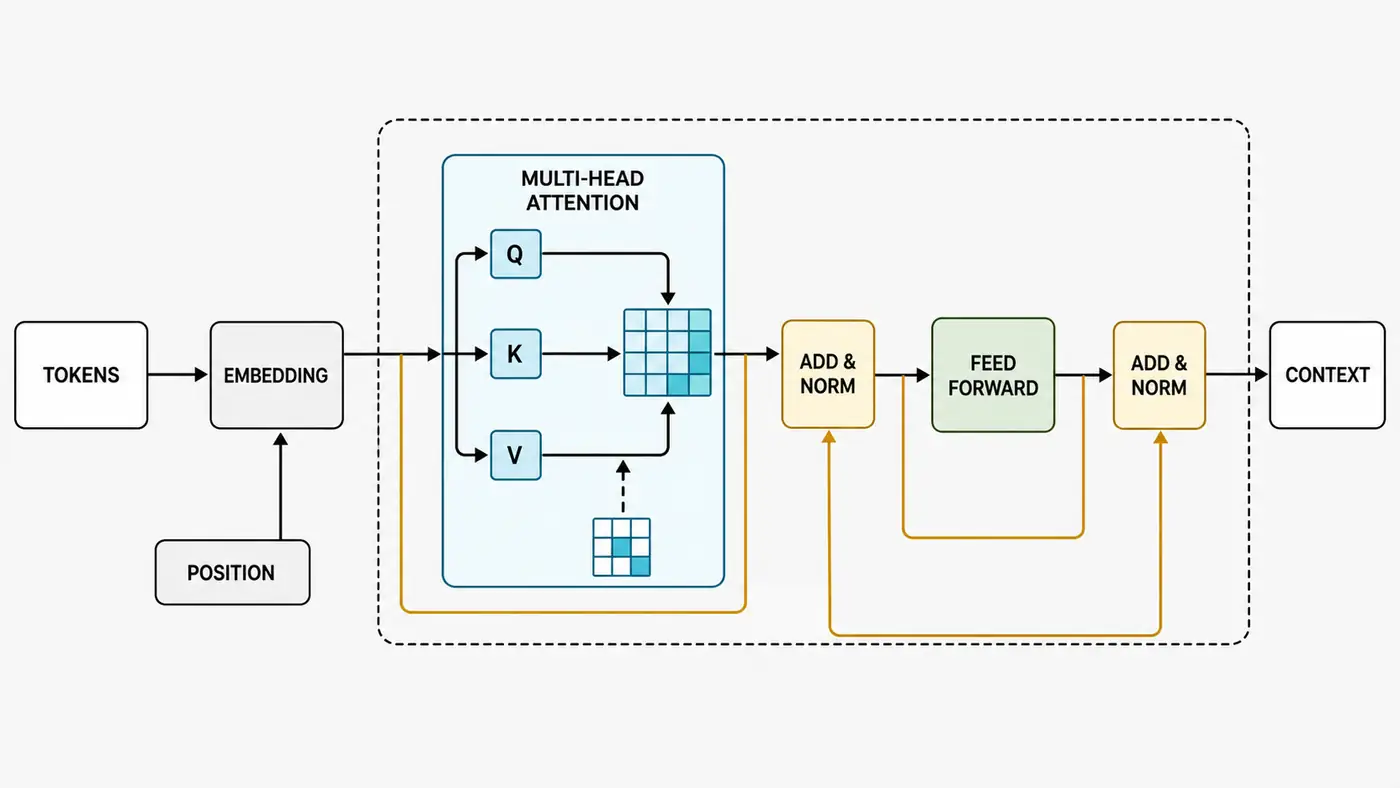
2017 年的《Attention Is All You Need》用自注意力替代循环网络和卷积,让一个序列中的所有位置可以并行计算。原论文的 Encoder 由 N 个相同结构的层堆叠而成,每层包含两个子层:Multi-Head Self-Attention 和 Position-wise Feed-Forward Network。每个子层外都有残差连接与 LayerNorm。
对输入 token 序列,最底部先查 embedding,再乘以 sqrt(d_model),随后加上同维度的位置编码。位置编码是必要的,因为自注意力本身只根据内容计算 token 间关系;如果交换两个 token,同时交换对应的 Q、K、V,纯注意力不会自动知道顺序发生了变化。
原论文使用正弦和余弦函数构造固定位置编码:
P E ( p o s , 2 i ) = sin ( p o s / 10000 2 i / d m o d e l ) PE(pos, 2i)=\sin\left(pos/10000^{2i/d_{model}}\right) P E ( p os , 2 i ) = sin ( p os /1000 0 2 i / d m o d e l ) P E ( p o s , 2 i + 1 ) = cos ( p o s / 10000 2 i / d m o d e l ) PE(pos, 2i+1)=\cos\left(pos/10000^{2i/d_{model}}\right) P E ( p os , 2 i + 1 ) = cos ( p os /1000 0 2 i / d m o d e l ) 偶数维和奇数维使用不同相位,不同维度对应不同频率。实现时最重要的不是背公式,而是确认 PE 的形状可广播到 [B,T,d_model],并作为 buffer 跟随模型移动设备,却不参与梯度更新。
Encoder 输出仍然是长度为 T 的序列表示,而不是一个分类结果。每个位置都已通过自注意力融合全序列信息。BERT 后来把这种双向 Encoder 表示用于预训练,再针对分类、问答等任务增加输出头;这也是“Encoder 不是只为机器翻译服务”的典型例子。
从公式到张量形状
1. Scaled Dot-Product Attention
注意力的核心公式是:
A t t e n t i o n ( Q , K , V ) = s o f t m a x ( Q K T d k + M ) V Attention(Q,K,V)=softmax\left(\frac{QK^T}{\sqrt{d_k}}+M\right)V A tt e n t i o n ( Q , K , V ) = so f t ma x ( d k Q K T + M ) V 若输入 x 为 [B,T,d_model],先通过线性映射得到 Q、K、V。拆成 h 个头后,三者形状都变为 [B,h,T,d_head],其中 d_head=d_model/h。因此 d_model 必须能被头数整除。
Q @ K.transpose(-2,-1) 得到 [B,h,T,T]。前一个 T 表示“哪个 Query 正在提问”,后一个 T 表示“它能查看哪些 Key”。除以 sqrt(d_head) 是为了控制点积方差;维度增大时,未经缩放的分数容易进入 softmax 的饱和区,梯度会变得不友好。
mask 应在 softmax 前作用于 score。对 padding mask,True 通常表示对应 Key 是填充位置,需把该列 score 设成一个极小值。这里尤其容易写反:屏蔽的是 Key 维,也就是 [B,1,1,T] 广播到所有头和所有 Query,而不是随手把输出位置清零。PyTorch 官方 MultiheadAttention 文档同样规定,二值 key_padding_mask 中的 True 表示忽略该 Key。
2. Multi-Head 的意义
单头注意力只在一个投影空间内计算关系。多头注意力让不同头拥有独立的 Q、K、V 子空间,再把各头结果拼回 [B,T,d_model],最后通过输出投影 W^O 混合。
M u l t i H e a d ( Q , K , V ) = C o n c a t ( h e a d 1 , … , h e a d h ) W O MultiHead(Q,K,V)=Concat(head_1,\ldots,head_h)W^O M u l t i H e a d ( Q , K , V ) = C o n c a t ( h e a d 1 , … , h e a d h ) W O 这不意味着每个头必然学出人类可命名的语言学关系。注意力权重可以用于诊断,但“某个头看向某个 token”不能直接等同于因果解释。下一篇的 Attention 可视化会专门讨论这一边界。
3. Position-wise FFN
前馈网络独立作用于每个位置:
F F N ( x ) = max ( 0 , x W 1 + b 1 ) W 2 + b 2 FFN(x)=\max(0,xW_1+b_1)W_2+b_2 F F N ( x ) = max ( 0 , x W 1 + b 1 ) W 2 + b 2 它先把 d_model 扩展到 d_ff,经过 ReLU,再投影回 d_model。注意力负责跨位置混合,FFN 负责对每个位置做非线性特征变换。两者分工不同,不能因为“attention is all you need”就删掉 FFN。
4. 残差与 LayerNorm
原论文写法是 LayerNorm(x + Sublayer(x)),即 Post-LN。PyTorch 的 TransformerEncoderLayer 默认 norm_first=False,也对应先做子层与残差,再归一化;设置 norm_first=True 则变为 Pre-LN。后续研究表明,两种顺序会改变深层 Transformer 的梯度行为和 warm-up 需求。因此复现时必须把归一化顺序视为实验变量,不能只看模块是否都存在。
最小 PyTorch 实现怎么读
配套脚本位于 code/minimal_transformer_encoder.pymain() 开始,而按以下路径阅读。
第一步看 MultiHeadSelfAttention.forward()。重点追踪 QKV 合并投影、view、permute、score 矩阵、mask 广播、softmax、各头拼接这七个动作。只要其中一次维度交换错了,代码可能仍能运行,却把 batch、head 或 sequence 的语义混在一起。
第二步看 EncoderLayer.forward()。脚本同时保留 Post-LN 和 Pre-LN 两条路径,默认使用原论文式 Post-LN。这里应明确残差分支中的 x 指向哪一阶段,避免无意中把 norm(x) 与未归一化的残差相加。
第三步看 TransformerEncoder.forward()。它完成 embedding 缩放、位置编码和 N 层堆叠。这里用 ModuleList 创建独立层,而不是重复引用同一个 layer 对象;否则看起来堆叠了 N 层,实际却共享全部参数。
第四步看 run_invariant_checks()。它不检查“模型聪不聪明”,只检查更基础、也更可靠的事实:输出是否为 [2,5,64],每层注意力是否为 [2,4,5,5],softmax 后每行是否求和为 1,被 padding mask 屏蔽的 Key 概率是否为 0。复现项目应先通过这些不变量,再谈训练曲线。
最小实验与验收标准
安装依赖后,可先只运行结构检查:
python3 -m pip install -r code/requirements.txt
python3 code/minimal_transformer_encoder.py --check-only
再运行合成任务:
python3 code/minimal_transformer_encoder.py --steps 80 --seed 7
任务随机生成长度为 12 的 token 序列,并平衡构造两类样本:正类的首 token 与尾 token 相同,负类则确保两者不同。分类头只读取第一个位置的 Encoder 表示,因此模型若要利用最后一个 token,必须通过层内信息交互把远端信息传回首位置。这个任务不是 benchmark,也不能证明实现等价于原论文训练系统;它只是一个便宜的端到端连通性检查。
建议把验收分成四层。
层级
检查内容
失败时优先排查
结构
所有张量形状与头数一致
view、permute、d_model % n_heads
数值
loss、梯度和 attention 无 nan/inf
mask、学习率、初始化、全 padding 行
学习
固定 seed 后 loss 有下降趋势
标签构造、梯度是否更新、dropout、任务是否可学
对照
与官方层在相同配置下输出形状和 mask 语义一致
batch_first、Pre/Post-LN、激活、bias、dropout
本次实际验证结果是:脚本已通过 Python 语法编译;当前环境因缺少 torch,未执行结构断言和训练循环。安装依赖后,首先应运行 --check-only,再观察 toy loss,而不是直接引用一个未经运行的准确率。
与 PyTorch 官方实现对照
PyTorch 官方 TransformerEncoderLayer 明确由 self-attention 和 feed-forward network 构成,并提供 d_model、nhead、dim_feedforward、dropout、activation、batch_first 与 norm_first 等参数。把本文实现与官方层逐项对照,可以得到一张最实用的阅读表。
本文模块
PyTorch 官方对应
需要核对的语义
MultiHeadSelfAttentionnn.MultiheadAttention输入布局、mask 中 True 的含义、是否返回每个 head 权重
EncoderLayernn.TransformerEncoderLayerPost-LN / Pre-LN、激活函数、dropout 位置
ModuleList[layers]nn.TransformerEncoder层数、参数是否独立、最终 norm
手写 attention 公式
scaled_dot_product_attention数值稳定性、融合 kernel、mask 类型
手写版本适合学习和插桩,不适合直接替代生产实现。PyTorch 当前教程建议用 scaled_dot_product_attention、Nested Tensor、torch.compile() 和 FlexAttention 等底层组件构建更灵活高效的层。这里的差异不是“公式变了”,而是官方实现还要处理 kernel 调度、不同 dtype、设备、稀疏长度、编译和性能快路径。
最容易踩的复现陷阱
第一,忘记 embedding 缩放或位置编码。小任务也许仍能拟合,但这已经不是原论文的输入构造,不能把结果当成同一实现。
第二,softmax 维度写错。attention 应沿最后一个 Key 维归一化。如果沿 head 或 Query 维做 softmax,输出形状仍完全正确,错误却很隐蔽。
第三,mask 语义混乱。不同库可能用 1 表示保留,也可能用 True 表示屏蔽。不要凭记忆转换;先读当前版本文档,再写一个两行样例验证被屏蔽位置的概率确实为 0。
第四,所有 Key 都被屏蔽。若某个样本的一行 score 全是极小值,softmax 可能产生无意义分布,部分实现或 dtype 下还可能出现 nan。数据管线应保证至少有一个有效 token,或显式定义空序列行为。
第五,混淆 Encoder 自注意力和 Decoder 因果注意力。Encoder 通常允许每个位置查看整个输入,不应默认加上三角 causal mask。把 Decoder 的“不能看未来”照搬到 BERT 风格 Encoder,会悄悄改变任务定义。
第六,层复制成参数共享。[layer] * N 只是把同一个 Python 对象引用 N 次。若论文没有明确共享参数,应为每层实例化独立模块。
第七,只报告最终 loss。一个可信复现还应记录 PyTorch 版本、设备、seed、数据生成方式、参数量、训练步数、优化器与提交版本。toy task 的成功只能说明实现具有基本学习能力,不能外推到翻译质量、长序列能力或真实语料性能。
可以继续研究的问题
在层数从 2 增加到 24 时,Post-LN 与 Pre-LN 的梯度范数、warm-up 需求和收敛速度如何变化?
固定参数量后,增加 head 数是否总能提升合成关系任务?当 d_head 太小时会发生什么?
正弦位置编码、可学习绝对位置编码、RoPE 与 ALiBi 在长度外推上的差异,如何用可控数据验证?
手写 attention 与 PyTorch scaled_dot_product_attention 在 CPU、CUDA、不同 dtype 下的数值误差与速度差异多大?
padding mask、causal mask 和任意稀疏 mask 能否统一为一个经过单元测试的接口?
注意力权重与模型预测之间是否具有因果关系?遮蔽高权重连接后,输出变化是否真的更大?
这些问题都适合从本文脚本扩展。研究价值不在于再造一个更大的 Transformer,而在于把一个变量、一个假设和一个测量协议说清楚。
总结
复现 Transformer Encoder 的第一步,不是追求与原论文相同的 BLEU,而是建立公式、张量、代码和测试之间的对应关系:QKV 如何拆头,score 为什么除以 sqrt(d_head),mask 在哪个维度生效,注意力后为何还需要 FFN,残差与 LayerNorm 的顺序又如何成为可研究变量。
本文的最小实现刻意保留可读性,并用形状、概率和 mask 不变量约束正确性。它已经完成静态语法验证,但由于当前环境没有 PyTorch,运行时结果仍标注为待人工核验。这样的边界说明不是缺点,而是复现记录最重要的一部分:只报告真正做过的验证。
参考资料
检索日期:2026-08-24。PyTorch 文档会随版本变化;正式复现实验应同时记录本地 torch.__version__、设备与提交版本。
Vaswani et al., Attention Is All You Need , 2017;arXiv 当前页面包含 2023 年修订版本。
Harvard NLP, The Annotated Transformer ,带注释的 PyTorch 实现与 notebook。
PyTorch, TransformerEncoderLayer ,当前官方 API 说明。
PyTorch, MultiheadAttention ,输入形状、key_padding_mask 与 attn_mask 语义。
PyTorch Tutorials, Transformer building blocks ,scaled_dot_product_attention、Nested Tensor 与自定义层的当前建议。
Harvard NLP, the_annotated_transformer.py ,位置编码、模型构造、初始化与训练代码路径。
Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding , 2018。
Xiong et al., On Layer Normalization in the Transformer Architecture , ICML 2020。
Companion Code
配套示例代码 与正文对应的教学示例。请先阅读运行说明,下载所需文件并保留目录结构;也可以展开源码对照阅读。
展开查看完整源码 minimal_transformer_encoder.py · 258 行 """A minimal Transformer encoder implemented with basic PyTorch modules.
The script includes shape and masking checks plus a tiny synthetic task. It is
intended for learning and reproduction, not as a high-performance kernel.
"""
from __future__ import annotations
import argparse
import math
import torch
from torch import Tensor, nn
def set_seed(seed: int) -> None:
torch.manual_seed(seed)
class SinusoidalPositionalEncoding(nn.Module):
def __init__(self, d_model: int, max_length: int = 512) -> None:
super().__init__()
position = torch.arange(max_length, dtype=torch.float32).unsqueeze(1)
div_term = torch.exp(
torch.arange(0, d_model, 2, dtype=torch.float32)
* (-math.log(10000.0) / d_model)
)
encoding = torch.zeros(max_length, d_model)
encoding[:, 0::2] = torch.sin(position * div_term)
encoding[:, 1::2] = torch.cos(position * div_term)
self.register_buffer("encoding", encoding.unsqueeze(0), persistent=False)
def forward(self, x: Tensor) -> Tensor:
return x + self.encoding[:, : x.size(1)].to(dtype=x.dtype)
class MultiHeadSelfAttention(nn.Module):
def __init__(self, d_model: int, n_heads: int, dropout: float = 0.0) -> None:
super().__init__()
if d_model % n_heads != 0:
raise ValueError("d_model must be divisible by n_heads")
self.n_heads = n_heads
self.d_head = d_model // n_heads
self.qkv = nn.Linear(d_model, 3 * d_model)
self.out_proj = nn.Linear(d_model, d_model)
self.dropout = nn.Dropout(dropout)
def forward(
self,
x: Tensor,
key_padding_mask: Tensor | None = None,
need_weights: bool = False,
) -> tuple[Tensor, Tensor | None]:
batch, length, d_model = x.shape
qkv = self.qkv(x).view(
batch, length, 3, self.n_heads, self.d_head
)
q, k, v = qkv.permute(2, 0, 3, 1, 4).unbind(0)
scores = q @ k.transpose(-2, -1)
scores = scores / math.sqrt(self.d_head)
if key_padding_mask is not None:
if key_padding_mask.shape != (batch, length):
raise ValueError("key_padding_mask must have shape [batch, length]")
scores = scores.masked_fill(
key_padding_mask[:, None, None, :],
torch.finfo(scores.dtype).min,
)
weights = torch.softmax(scores, dim=-1)
context = self.dropout(weights) @ v
context = context.transpose(1, 2).contiguous().view(batch, length, d_model)
output = self.out_proj(context)
return output, weights if need_weights else None
class EncoderLayer(nn.Module):
def __init__(
self,
d_model: int,
n_heads: int,
d_ff: int,
dropout: float = 0.1,
norm_first: bool = False,
) -> None:
super().__init__()
self.norm_first = norm_first
self.self_attn = MultiHeadSelfAttention(d_model, n_heads, dropout)
self.ffn = nn.Sequential(
nn.Linear(d_model, d_ff),
nn.ReLU(),
nn.Dropout(dropout),
nn.Linear(d_ff, d_model),
)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
self.dropout1 = nn.Dropout(dropout)
self.dropout2 = nn.Dropout(dropout)
def forward(
self,
x: Tensor,
key_padding_mask: Tensor | None = None,
need_weights: bool = False,
) -> tuple[Tensor, Tensor | None]:
if self.norm_first:
attn_out, weights = self.self_attn(
self.norm1(x), key_padding_mask, need_weights
)
x = x + self.dropout1(attn_out)
x = x + self.dropout2(self.ffn(self.norm2(x)))
return x, weights
attn_out, weights = self.self_attn(x, key_padding_mask, need_weights)
x = self.norm1(x + self.dropout1(attn_out))
x = self.norm2(x + self.dropout2(self.ffn(x)))
return x, weights
class TransformerEncoder(nn.Module):
def __init__(
self,
vocab_size: int,
d_model: int = 64,
n_heads: int = 4,
d_ff: int = 128,
n_layers: int = 2,
dropout: float = 0.1,
norm_first: bool = False,
) -> None:
super().__init__()
self.d_model = d_model
self.embedding = nn.Embedding(vocab_size, d_model, padding_idx=0)
self.position = SinusoidalPositionalEncoding(d_model)
self.layers = nn.ModuleList(
[
EncoderLayer(d_model, n_heads, d_ff, dropout, norm_first)
for _ in range(n_layers)
]
)
self.final_norm = nn.LayerNorm(d_model) if norm_first else nn.Identity()
self.reset_parameters()
def reset_parameters(self) -> None:
for parameter in self.parameters():
if parameter.dim() > 1:
nn.init.xavier_uniform_(parameter)
with torch.no_grad():
self.embedding.weight[0].zero_()
def forward(
self,
token_ids: Tensor,
key_padding_mask: Tensor | None = None,
need_weights: bool = False,
) -> tuple[Tensor, list[Tensor]]:
x = self.embedding(token_ids) * math.sqrt(self.d_model)
x = self.position(x)
all_weights: list[Tensor] = []
for layer in self.layers:
x, weights = layer(x, key_padding_mask, need_weights)
if weights is not None:
all_weights.append(weights)
return self.final_norm(x), all_weights
class FirstLastMatchClassifier(nn.Module):
def __init__(self, vocab_size: int) -> None:
super().__init__()
self.encoder = TransformerEncoder(vocab_size=vocab_size)
self.classifier = nn.Linear(64, 2)
def forward(
self, token_ids: Tensor, key_padding_mask: Tensor | None = None
) -> Tensor:
encoded, _ = self.encoder(token_ids, key_padding_mask)
return self.classifier(encoded[:, 0])
def make_batch(
batch_size: int, sequence_length: int, vocab_size: int
) -> tuple[Tensor, Tensor]:
token_ids = torch.randint(1, vocab_size, (batch_size, sequence_length))
labels = torch.randint(0, 2, (batch_size,))
token_ids[labels == 1, -1] = token_ids[labels == 1, 0]
negative_rows = labels == 0
negative_last = torch.randint(1, vocab_size, (int(negative_rows.sum()),))
negative_first = token_ids[negative_rows, 0]
negative_last = torch.where(
negative_last == negative_first,
(negative_last % (vocab_size - 1)) + 1,
negative_last,
)
token_ids[negative_rows, -1] = negative_last
return token_ids, labels
def run_invariant_checks() -> None:
encoder = TransformerEncoder(vocab_size=32, dropout=0.0)
encoder.eval()
token_ids = torch.tensor([[1, 2, 3, 4, 0], [5, 6, 7, 0, 0]])
padding_mask = token_ids.eq(0)
encoded, weights = encoder(token_ids, padding_mask, need_weights=True)
assert encoded.shape == (2, 5, 64)
assert len(weights) == 2
assert weights[0].shape == (2, 4, 5, 5)
torch.testing.assert_close(
weights[0].sum(dim=-1), torch.ones_like(weights[0].sum(dim=-1))
)
masked_probability = weights[0].masked_select(
padding_mask[:, None, None, :].expand_as(weights[0])
)
assert torch.count_nonzero(masked_probability).item() == 0
print("invariant checks: passed")
def train_toy_task(steps: int, seed: int) -> None:
set_seed(seed)
vocab_size = 64
model = FirstLastMatchClassifier(vocab_size)
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)
loss_fn = nn.CrossEntropyLoss()
model.train()
for step in range(1, steps + 1):
token_ids, labels = make_batch(64, 12, vocab_size)
loss = loss_fn(model(token_ids), labels)
optimizer.zero_grad(set_to_none=True)
loss.backward()
optimizer.step()
if step == 1 or step % 20 == 0 or step == steps:
print(f"step={step:03d} loss={loss.item():.4f}")
def parse_args() -> argparse.Namespace:
parser = argparse.ArgumentParser()
parser.add_argument("--steps", type=int, default=80)
parser.add_argument("--seed", type=int, default=7)
parser.add_argument(
"--check-only",
action="store_true",
help="run shape and masking checks without training",
)
return parser.parse_args()
def main() -> None:
args = parse_args()
print(f"torch={torch.__version__}")
run_invariant_checks()
if not args.check_only:
train_toy_task(args.steps, args.seed)
if __name__ == "__main__":
main()