摘要
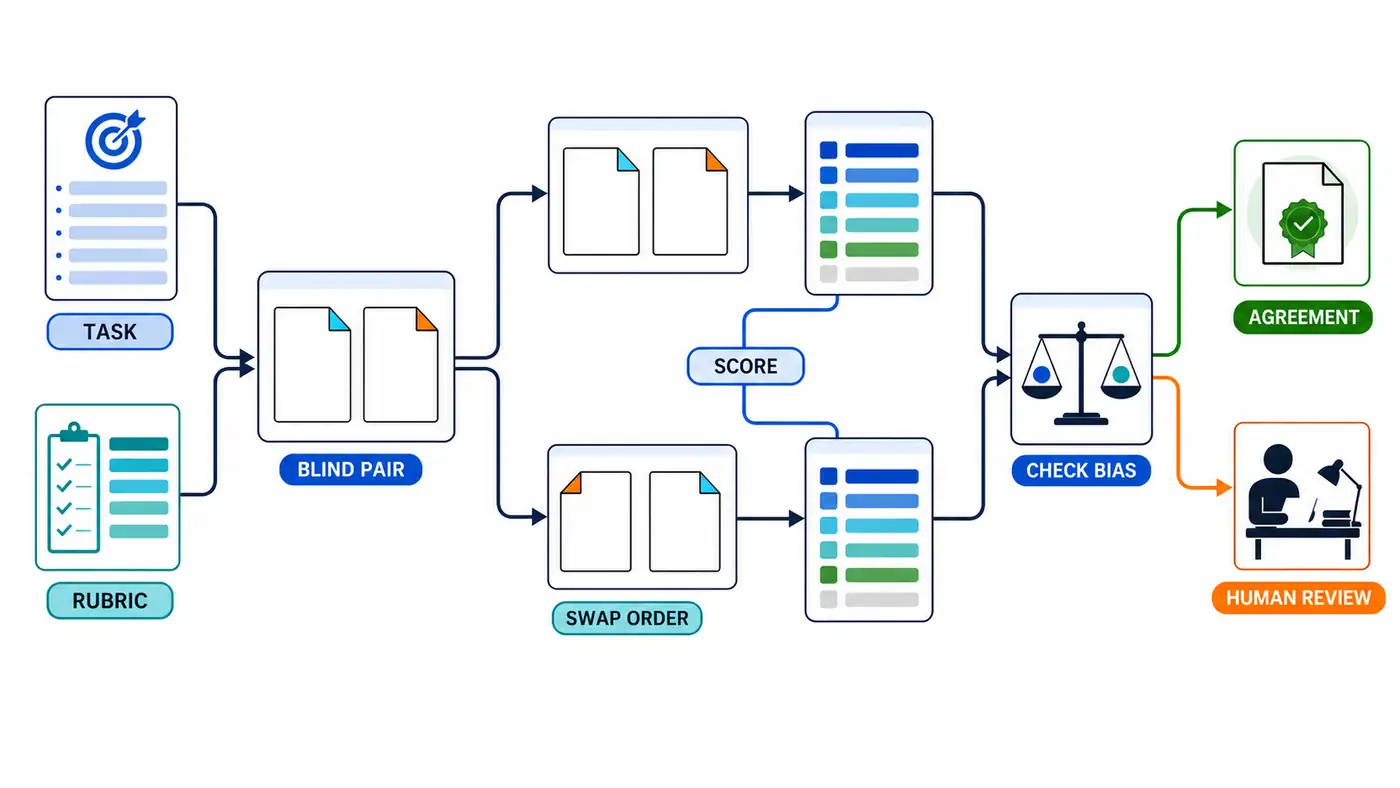
LLM-as-a-Judge(讓大語言模型充當評審器)適合評價開放式回答,因為它能讀取任務、候選答案和自然語言標準,再輸出分數、偏好與理由。但“裁判模型很強”不等於評測可靠:候選順序、回答長度、模型家族、提示詞措辭和評分刻度都可能改變結論。本文沿 MT-Bench/FastChat、G-Eval、FairEval、Prometheus 和 LLMBar 閱讀論文與官方代碼,建立一條可審計的最小協議:先寫任務特定 Rubric(評分規約),隱藏模型身份,對同一答案對做 A/B 與 B/A 兩次評審,把結果映射回答案身份,衝突時拒絕自動裁決,最後用人工標籤做元評測。附帶腳本實際驗證這些協議機制;它是合成特徵上的確定性模擬,不是任何 LLM、MT-Bench 或公開榜單成績。
復現價值與目標:評的不是答案,而是評測器
傳統準確率要求一個確定 gold answer;摘要、對話、代碼解釋和科研問答卻常有多種可接受表達。模型裁判把難以程序化的“相關、正確、清晰、遵循指令”轉成一次生成任務,成本通常低於逐條人工評審,還能給出理由。然而研究者真正需要回答的是二階問題:同一內容換位置後是否仍得同一結論;短而正確的答案會不會輸給冗長答案;Rubric 是否把抽象詞落實成可判邊界;裁判與人的一致,是穩定能力還是數據集、提示與模型版本的偶合。
本次最小復現不調用在線模型,也不復述動態排行榜。目標有四個:實現 pointwise(逐項打分)與 pairwise(成對比較)背後的數據結構;量化換序一致性;比較模糊“整體質量”與分維度 Rubric;展示自動拒判和異構評審面板怎樣改變覆蓋率與準確率。這樣先驗證評測協議,再替換為真實 judge API,能夠把“看起來合理的打分”變成可診斷實驗。
核心思想:Judge 是帶條件的測量函數
對任務 (x)、候選回答 (y)、可選參考答案 (z)、Rubric (r) 與提示模板 (p),逐項評分可寫成:
(J_\theta) 是版本固定的裁判模型, 包括採樣隨機性和服務端變化。若一個 batch 有 個樣本、Rubric 有 個維度,先得到評分矩陣 ,再用權重 聚合 。每個維度必須說明 1–5 分分別意味著什麼;只寫“helpfulness”而沒有錨點,並沒有定義可復現測量。
成對評審輸出 ,其中 是平局。由於輸入是有序序列,理論上交換答案再映射回應答身份應保持結論。定義:
(N) 是答案對數量, 與 分別來自兩種順序, 把槽位標籤轉回答案身份。 越低,位置擾動越能翻轉結果。穩健協議可以只在兩次判斷一致時自動接受;此時要同時報告 accepted accuracy 與 coverage,不能把拒判樣本悄悄刪掉後只報更高準確率。
論文與官方代碼閱讀路線
先讀 Zheng 等人的 MT-Bench/Chatbot Arena 論文。論文在開放式多輪對話上研究強模型充當裁判,報告 GPT-4 裁判與人類偏好的協議一致率超過 80%,同時專門分析位置、冗長、自我增強和推理能力邊界。這是論文特定數據、模型與 2023 年設置下的報告,不是任意新模型自動擁有的性質。
再順著 FastChat 官方倉庫讀代碼。data/judge_prompts.jsonl 的 pair-v2 先要求比較理由,再以 [[A]]、[[B]] 或 [[C]] 輸出裁決,並明確提醒不要受順序和長度影響;文字提醒本身不是消偏證據。gen_judgment.py 將一般題、需要參考答案的數學題、單輪與多輪拆成不同 judge 模板。最關鍵的是 common.py:play_a_match_pair() 對同一答案運行正序和反序兩次,映射回 model_1/model_2,並把兩次原始 prompt、judgment 和 winner 一併寫入 JSONL。真正復現時還應鎖定倉庫 commit、裁判模型快照和 API 參數,而不是隻記錄“用了 GPT-4”。
G-Eval 面向摘要與對話生成,把任務介紹、評價標準和自動生成的 evaluation steps 組成 form-filling 提示,並嘗試利用評分 token 的概率加權離散分數;論文報告其特定摘要實驗與人類分數相關性更高,也明確提醒裁判可能偏愛 LLM 生成文本。Prometheus 則把 reference answer 與細粒度 score rubric 放到開放 evaluator model 的輸入中,強調可控版本和定製標準。它們說明“給一個總分”不是唯一範式:任務、證據、維度與輸出格式必須顯式化。
最後看元評測。FairEval 直接顯示僅交換候選位置即可翻轉大量判斷,並提出多證據、平衡位置與人工介入校準。LLMBar 提供帶 gold preference 的自然與對抗答案對,測裁判能否識別真正遵循指令的輸出,而不是被表面質量迷惑。Judge 的評測集應獨立於被測模型的開發集;否則裁判 prompt 調到“更準”,也可能只是對元評測集過擬合。
最小實驗:換序不是數據增強,而是測量審計
運行:
python3 code/minimal_llm_judge.py --check-only
腳本僅用 Python 標準庫,固定種子 61,生成 120 個答案對。每個合成回答有 correctness、instruction following、evidence、clarity 四個 0–4 維度和 token 數;gold preference 由預先公開、正確性權重最高的 Rubric 決定,並刪除近似平局。模擬裁判加入位置偏置、長度偏置和由 SHA-256 鍵固定的噪聲,因此每次運行完全一致。
本次 CPU smoke test 中,模糊“整體質量”裁判在 AB/BA 順序的準確率分別為 0.700/0.742,換序一致性只有 0.642;只接受雙向一致的樣本後,覆蓋率為 0.642、準確率為 0.844。使用明確 Rubric 後,兩種順序準確率升到 0.850/0.867,雙向一致覆蓋率 0.717,接受子集準確率 1.000。三個具有不同偏置方向和噪聲的合成裁判做多數票,整體準確率為 1.000,全部裁判都換序穩定的比例為 0.967。
這些數字只證明腳本構造中的協議性質:Rubric 更接近生成 gold 的規則,雙向同意又主動拒絕難例,所以結果必然受益;它不能證明真實多裁判一定滿分,也不能外推到任何公開數據集。真正的研究結論必須換成凍結的模型輸出、獨立人工標籤和預註冊分析。
偏差地圖:先區分來源,才能設計對照
位置偏差指內容不變,僅改變前後槽位就改變偏好;最低成本檢查是雙向換序並報告衝突矩陣。冗長偏差指額外細節、重複和修辭被誤當成完整性;應構造“短而正確”對“長但含錯”的對照,並把簡潔度與事實性分開評分。自我增強偏差是裁判偏愛同源模型輸出;需要隱藏模型名,並讓不同家族裁判交叉評審。熟悉度與風格偏差會獎勵常見措辭、流暢英文或特定模板,跨語言、改寫和格式擾動是必要壓力測試。
還有三類常被誤稱為 bias 的失敗。第一是能力不足:裁判自己不會數學、代碼執行或領域知識;能用單元測試、參考答案、檢索證據解決時,不該強迫模型憑印象裁決。第二是 prompt sensitivity:維度順序、是否先解釋、輸出 token 形式都可能改變分佈。第三是汙染與洩漏:裁判見過 benchmark、參考答案或候選來源。它們都要求日誌化和對照,但因果機制不同,不能只用一句“LLM 有偏見”概括。
Rubric 設計:把價值判斷寫成可證偽規則
一個可用 Rubric 先寫任務目標,再列 3–5 個正交維度。事實問答可用正確性、證據覆蓋、指令遵循、清晰度;摘要還需忠實性與關鍵信息覆蓋。每個維度提供分數錨點和反例,例如“5 分:所有關鍵斷言可由給定證據支持;3 分:結論基本正確但遺漏一項關鍵約束;1 分:核心事實與證據衝突”。權重應在看結果前確定,並說明 fatal error:關鍵事實錯誤是否應蓋過文風優勢。
Pairwise 更容易回答“哪一個更好”,卻只給相對信息;pointwise 便於跨批次彙總,卻容易尺度漂移。穩妥做法是:先用 pointwise 維度生成可檢查理由,再做 pairwise 總裁決;對可程序化維度優先用規則執行器;對主觀維度保留平局與拒判。不要要求裁判暴露長篇隱式推理,只保存短證據摘錄、維度分數和結構化錯誤碼,既便於審計,也減少看似合理的事後辯護。
評測協議:同時報告效度、信度和成本
數據集先按任務、難度、語言、長度差和是否需要外部知識分層,答案身份盲化,順序隨機化;每對至少運行 AB/BA。信度報告換序一致性、重複採樣一致性、裁判間一致性,以及 Cohen’s : 是觀察一致率, 是按各自標籤邊際分佈偶然一致的期望。高一致不代表正確,兩個裁判可以穩定犯同一種錯,因此還要在獨立人工 gold 上報告準確率、混淆矩陣和分層誤差。
效度檢查裁判是否真的測到目標構念:給答案加入無關贅述、調換位置、改寫風格、插入模型名,正確結論應保持不變;刪除關鍵證據或製造事實矛盾,分數應下降。把自動接受、平局、解析失敗、換序衝突、人工升級分別計數;記錄 prompt hash、Rubric 版本、judge 版本、溫度、原始輸入輸出、token、延遲和費用。動態 API 與榜單會變,當前價格和排名均待人工核驗。
失敗分析與排查順序
若兩種順序頻繁衝突,先確認映射代碼沒有把槽位 A/B 當成模型身份,再查答案長度差、模板位置和結論 token 偏好;不要用隨機再跑一次掩蓋衝突。若所有分數擠在高分區,檢查錨點是否缺少低分樣例、提示是否把“友善”誤當“正確”,並查看每維邊際分佈。若與人工不一致,先複核人工 Rubric 和標註者協議,再按任務切片定位裁判不會的知識或推理類型。
若換一個 judge 排名就反轉,不應挑“最符合預期”的那個。可以使用異構 panel,但要公開每個裁判結果和聚合規則;多個同家族模型不等於獨立證據。若理由正確而最終標籤錯,檢查解析器、標籤映射和生成截斷。若理由流暢卻引用了候選中不存在的事實,應把 rationale fidelity 單獨抽檢,並把高風險樣本送人工。
後續科研問題
一是怎樣從 Rubric 自動生成最小對抗擾動,驗證每個維度的單調性;二是換序衝突、裁判分歧和語言模型置信度中,哪一個最能預測人工難例;三是怎樣估計 judge 與被測模型的家族依賴,而不洩露匿名;四是規則、檢索、執行器和 LLM 裁判如何按能力邊界組合;五是 panel 的多樣性應按模型家族、訓練數據還是錯誤相關性選擇;六是長期 benchmark 中如何檢測裁判版本漂移。一個可執行課題是凍結同一批答案,對 Rubric、順序、語言和 judge 家族做全因子實驗,公開原始裁決與人工複核集。
總結
LLM-as-a-Judge 的價值不是替代所有人工,而是把開放式評測擴展成可重複的候選測量。可靠性來自任務特定 Rubric、身份盲化、雙向換序、結構化輸出、獨立人工元評測、衝突拒判和完整日誌,而不是一句“請保持客觀”。先用本文腳本復現位置與長度偏差,再接真實裁判並凍結版本,才能知道分數變化來自被測模型,還是來自尺子本身。
參考資料
檢索日期:2026-09-02。以下均為論文、會議頁面或官方代碼;動態 API 行為、模型可用性與榜單待人工核驗。
- Lianmin Zheng 等,2023,Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena(NeurIPS Datasets and Benchmarks)
- LMSYS,FastChat LLM Judge 官方說明、
gen_judgment.py、common.py與 judge prompts - Yang Liu 等,2023,G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment(EMNLP)與官方代碼
- Peiyi Wang 等,2024,Large Language Models are not Fair Evaluators(ACL)與官方代碼
- Seungone Kim 等,2024,Prometheus: Inducing Fine-Grained Evaluation Capability in Language Models(ICLR)與官方代碼
- Zhiyuan Zeng 等,2024,Evaluating Large Language Models at Evaluating Instruction Following(LLMBar, ICLR)與官方代碼
- Pat Verga 等,2024,Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models(PoLL)
- Sijun Tan 等,2025,JudgeBench: A Benchmark for Evaluating LLM-Based Judges(ICLR / arXiv)與官方代碼