摘要
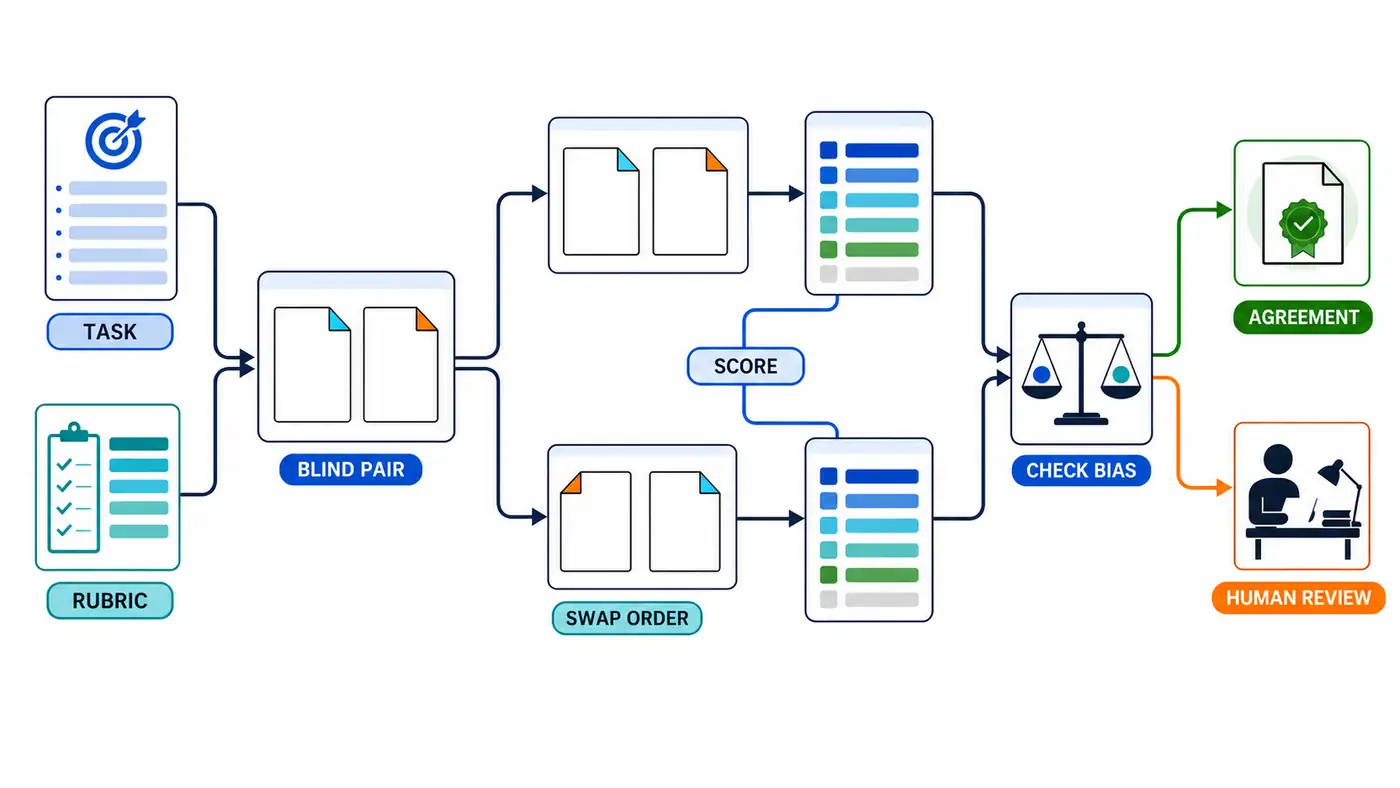
LLM-as-a-Judge(让大语言模型充当评审器)适合评价开放式回答,因为它能读取任务、候选答案和自然语言标准,再输出分数、偏好与理由。但“裁判模型很强”不等于评测可靠:候选顺序、回答长度、模型家族、提示词措辞和评分刻度都可能改变结论。本文沿 MT-Bench/FastChat、G-Eval、FairEval、Prometheus 和 LLMBar 阅读论文与官方代码,建立一条可审计的最小协议:先写任务特定 Rubric(评分规约),隐藏模型身份,对同一答案对做 A/B 与 B/A 两次评审,把结果映射回答案身份,冲突时拒绝自动裁决,最后用人工标签做元评测。附带脚本实际验证这些协议机制;它是合成特征上的确定性模拟,不是任何 LLM、MT-Bench 或公开榜单成绩。
复现价值与目标:评的不是答案,而是评测器
传统准确率要求一个确定 gold answer;摘要、对话、代码解释和科研问答却常有多种可接受表达。模型裁判把难以程序化的“相关、正确、清晰、遵循指令”转成一次生成任务,成本通常低于逐条人工评审,还能给出理由。然而研究者真正需要回答的是二阶问题:同一内容换位置后是否仍得同一结论;短而正确的答案会不会输给冗长答案;Rubric 是否把抽象词落实成可判边界;裁判与人的一致,是稳定能力还是数据集、提示与模型版本的偶合。
本次最小复现不调用在线模型,也不复述动态排行榜。目标有四个:实现 pointwise(逐项打分)与 pairwise(成对比较)背后的数据结构;量化换序一致性;比较模糊“整体质量”与分维度 Rubric;展示自动拒判和异构评审面板怎样改变覆盖率与准确率。这样先验证评测协议,再替换为真实 judge API,能够把“看起来合理的打分”变成可诊断实验。
核心思想:Judge 是带条件的测量函数
对任务 (x)、候选回答 (y)、可选参考答案 (z)、Rubric (r) 与提示模板 (p),逐项评分可写成:
s=Jθ(x,y,z,r,p;ξ)
(J_\theta) 是版本固定的裁判模型,ξ 包括采样随机性和服务端变化。若一个 batch 有 B 个样本、Rubric 有 K 个维度,先得到评分矩阵 V∈RB×K,再用权重 w∈RK 聚合 s=Vw。每个维度必须说明 1–5 分分别意味着什么;只写“helpfulness”而没有锚点,并没有定义可复现测量。
成对评审输出 d=Jθ(x,yA,yB,r,p)∈{A,B,T},其中 T 是平局。由于输入是有序序列,理论上交换答案再映射回应答身份应保持结论。定义:
Cswap=N1i=1∑N1[diAB=map(diBA)]
(N) 是答案对数量,diAB 与 diBA 分别来自两种顺序,map 把槽位标签转回答案身份。Cswap 越低,位置扰动越能翻转结果。稳健协议可以只在两次判断一致时自动接受;此时要同时报告 accepted accuracy 与 coverage,不能把拒判样本悄悄删掉后只报更高准确率。
论文与官方代码阅读路线
先读 Zheng 等人的 MT-Bench/Chatbot Arena 论文。论文在开放式多轮对话上研究强模型充当裁判,报告 GPT-4 裁判与人类偏好的协议一致率超过 80%,同时专门分析位置、冗长、自我增强和推理能力边界。这是论文特定数据、模型与 2023 年设置下的报告,不是任意新模型自动拥有的性质。
再顺着 FastChat 官方仓库读代码。data/judge_prompts.jsonl 的 pair-v2 先要求比较理由,再以 [[A]]、[[B]] 或 [[C]] 输出裁决,并明确提醒不要受顺序和长度影响;文字提醒本身不是消偏证据。gen_judgment.py 将一般题、需要参考答案的数学题、单轮与多轮拆成不同 judge 模板。最关键的是 common.py:play_a_match_pair() 对同一答案运行正序和反序两次,映射回 model_1/model_2,并把两次原始 prompt、judgment 和 winner 一并写入 JSONL。真正复现时还应锁定仓库 commit、裁判模型快照和 API 参数,而不是只记录“用了 GPT-4”。
G-Eval 面向摘要与对话生成,把任务介绍、评价标准和自动生成的 evaluation steps 组成 form-filling 提示,并尝试利用评分 token 的概率加权离散分数;论文报告其特定摘要实验与人类分数相关性更高,也明确提醒裁判可能偏爱 LLM 生成文本。Prometheus 则把 reference answer 与细粒度 score rubric 放到开放 evaluator model 的输入中,强调可控版本和定制标准。它们说明“给一个总分”不是唯一范式:任务、证据、维度与输出格式必须显式化。
最后看元评测。FairEval 直接显示仅交换候选位置即可翻转大量判断,并提出多证据、平衡位置与人工介入校准。LLMBar 提供带 gold preference 的自然与对抗答案对,测裁判能否识别真正遵循指令的输出,而不是被表面质量迷惑。Judge 的评测集应独立于被测模型的开发集;否则裁判 prompt 调到“更准”,也可能只是对元评测集过拟合。
最小实验:换序不是数据增强,而是测量审计
运行:
python3 code/minimal_llm_judge.py --check-only
脚本仅用 Python 标准库,固定种子 61,生成 120 个答案对。每个合成回答有 correctness、instruction following、evidence、clarity 四个 0–4 维度和 token 数;gold preference 由预先公开、正确性权重最高的 Rubric 决定,并删除近似平局。模拟裁判加入位置偏置、长度偏置和由 SHA-256 键固定的噪声,因此每次运行完全一致。
本次 CPU smoke test 中,模糊“整体质量”裁判在 AB/BA 顺序的准确率分别为 0.700/0.742,换序一致性只有 0.642;只接受双向一致的样本后,覆盖率为 0.642、准确率为 0.844。使用明确 Rubric 后,两种顺序准确率升到 0.850/0.867,双向一致覆盖率 0.717,接受子集准确率 1.000。三个具有不同偏置方向和噪声的合成裁判做多数票,整体准确率为 1.000,全部裁判都换序稳定的比例为 0.967。
这些数字只证明脚本构造中的协议性质:Rubric 更接近生成 gold 的规则,双向同意又主动拒绝难例,所以结果必然受益;它不能证明真实多裁判一定满分,也不能外推到任何公开数据集。真正的研究结论必须换成冻结的模型输出、独立人工标签和预注册分析。
偏差地图:先区分来源,才能设计对照
位置偏差指内容不变,仅改变前后槽位就改变偏好;最低成本检查是双向换序并报告冲突矩阵。冗长偏差指额外细节、重复和修辞被误当成完整性;应构造“短而正确”对“长但含错”的对照,并把简洁度与事实性分开评分。自我增强偏差是裁判偏爱同源模型输出;需要隐藏模型名,并让不同家族裁判交叉评审。熟悉度与风格偏差会奖励常见措辞、流畅英文或特定模板,跨语言、改写和格式扰动是必要压力测试。
还有三类常被误称为 bias 的失败。第一是能力不足:裁判自己不会数学、代码执行或领域知识;能用单元测试、参考答案、检索证据解决时,不该强迫模型凭印象裁决。第二是 prompt sensitivity:维度顺序、是否先解释、输出 token 形式都可能改变分布。第三是污染与泄漏:裁判见过 benchmark、参考答案或候选来源。它们都要求日志化和对照,但因果机制不同,不能只用一句“LLM 有偏见”概括。
Rubric 设计:把价值判断写成可证伪规则
一个可用 Rubric 先写任务目标,再列 3–5 个正交维度。事实问答可用正确性、证据覆盖、指令遵循、清晰度;摘要还需忠实性与关键信息覆盖。每个维度提供分数锚点和反例,例如“5 分:所有关键断言可由给定证据支持;3 分:结论基本正确但遗漏一项关键约束;1 分:核心事实与证据冲突”。权重应在看结果前确定,并说明 fatal error:关键事实错误是否应盖过文风优势。
Pairwise 更容易回答“哪一个更好”,却只给相对信息;pointwise 便于跨批次汇总,却容易尺度漂移。稳妥做法是:先用 pointwise 维度生成可检查理由,再做 pairwise 总裁决;对可程序化维度优先用规则执行器;对主观维度保留平局与拒判。不要要求裁判暴露长篇隐式推理,只保存短证据摘录、维度分数和结构化错误码,既便于审计,也减少看似合理的事后辩护。
评测协议:同时报告效度、信度和成本
数据集先按任务、难度、语言、长度差和是否需要外部知识分层,答案身份盲化,顺序随机化;每对至少运行 AB/BA。信度报告换序一致性、重复采样一致性、裁判间一致性,以及 Cohen’s κ=(po−pe)/(1−pe):po 是观察一致率,pe 是按各自标签边际分布偶然一致的期望。高一致不代表正确,两个裁判可以稳定犯同一种错,因此还要在独立人工 gold 上报告准确率、混淆矩阵和分层误差。
效度检查裁判是否真的测到目标构念:给答案加入无关赘述、调换位置、改写风格、插入模型名,正确结论应保持不变;删除关键证据或制造事实矛盾,分数应下降。把自动接受、平局、解析失败、换序冲突、人工升级分别计数;记录 prompt hash、Rubric 版本、judge 版本、温度、原始输入输出、token、延迟和费用。动态 API 与榜单会变,当前价格和排名均待人工核验。
失败分析与排查顺序
若两种顺序频繁冲突,先确认映射代码没有把槽位 A/B 当成模型身份,再查答案长度差、模板位置和结论 token 偏好;不要用随机再跑一次掩盖冲突。若所有分数挤在高分区,检查锚点是否缺少低分样例、提示是否把“友善”误当“正确”,并查看每维边际分布。若与人工不一致,先复核人工 Rubric 和标注者协议,再按任务切片定位裁判不会的知识或推理类型。
若换一个 judge 排名就反转,不应挑“最符合预期”的那个。可以使用异构 panel,但要公开每个裁判结果和聚合规则;多个同家族模型不等于独立证据。若理由正确而最终标签错,检查解析器、标签映射和生成截断。若理由流畅却引用了候选中不存在的事实,应把 rationale fidelity 单独抽检,并把高风险样本送人工。
后续科研问题
一是怎样从 Rubric 自动生成最小对抗扰动,验证每个维度的单调性;二是换序冲突、裁判分歧和语言模型置信度中,哪一个最能预测人工难例;三是怎样估计 judge 与被测模型的家族依赖,而不泄露匿名;四是规则、检索、执行器和 LLM 裁判如何按能力边界组合;五是 panel 的多样性应按模型家族、训练数据还是错误相关性选择;六是长期 benchmark 中如何检测裁判版本漂移。一个可执行课题是冻结同一批答案,对 Rubric、顺序、语言和 judge 家族做全因子实验,公开原始裁决与人工复核集。
总结
LLM-as-a-Judge 的价值不是替代所有人工,而是把开放式评测扩展成可重复的候选测量。可靠性来自任务特定 Rubric、身份盲化、双向换序、结构化输出、独立人工元评测、冲突拒判和完整日志,而不是一句“请保持客观”。先用本文脚本复现位置与长度偏差,再接真实裁判并冻结版本,才能知道分数变化来自被测模型,还是来自尺子本身。
参考资料
检索日期:2026-09-02。以下均为论文、会议页面或官方代码;动态 API 行为、模型可用性与榜单待人工核验。
Companion Code
配套示例代码
与正文对应的教学示例。请先阅读运行说明,下载所需文件并保留目录结构;也可以展开源码对照阅读。
展开查看完整源码minimal_llm_judge.py · 208 行
#!/usr/bin/env python3
"""Deterministic protocol simulator for bias-audited pairwise judging.

This is not an LLM benchmark.  It exposes the mechanics of position/verbosity
bias, order swapping, rubric scoring, abstention, and panel aggregation with
synthetic answer features whose gold preference is known.
"""

from __future__ import annotations

import argparse
import hashlib
import random
from dataclasses import dataclass
from typing import Iterable, Sequence


SEED = 61


@dataclass(frozen=True)
class Answer:
    correctness: int
    instruction: int
    evidence: int
    clarity: int
    tokens: int


@dataclass(frozen=True)
class Pair:
    pair_id: str
    a: Answer
    b: Answer


@dataclass(frozen=True)
class Judge:
    name: str
    position_bias: float
    verbosity_bias: float
    noise: float


def rubric_score(answer: Answer) -> float:
    """Task-specific score; factual correctness is intentionally dominant."""
    return (
        0.45 * answer.correctness
        + 0.25 * answer.instruction
        + 0.20 * answer.evidence
        + 0.10 * answer.clarity
    )


def stable_noise(key: str, scale: float) -> float:
    digest = hashlib.sha256(key.encode("utf-8")).digest()
    unit = int.from_bytes(digest[:8], "big") / (2**64 - 1)
    return (2.0 * unit - 1.0) * scale


def make_pairs(n: int = 120) -> list[Pair]:
    rng = random.Random(SEED)
    pairs: list[Pair] = []
    while len(pairs) < n:
        answers = []
        for _ in range(2):
            answers.append(
                Answer(
                    correctness=rng.randint(0, 4),
                    instruction=rng.randint(0, 4),
                    evidence=rng.randint(0, 4),
                    clarity=rng.randint(0, 4),
                    tokens=rng.randint(40, 420),
                )
            )
        a, b = answers
        # Remove near-ties so the synthetic gold label is unambiguous.
        if abs(rubric_score(a) - rubric_score(b)) < 0.28:
            continue
        pairs.append(Pair(f"p{len(pairs):03d}", a, b))
    return pairs


def gold(pair: Pair) -> str:
    return "A" if rubric_score(pair.a) > rubric_score(pair.b) else "B"


def judge_once(pair: Pair, judge: Judge, order: str, rubric: bool) -> str:
    first, second = (pair.a, pair.b) if order == "AB" else (pair.b, pair.a)
    if rubric:
        first_score = rubric_score(first)
        second_score = rubric_score(second)
        length_weight = judge.verbosity_bias * 0.20
    else:
        # A vague "overall quality" score overweights polish and length.
        first_score = 0.55 * rubric_score(first) + 0.45 * first.clarity
        second_score = 0.55 * rubric_score(second) + 0.45 * second.clarity
        length_weight = judge.verbosity_bias

    first_score += length_weight * first.tokens / 420.0 + judge.position_bias
    second_score += length_weight * second.tokens / 420.0
    delta = first_score - second_score
    delta += stable_noise(f"{pair.pair_id}:{judge.name}:{order}:{rubric}", judge.noise)
    slot_winner = "FIRST" if delta > 0 else "SECOND"
    if order == "AB":
        return "A" if slot_winner == "FIRST" else "B"
    return "B" if slot_winner == "FIRST" else "A"


def accuracy(predictions: Sequence[str], labels: Sequence[str]) -> float:
    return sum(p == y for p, y in zip(predictions, labels)) / len(labels)


def evaluate_single(pairs: Sequence[Pair], judge: Judge, rubric: bool) -> dict[str, float]:
    labels = [gold(pair) for pair in pairs]
    ab = [judge_once(pair, judge, "AB", rubric) for pair in pairs]
    ba = [judge_once(pair, judge, "BA", rubric) for pair in pairs]
    consistent = [x == y for x, y in zip(ab, ba)]
    accepted = [x for x, ok in zip(ab, consistent) if ok]
    accepted_gold = [y for y, ok in zip(labels, consistent) if ok]
    return {
        "ab_accuracy": accuracy(ab, labels),
        "ba_accuracy": accuracy(ba, labels),
        "swap_consistency": sum(consistent) / len(consistent),
        "balanced_coverage": len(accepted) / len(pairs),
        "balanced_accuracy": accuracy(accepted, accepted_gold),
    }


def majority(votes: Iterable[str]) -> str:
    votes = list(votes)
    return "A" if votes.count("A") > votes.count("B") else "B"


def evaluate_panel(pairs: Sequence[Pair], judges: Sequence[Judge]) -> dict[str, float]:
    labels = [gold(pair) for pair in pairs]
    predictions: list[str] = []
    unanimous_order_stable = 0
    for pair in pairs:
        per_judge = []
        stable = True
        for judge in judges:
            ab = judge_once(pair, judge, "AB", rubric=True)
            ba = judge_once(pair, judge, "BA", rubric=True)
            per_judge.append(ab if ab == ba else majority([ab, ba]))
            stable &= ab == ba
        predictions.append(majority(per_judge))
        unanimous_order_stable += stable
    return {
        "accuracy": accuracy(predictions, labels),
        "all_judges_swap_stable": unanimous_order_stable / len(pairs),
    }


def run_checks() -> None:
    pairs = make_pairs()
    biased = Judge("biased", position_bias=0.70, verbosity_bias=1.10, noise=0.22)
    generic = evaluate_single(pairs, biased, rubric=False)
    rubric = evaluate_single(pairs, biased, rubric=True)
    panel = evaluate_panel(
        pairs,
        [
            Judge("cyan", 0.26, 0.30, 0.18),
            Judge("amber", -0.18, 0.12, 0.24),
            Judge("green", 0.08, -0.05, 0.20),
        ],
    )

    print(f"seed={SEED} pairs={len(pairs)}")
    print(
        "generic "
        f"AB_acc={generic['ab_accuracy']:.3f} BA_acc={generic['ba_accuracy']:.3f} "
        f"swap_consistency={generic['swap_consistency']:.3f} "
        f"balanced_coverage={generic['balanced_coverage']:.3f} "
        f"balanced_acc={generic['balanced_accuracy']:.3f}"
    )
    print(
        "rubric  "
        f"AB_acc={rubric['ab_accuracy']:.3f} BA_acc={rubric['ba_accuracy']:.3f} "
        f"swap_consistency={rubric['swap_consistency']:.3f} "
        f"balanced_coverage={rubric['balanced_coverage']:.3f} "
        f"balanced_acc={rubric['balanced_accuracy']:.3f}"
    )
    print(
        "panel   "
        f"accuracy={panel['accuracy']:.3f} "
        f"all_judges_swap_stable={panel['all_judges_swap_stable']:.3f}"
    )

    assert generic["swap_consistency"] < 0.80
    assert rubric["balanced_accuracy"] >= rubric["ab_accuracy"]
    assert rubric["balanced_accuracy"] >= rubric["ba_accuracy"]
    assert rubric["balanced_accuracy"] > generic["balanced_accuracy"]
    assert panel["accuracy"] > generic["ab_accuracy"]
    print("checks=passed")


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--check-only", action="store_true", help="run deterministic assertions")
    args = parser.parse_args()
    if not args.check_only:
        parser.error("this teaching script only supports --check-only")
    run_checks()


if __name__ == "__main__":
    main()