日期:2026-08-19
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
檢索日期:2026-08-19
摘要
很多人讀 OpenReview 只看最終決定、分數和一句 meta-review,然後把結論簡化成“這篇被接收,所以質量高”或“這篇被拒,所以不值得讀”。這種讀法浪費了頂會開放評審系統裡最有價值的訓練材料:審稿人指出了哪些核心問題?作者 rebuttal 回答了哪些問題、迴避了哪些問題?評審是否在討論後改變判斷?AC 或 meta-review 又如何權衡貢獻、證據和風險?
本文討論如何把頂會論文的 reviews、rebuttal、discussion 和 meta-review 讀成一份“研究質量診斷報告”。目標不是學習如何討好審稿人,而是訓練科研判斷力:從審稿意見反推論文的真實貢獻、證據強度、可復現性、實驗缺口、寫作問題和後續選題空間。文章結合 ICLR 2026、ICML 2026、NeurIPS 2026 和 ACL Rolling Review 的官方流程說明,也參考 PeerRead、DISAPERE、NLPeer、PRISM、LimitGen、ICLR 2025 review feedback agent 和 AAAI-26 AI review pilot 等關於 peer review 的研究。易變化的流程、時間、政策和 AI 評審實踐,請以各會議官方頁面為準。
目錄
- 為什麼這個主題重要
- 先讀制度:不同會議的 rebuttal 不是一回事
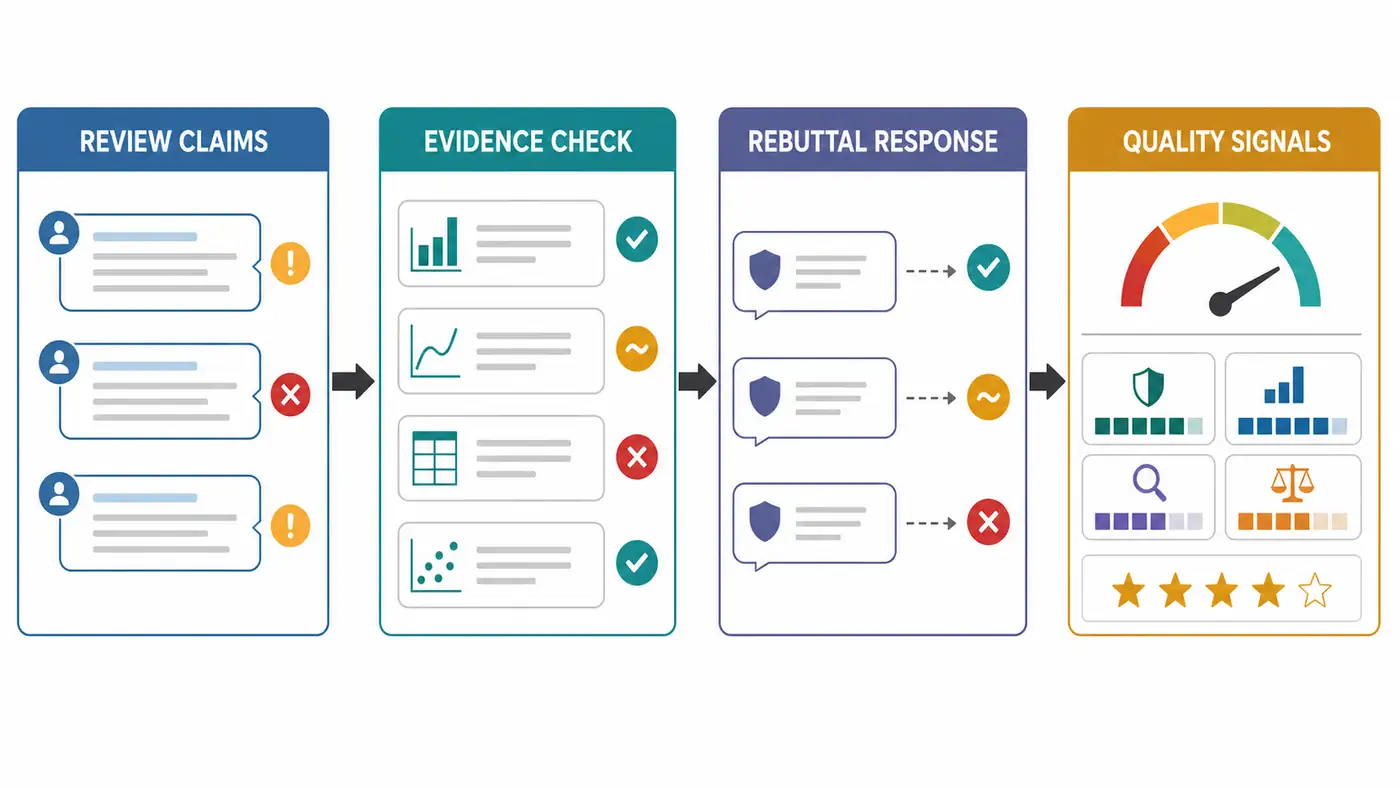
- 核心閱讀方法:四層證據鏈
- 代表資料路線圖
- 關鍵論文和項目精讀
- Review / rebuttal 質量信號表
- 復現訓練:如何做一份 review-reading report
- 常見誤區
- 適合研究生繼續做的選題
- 總結與參考資料
為什麼這個主題重要
頂會論文的正文通常是“作者希望你相信的版本”,而 review 和 rebuttal 展示的是“共同體如何檢驗這個版本”。一篇方法論文可能在摘要裡聲稱提出了新範式,但 reviewer 會追問:這個問題是否已經被前人做過?baseline 是否合理?ablation 是否隔離了核心變量?結果是否只來自更大模型、更長 prompt 或更貴推理?結論是否超出了實驗支持範圍?這些問題比最終 accept / reject 更能訓練研究者的眼睛。
對研究生來說,公開評審還有三個額外價值。第一,它暴露了論文寫作中的“失真點”:作者覺得清楚的動機,審稿人可能沒有讀懂;作者覺得充分的實驗,審稿人可能認為缺少統計顯著性或關鍵 baseline。第二,它讓你看到同一篇論文如何被不同專家從不同角度解讀:有人看 novelty,有人看 soundness,有人看 reproducibility,有人看 ethical risk。第三,它能幫助你發現 follow-up idea:一個嚴肅 review 裡沒有被 rebuttal 解決的核心問題,常常就是後續研究的入口。
2025-2026 年之後,這個主題更重要,因為評審流程本身正在變化。ICLR 2026 明確要求 reviewer 給出及時且實質性的 review,並要求 reviewer 披露 LLM 使用;ICML 2026 的 peer-review FAQ 規定每條官方 review 都可以有 rebuttal,且 reviewer 需要確認作者回復並在必要時更新 review;ACL Rolling Review 把 author response、review issue reporting、resubmission 和 commitment 拆成連續流程;NeurIPS 2026 reviewer guidelines 按貢獻類型解釋 quality、clarity、significance 和 originality。與此同時,ICLR 2025 試點了 LLM feedback agent,AAAI-26 報告了大規模 AI-assisted peer review,PRISM 和 LimitGen 則把“AI 能不能輔助評審”變成可評測問題。讀 review 已經不只是讀幾段匿名意見,而是在讀一個不斷制度化、數據化、自動化的科研評價系統。
先讀制度:不同會議的 rebuttal 不是一回事
讀 review 前先讀會議規則。否則你會誤解 rebuttal 的含義。
ICLR 是典型的 OpenReview 公開討論模式。ICLR 2026 Author Guide 顯示,2025 年 11 月 11 日 reviews 發佈後,11 月 11 日到 12 月 3 日是 public discussion period,作者可以在 OpenReview 上回復 reviews,也可以在討論期內修改論文;官方頁面還說明,若提交修訂版,會用 pdfdiff 比較原始提交和新版本,AC 與 reviewer 可以忽略與原稿差異過大的修改。對讀者來說,這意味著 ICLR rebuttal 不是單獨的一段短文,而是“review、作者回復、論文版本變化、reviewer 討論、最終 recommendation”的組合證據。
ICML 2026 的 Peer Review FAQ 更像結構化對話。官方說明作者可以對每條 official review 寫一條 response,每條有 5000 字符限制;reviewer 在作者回復後需要 acknowledge,並同意在必要時更新 review;後續 additional comments 和 final responses 也有相應限制。讀 ICML 的 rebuttal 時,應關注每個 reviewer 的問題是否被逐條回答,而不是隻看作者是否寫了一篇總回應。
ARR 的目標又不同。ACL Rolling Review 作者指南強調,ARR 是 reviewing platform,reviewer 不直接做接收或拒稿決定;author response 的主要作用更偏向澄清誤解、指出事實錯誤、為下一輪修改提供依據。ARR 還提供 review issue reporting,用於向 AC 報告具體的 review 質量問題。讀 ARR review 時,不能簡單套用會議 rebuttal 的“說服審稿人改分”邏輯,而要把它看作一輪可迭代研究診斷。
NeurIPS 2026 Reviewer Guidelines 則提醒我們:不同 contribution type 的評價標準不同。General、Theory、Use-Inspired、Concept & Feasibility、Negative Results 不應被同一套 SOTA 競賽邏輯評估。尤其是 negative results,官方指南強調它需要 grounded analysis,而不是簡單報告一次失敗實驗。讀 NeurIPS review 時,第一步應核對 reviewer 是否按論文自選貢獻類型評估,而不是要求所有論文都提供同一種實驗。
核心閱讀方法:四層證據鏈
第一層,拆 review claim。把每條審稿意見分成 claim,而不是按 reviewer 分組。例如“novelty 不足”“baseline 缺失”“實驗不公平”“理論假設過強”“結果不可復現”“寫作不清楚”“倫理風險沒有處理”。每個 claim 都要標註類型:事實性、方法性、實驗性、表達性、主觀偏好、流程性。事實性 claim 可以查證,主觀偏好需要看是否有理由,流程性問題要對照會議規則。
第二層,做 evidence check。對每個 claim 回到論文正文、 appendix、代碼、數據和相關工作中找證據。一個合格的 review 不只是說“缺少 novelty”,而應該指出與哪篇工作相似、差異在哪裡不清楚;不只是說“實驗弱”,而應該指出缺哪個 baseline、哪個 dataset、哪個 metric、哪個 ablation 或哪種統計說明。讀者要訓練自己判斷:reviewer 是在提供證據,還是在使用未經論證的口頭禪。
第三層,讀 rebuttal response。好 rebuttal 通常有三類動作:澄清誤解、補充證據、承諾合理修改。弱 rebuttal 則常見四種問題:只說“我們會補充”但不給具體結果;迴避最核心的 baseline 或假設問題;用更多修辭替代實驗;把所有批評都歸結為 reviewer 沒讀懂。不要只看 rebuttal 是否禮貌,要看它是否降低了不確定性。
第四層,讀 quality signals。最終判斷不來自單個 reviewer 分數,而來自整個討論後的信號:多個 reviewer 是否獨立指出同一核心問題?作者是否用證據解決了高優先級問題?reviewer 是否承認澄清有效?AC 是否明確說明接受或拒絕的主因?meta-review 是否只是平均分數,還是區分了貢獻、證據、風險和可修復問題?如果一篇論文被接收但 review 中仍有未解決的復現缺口,你可以讀,但不要無條件繼承其結論;如果一篇論文被拒但 review 承認問題重要、方法有潛力、主要缺陷可修復,它反而可能是很好的 follow-up 訓練材料。
代表資料路線圖
第一組是官方流程資料:ICLR 2026 Author Guide 與 Reviewer Guide、ICML 2026 Peer Review FAQ、NeurIPS 2026 Reviewing Guidelines、NeurIPS 2026 Evaluations & Datasets Reviewing Guidelines、ACL Rolling Review Authors Guidelines 與 Reviewer Guidelines。這些資料定義了你讀 review 時的“制度上下文”:誰能回覆、何時回覆、reviewer 是否必須更新、AC 如何看待 reported issue、LLM 使用是否允許、不同貢獻類型如何評價。
第二組是 peer-review 數據集:PeerRead 是較早的公開 peer review 數據集,覆蓋 ACL、NIPS、ICLR 等 venue 的論文、review 和 accept/reject 信息;DISAPERE 標註 review-rebuttal pairs 中的 discourse structure,幫助研究者分析 rebuttal 如何回應 review argument;NLPeer 進一步整合多領域論文、review、版本和元數據,並強調倫理授權和統一表示。它們適合訓練“從 review 文本抽取結構化問題”的方法。
第三組是 rebuttal 研究。Journal of Informetrics 2023 的 “What makes a successful rebuttal in computer science conferences?” 使用 ICLR 2022 的開放評審數據,把 rebuttal 階段視作作者與 reviewer 的社會互動,並分析 score change、reviewer social effect 和 rebuttal strategy。它提醒我們:rebuttal 不只是文本質量問題,也受 reviewer 之間互動、初始立場和討論結構影響。
第四組是 AI-assisted peer review。ICLR 2025 的 review feedback agent 是一個重要案例:官方博客報告稱,該系統向部分 review 提供可選反饋,目標是提升 review 的信息量、清晰度和可行動性,而不是直接改變論文接收結果。AAAI-26 AI Review Pilot 報告了面向 AAAI-26 main-track submissions 的大規模 AI review 部署。PRISM 提出多維 benchmark 評估 LLM peer reviewers,強調 depth、novelty、flaw identification 和 constructiveness;LimitGen 則專門評估 LLM 識別 scientific limitations 的能力。這些工作可以作為研究材料,但由於 AI 評審政策、系統實現和會議實踐變化很快,所有結論都應標註檢索日期並保留人工核驗。
關鍵論文和項目精讀
PeerRead 的價值在於它把 review 當成可研究對象,而不是隻把論文正文當成文本。讀 PeerRead 時,不要只關注 acceptance prediction,因為那容易誘導“用文本預測命運”的狹窄目標。更有價值的問題是:review 的哪些語言信號對應 novelty、impact、clarity 和 soundness?不同 venue 的 review form 如何影響 reviewer 寫作?如果你想做 review-reading report,可以借鑑它的數據組織方式,把 paper、review、score、decision 放在同一個樣本里。
DISAPERE 更適合訓練 rebuttal 分析。它關注 review 與 rebuttal 句子之間的關係,包括 reviewer 提出的論點、作者的 stance、回應是否直接相關。讀這篇時要特別留意一個方法論點:rebuttal 質量不是“寫得長”或“態度強硬”,而是能否定位 review argument 並給出可驗證回應。你可以把這個思想遷移到日常讀論文:每條 rebuttal 都問一句,它回答的是 reviewer 的哪一個 claim?
NLPeer 的貢獻在於統一資源和倫理數據收集。它不只是多放了一些 review,而是引入 parsed paper representation、metadata、versioning 等結構。這對研究復現很重要:如果你想比較 submission version 和 camera-ready version,或分析作者是否根據 review 修改了論文,需要版本信息,而不是隻有最終 PDF。NLPeer GitHub 還提示數據用途是幫助 junior reviewers 提升 review 質量,並反對 reviewer profiling;這也是做 peer-review 研究時需要遵守的邊界。
ICLR 2025 review feedback agent 和 AAAI-26 AI review pilot 則提供了新的問題:當 AI 開始影響 review 生產過程,我們怎樣判斷 review 的可信度?ICLR 2025 官方博客強調系統只是給 reviewer 提供反饋,reviewer 可以忽略或修改,最終沒有直接改變論文接收結果。AAAI-26 arXiv 報告聲稱所有 main-track full-review papers 都收到明確標識的 AI review,並報告作者和程序委員會成員對 AI review 的有用性評價。讀這些材料時,應區分三件事:AI 能否指出真實問題,AI 反饋是否改善人類 review,AI 是否應參與正式決策。這三件事不能互相替代。
PRISM 和 LimitGen 是更接近“科研訓練”的材料。PRISM 認為單一 LLM-as-judge 分數會混合 fluency 和 rigor,因此拆成多個維度,並用 argument mining、retrieval-augmented verification 和 consensus scoring 來評估 review。LimitGen 則把 limitation identification 獨立出來,強調用 prior literature grounding 來提高反饋具體性。對研究生來說,它們的啟發是:當你讀 review 時,也要把“有道理”“有證據”“可執行”“優先級高”分開打分。
Review / rebuttal 質量信號表
| 觀察對象 | 高質量信號 | 風險信號 | 讀者動作 |
|---|---|---|---|
| Review summary | 準確複述問題、方法和貢獻邊界 | summary 與論文核心不符 | 先判斷 reviewer 是否讀懂 |
| Novelty criticism | 指出具體相似工作和差異缺口 | 只說 incremental / not novel | 回查 related work |
| Soundness criticism | 說明假設、推導、實驗或 metric 的具體漏洞 | 只有籠統不信任 | 標註為待證實 claim |
| Baseline criticism | 指出缺失 baseline 及其必要性 | 要求不相關或不可行 baseline | 判斷是否影響核心結論 |
| Reproducibility criticism | 問 seed、超參、數據版本、代碼、統計顯著性 | 只要求更多細節但無優先級 | 轉成復現 checklist |
| Rebuttal | 逐條回應、給出新證據、承認可修問題 | 迴避核心問題、堆砌承諾、請求改分 | 看不確定性是否下降 |
| Reviewer update | 明確說明哪些回應改變或未改變判斷 | 沒看 rebuttal 或無理由維持分數 | 結合 AC / meta-review 判斷 |
| Meta-review | 權衡貢獻、證據、缺陷可修性 | 只平均分數或複述 review | 記錄最終決策邏輯 |
一個簡單規則是:強論文不等於沒有 criticism,而是 critical criticism 可定位、可回應、不會推翻核心貢獻。弱論文也不等於分數低,而是作者和 reviewer 在討論後仍無法明確核心 claim 是否成立。
復現訓練:如何做一份 review-reading report
選擇一篇有公開 review 的 ICLR、ICML、NeurIPS 或 ACL / ARR 論文,最好選擇你研究方向內、且 review 分歧明顯的論文。不要一開始就選 best paper;分歧樣本更能訓練判斷。
第一步,建立材料包:submission PDF、supplement、代碼或項目頁、reviews、rebuttal、discussion、meta-review、final decision、camera-ready version。記錄檢索日期和 OpenReview / Anthology / proceedings 鏈接。如果 reviewer 或作者在討論中提到新實驗、匿名代碼、外部 benchmark,要標註是否還能訪問。
第二步,抽取 review claims。建議做一張表:claim id、reviewer、原始意見簡述、問題類型、證據位置、嚴重程度、是否被其他 reviewer 復現、是否被 rebuttal 回應、回應是否充分。嚴重程度不要按語氣判斷,而按它是否影響主結論判斷。
第三步,做 evidence audit。對每個高嚴重 claim,回到正文查證。比如 reviewer 說缺少 baseline,你要查是否真的缺少,以及該 baseline 是否在該任務中標準;reviewer 說方法只是已有方法組合,你要查相關論文;reviewer 說數據洩漏,你要查 dataset split 和去重說明。無法判斷時寫“待人工核驗”,不要用直覺替代證據。
第四步,評估 rebuttal。把 rebuttal 分成三類:resolved、partially resolved、unresolved。resolved 表示作者給出證據後,合理讀者的不確定性顯著下降;partially resolved 表示澄清了局部問題但核心實驗仍缺;unresolved 表示作者沒有回答、證據不足或需要新增實驗。不要把“作者解釋得很自信”當成 resolved。
第五步,寫質量結論。結論可以分四段:論文的真實貢獻是什麼;最強證據是什麼;最大未解決風險是什麼;如果你要基於它做 follow-up,最可靠的小問題是什麼。這樣寫出來的 report 比“論文精讀筆記”更接近科研訓練,因為它包含外部審查和證據再評估。
常見誤區
誤區一,把分數當質量。分數是信號,不是證據。分數受 reviewer calibration、領域偏好、貢獻類型、討論參與度和會議政策影響。尤其在 open review 中,分數變化本身也需要解釋:是作者補充了關鍵證據,還是 reviewer 被說服,還是 AC 重新權衡?
誤區二,把 reviewer 都當權威。好的 reviewer 會給出可檢查證據;差 review 可能使用 lazy heuristics,例如“不夠 SOTA”“太簡單”“不驚人”,卻沒有說明為什麼這些問題推翻論文貢獻。ACL 2023 peer review report 和 ARR issue-reporting 機制都說明,review quality 本身也需要被評估。
誤區三,把 rebuttal 當辯論賽。ARR 作者指南明確提醒,author response 的目標是澄清誤解和處理關鍵問題,反覆爭論強烈主觀看法通常無益。科研讀者也應如此:你不是要判斷誰贏了,而是要判斷哪些 claim 被證據解決。
誤區四,只讀 accepted papers。被拒論文的 review 往往更有訓練價值,因為 reviewer 會更明確地指出為什麼證據鏈斷裂。很多被拒工作的 idea 仍然重要,只是實驗、表達或定位尚未達到頂會標準。
誤區五,無條件信任 AI-generated review。2025-2026 年關於 AI peer review 的研究很活躍,但不同系統、不同任務和不同政策之間不能直接類比。PRISM 強調 LLM reviewer 可能在某些維度強、在另一些維度弱;ACL reviewer guidelines 對生成式 AI 使用也強調保密、責任和披露。把 AI review 當輔助線索可以,把它當最終判斷不行。
適合研究生繼續做的選題
構建一個 review claim taxonomy:收集 100 篇 ICLR 或 ARR 論文的 reviews,把 criticism 分成 novelty、soundness、baseline、ablation、clarity、reproducibility、ethics 等類別,分析哪些類別最常導致最終負面判斷。
研究 rebuttal 的證據類型:比較 accepted 與 rejected papers 中 rebuttal 使用的證據,包括新增實驗、補充引用、澄清定義、承認限制、承諾 camera-ready 修改。注意控制初始分數和領域。
做 review-to-revision diff 分析:使用 submission version 和 camera-ready version,分析作者實際改了什麼,哪些 review comments 被落實,哪些只在 rebuttal 中承諾但沒有進入論文。
評估 LLM 作為 review-reading assistant:不是讓 LLM 寫 review,而是讓它抽取 review claims、匹配論文證據、標註 unresolved issues,再由人類驗證準確率。數據可參考 NLPeer / DISAPERE 思路,但必須遵守數據許可和會議政策。
比較不同貢獻類型的評審標準:以 NeurIPS 2026 contribution types 為框架,研究 theory、negative results、use-inspired papers 的 review 中是否仍被不恰當地要求 SOTA benchmark。
總結
讀 rebuttal 和 peer review 的核心,不是學習“如何過審”,而是學習“共同體如何檢驗研究”。一個成熟讀者應能從 review 中抽取 claim,從 rebuttal 中判斷不確定性是否下降,從 meta-review 中理解決策權衡,並把未解決問題轉化為可執行的復現實驗或 follow-up idea。
下次讀一篇 OpenReview 論文時,不要從 final decision 開始。先讀論文摘要和方法,寫下你自己的疑問;再讀 reviews,看哪些疑問被 reviewer 捕捉;然後讀 rebuttal,看作者如何補證據;最後讀 meta-review,看 AC 如何權衡。這樣訓練一個月,你會逐漸形成比“看榜單”和“看標題”可靠得多的科研判斷力。
參考資料
檢索日期:2026-08-19。以下鏈接均為寫作時核對過的一手資料或研究資料;會議流程、政策、review form、AI 使用規定和 OpenReview 頁面會變化,投稿或引用前請重新核驗。
- ICLR 2026 Author Guide. https://iclr.cc/Conferences/2026/AuthorGuide
- ICLR 2026 Reviewer Guide. https://iclr.cc/Conferences/2026/ReviewerGuide
- ICML 2026 Peer Review FAQ. https://icml.cc/Conferences/2026/PeerReviewFAQ
- NeurIPS 2026 Reviewing Guidelines. https://neurips.cc/Conferences/2026/ReviewerGuidelines
- NeurIPS 2026 Evaluations & Datasets Reviewing Guidelines. https://neurips.cc/Conferences/2026/EvaluationsDatasetsReviewerGuidelines
- ACL Rolling Review Authors Guidelines. https://aclrollingreview.org/authors
- ACL Rolling Review Reviewer Guidelines. https://github.com/acl-org/aclrollingreview/blob/main/reviewerguidelines.md
- ACL 2023 Peer Review Report. https://2023.aclweb.org/blog/review-report/
- ACL 2023 Peer Review Policies. https://2023.aclweb.org/blog/review-acl23/
- Kang et al. A Dataset of Peer Reviews (PeerRead): Collection, Insights and NLP Applications. arXiv, 2018. https://arxiv.org/abs/1804.09635
- Kennard et al. DISAPERE: A Dataset for Discourse Structure in Peer Review Discussions. NAACL 2022. https://aclanthology.org/2022.naacl-main.89/
- Dycke, Kuznetsov, Gurevych. NLPeer: A Unified Resource for the Computational Study of Peer Review. ACL 2023. https://aclanthology.org/2023.acl-long.277/
- UKPLab NLPeer GitHub repository. https://github.com/UKPLab/nlpeer
- Huang et al. What makes a successful rebuttal in computer science conferences?: A perspective on social interaction. Journal of Informetrics, 2023. https://doi.org/10.1016/j.joi.2023.101427
- Liang et al. Can large language models provide useful feedback on research papers? A large-scale empirical analysis. arXiv, 2023. https://arxiv.org/abs/2310.01783
- ICLR Blog. Leveraging LLM feedback to enhance review quality. 2025. https://blog.iclr.cc/2025/04/15/leveraging-llm-feedback-to-enhance-review-quality/
- Biswas et al. AI-Assisted Peer Review at Scale: The AAAI-26 AI Review Pilot. arXiv, 2026. https://arxiv.org/abs/2604.13940
- Loc et al. PRISM: A Multi-Dimensional Benchmark for Evaluating LLM Peer Reviewers. arXiv, 2026. https://arxiv.org/abs/2605.26730
- PRISM Benchmark project page. https://prism-benchmark.github.io/
- Xu et al. Can LLMs Identify Critical Limitations within Scientific Research? A Systematic Evaluation on AI Research Papers. arXiv, 2025. https://arxiv.org/abs/2507.02694
- Rao et al. Detecting LLM-generated peer reviews. PLOS ONE, 2025. https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0331871