日期:2026-08-20
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
檢索日期:2026-08-20
摘要
很多研究生讀完十篇論文後,得到的不是一個研究 proposal,而是一份更長的 related work:誰做了什麼、用了什麼模型、在哪些 benchmark 上更好。問題在於,proposal 不是文獻綜述的自然延長線。它需要把論文壓縮成一個可回答的問題、一個可被證偽的假設、一組有因果指向的方法選擇,以及一套資源可承受的實驗計劃。
本文給出一個面向 AI 研究訓練的工作流:如何從 10 篇論文出發,畫出問題地圖,構造 gap matrix,篩選研究假設,設計最小實驗計劃,最後寫成 2-4 頁 pre-proposal。文章參考了 DARPA Heilmeier Catechism、NSF proposal preparation guidance、ICLR 2026 author guidance,也結合 2025-2026 年關於 LLM research ideation、AI Scientist、PaperBench、LiveIdeaBench、InciteResearch 和 proposal writing 的最新資料。重點不是讓 LLM 替你“生成選題”,而是訓練你把論文讀成研究決策。
目錄
- 為什麼這個主題重要
- 10 篇論文不是數量要求,而是證據邊界
- 核心流程:從 paper set 到 proposal
- 代表論文與資料路線圖
- 關鍵論文精讀:AI 能幫到哪裡,幫不到哪裡
- Gap Matrix:把閱讀筆記變成研究判斷
- Proposal 草稿結構
- 復現與預實驗建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結與參考資料
為什麼這個主題重要
論文精讀訓練的終點不是“我知道這個方向有哪些工作”,而是“我能提出一個小而清楚、可被檢驗、可在現有資源下執行的問題”。這正是從閱讀者轉向研究者的關鍵臺階。
在 AI 方向,這個臺階尤其難。第一,論文更新太快。一個 proposal 如果只停留在“改進某個 2024 baseline”,可能在開題前就被 2025-2026 的模型或 benchmark 吞掉。第二,很多論文把貢獻包裝成系統工程:數據、模型、prompt、後處理、訓練 recipe 和評測策略糾纏在一起,讀者很難判斷真正有效的變量。第三,LLM 已經開始參與文獻檢索、idea generation、proposal writing 和實驗執行,但最新研究也反覆提醒我們:模型能給出看似合理的 idea,卻容易在可行性、引用準確性、多樣性和真實執行上出問題。
DARPA 的 Heilmeier Catechism 很適合作為 proposal 的最低門檻:你要做什麼?今天怎麼做,限制在哪裡?你的新方法是什麼,為什麼可能成功?誰在乎?風險、成本、時間和中期/最終驗收是什麼?NSF 的 proposal guidance 也把核心問題壓縮成類似結構:想做什麼,為什麼做,如何做,如何知道成功,以及成功後有什麼價值。對研究生來說,這些問題比“標題是否酷”“模型是否新”更重要。
10 篇論文不是數量要求,而是證據邊界
“從 10 篇論文形成 proposal”不等於隨機讀 10 篇。更好的構成是:
- 2 篇奠基論文:定義任務、範式或核心假設。
- 3 篇最近強 baseline:代表當前主流做法,優先選 2025-2026 年或仍被當前工作使用的技術報告。
- 2 篇反例或負結果:指出 benchmark、復現、泛化或機制解釋的問題。
- 2 篇鄰近分支:提供可遷移方法,但不是同一套路的簡單堆疊。
- 1 篇綜述、系統論文或 benchmark 論文:幫助你理解評價邊界。
這 10 篇論文的目的不是覆蓋所有相關工作,而是建立一個“足夠做判斷”的證據邊界。讀完後,你應該能回答四個問題:這個方向的核心變量是什麼?哪些結論已經被反覆驗證?哪些結論只在狹窄設置中成立?如果我只能做一個月預實驗,最值得檢驗的缺口是什麼?
如果十篇論文全是同一實驗套路的 SOTA paper,你很容易得到一個平庸 proposal:換模型、換數據、換 loss、再跑一次 leaderboard。真正有訓練價值的 paper set 應該包含張力:一個方法聲稱有效,另一個復現研究質疑它;一個 benchmark 流行,另一個 contamination 或 leakage 分析指出風險;一個 agent 框架自動生成實驗,另一個評測顯示 agent 仍遠低於人類復現能力。
核心流程:從 paper set 到 proposal
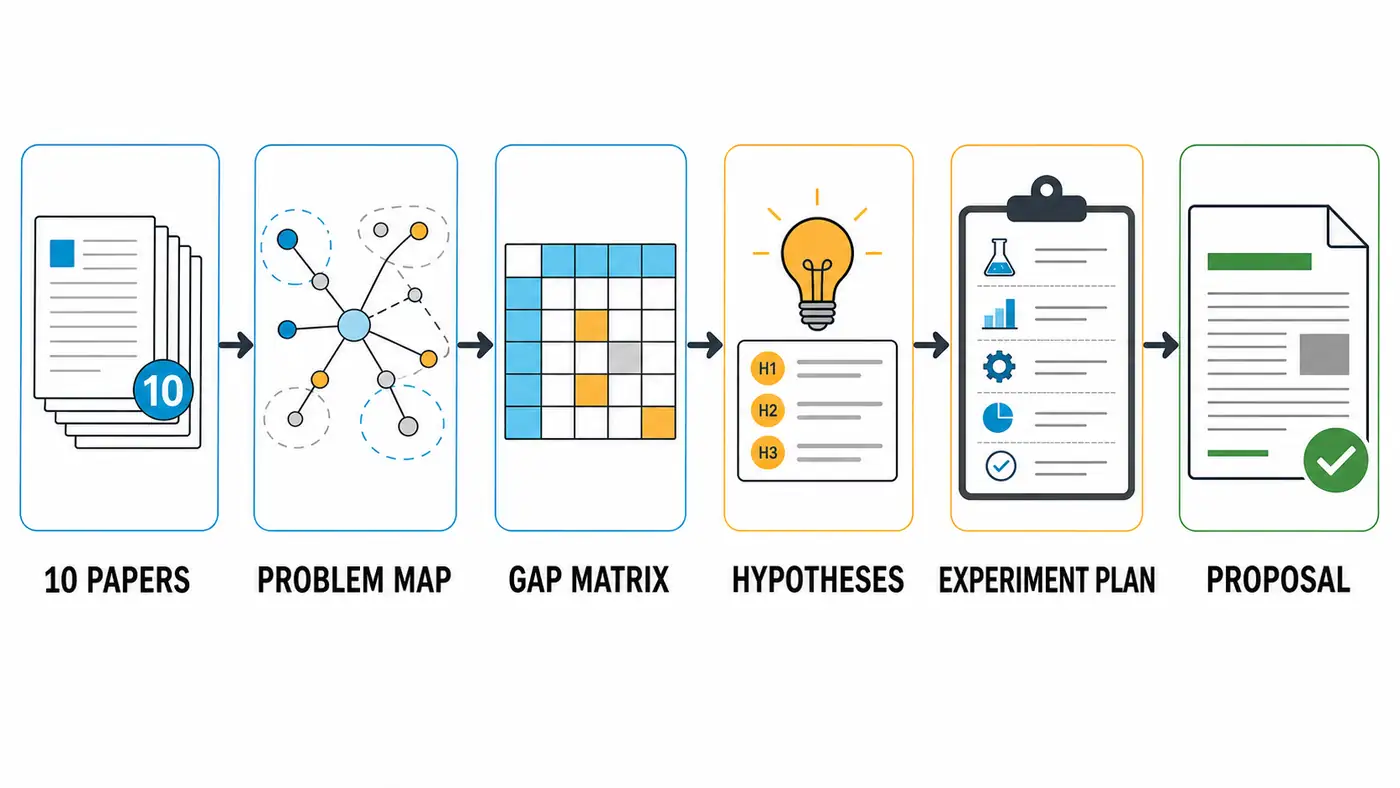
第一步,做 problem map。不要先按論文時間線排,而要按“它們認為問題在哪裡”排。每篇論文都填三句話:它要解決的失敗模式是什麼?它把失敗歸因於什麼變量?它認為成功應該如何測量?例如在 LLM research ideation 方向,有的論文把問題定義為 novelty,有的定義為 feasibility,有的定義為 groundedness,有的定義為執行成功率。它們表面上都在做“生成研究想法”,但問題定義並不相同。
第二步,做 claim extraction。把每篇論文的核心 claim 寫成可驗證句子,而不是摘要句。錯誤寫法是“提出一個自動科研系統”。更好的寫法是“在給定模板和代碼庫的條件下,系統能完成 idea generation、實驗迭代、寫作和自動 review,但產出論文仍存在解釋和可靠性問題”。claim 一旦被寫成可驗證句子,就能進入下一步比較。
第三步,做 gap matrix。行是論文或方法,列是問題定義、假設、數據/任務、模型規模、實驗變量、metric、baseline、復現材料、失敗案例、外部有效性。你要找的 gap 不是“沒人做過 X”,而是“現有證據不能支持某個重要判斷”。比如:idea generation 論文可能證明生成 idea 新穎,但沒有證明它們能被低成本實驗驗證;proposal writing 論文可能改進文本質量,卻仍要單獨核查 reference validity;PaperBench 顯示 AI agent 復現複雜 AI 論文仍困難,這會限制全自動 proposal-to-paper 系統的現實可信度。
第四步,生成 3 個候選假設。每個假設都必須包含方向、機制和可證偽條件。弱假設是“加入檢索會提升研究 proposal 質量”。強假設是“在從 10 篇論文生成 AI research proposal 的任務中,把文獻證據顯式壓縮為 gap matrix,比直接 RAG 生成 proposal 更能提升 feasibility 和 reference validity;若人工評審或執行預實驗未顯示顯著差異,則假設不成立。”
第五步,設計最小實驗計劃。proposal 不是要把所有實驗列滿,而是要證明你知道第一塊證據應該怎麼拿。最小實驗通常包括一個主對比、一個 ablation、一個失敗案例分析和一個人工核驗環節。對於 AI 論文訓練,尤其要寫清楚 seed、數據版本、模型版本、prompt、推理預算、評分規則和日誌保存方式。
第六步,寫 pre-proposal。先寫 2-4 頁,不要直接寫 15 頁。順序是:問題、已有證據、核心 gap、假設、方法、實驗、風險、時間表。只要這幾頁講不清,長 proposal 只會把問題藏起來。
代表論文與資料路線圖
| 類別 | 代表資料 | 對 proposal 訓練的啟發 |
|---|---|---|
| Proposal 判斷框架 | DARPA Heilmeier Catechism;NSF Preparing Your Proposal | 把選題壓成目標、現狀、創新、價值、風險、成本、驗收 |
| 頂會寫作規範 | ICLR 2026 Author Guide;NeurIPS 2026 review guidance | 關注貢獻類型、可復現性、匿名代碼、倫理和實驗支撐 |
| AI research ideation | Si et al., ICLR 2025;Measuring the Gap Between Human and LLM Research Ideas, 2026 | LLM idea 可有新穎性,但 feasibility、diversity 和 human taste gap 需要單獨評估 |
| 自動科研系統 | The AI Scientist / AI Scientist-v2;PaperBench | 自動生成和復現仍受執行、代碼、實驗和評審可靠性約束 |
| Idea benchmark | LiveIdeaBench;InciteResearch / TF-Bench | 科學創意評價要拆成 originality、feasibility、flexibility、clarity 等維度 |
| Proposal writing | Assisting Research Proposal Writing with LLMs, 2025 | 文本質量和引用真實性應分開評估,迭代提示不能替代人工核驗 |
關鍵論文精讀:AI 能幫到哪裡,幫不到哪裡
Si、Yang 和 Hashimoto 的 ICLR 2025 研究是讀這個主題的入口。它招募 100 多位 NLP 研究者參與 idea 寫作與盲審,發現 LLM 生成 idea 在新穎性評價上可以超過人類專家,但可行性略弱,並暴露出 LLM self-evaluation 失敗和生成多樣性不足的問題。對 proposal 訓練的直接啟發是:不要把“新穎”當作唯一目標。一個研究生 proposal 如果只有 novelty,沒有可執行實驗和失敗標準,很容易變成漂亮但不可驗證的空想。
2026 年的 Measuring the Gap Between Human and LLM Research Ideas 更進一步。它不只評價單個 idea,而是比較人類論文與 LLM idea 的分佈差異。論文指出,LLM idea 往往更集中在 bridge-like opportunity 和 synthesis method 上,而人類研究 idea 的分佈更分散。這個結論對使用 LLM 輔助選題的人很重要:模型可能不斷給你“把 A 和 B 結合”的建議,但真正的研究機會也可能來自反常現象、測量缺口、負結果、機制解釋或約束條件變化。
The AI Scientist 和 AI Scientist-v2 展示了 agentic research pipeline 的可能性:生成假設、寫代碼、跑實驗、分析結果和寫論文。AI Scientist-v2 的 GitHub README 也明確提醒,系統會執行 LLM 寫出的代碼,需要在受控 sandbox 中運行,並且 v2 不一定比模板化 v1 產出更好,特別是在有強模板的任務上。這對 proposal 設計是一條硬約束:自動化可以幫助探索,但 proposal 仍要寫清楚哪些步驟由人核驗、哪些實驗可重複、哪些失敗會觸發 pivot。
PaperBench 則提供了冷靜的一面。OpenAI 在 2025 年發佈的 PaperBench 要求 agent 從零復現 20 篇 ICML 2024 Spotlight / Oral 論文,並用作者共同制定的層級 rubric 評分。公開結果顯示,當時最佳 tested agent 仍沒有超過人類基線。這裡不應只關注分數,而要學習它的 rubric 思想:一個 research plan 不能只寫“復現論文”,而要把復現拆成可評分任務,例如數據準備、模型實現、訓練目標、核心實驗、ablation、圖表和結論核驗。
LiveIdeaBench 和 InciteResearch 適合提醒我們:proposal 不是簡單的 convergent reasoning。LiveIdeaBench 用 originality、feasibility、fluency、flexibility 和 clarity 等維度衡量 scientific idea generation,說明科學創意與一般智能分數並不等價。InciteResearch 則強調許多研究起點並不是清楚問題,而是“隱性摩擦”:你覺得某個方向不對勁,但還說不出問題。這正是讀 10 篇論文的意義:不是馬上生成答案,而是把模糊不滿變成可檢查的研究問題。
最後,Assisting Research Proposal Writing with LLMs 直接討論 proposal writing。它把內容質量與 reference validity 分開評估,並用迭代 prompting 改善寫作質量、減少引用錯誤。這個設定很實用:當你用 LLM 輔助 proposal 草稿時,應至少保留兩張表,一張評估論證結構,一張逐條核查引用是否真實、是否支持對應句子。
Gap Matrix:把閱讀筆記變成研究判斷
下面是一個可直接複用的 gap matrix 模板。
| 字段 | 要填什麼 | 判斷標準 |
|---|---|---|
| Problem | 論文解決的具體失敗模式 | 是否比“大模型不夠好”更具體 |
| Assumption | 方法成立依賴的前提 | 是否能被實驗打破 |
| Intervention | 方法真正改變的變量 | 是否與工程細節混淆 |
| Evidence | 支持 claim 的證據 | 是否包含 baseline、ablation、統計或人工核驗 |
| Boundary | 證據適用邊界 | 是否說明數據、模型、任務和預算限制 |
| Missing | 仍未回答的問題 | 是否重要且可實驗 |
| Feasibility | 你能否在 2-4 周做預實驗 | 數據、算力、代碼、評測是否可得 |
| Proposal Hook | 可形成的研究假設 | 是否有機制和可證偽條件 |
完成矩陣後,不要急著選“最大”的 gap。研究生訓練更適合選擇“中等重要、低到中等成本、證據鏈清楚、能在一個月拿到預實驗結果”的 gap。一個小 proposal 的目標不是擊敗整個領域,而是建立一個能被導師、同學或 reviewer 認真討論的證據起點。
Proposal 草稿結構
建議先寫一頁版本:
- 標題:必須包含任務、變量和目標,不要只寫一個大方向。
- 問題:用 3-5 句話說明現有方法在哪個具體場景失敗。
- 文獻證據:列出 10 篇論文如何共同支持這個問題存在。
- 核心 gap:說明現有證據缺什麼,不要只說“尚未有人研究”。
- 假設:寫成可證偽句子。
- 方法:說明你改變哪個變量,以及為什麼這可能解決 gap。
- 實驗計劃:列 dataset、metric、baseline、ablation、人工核驗和日誌。
- 風險與替代計劃:寫清楚失敗後如何縮小問題或 pivot。
再擴成 2-4 頁版本時,可以增加 related work map、pilot experiment、timeline 和資源預算。參考 NSF 的思路,proposal 應該回答“想做什麼、為什麼做、如何做、如何知道成功”。參考 DARPA 的思路,還要回答“誰在乎、風險是什麼、階段性考試是什麼”。對於 AI 研究訓練,階段性考試可以很具體:兩週內復現 baseline;第三週完成主對比;第四周完成 ablation 和 error analysis;若主指標無提升,則轉向解釋失敗原因,而不是繼續堆技巧。
復現與預實驗建議
第一,先復現一個可信 baseline,而不是先實現你的新方法。baseline 復現失敗,通常說明環境、數據、metric 或理解存在問題。這個階段的日誌應該包含 commit、依賴版本、seed、模型 checkpoint、數據 hash、運行命令和異常記錄。
第二,把 proposal 的核心假設壓成最小干預。例如你的假設是“gap matrix improves proposal feasibility”,就不要同時換模型、換 prompt、換檢索庫、換評審標準。最小實驗可以是:同一組 10 篇論文、同一模型、同一輸出格式,對比 direct RAG proposal 與 gap-matrix-first proposal,再由人工 rubric 評估 specificity、feasibility、reference support 和 testability。
第三,保留負結果。很多 proposal 的真正價值不是“方法立刻有效”,而是發現現有 claim 的邊界。NeurIPS 2026 等會議已經在貢獻類型中給 negative results、concept & feasibility、evaluation analysis 留出空間;只要實驗設計嚴謹,負結果可以成為強選題。
第四,不要把 LLM judge 當最終證據。可以用 LLM 做初篩、結構檢查和引用提醒,但 reference validity、實驗可執行性和關鍵 claim 必須人工核驗。PaperBench 之所以有訓練價值,正是因為它把復現任務拆成層級 rubric,而不是隻問模型“這篇復現是否成功”。
常見誤區
誤區一:把 proposal 寫成 related work。Related work 解釋過去,proposal 必須押注未來的一個可驗證判斷。
誤區二:把 gap 理解成“沒人做過”。很多沒人做過的事是不重要、不可能、或做了也沒意義。更好的 gap 是“現有證據不足以支持一個重要 claim”。
誤區三:只追求 novelty。Si et al. 和後續 ideation 研究都提示,novelty 與 feasibility、diversity、execution success 不是一回事。
誤區四:實驗計劃過大。proposal 的第一階段不該依賴訓練 70B 模型或構建全新 benchmark。先證明關鍵變量值得研究。
誤區五:引用不核驗。LLM 生成的 proposal 文字越流暢,越容易掩蓋引用錯配。引用必須逐條對應 claim。
誤區六:沒有失敗標準。沒有失敗標準的 proposal 不是研究計劃,而是願望清單。
適合研究生繼續做的選題
- Gap-matrix-first proposal writing:比較結構化 gap matrix 與直接 RAG 對 proposal 可行性、引用準確性和可測試性的影響。
- Research idea diversity audit:復現 Measuring the Gap Between Human and LLM Research Ideas 的思想,在某個 AI 子領域分析 LLM idea 是否過度偏向“方法融合”。
- Proposal reference validity benchmark:構建小型中文/英文 AI proposal 數據集,評估 LLM 是否引用真實論文、引用是否支持對應論斷。
- PaperBench-style proposal rubric:把一篇 proposal 拆成可評分任務,研究這種 rubric 是否提升導師反饋質量。
- Negative-result-driven proposal mining:從復現失敗、benchmark 陷阱和 ablation 負結果中自動提取可執行 follow-up idea。
- Human-AI proposal co-writing protocol:設計一個流程,明確哪些步驟由 LLM 輔助,哪些步驟必須由人類研究者核驗。
總結
從 10 篇論文到 proposal 的核心,不是“讀得越多越好”,而是把文獻變成決策。你要從論文中抽取問題定義、核心假設、方法干預、證據強度和未解 gap,再把其中一個 gap 壓成可證偽假設和最小實驗計劃。
一個合格的研究生 proposal 至少應該讓讀者相信三件事:問題真實且重要;你的方法選擇有機制理由;實驗計劃能在有限資源下給出清楚答案。LLM 可以幫助檢索、整理、生成候選假設和檢查結構,但它不能替你承擔最終判斷。真正的訓練在於:你能否說清楚為什麼是這個問題、為什麼是這個實驗、以及失敗後你會學到什麼。
參考資料
檢索日期:2026-08-20。以下鏈接均為寫作時可訪問的一手或近一手資料;會議政策、代碼倉庫、benchmark 結果、模型版本和 arXiv 版本可能變化,正式發表前請再次核驗。
- DARPA, The Heilmeier Catechism. https://www.darpa.mil/about/heilmeier-catechism
- NSF, Preparing Your Proposal. https://www.nsf.gov/funding/preparing-proposal
- ICLR 2026 Author Guide. https://iclr.cc/Conferences/2026/AuthorGuide
- Chenglei Si, Diyi Yang, Tatsunori Hashimoto, "Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers", ICLR 2025. https://mlanthology.org/iclr/2025/si2025iclr-llms/
- Ziyu Chen, Yilun Zhao, Arman Cohan, "Measuring the Gap Between Human and LLM Research Ideas", arXiv:2607.01233, 2026. https://arxiv.org/abs/2607.01233
- SakanaAI, AI-Scientist-v2 GitHub repository. https://github.com/SakanaAI/AI-Scientist-v2
- Sakana AI, The AI Scientist project page. https://sakana.ai/ai-scientist/
- OpenAI, PaperBench: Evaluating AI's Ability to Replicate AI Research, 2025. https://openai.com/index/paperbench/
- OpenAI frontier-evals, PaperBench README. https://github.com/openai/frontier-evals/blob/main/project/paperbench/README.md
- Jing Ren, Weiqi Wang, "Assisting Research Proposal Writing with Large Language Models: Evaluation and Refinement", arXiv:2509.09709, 2025. https://arxiv.org/abs/2509.09709
- Kai Ruan et al., "Evaluating LLMs' divergent thinking capabilities for scientific idea generation with minimal context", Nature Communications, 2026. https://www.nature.com/articles/s41467-026-70245-1
- Jie Yu, Song Qiu, "More Than Can Be Said: A Benchmark and Framework for Pre-Question Scientific Ideation", arXiv:2605.06345, 2026. https://arxiv.org/abs/2605.06345
- Rosni Vasu et al., "HARPA: A Testability-Driven, Literature-Grounded Framework for Research Ideation", OpenReview ICLR 2026 withdrawn submission. https://openreview.net/forum?id=zGr73fcSsB
- NeurIPS 2026 Evaluations and Datasets Reviewing Guidelines. https://neurips.cc/Conferences/2026/EvaluationsDatasetsReviewerGuidelines