日期:2026-08-21
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
檢索日期:2026-08-21
摘要
一個月的論文精讀訓練不能只留下 30 篇博客。真正有價值的結果,是建立一套能持續運轉的科研閱讀系統:知道如何發現論文、判斷是否值得讀、拆解方法與實驗、做可復現記錄、提煉負結果和 follow-up idea,並把這些材料沉澱成 proposal、復現報告和長期選題庫。
本文是“AI 論文精讀與復現訓練營”的總結篇。前 30 篇覆蓋了從單篇論文精讀、related work 地圖、實驗解讀、benchmark 陷阱、復現報告,到 Transformer、Scaling Laws、RLHF、Reasoning、Tool-Using LLM、Multimodal LLM、AI for Science、Interpretability、Safety、Evaluation、Data-Centric AI、Efficient Training / Inference、開源模型技術報告、rebuttal、proposal 寫作等路線。最後一篇不再增加新主題,而是把這些訓練動作組織成一個長期系統:每週怎麼讀,每月怎麼復盤,如何維護 paper map、claim ledger、experiment log 和 idea backlog,如何使用 LLM/agent 輔助但不讓它替代判斷。
文章結合 2025-2026 年關於 AI 輔助科研、PaperBench、AAAR-1.0、AI Scientist、Science of Science agent、自動科學發現綜述,以及 ICLR 2026、NeurIPS 2026 對可復現性、代碼、數據和 LLM 使用的最新政策。核心結論很簡單:長期科研能力不是“讀很多論文”,而是把論文變成可檢驗判斷、可復現實驗和可持續選題。
目錄
- 為什麼總結篇仍然重要
- 一個月訓練營真正訓練了什麼
- 長期閱讀系統的四個倉庫
- 每週科研閱讀循環
- 從論文盤點到研究判斷
- AI 工具能幫什麼,不能替你做什麼
- 代表資料路線圖
- 可復現閱讀與實驗記錄模板
- 月度復盤:把閱讀變成選題資產
- 常見誤區
- 適合研究生繼續做的系統建設題
- 總結與參考資料
為什麼總結篇仍然重要
很多論文訓練計劃失敗,不是因為讀者不努力,而是因為訓練目標錯了。最常見的目標是“讀完多少篇論文”。這個目標容易執行,也容易產生滿足感,但它對科研能力的貢獻有限。真正決定研究能力的,不是你看過多少 PDF,而是你能否在一個方向裡持續回答五個問題:哪些問題重要?哪些方法真有新意?哪些證據可信?哪些結果能復現?哪些 gap 值得變成自己的實驗?
過去一個月的 30 個主題,其實對應科研訓練的五層能力。第一層是閱讀入口:如何精讀、如何判斷論文是否值得讀、如何做 related work 地圖。第二層是結構拆解:任務定義、假設、模塊、訓練目標、dataset、metric、baseline、ablation。第三層是可信度判斷:benchmark 陷阱、數據洩漏、選擇性報告、統計顯著性、不可復現結果。第四層是實驗訓練:環境、數據、權重、seed、日誌、reproduction report、負結果。第五層是選題形成:follow-up idea、proposal、rebuttal 和長期研究路線。
如果這些能力只存在於 30 篇獨立筆記裡,它們很快會散掉。你需要的是一個能反覆運行的系統。這個系統不追求把所有論文都讀完,而是保證每篇被認真處理的論文都進入某個位置:成為地圖上的節點、claim ledger 裡的可檢驗斷言、experiment log 裡的復現記錄、idea backlog 裡的候選問題,或者 proposal 裡的證據。
一個月訓練營真正訓練了什麼
這套訓練營的內容,不是一個主題列表,而是一條科研動作鏈。
方法論部分:從單篇論文的摘要、方法和實驗表格開始,訓練讀者把論文拆成問題、假設、變量、證據和侷限;再進一步學習 related work map、benchmark 風險、LLM 論文復現、復現筆記、ablation study 和 follow-up idea。它們解決的是“如何把閱讀變成判斷”。
技術路線部分:Transformer、Scaling Laws、Instruction Tuning、RLHF / Preference Optimization、Retrieval-Augmented Learning、Reasoning Models、Tool-Using LLM、Multimodal LLM、Vision-Language-Action、AI for Science、Interpretability、Safety / Alignment、Evaluation、Data-Centric AI、Efficient Training、Efficient Inference。它們解決的是“如何把領域變成路線圖”。這些文章不應該被當成百科,而應該被當成建立 paper map 的樣例。
科研製度和產出部分:如何讀開源模型技術報告,如何讀 rebuttal 與 peer review,如何從 10 篇論文形成 proposal。它們解決的是“如何把論文變成研究產物”。一個研究生如果只會讀 accepted paper,而不會讀技術報告、模型卡、review、rebuttal、代碼倉庫、失敗報告和復現材料,就很難判斷一個方向的真實狀態。
本文的任務,就是把這些動作長期化。長期系統的目標不是讓你每天都高強度讀論文,而是讓你在忙碌、換方向、實驗失敗、投稿被拒之後,仍然能恢復到同一套科研工作流。
長期閱讀系統的四個倉庫
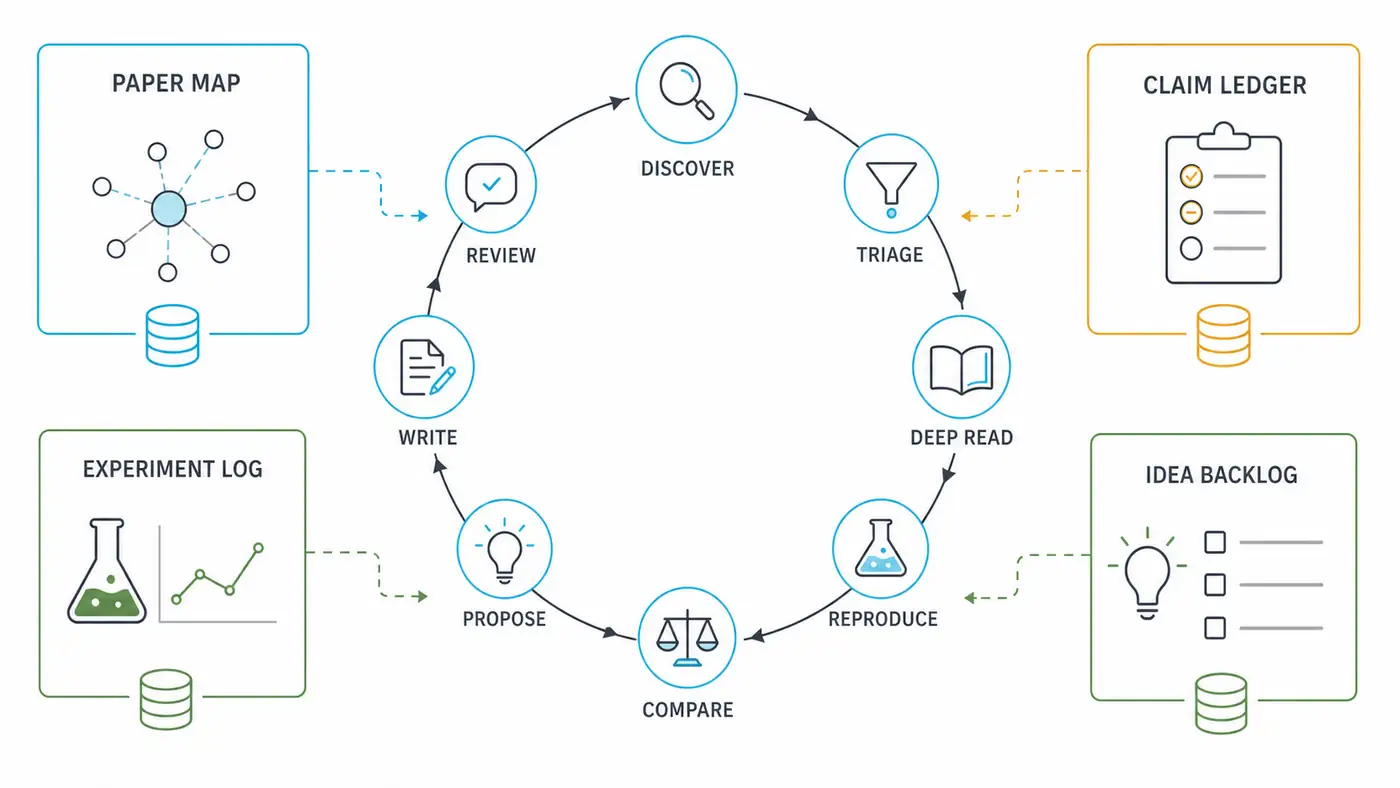
長期科研閱讀系統至少需要四個倉庫。
第一個是 paper map。它不是文獻管理器裡的文件夾,而是你對領域結構的理解。每個節點不是論文標題,而是問題、方法族、數據集、benchmark、失敗模式或技術假設。比如在 Efficient Inference 方向,節點可以是 KV cache、speculative decoding、quantization、continuous batching、serving benchmark;在 Safety 方向,節點可以是 red teaming、refusal、preference optimization、jailbreak robustness、policy compliance。論文只是掛在節點上的證據。
第二個是 claim ledger。它記錄論文中的可檢驗斷言,而不是摘要。每條 claim 至少包含:誰提出、在哪個設置下、改變了什麼變量、用什麼證據支持、適用邊界是什麼、你是否復現過。好的 claim ledger 會讓你很快發現哪些結論被多篇論文獨立支持,哪些只是某個 benchmark 上的局部現象,哪些依賴很強的工程細節。
第三個是 experiment log。復現實驗如果沒有日誌,幾週後就只剩印象。日誌應記錄 commit、環境、依賴版本、模型權重、數據版本、運行命令、seed、硬件、耗時、異常、指標、截圖和分析。ICLR 2026 Author Guide 強調可復現性聲明應指向論文、附錄和補充材料中能幫助復現的部分;NeurIPS 2026 handbook 也把代碼、數據、權重、環境版本和超參數等研究 artifact 視為外部審查的重要信息。對個人訓練而言,這些要求不是投稿負擔,而是日常科研 hygiene。
第四個是 idea backlog。不要把所有想法都寫成 proposal。backlog 的最小條目可以只有四行:問題、證據、最小實驗、失敗標準。一個 idea 如果沒有失敗標準,就還不是研究假設。一個 idea 如果找不到相關論文證據,就可能只是靈感。一個 idea 如果沒有最小實驗,就暫時不該佔用主線時間。
每週科研閱讀循環
長期系統需要一個輕量但穩定的周循環。建議用八步,而不是每天臨時決定讀什麼。
第一步,discover。每週固定一次掃描 arXiv、OpenReview、ACL Anthology、PMLR、NeurIPS/ICLR/ICML/ACL/EMNLP/CVPR 頁面、官方技術報告、代碼倉庫 release、benchmark leaderboard 和導師/同學分享。掃描時只記錄標題、來源、日期、任務、為什麼值得看,不做深讀。
第二步,triage。把論文分成四類:必讀、精讀、略讀、暫存。必讀是與你當前實驗直接相關;精讀是可能改變 paper map;略讀是補背景;暫存是看起來有趣但短期不影響判斷。判斷標準不是熱度,而是問題重要性、方法新意、證據強度和與你當前研究的耦合度。
第三步,deep read。每週最多精讀 1-2 篇。精讀時先讀摘要和結論,寫出作者想讓你相信什麼;再讀方法,拆任務定義、假設、模塊和訓練目標;最後讀實驗,檢查 dataset、metric、baseline、ablation、統計和失敗案例。不要一上來逐句翻譯。
第四步,reproduce。不是每篇都完整復現,但每週至少做一個可執行動作:跑作者 demo、復現一個表格中的小設置、重算 metric、檢查數據 split、跑 ablation、閱讀核心代碼路徑。PaperBench 的啟發是,復現能力可以拆成層級任務;小任務也能訓練真實判斷。
第五步,compare。把新論文放回 paper map,比較它與已有工作的差異。它改變的是模型結構、數據、訓練目標、推理預算、評價協議,還是敘事方式?如果只是換模型或換 benchmark,它未必值得進入主線。
第六步,propose。從本週閱讀中生成 1-3 個小 follow-up idea,每個都寫最小實驗。不要追求數量。一個經過證據約束的小問題,比十個泛泛的“可以結合 X 和 Y”更有價值。
第七步,write。每週輸出一份短文檔:可以是論文卡片、復現筆記、失敗記錄、對比表或 proposal 草稿。寫作不是宣傳,而是強迫自己把判斷說清楚。
第八步,review。週末用 30 分鐘檢查四個倉庫:paper map 是否新增節點,claim ledger 是否有可疑 claim,experiment log 是否可復現,idea backlog 是否有值得推進的條目。
從論文盤點到研究判斷
論文盤點很容易變成“這個方向有很多論文”。研究判斷則必須回答“因此我相信什麼、不相信什麼、下一步應該驗證什麼”。
最實用的方法是把每篇論文壓成五句話。第一句:它解決什麼具體失敗模式。第二句:它的核心假設是什麼。第三句:它真正改變了什麼變量。第四句:證據來自哪些實驗。第五句:我認為它最脆弱的地方在哪裡。這個格式看起來簡單,但會迫使你區分“論文做了什麼”和“論文證明了什麼”。
對方向盤點,可以用三張表。第一張是 timeline table,按時間列出技術路線變化。第二張是 evidence table,按 claim 列出支持證據和反證。第三張是 reproducibility table,記錄代碼、數據、權重、環境、運行成本和復現風險。三張表合在一起,才接近研究判斷。
在 2025-2026 年的 AI 研究環境裡,尤其要警惕“模型名驅動閱讀”。很多技術報告會同時改變模型規模、數據、後訓練、推理策略和評測設置。讀者如果只看排行榜,就會把系統性工程誤讀成單一方法貢獻。長期系統要把每個 claim 還原到變量層面:到底是數據更好、訓練更久、模型更大、prompt 更強、benchmark 更適配,還是方法本身更有效?
AI 工具能幫什麼,不能替你做什麼
AI 工具已經進入科研閱讀工作流,但它的正確位置是“加速處理”和“暴露盲點”,不是替代判斷。
AAAR-1.0 是一個很好的提醒。它把研究者日常任務拆成 EquationInference、ExperimentDesign 和 PaperWeakness,強調這些任務需要領域專長,而不是普通問答能力。PaperBench 則從另一側提醒我們:復現 AI 論文不是摘要任務,而是理解貢獻、開發代碼和執行實驗的端到端任務;OpenAI 2025 年發佈頁面顯示,當時最好的 tested agent 仍未超過人類基線。二者共同說明:LLM 可以作為研究助理,但“讀懂、復現、判斷”的責任仍在研究者。
ICLR 2026 對 LLM 使用的政策也體現了同樣原則:LLM 可以作為通用輔助工具,但如果在研究構思或寫作中起到顯著貢獻,需要披露其角色;作者仍對內容、事實、引用和潛在學術不端負責。NeurIPS 2026 對 reviewer 使用 LLM 的規定更嚴格,強調投稿保密、受控工具和 prompt injection 風險。對個人閱讀系統來說,這意味著:不要把未公開稿件、保密代碼、審稿材料隨意丟進外部模型;不要相信模型生成的引用;不要讓模型直接給出最終審稿判斷。
可取的用法包括:讓 LLM 幫你把論文轉成 claim ledger 初稿;讓它列出需要核驗的 dataset、metric、baseline;讓它從 experiment log 中整理異常;讓它根據 paper map 提出候選 gap;讓它把復現筆記改寫成博客草稿。不可取的用法包括:讓模型替你決定論文是否可信;讓模型編 reference;讓模型基於未核驗摘要生成 proposal;讓模型在無 sandbox 的環境中執行陌生代碼;讓模型把 reviewer 意見簡化成“接收/拒絕”。
代表資料路線圖
| 類別 | 代表資料 | 對長期系統的啟發 |
|---|---|---|
| 可復現規範 | ICLR 2026 Author Guide;NeurIPS 2026 Main Track Handbook;Papers with Code research-code checklist | 把代碼、數據、環境、權重、超參數和運行命令納入日常記錄 |
| AI 復現能力評測 | OpenAI PaperBench;frontier-evals PaperBench README | 把“復現論文”拆成可評分子任務,而不是泛泛地跑一下代碼 |
| AI 輔助科研任務 | AAAR-1.0;Can LLMs Generate Novel Research Ideas? | 區分 idea、實驗設計、弱點識別、可行性和新穎性 |
| 科學發現 agent | Towards end-to-end automation of AI research;Automated Scientific Discovery survey;AI Agents for the Science of Science | 自動化科研需要外部證據、實驗 substrate、反饋循環和偏差審查 |
| 研究寫作與評審 | ICLR/NeurIPS LLM 使用政策;頂會 review form;rebuttal 經驗 | 把寫作、審稿和回應都當成證據質量訓練 |
| 長期知識系統 | paper map、claim ledger、experiment log、idea backlog | 把閱讀結果沉澱成可維護資產 |
可復現閱讀與實驗記錄模板
下面是一份可直接複製到筆記系統裡的最小模板。
Paper:
Venue / version / date:
Link:
Code / data / model:

Problem:
Claim:
Assumption:
Intervention:
Evidence:
Boundary:
Failure cases:

Datasets:
Metrics:
Baselines:
Ablations:
Statistical checks:

Reproduction target:
Environment:
Command:
Seed:
Hardware / budget:
Result:
Difference from paper:
Debug notes:

What I believe now:
What I do not believe yet:
Follow-up idea:
Minimum experiment:
Failure criterion:
這個模板的重點不是完整,而是形成一致性。長期堅持後,你會得到一個很有價值的個人數據庫:哪些論文真的改變了你的判斷,哪些實驗你親手跑過,哪些 claim 最經不起復現,哪些 idea 已經多次出現但仍沒人解決。
月度復盤:把閱讀變成選題資產
每個月至少做一次復盤。復盤不需要很長,但必須產出三個東西。
第一,更新 paper map。刪除已經不重要的節點,合併重複分支,標記新出現的技術分叉。比如一個月前你可能把 “LLM evaluation” 當成單一方向;讀完後它可能拆成 open-ended eval、human eval、LLM-as-judge、contamination、live benchmark、agent eval 和 domain-specific eval。
第二,清理 claim ledger。把 claim 分成三類:已較穩固、仍待核驗、傾向不成立。這個分類必須基於證據,不是基於論文聲量。對於“待核驗”的 claim,寫清楚最小核驗動作;對於“傾向不成立”的 claim,保留反例和失敗日誌。
第三,篩選 idea backlog。每月只推進 1-2 個 idea。推進標準是:問題足夠具體,相關論文證據足夠清楚,最小實驗可在 2-4 周完成,失敗後也能學到東西。其他 idea 暫存,不要讓它們干擾當前主線。
如果你是研究生,可以把月度復盤變成與導師溝通的材料。相比“我讀了很多論文”,更有用的是:“我認為這個方向有三個未解 claim;其中一個可以用兩週復現實驗驗證;如果結果為正,可以擴成 workshop paper;如果為負,可以寫成 benchmark audit 或 reproducibility note。”
常見誤區
誤區一:收藏等於閱讀。文獻管理器裡的 500 篇 PDF 不會自動變成理解。沒有進入 paper map 或 claim ledger 的論文,對長期研究幫助很小。
誤區二:摘要等於證據。摘要告訴你作者想讓你相信什麼,實驗和復現才決定你應該相信多少。
誤區三:只讀最新論文。AI 方向更新快,但經典論文提供任務定義、歸納偏置和評價範式。只讀 2026 年論文,容易看見結果卻看不見問題從哪裡來。
誤區四:只讀經典論文。相反,只停留在 Attention、BERT、InstructGPT 這些基礎論文,也會錯過當前 benchmark、數據策略、模型報告和復現制度的變化。
誤區五:把 LLM 當成導師。LLM 可以問你問題、整理表格、提出候選 gap,但它不會為你的實驗負責,也不會承擔錯誤引用、錯誤 claim 或不可復現結果的後果。
誤區六:沒有維護成本意識。長期系統必須輕量。每篇論文都寫 5000 字筆記,通常堅持不了。更好的做法是少數精讀、批量略讀、關鍵 claim 結構化記錄。
誤區七:每個 idea 都立刻開實驗。idea backlog 的作用是延遲衝動。真正值得推進的 idea,應該經得起一週後的復看和一個最小實驗計劃的約束。
適合研究生繼續做的系統建設題
- 個人 claim ledger 工具:把 AI 論文中的 claim、dataset、metric、baseline 和復現狀態結構化,並支持按方向檢索。
- Reproducibility-first paper reading protocol:比較普通閱讀筆記與復現優先筆記對後續實驗成功率的影響。
- LLM-assisted literature triage audit:評估 LLM 對論文初篩的幫助與偏差,重點檢查遺漏重要負結果和過度偏好熱門模型的問題。
- Paper map drift analysis:跟蹤一個 AI 子領域六個月,分析 paper map 如何隨 benchmark、模型和會議政策變化而重構。
- Proposal-from-ledger workflow:研究從 claim ledger 自動生成 proposal 初稿時,哪些字段最能提升可行性和引用準確性。
- Failed reproduction memory bank:建立復現失敗案例庫,研究失敗原因在不同論文類型中的分佈。
這些題目不一定都要寫成大論文,但都適合作為科研訓練項目。它們的共同點是:把“讀論文”本身變成可研究、可測量、可改進的過程。
總結
一個月 AI 論文訓練營的結束,不應該是閱讀習慣的結束。真正的目標,是你已經擁有一套能繼續運轉的系統:每週發現與篩選論文,精讀少數關鍵工作,做最小復現,把 claim 寫成可核驗記錄,把實驗寫成可復現日誌,把想法放入 backlog,再用月度復盤把它們壓縮成 proposal 或新的研究問題。
長期科研閱讀不是追熱點,也不是攢知識點。它是一種持續校準判斷的過程:不斷問自己,我現在相信什麼?證據夠不夠?如果不夠,最小實驗是什麼?如果失敗,我會學到什麼?當你能穩定回答這些問題,論文就不再是信息流,而會變成你的研究資產。
參考資料
檢索日期:2026-08-21。以下鏈接為寫作時可訪問的一手或近一手資料;會議政策、代碼倉庫、benchmark 結果、模型版本、數據集版本和 arXiv/OpenReview 狀態可能變化,正式發表前請再次核驗。
- ICLR 2026 Author Guide. https://iclr.cc/Conferences/2026/AuthorGuide
- NeurIPS 2026 Main Track Handbook. https://neurips.cc/Conferences/2026/MainTrackHandbook
- Papers with Code, Tips for Publishing Research Code. https://github.com/paperswithcode/releasing-research-code
- OpenAI, PaperBench: Evaluating AI's Ability to Replicate AI Research, 2025. https://openai.com/index/paperbench/
- OpenAI frontier-evals, PaperBench README. https://github.com/openai/frontier-evals/blob/main/project/paperbench/README.md
- Renze Lou et al., "AAAR-1.0: Assessing AI's Potential to Assist Research", ICML 2025 / PMLR. https://proceedings.mlr.press/v267/lou25c.html
- Chenglei Si, Diyi Yang, Tatsunori Hashimoto, "Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers", ICLR 2025. https://mlanthology.org/iclr/2025/si2025iclr-llms/
- Yixuan Liu, Yicheng Zhang, "AI Agents for the Science of Science: A Survey of Tasks, Architectures, Evaluations, and Challenges", Findings of ACL 2026. https://aclanthology.org/2026.findings-acl.1804/
- Stefan Kramer et al., "Automated Scientific Discovery: From Equation Discovery to Autonomous Discovery Systems", Machine Learning, 2026. https://link.springer.com/article/10.1007/s10994-025-06955-2
- "Towards end-to-end automation of AI research", Nature, 2026. https://doi.org/10.1038/s41586-026-10265-5
- NeurIPS Ethics Guidelines. https://neurips.cc/public/EthicsGuidelines
- ICLR 2026 Policies on Large Language Model Usage. https://iclr.cc/FAQ/LLM
- REFORMS: Consensus-based Recommendations for Machine-learning-based Science. https://pmc.ncbi.nlm.nih.gov/articles/PMC11092361/
- Reproducibility in machine-learning-based research: Overview, barriers, and drivers, AI Magazine, 2025. https://onlinelibrary.wiley.com/doi/10.1002/aaai.70002
- An international consensus on core reproducibility items in research, 2026. https://pmc.ncbi.nlm.nih.gov/articles/PMC13086321/