日期:2026-08-18
適合讀者:研究生、開源模型研究新人、有工程背景的 AI 讀者
檢索日期:2026-08-18
摘要
開源模型技術報告不是普通論文,也不是下載說明。它通常把模型卡、訓練配方、數據說明、評測表、許可證、安全說明和部署建議放在一起。讀這類報告的關鍵,不是看“模型排第幾”,而是判斷:它到底開放了什麼?哪些證據足以支持復現?哪些結論只適用於作者的評測設置?哪些限制會影響你的實驗設計?
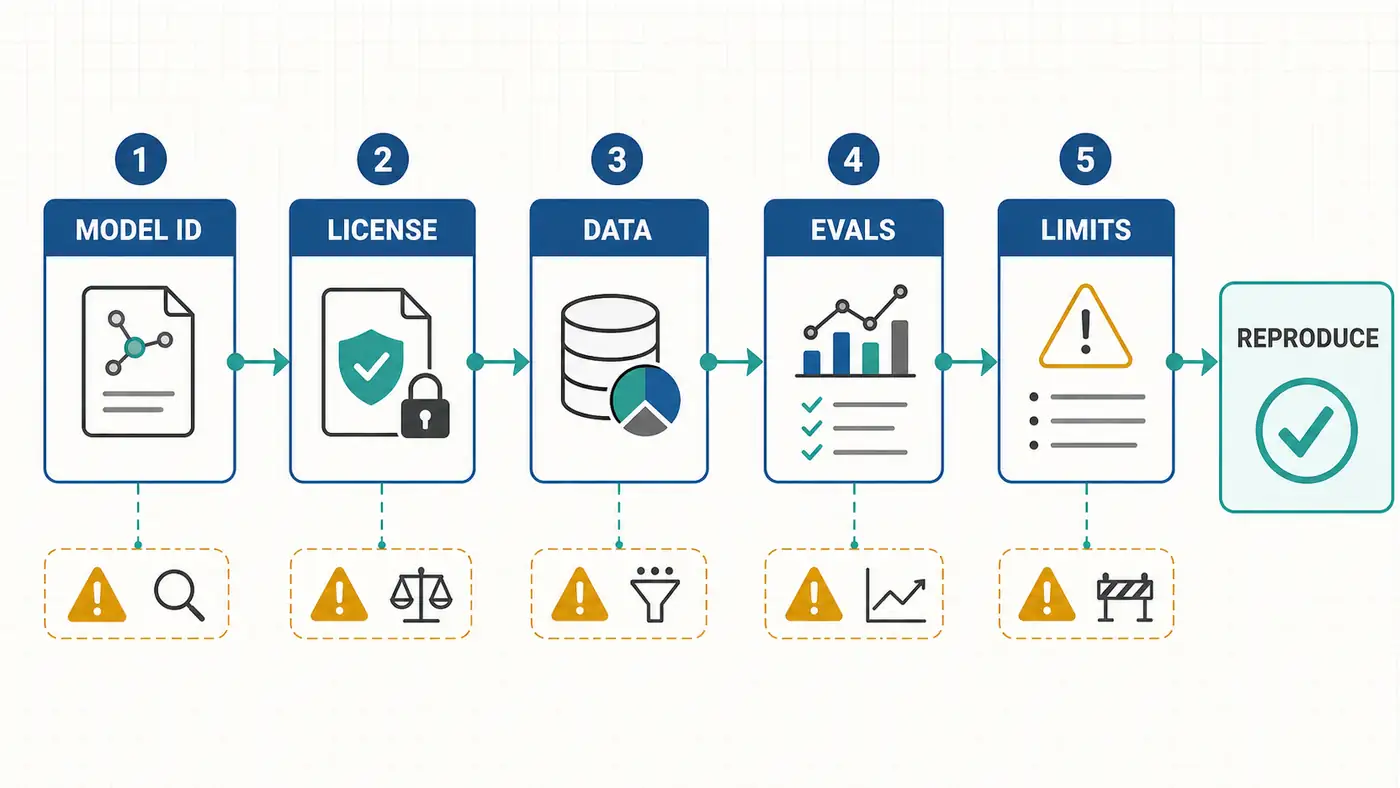
本文給出一套七層閱讀法:模型身份、開放範圍、許可證、訓練數據、訓練方法、評測證據、限制與復現資產。案例覆蓋 Llama 4、Qwen3、DeepSeek、Gemma、gpt-oss、OLMo 和 Nemotron。目標不是替某個模型背書,而是訓練你把模型報告讀成一條可核驗的證據鏈。
目錄
- 為什麼這個主題重要
- 核心閱讀方法
- 代表模型報告路線圖
- 技術報告對比表
- 復現建議
- 常見誤區
- 研究生選題
- 總結與參考資料
為什麼這個主題重要
2025-2026 年的開放模型發佈越來越像組合包:官網負責敘事,arXiv 報告講訓練和實驗,Hugging Face 模型卡給使用說明,GitHub 放推理代碼,另有安全頁、許可證和 benchmark 頁面。研究生如果只讀 PDF,很容易漏掉影響復現的細節:tokenizer、chat template、上下文長度開關、量化版本、推薦 serving engine、許可證限制、數據過濾和安全評測邊界。
“開放”也不是二值標籤。OSI 的 Open Source AI Definition 1.0 要求機器學習系統提供足夠的數據說明、訓練和運行代碼、參數等 preferred form。很多模型更準確地說是 open-weight:權重可下載,推理可運行,但訓練數據、過濾代碼、RL 環境、完整超參、中間 checkpoint 和內部評測集不完全公開。科研閱讀必須把“能用”和“能復現”分開。
核心閱讀方法
第一,看模型身份。記錄模型名、版本、發佈時間、開發者、參數規模、激活參數、架構、模態、上下文窗口、tokenizer、chat template,以及 base / instruct / thinking / quantized / distill 的關係。不要把同一家模型的不同後綴混用。
第二,看開放範圍。檢查開放的是權重、推理代碼、訓練代碼、訓練數據、數據配比、過濾腳本、中間 checkpoint、optimizer state、評測腳本,還是隻開放在線接口。Hugging Face 模型卡文檔建議說明模型、用途和限制、訓練參數、訓練數據和評測結果;但建議不等於每個模型都完整披露。筆記裡要標註“已公開 / 部分公開 / 未公開 / 待人工核驗”。
第三,看許可證。科研復現可用,不代表可以商業部署、二次分發或蒸餾。代碼許可證、權重許可證、數據許可證和 acceptable use policy 可能不同。尤其注意:GitHub 倉庫 MIT,不代表模型權重也是 MIT。
第四,看訓練數據。至少問:token 數是多少?數據截止時間是什麼?包含哪些語種和模態?來自公開網頁、授權數據、合成數據、用戶交互還是私有數據?是否說明去重、質量過濾、安全過濾和敏感信息過濾?是否報告 benchmark contamination?
第五,看訓練方法。畫出 pre-training、continued pre-training、SFT、RLHF、DPO/GRPO/RLVR、distillation、long-context extension、quantization、tool-use tuning 和 safety tuning 的順序。很多能力來自後訓練,而不是 base 模型本身。
第六,看評測證據。檢查 benchmark 版本、shot 數、prompt 格式、是否用工具、是否用 thinking mode、是否比較同尺寸模型、是否報告方差、是否公開評測腳本。Arena、LiveCodeBench、AIME、MMLU-Pro、GPQA、MMMU、SWE-bench 等結果變化很快,引用時必須寫檢索日期。
第七,看限制說明。真正有價值的模型卡會說明不適用場景:語言覆蓋不足、圖像數量限制、長上下文質量衰減、高風險領域、偏見與隱私風險、安全繞過風險、訓練數據不可復現。這些限制往往是 follow-up idea 的來源。
代表模型報告路線圖
Model Cards for Model Reporting 是基礎讀物。它強調 intended use、評測過程、不同條件下的性能和限制說明。Datasheets for Datasets 與 Data Statements for NLP 則提醒我們:數據不是一個 token 總量,而有來源、採集過程、標註人群、語言社區、偏差和維護責任。讀大模型報告時,應把三者合起來看。
Llama 4 模型卡是開放權重報告的典型樣本。Meta 披露 Scout 與 Maverick 的 MoE 架構、激活參數、總參數、上下文長度、訓練 token 量、知識截止日期、支持語言、許可證、能耗、benchmark 和安全評測;也說明訓練數據包含公開、授權以及來自 Meta 產品和服務的信息。閱讀重點是區分“披露較完整”和“訓練可完全復現”。
Qwen3 適合訓練版本控制意識。Qwen GitHub README 顯示 2025 年 7-8 月連續發佈 2507 版本;Qwen3-235B-A22B-Instruct-2507 模型卡標註 235B 總參數、22B 激活參數、原生 262,144 token 上下文,並給出擴展到約 1,010,000 token 的配置說明。任何實驗數字都必須綁定 checkpoint、revision、推理框架和 chat template。
DeepSeek-V3 / R1 適合訓練復現邊界意識。R1 發佈頁和 Nature 論文提供多階段後訓練、RL、蒸餾模型、開源權重和部分數據樣本;但社區 replication 綜述指出,完整實現細節和訓練數據並非全部公開。因此復現筆記應明確:哪些環節等價,哪些只是替代。
Gemma、gpt-oss、OLMo 和 Nemotron 展示了不同透明度風格。Gemma 模型卡強調輸入輸出、訓練數據、過濾、安全評測和限制;gpt-oss 模型卡討論開放權重被惡意微調繞過安全拒答的風險;OLMo 2 強調 fully-open,包括訓練數據、代碼、配方、評測和中間產物;Nemotron 突出開放權重、訓練數據和訓練 recipe。把它們並排讀,可以看到“開放”是一條連續譜。
技術報告對比表
| 維度 | 應該找什麼 | 風險信號 |
|---|---|---|
| 模型身份 | 版本、架構、參數、模態、上下文 | 只寫家族名 |
| 許可證 | 權重、代碼、數據、輸出許可 | 代碼許可和權重許可混淆 |
| 訓練數據 | token、來源、截止、過濾、去重 | 只寫 high-quality mixture |
| 後訓練 | SFT、RL、偏好數據、安全 tuning | 能力歸因模糊 |
| 評測 | benchmark 版本、shot、prompt、工具 | 只放總榜圖 |
| 限制 | 語言、模態、安全、領域邊界 | out-of-scope 空泛 |
| 復現資產 | repo、環境、權重、數據、日誌 | 只有 demo 或 API |
復現建議
不要從零復現 100B+ 模型。更可靠的做法是分三層。第一層是文檔復現:建立審計表,逐項核對模型身份、許可證、數據、評測、限制和復現資產,輸出 reproduction readiness report。第二層是推理復現:選擇一個可運行 checkpoint,固定 revision、環境、chat template、採樣參數和硬件,復現模型卡中的 1-2 個小 benchmark 或官方示例。第三層是機制復現:用 0.5B-7B 模型復現一個機制,例如數據去重、SFT 數據混合、拒答數據構造、contamination 檢查、量化誤差分析或 tool-use benchmark。
一個最小實驗可以這樣做:選三個開放模型卡,構建統一審計表;選其中一個 7B-30B 可運行模型,固定環境跑 MMLU-Pro 子集、IFEval 子集或自建中文任務;比較 base / instruct / quantized 的差異;最後寫出“哪些信息足以復現,哪些缺失導致只能近似復現”。
常見誤區
第一,把 leaderboard 當論文。榜單數字只是入口,必須追問評測日期、版本、prompt、工具、shot、thinking mode 和 contamination 檢查。第二,把權重開放當訓練開放。下載權重只能復現推理行為,不能復現訓練過程。第三,忽略許可證。課堂復現、開源倉庫、商業服務、二次蒸餾和輸出再訓練可能對應不同約束。第四,混用版本。模型卡更新、量化權重、後訓練版本和 provider 部署版本都會變化。
研究生選題
- 開放模型報告透明度評分:構建 LLM model-card audit rubric,比較 20 個開放權重模型。
- 訓練數據說明與 benchmark contamination:研究不同 contamination 聲明能否預測實際重疊風險。
- 模型卡限制說明的實證驗證:把 reported limitations 轉化為可運行測試集。
- 快速版本迭代下的評測漂移:比較同一模型家族不同 checkpoint 的評測設置。
- Fully-open 與 open-weight 復現成本對比:度量復現所需缺失信息。
總結
開源模型技術報告的讀法,不是從 benchmark 表開始,也不是從下載命令開始,而是從證據鏈開始:模型是誰、開放了什麼、數據來自哪裡、訓練如何進行、評測如何設置、限制是否清楚、復現資產是否足夠。把每份報告都讀成一份“可復現性合同”:明確承諾的,可以嘗試復現;含糊帶過的,要標註風險;沒有披露的,不要替它補全。
參考資料
檢索日期:2026-08-18。模型版本、倉庫 commit、評測榜單和許可證條款可能變化,發表前建議再次人工核驗。
- Model Cards for Model Reporting. https://arxiv.org/abs/1810.03993
- Hugging Face Model Cards. https://huggingface.co/docs/hub/model-cards
- Open Source AI Definition 1.0. https://opensource.org/ai/open-source-ai-definition
- Foundation Model Transparency Index. https://crfm.stanford.edu/fmti/
- Datasheets for Datasets. https://arxiv.org/abs/1803.09010
- Data Statements for NLP. https://aclanthology.org/Q18-1041/
- Llama 4 Model Card. https://github.com/meta-llama/llama-models/blob/main/models/llama4/MODEL_CARD.md
- Qwen3 GitHub. https://github.com/QwenLM/Qwen3
- Qwen3-235B-A22B-Instruct-2507. https://huggingface.co/Qwen/Qwen3-235B-A22B-Instruct-2507
- DeepSeek-V3. https://github.com/deepseek-ai/DeepSeek-V3
- DeepSeek-R1 Release. https://api-docs.deepseek.com/news/news250120/
- DeepSeek-R1 Nature paper. https://doi.org/10.1038/s41586-025-09422-z
- OpenAI gpt-oss Model Card. https://openai.com/index/gpt-oss-model-card/
- Gemma 3 model card. https://ai.google.dev/gemma/docs/core/model_card_3
- Gemma 4 model page. https://deepmind.google/models/gemma/gemma-4/
- OLMo 2. https://allenai.org/olmo2
- NVIDIA Nemotron. https://developer.nvidia.com/topics/ai/nemotron
- Open-weight AI risk management. https://www.aisi.gov.uk/research/open-technical-problems-in-open-weight-ai-model-risk-management