日期:2026-08-14
適合讀者:研究生、LLM evaluation 入門研究者、有工程背景的 AI 讀者
檢索日期:2026-08-14
摘要
LLM Evaluation 論文最容易被讀成“誰在榜單上更高”。但科研訓練真正要學習的是:一個 benchmark 為什麼能代表能力,開放式回答如何被評分,人類偏好和專家標註如何進入證據鏈,LLM-as-a-judge 的誤差如何被校準,以及數據汙染、提示格式、版本漂移會怎樣改變結論。
這篇文章給出一條從經典 benchmark 到 2025-2026 年動態評測的精讀路線。先讀 HELM、BIG-bench、MMLU-Pro、GPQA 等資料,理解任務 taxonomy、標準化協議和多指標報告;再讀 Chatbot Arena、MT-Bench、AlpacaEval、Arena-Hard、WildBench,理解開放式回答與人類偏好為什麼需要成對比較、置信區間和錯誤切片;然後讀 LLM-as-a-judge survey、Judge-Bench、PPE、OpenAI Evals、EleutherAI lm-evaluation-harness,理解自動裁判的可復現邊界;最後讀 LiveBench、LiveCodeBench、YourBench 和 contamination detection 論文,理解現代評測正在從靜態題庫轉向動態、版本化、可審計的評測系統。
目錄
- 為什麼這個主題重要
- 核心閱讀方法
- 代表論文路線圖
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結與參考資料
為什麼這個主題重要
對研究生來說,Evaluation 是 AI 研究裡最值得系統訓練的基本功。很多論文的“方法有效”其實只在一個脆弱評測協議下成立:dataset 被汙染,baseline 太弱,prompt 沒對齊,answer extraction 有偏,LLM judge 偏好更長答案,human eval 樣本太少,或者只報告了總分而沒有錯誤分佈。你如果不會讀評測部分,就很難判斷一篇論文是否真的推進了能力。
2025-2026 年的趨勢尤其明顯。靜態選擇題 benchmark 仍然重要,但越來越多研究開始強調 open-ended tasks、human preference、model-graded eval、實時更新題庫、私有或延遲公開 test set、可復現日誌和汙染檢測。LiveBench 頁面在 2026 年仍以“contamination-free”和定期刷新為核心賣點;OpenAI Evals 頁面持續發佈 GDPval、SWE-Lancer、MLE-bench 等更接近真實工作流的評測;Hugging Face YourBench 則把“從自有文檔生成動態 benchmark”變成開源工具。這些變化說明,評測不再只是論文最後一張表,而是研究問題本身。
本篇的訓練目標不是讓你記住哪個榜單最權威,而是建立一個判斷框架:這個評測測的是什麼?沒測什麼?標籤或裁判從何而來?分數能否復現?是否可能被訓練數據、prompt、答案格式或 judge bias 汙染?能否從錯誤案例裡提出下一篇論文的選題?
核心閱讀方法
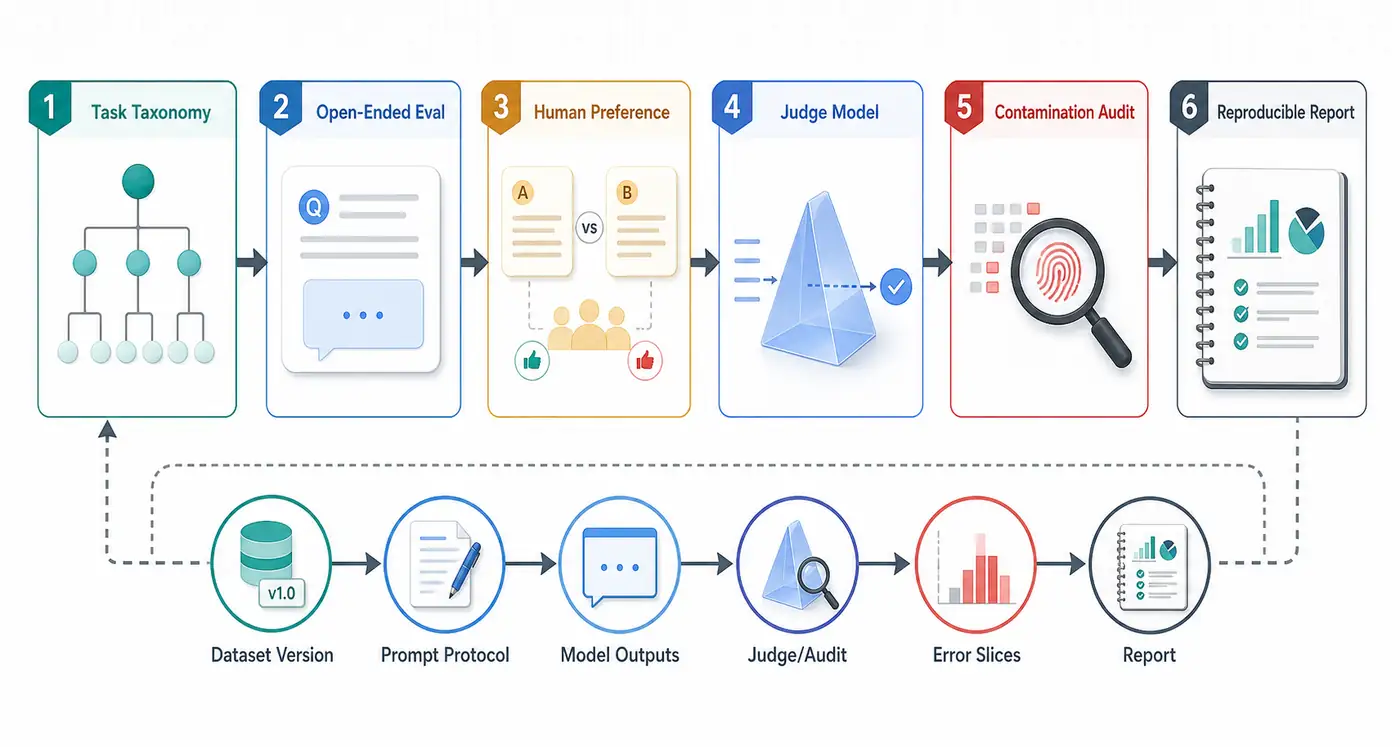
讀 Evaluation 論文時,建議先寫下六個問題。
第一,任務邊界是什麼?評測的是 closed-book knowledge、數學推理、代碼、長上下文、工具使用、開放問答、偏好對齊,還是真實工作任務?不同任務不能簡單用一個平均分相加。MMLU-Pro 的多選題、GPQA 的專家題、Chatbot Arena 的人類偏好、SWE-bench 的端到端測試,代表的是不同證據類型。
第二,樣本從哪裡來?題目來自考試、專家撰寫、真實用戶、代碼 issue、Kaggle 競賽、最新 arXiv 摘要,還是 LLM 合成?樣本來源決定了汙染風險、難度分佈和外推邊界。讀論文時要記錄數據版本、公開時間、訓練數據 cutoff 是否可知,以及是否有 private split 或 delayed release。
第三,輸出如何評分?選擇題可以用 accuracy,但開放式回答需要 exact match、rubric、pairwise preference、LLM judge、人工評分或執行測試。評分規則越複雜,越要檢查裁判穩定性、人工一致性、輸出解析規則和無效回答處理。
第四,比較是否公平?不同模型的 system prompt、chat template、temperature、max tokens、thinking traces、工具權限和答案抽取方法都會影響分數。現代 reasoning models 還會引入“隱藏推理”和長輸出預算問題;如果不固定協議,所謂提升可能只是推理預算更大。
第五,統計證據是否足夠?開放式評測和人類偏好評測必須看置信區間、樣本量、bootstrap、pairwise matrix、勝率不確定性和 error slices。只給一個小數點後三位的 leaderboard 分數,通常不足以支撐強結論。
第六,是否有汙染與漂移審計?汙染不只意味著 test set 原文進入預訓練,也包括 benchmark 題目在網絡、leaderboard、論壇和教程中反覆傳播。模型 API、judge model、benchmark release 和數據許可證都會變化,復現報告必須寫明檢索日期與版本。
代表論文路線圖
1. 從 HELM 到 MMLU-Pro:先學會讀“評測協議”
HELM 是很好的第一站,因為它把 evaluation 從單一準確率擴展成“場景、適配方式、指標和透明日誌”的系統工程。HELM 的核心訓練價值不在於某個模型排名,而在於三點:覆蓋面要明確,缺口也要明確;指標要多元,包括準確率、魯棒性、公平性、校準、效率等;同一批模型要在同一協議下比較。讀 HELM 時,建議把每個 benchmark 拆成 scenario、adaptation、metric、model access、raw outputs 五列。
BIG-bench 和 BIG-bench Hard 適合用來理解“能力探針”的思路。它們不是為了復刻單個應用,而是用大量困難任務暴露模型能力邊界。缺點也明顯:題庫公開後,後續模型可能通過訓練數據或調參間接接觸題目,靜態題庫會逐漸失去區分度。
MMLU-Pro 和 GPQA 代表了“讓靜態 benchmark 變難、變穩”的路線。MMLU-Pro 從 MMLU 出發,增加選項數量、篩選更偏推理的問題,並在官方倉庫中強調 CoT 評測和 prompt 穩定性;GPQA 由領域專家撰寫研究生級科學問題,並強調非專家即使用搜索也難以回答。精讀這些論文時,不要只看“題目更難”,而要看它們如何定義難度、如何驗證題目質量、如何處理隨機猜測和專家誤差。
2. Open-ended Eval:開放回答不是沒有標準
開放式評測的難點是答案空間大。MT-Bench 和 Chatbot Arena 讓研究者看到兩條路線:前者用固定多輪問題和 GPT-4 judge 做自動評分,後者用匿名模型對戰和人類投票估計偏好。它們的科研價值在於承認“開放回答很難寫一個確定答案”,於是轉向 pairwise comparison、Elo / Bradley-Terry 估計、人工偏好和裁判校準。
AlpacaEval 和 Arena-Hard 是自動偏好評測的重要節點。AlpacaEval 追求低成本、快速並與人類偏好高度相關;後續 length-controlled win rate 明確處理長答案偏差。Arena-Hard 從 Chatbot Arena 的真實數據中構造更有區分度的挑戰集,並強調 separability 與 human preference agreement。讀這些論文時,關鍵問題是:prompt 是否代表真實用戶?judge 是否偏好長、禮貌、結構化或自信的回答?分數差異是否大到超過置信區間?
WildBench 則把真實用戶任務進一步引入開放評測。它提醒我們,真實 query 往往不是乾淨考試題,而是含糊、長、上下文不足、跨領域、格式要求複雜。對研究生來說,復現開放式評測時最有價值的不是追榜,而是抽樣讀失敗案例:模型是在事實錯、格式錯、推理錯、沒遵守約束,還是回答看似漂亮但沒有解決任務?
3. Human Eval:人類標籤是證據,不是裝飾
Human eval 的常見誤區是把“找幾個人投票”當作充分證據。嚴格的人類評測至少要交代標註者背景、任務說明、評分 rubric、樣本抽樣、盲評方式、一致性指標、付費或激勵方式,以及 tie / unsure 如何處理。Chatbot Arena 的優勢是規模大、真實用戶多、匿名對戰減少品牌偏見;侷限是用戶分佈、任務分佈和投票動機並不完全受控。
MT-Bench 的專家標註、Chatbot Arena 的 crowdsourced preference、OpenAI SimpleQA 的 factuality 設計、GDPval 的行業專家任務,都體現了不同的人類證據。SimpleQA 試圖把事實性壓縮成短答案問題,降低長文本事實核查難度;GDPval 則把評測對象推向真實知識工作 deliverables。讀這些資料時要區分:人類是在提供 gold answer、偏好排序、質量評分、事實核查,還是任務驗收?不同標籤不能混用。
如果你要做自己的 human eval,建議從小規模但高質量開始。先寫 rubric,再做 20 條 pilot annotation;統計標註分歧,修訂說明;正式評測時保留 blind pairwise 樣本、隨機順序、重複樣本和衝突仲裁。不要只報告“平均人類偏好”,要報告置信區間和典型分歧。
4. LLM-as-a-Judge:自動裁判必須先被裁判
LLM-as-a-judge 是現代評測繞不開的工具,因為人工評測成本高,開放輸出難以規則評分。但自動裁判的風險也很集中:位置偏差、長度偏差、自我偏好、格式偏差、領域知識不足、prompt 敏感、對 adversarial wording 脆弱,以及 proprietary judge 版本不可復現。
2025 年 ACL / EMNLP 的 LLM-as-a-judge survey 和 “LLMs instead of Human Judges?” 這類實證研究值得精讀。它們的共同結論是:LLM judge 在某些任務上能提供有用信號,但必須先用人類標註驗證,不能默認替代人類。Judge-Bench 一類工作強調不同任務、不同語言、不同數據類型上的 judge 表現差異;PPE 則把 reward model / LLM judge 放在真實人類偏好和可驗證 correctness 上做元評測。
讀 LLM judge 論文時,建議固定一個表格:judge model、judge prompt、輸入格式、輸出格式、是否 pairwise、是否 shuffle 順序、是否多次採樣、是否用 ensemble、與人類的相關性、偏差測試、人工抽查比例、失敗樣例。一個沒有這些信息的 judge 實驗,即使分數很高,也很難成為可靠證據。
5. Contamination:高分可能來自能力,也可能來自記憶
數據汙染是 LLM evaluation 的核心風險。NAACL 2024 的 “Investigating Data Contamination in Modern Benchmarks for Large Language Models” 提出 retrieval-based overlap 和 Testset Slot Guessing,說明即便閉源模型也能通過行為探針暴露潛在接觸;Findings EMNLP 2024 的 open-source contamination report 則提供了面向開源模型和多項選擇 benchmark 的汙染分析流程。contamination survey 進一步整理了檢測方法和適用邊界。
汙染不是簡單的“見過題就一定高分”。有些汙染會顯著抬高分數,有些隻影響某些子集;有些模型可能記住題幹卻不會正確解題;有些 benchmark 的答案、解析、討論帖或 leaderboard 樣例比原始 test set 更容易進入訓練語料。讀論文時要看檢測的是 exact overlap、near-duplicate、semantic overlap、slot guessing,還是時間切分後的性能異常。
LiveBench 和 LiveCodeBench 代表動態抗汙染路線。LiveBench 使用定期刷新、客觀可驗證答案、延遲公開部分題目來降低汙染和 LLM judge 偏差;LiveCodeBench 從新近競賽平臺持續收集代碼題,強調時間切分、代碼生成之外的 self-repair、execution 和 test prediction 等能力。YourBench 則提供另一條路:從用戶提供的新文檔生成領域評測,並用 grounding / citation checks 減少“模型憑舊知識答題”的空間。
6. 復現工具:評測代碼也是論文的一部分
EleutherAI lm-evaluation-harness、HELM、OpenAI Evals、Evalchemy、LiveBench 倉庫和 MMLU-Pro 官方代碼都說明了一個事實:評測不是幾行推理腳本,而是需要任務定義、數據加載、prompt 模板、輸出解析、日誌、版本化和結果彙總的工程系統。
復現論文時,不要只複製 leaderboard 命令。你要保存完整 config:模型 checkpoint 或 API 名稱、日期、temperature、top_p、max tokens、chat template、system prompt、few-shot examples、stop tokens、answer extractor、judge prompt、judge model、併發設置、失敗重試和無效樣本處理。對於 reasoning models,還要記錄是否剝離 thinking traces、是否允許長推理、最終答案抽取規則是否與原論文一致。
方法與實驗對比表
| 閱讀分支 | 代表資料 | 主要問題 | 精讀時必須檢查 |
|---|---|---|---|
| Holistic evaluation | HELM, VHELM, MedHELM | 如何系統覆蓋場景和指標 | scenario taxonomy、adaptation、metric、raw outputs |
| 靜態困難基準 | MMLU-Pro, GPQA, BBH | 如何提高難度與區分度 | 題源、專家驗證、prompt 穩定性、汙染風險 |
| 開放式評測 | MT-Bench, AlpacaEval, Arena-Hard, WildBench | 如何評價開放回答質量 | pairwise 協議、judge bias、長度控制、錯誤樣例 |
| 人類偏好 | Chatbot Arena, SimpleQA, GDPval | 人類標籤如何進入證據鏈 | 標註者、rubric、盲評、置信區間、分歧處理 |
| LLM-as-judge | Survey, Judge-Bench, PPE | 自動裁判是否可信 | 與人類相關性、位置/長度偏差、版本漂移 |
| 汙染檢測 | TS-Guessing, contamination reports | 高分是否被數據洩漏放大 | overlap 類型、時間切分、私有集、delayed release |
| 動態評測 | LiveBench, LiveCodeBench, YourBench | 如何保持題庫新鮮 | release 版本、公開策略、可驗證答案、日誌 |
復現建議
第一階段,復現一個 closed benchmark。選 MMLU-Pro 的 1-2 個 subject 或 GPQA 的公開 split,使用官方腳本或 lm-evaluation-harness,固定模型和推理參數。報告裡不要只寫 accuracy,要寫 prompt、few-shot、answer extraction、無效輸出數量和錯誤類別。
第二階段,復現一個 open-ended judge。選 AlpacaEval、MT-Bench 或 WildBench 的小樣本,跑兩個模型的回答,再用固定 judge prompt 做 pairwise 評測。必須做位置交換,至少抽樣 30 條人工複核,統計 judge 與人工分歧,並列出 5 個分歧案例。
第三階段,做 contamination audit。對你要使用的數據集查公開時間、Hugging Face / GitHub / leaderboard 暴露情況、是否有訓練集洩漏討論。若模型訓練 cutoff 不透明,就不要寫“無汙染”,只能寫“未發現公開證據,待人工核驗”。可以用近重複檢索、slot guessing 或時間切分作為補充。
第四階段,構建一個小型動態 benchmark。選一組 2026 年之後的課程講義、技術文檔或最新論文,按 YourBench 思路生成 50-100 個問題,再手動審核答案可驗證性。這個練習適合訓練“評測即研究”的能力:你會很快發現問題生成、答案唯一性、文檔 grounding 和難度分佈都不是自動解決的。
第五階段,寫 evaluation reproduction report。建議固定結構:任務定義、數據版本、模型版本、評測協議、運行環境、成本、失敗樣本、總體分數、子集分數、人工複核、汙染風險、與原論文差異、下一步修正。不要把復現報告寫成排行榜截圖。
常見誤區
第一,把排行榜當論文結論。leaderboard 是入口,不是證據鏈。沒有協議、置信區間和錯誤分析,排名很難說明機制。
第二,把 LLM judge 當客觀真值。judge 是一個有偏模型,必須被人類或可驗證任務校準。
第三,忽略 prompt 和輸出解析。選擇題 benchmark 的幾分提升可能來自 answer extractor,而不是模型能力。
第四,用靜態公開題庫評估新模型卻不討論汙染。公開越久、傳播越廣,越需要汙染審計。
第五,只看平均分。真正有研究價值的發現往往在子任務、錯誤切片、低置信樣本和模型間分歧裡。
適合研究生繼續做的選題
- 中文開放式評測 judge 校準:構建 200 條中文複雜指令,比較人類、LLM judge 和規則評分的一致性。
- Benchmark contamination audit 工具:針對 Hugging Face 數據集和 GitHub 題庫做公開暴露時間線與近重複檢索。
- Length bias 可視化研究:在 AlpacaEval 風格評測中系統控制回答長度,量化不同 judge 的偏差。
- Dynamic eval for papers:從最近 3 個月 arXiv 論文生成可驗證問答,評估模型是否能利用新知識。
- Evaluation report card:為論文評測部分設計一張 reproducibility checklist,並用 10 篇 LLM 論文做案例分析。
總結
Evaluation 論文的精讀重點,是把分數還原成證據生產流程。HELM 教你看場景和指標,MMLU-Pro / GPQA 教你看題目質量和難度驗證,Chatbot Arena / AlpacaEval / Arena-Hard 教你看開放回答與人類偏好,LLM-as-a-judge 論文教你審計裁判,LiveBench / LiveCodeBench / YourBench 和汙染檢測論文教你處理動態題庫與數據洩漏。
對研究生最實用的訓練方式,是從一個小型評測復現實驗開始:固定模型版本,保存完整 prompt 和輸出,跑自動評分,再做人工抽樣複核,最後把錯誤切片寫成新的研究問題。真正成熟的 evaluation 能力,不是知道哪個 benchmark 流行,而是能解釋一個分數為什麼可信、哪裡不可信,以及下一輪實驗應該怎樣改。
參考資料
檢索日期:2026-08-14。以下優先列出論文、官方項目頁、會議頁面、官方 GitHub / Hugging Face / leaderboard 文檔和一手資料;模型版本、API 行為、leaderboard 排名、benchmark release、代碼倉庫狀態和數據許可證可能變化,復現前請再次核對。
- Liang et al., “Holistic Evaluation of Language Models”, TMLR / OpenReview, 2023. https://openreview.net/forum?id=iO4LZibEqW
- Stanford CRFM, HELM official leaderboard and documentation. https://crfm.stanford.edu/helm/index.html
- BIG-bench repository, Google. https://github.com/google/BIG-bench
- Suzgun et al., “Challenging BIG-Bench Tasks and Whether Chain-of-Thought Can Solve Them”, arXiv, 2022. https://arxiv.org/abs/2210.09261
- Wang et al., “MMLU-Pro: A More Robust and Challenging Multi-Task Language Understanding Benchmark”, arXiv / NeurIPS 2024, official repository. https://github.com/TIGER-AI-Lab/MMLU-Pro
- TIGER-Lab MMLU-Pro dataset card. https://huggingface.co/datasets/TIGER-Lab/MMLU-Pro
- Rein et al., “GPQA: A Graduate-Level Google-Proof Q&A Benchmark”, arXiv, 2023. https://arxiv.org/abs/2311.12022
- Zheng et al., “Judging LLM-as-a-judge with MT-Bench and Chatbot Arena”, arXiv, 2023. https://arxiv.org/abs/2306.05685
- Chatbot Arena official blog / LM Arena. https://arena.ai/blog/arena
- Chiang et al., “Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference”, arXiv, 2024. https://arxiv.org/abs/2403.04132
- AlpacaEval official repository. https://github.com/tatsu-lab/alpaca_eval
- Li et al., “From Crowdsourced Data to High-Quality Benchmarks: Arena-Hard and BenchBuilder Pipeline”, arXiv / official repository, 2024. https://github.com/lmarena/arena-hard-auto
- Lin et al., “WildBench: Benchmarking LLMs with Challenging Tasks from Real Users in the Wild”, arXiv / official repository, 2024. https://github.com/allenai/WildBench
- Li et al., “From Generation to Judgment: Opportunities and Challenges of LLM-as-a-judge”, ACL Anthology / EMNLP 2025. https://aclanthology.org/2025.emnlp-main.138/
- Bavaresco et al., “LLMs instead of Human Judges? A Large Scale Empirical Study across 20 NLP Evaluation Tasks”, ACL Anthology, 2025. https://aclanthology.org/2025.acl-short.20/
- Thakur et al., “Judging the Judges: Evaluating Alignment and Vulnerabilities in LLMs-as-Judges”, ACL Anthology GEM 2025. https://aclanthology.org/2025.gem-1.33/
- Frick et al., “Preference Proxy Evaluations”, LM Arena blog / arXiv / repository, 2024. https://arena.ai/blog/preference-proxy-evaluations/
- OpenAI Evals official page. https://evals.openai.com/
- OpenAI Evals repository. https://github.com/openai/evals
- OpenAI, “Introducing SimpleQA”, 2024. https://openai.com/index/introducing-simpleqa/
- EleutherAI lm-evaluation-harness official repository. https://github.com/EleutherAI/lm-evaluation-harness
- LiveBench official site. https://livebench.ai/
- LiveBench official repository. https://github.com/LiveBench/LiveBench
- White et al., “LiveBench: A Challenging, Contamination-Free LLM Benchmark”, ICLR 2025 / project links. https://crwhite.ml/
- Jain et al., “LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code”, ICLR 2025. https://proceedings.iclr.cc/paper_files/paper/2025/hash/94074dd5a072d28ff75a76dabed43767-Abstract-Conference.html
- Deng et al., “Investigating Data Contamination in Modern Benchmarks for Large Language Models”, ACL Anthology / NAACL 2024. https://aclanthology.org/2024.naacl-long.482/
- Li et al., “An Open-Source Data Contamination Report for Large Language Models”, ACL Anthology / Findings EMNLP 2024. https://aclanthology.org/2024.findings-emnlp.30/
- “A Comprehensive Survey of Contamination Detection Methods in Large Language Models”, OpenReview. https://openreview.net/forum?id=SxNMjbtdFm
- Xu et al., “Benchmark Data Contamination of Large Language Models: A Survey”, arXiv, 2024. https://arxiv.org/abs/2406.04244
- Shashidhar et al., “YourBench: Easy Custom Evaluation Sets for Everyone”, OpenReview / COLM 2025. https://openreview.net/forum?id=bkWERVKzuP
- Hugging Face YourBench repository. https://github.com/huggingface/yourbench
- Hugging Face Open LLM Leaderboard documentation. https://huggingface.co/docs/leaderboards/main/open_llm_leaderboard/about