日期:2026-08-13
適合讀者:研究生、AI safety / alignment 入門研究者、有工程背景的 AI 讀者
檢索日期:2026-08-13
摘要
Safety / Alignment 論文很容易被讀成“模型應該怎樣回答”的規範討論,但科研訓練真正要抓住的是:威脅如何被發現,安全邊界如何定義,偏好數據如何進入訓練目標,拒答與過拒答如何同時評估,以及模型能否在不越界的前提下保持有用。這條線的論文不應只看安全分數,更要看 taxonomy、數據構造、攻擊強度、評測裁判、錯誤分析和復現邊界。
這篇文章給出一條從 red teaming 到 controllable generation 的精讀路線。先讀 RLHF、Constitutional AI 和 Safe RLHF,理解“安全行為”如何被寫進訓練目標;再讀 red teaming、jailbreak benchmark、refusal benchmark 和 moderation model,理解安全評測為什麼不是單一準確率;最後讀 safe completion、constitutional classifiers 和 frontier safety framework,理解 2025-2026 年的趨勢:安全研究正在從“輸入是否該拒絕”轉向“輸出是否在約束內儘量有用”,從靜態聊天模型轉向多步驟、工具化和高風險能力場景。
為什麼這個主題重要
對研究生來說,Safety / Alignment 是一個很適合訓練科研判斷力的方向,因為它天然要求你同時處理方法、數據、評測和價值邊界。一個模型拒絕危險請求,可能是安全能力,也可能是過度保守;一個模型在 jailbreak benchmark 上表現好,可能是訓練得更魯棒,也可能是 benchmark 被汙染、裁判太寬或攻擊不夠強;一個偏好優化方法提升 harmlessness,可能犧牲 helpfulness,也可能只是讓模型更擅長說“抱歉”。
2025-2026 年的變化讓這條線更值得系統精讀。OpenAI 的 safe-completion 思路把焦點從“按輸入二分類為 comply/refuse”轉向“在輸出層面最大化安全約束內的幫助度”;Anthropic 的 Constitutional Classifiers 和後續 Constitutional Classifiers++ 把 constitution、合成數據、輸入/輸出或 exchange classifier、線性 probe 和級聯架構結合起來,用來抵抗 universal jailbreak;Google DeepMind 和 Anthropic 的 frontier safety framework / responsible scaling policy 則把模型評測放到能力閾值、部署緩解、外部評估和持續紅隊的生命週期裡。
這不是說每篇博客都要討論治理。相反,科研訓練要把這些資料拆回可操作問題:怎樣構造攻擊集?怎樣定義不該拒絕的安全請求?怎樣測量 harmful compliance、false refusal、helpfulness 和 severity?怎樣記錄 judge model 的版本和誤判?怎樣把負結果寫成下一篇論文的研究問題?
核心閱讀方法
讀 Safety / Alignment 論文時,建議用五個問題建立筆記模板。
第一,論文的安全對象是什麼?是普通聊天模型、工具調用 agent、多模態模型、代碼模型、文本到圖像模型,還是 frontier model 的高風險能力?對象不同,風險邊界不同。聊天模型的 harmful text 與 agent 的真實世界動作不是同一類失誤,多模態模型還會引入圖像輸入、視覺 jailbreak 和跨模態拒答。
第二,taxonomy 從哪裡來?安全論文經常先定義 harmful category、policy category 或 risk category。讀者要檢查這些類別是來自公開政策、法規、專家標註、已有 benchmark,還是作者自定義。taxonomy 越細,越利於錯誤分析;但越細,也越容易出現類別重疊、文化偏差和標註不一致。
第三,方法優化的目標是什麼?RLHF 把人類排序轉成 reward model;Constitutional AI 用原則驅動 self-critique、revision 和 RLAIF;Safe RLHF 把 helpfulness reward 與 harmlessness cost 解耦;DPO / preference optimization 則繞過顯式 RL,但仍依賴偏好對質量。讀論文時要問:它到底優化“拒絕危險內容”,還是優化“安全且有幫助的輸出”?
第四,評測同時看兩側了嗎?安全評測至少要看 harmful compliance 和 false refusal 兩個方向。只看 attack success rate,容易獎勵“拒絕一切”;只看 helpfulness,容易忽略危險請求。XSTest、SORRY-Bench、StrongREJECT、HarmBench、WildGuard、SALAD-Bench 等資料的共同教訓是:拒答邊界本身需要獨立評估。
第五,裁判是否可靠?很多安全 benchmark 使用 LLM-as-judge、moderation classifier 或規則判定。你要記錄 judge model、prompt、溫度、輸出解析、人工抽樣審核和 disagreement case。安全論文的復現報告裡,judge 的誤差不是附錄細節,而是核心實驗條件。
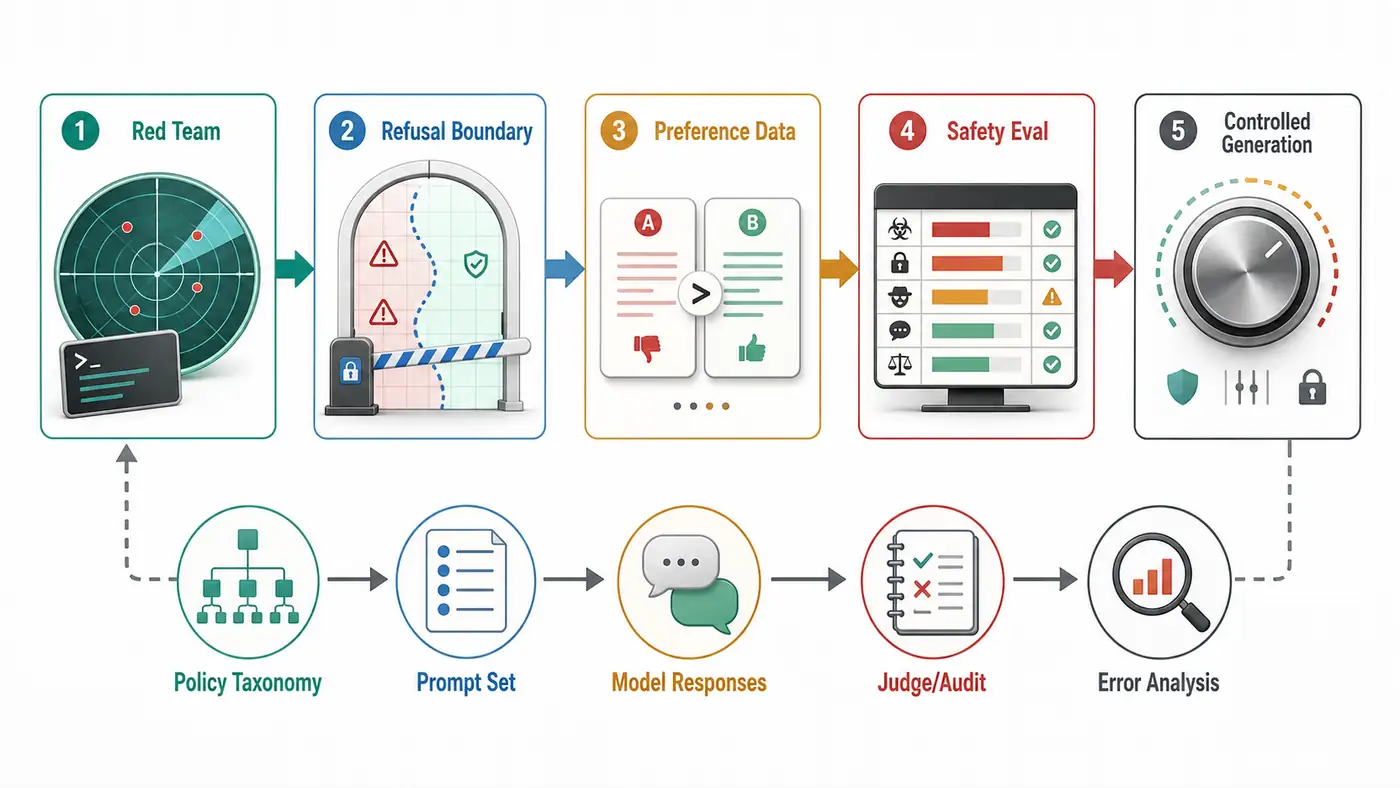
代表論文路線圖
1. 從 RLHF 到 Constitutional AI:安全行為如何進入訓練目標
入門第一篇仍然是 InstructGPT / RLHF。它說明了現代對齊訓練的基本範式:先用人工示範做 supervised fine-tuning,再讓標註者比較多個模型輸出,用 ranking 訓練 reward model,最後用強化學習優化模型行為。精讀時不要只記“RLHF 讓模型更聽話”,而要拆出三個變量:prompt distribution、labeler guideline、reward model 的泛化。
接著讀 Anthropic 的 red teaming 和 Constitutional AI。前者重要在於把 red team 從零散攻擊變成數據生產和測量流程:人類或模型持續尋找有害輸出,再把失敗案例反饋給訓練與評測。後者重要在於把“原則”顯式放進訓練過程,用 self-critique、revision 和 AI feedback 減少對人工 harmlessness 標註的依賴。這裡的關鍵訓練問題是:原則文本如何影響行為?模型是否只是學會更禮貌地拒絕?對 harmlessness 的改進是否伴隨 helpfulness 下降?
Safe RLHF 和 BeaverTails 適合放在第三步讀。BeaverTails 把 helpfulness 與 harmlessness 分開標註,Safe RLHF 把安全約束寫成 cost model 和 constrained optimization。它提醒研究生:安全對齊不是單目標優化,而是約束優化。復現時不要只報告一個平均勝率,要分別報告幫助度、安全性和二者衝突時的行為。
2. Red Teaming 與 Jailbreak Benchmark:攻擊不是越花哨越好
Red teaming 論文要重點看攻擊預算、攻擊目標和成功定義。Anthropic 2022 red teaming 工作釋放了大規模 red-team attack 數據並討論模型規模、訓練方式與可紅隊性的關係;DeepMind 早期工作展示了用語言模型自動生成 red-team prompts;HarmBench 和 JailbreakBench 進一步把攻擊方法、目標模型、harmful behaviors 和 evaluator 標準化。
StrongREJECT 值得單獨讀,因為它指出了一個常見陷阱:很多 jailbreak 評測會把“模型沒有明確拒絕”誤當作“攻擊成功”,但真實風險還取決於輸出是否具體、可執行、有害。對研究生來說,這篇論文的價值不只是數據集,而是評測觀念:attack success 需要同時判斷 willingness 和 capability。
復現這類論文時,建議從小規模開始。選 20-50 個公開 harmful prompts,準備 2-3 種 attack wrapper,固定目標模型版本,保存完整 prompt、response、judge rationale 和人工複核標籤。不要在公開博客裡傳播可執行的有害細節,可以只展示抽象類別、脫敏樣例和統計摘要。
3. 拒答與過拒答:安全邊界是一條可測量的曲線
拒答不是越多越好。XSTest 的核心貢獻是構造一組“看起來像危險請求、實際安全”的 prompts,用來測 exaggerated safety behavior。SORRY-Bench 則系統評估安全拒答行為在不同模型和主題上的差異。WildGuard 把 prompt harmfulness、response harmfulness 和 refusal detection 放在一個開放 moderation 工具中,說明安全評估不僅要判斷輸入,還要判斷模型輸出和拒答行為。
這一線論文最好按混淆矩陣來讀:unsafe prompt + unsafe compliance 是高風險失敗;unsafe prompt + safe refusal 或 safe completion 是目標行為;safe prompt + refusal 是 false refusal;safe prompt + useful answer 是可用性。很多論文只展示平均 safety score,但你應該追問每一格的錯誤樣例。
OpenAI 的 Model Spec 和 safe-completion 資料可以作為“拒答風格”的一手參照。safe completion 的核心不是把拒答寫得更委婉,而是在不能提供危險細節時,仍儘量給出安全範圍內有用的替代信息。讀這類資料時要保持邊界意識:它們是模型行為規範與訓練思路,不等同於完全可復現的學術 benchmark;若要寫論文,需要把規範轉換成可標註、可評測的數據任務。
4. 偏好對齊與安全數據:數據比算法名更重要
RLHF、DPO、RLAIF、Safe RLHF、Constitutional AI 的共同瓶頸是數據。安全偏好數據至少包含四個層次:危險請求的類別,模型輸出的危險程度,安全替代回答的幫助度,以及標註者或原則對邊界的解釋。只收集“拒絕 vs 不拒絕”會把問題壓扁。
BeaverTails 的價值在於分離 helpfulness / harmlessness;PKU-SafeRLHF 的開源代碼與數據讓研究者可以復現 reward model、cost model 和 constrained fine-tuning;2025 年的 Safe RLHF-V 把這套思路擴展到多模態人類反饋,說明圖像輸入下的安全標註需要多級風險標籤和 guardrail。未來安全數據的關鍵不是規模本身,而是邊界樣本、雙用途樣本、跨語言樣本和 adversarial examples 的覆蓋。
讀偏好優化論文時,可以用一個硬問題檢查它:如果 benign prompt 包含危險詞彙,但用戶意圖明顯安全,模型是否能回答?如果 dual-use prompt 可能被濫用,模型能否提供高層、合規、不可執行的幫助?如果攻擊者用編碼、角色扮演、翻譯、長上下文或工具反饋繞過邊界,訓練方法是否仍有效?
5. 可控生成與系統級防護:從模型參數到運行時保障
可控生成不是簡單加一個 system prompt。安全控制可以發生在預訓練數據過濾、SFT、偏好優化、拒答訓練、output shaping、classifier guardrail、tool permission、human confirmation 和 deployment monitoring 等多個層面。2025-2026 年的趨勢是多層防護:模型自身學習安全邊界,外部 classifier 監控輸入輸出,系統層限制高風險動作,並通過紅隊持續更新數據。
Anthropic 的 Constitutional Classifiers 和 Constitutional Classifiers++ 是很好的精讀材料。前者用 constitution 生成合成訓練數據,訓練輸入和輸出 classifier 來防 universal jailbreak;後者引入更高效的級聯結構和內部 activation probe,以降低計算開銷和過拒答。閱讀時不要只看“攻擊成功率下降”,還要看 harmless query refusal rate、compute overhead、紅隊時長、是否發現 universal jailbreak,以及演示環境與真實部署的差異。相關數字和 demo 結論隨版本變化,寫作前必須重新核對。
Google DeepMind 的 Frontier Safety Framework 和 Anthropic 的 Responsible Scaling Policy 則提醒我們:安全對齊論文正在與能力評估、模型安全報告和部署閾值連接。對研究生而言,最實用的讀法是把這些框架轉成實驗清單:風險類別、能力閾值、評測集、緩解措施、殘餘風險、外部評審和更新機制。
方法與實驗對比表
| 閱讀分支 | 代表資料 | 主要問題 | 精讀時必須檢查 |
|---|---|---|---|
| RLHF / RLAIF | InstructGPT, Constitutional AI | 如何把偏好和原則寫進訓練 | prompt 分佈、標註規範、reward 泛化、helpfulness 損失 |
| 安全約束優化 | Safe RLHF, BeaverTails | 如何分離幫助度和無害性 | reward/cost 定義、衝突樣例、約束是否滿足 |
| Red teaming | Anthropic red teaming, HarmBench, JailbreakBench | 如何發現和衡量攻擊 | 攻擊預算、目標模型、成功定義、人工複核 |
| 拒答評測 | XSTest, SORRY-Bench, StrongREJECT | 何時拒絕、何時不該拒絕 | false refusal、harmful compliance、judge 誤差 |
| Moderation / guardrail | WildGuard, SALAD-Bench, Constitutional Classifiers | 如何在系統外層攔截風險 | 輸入/輸出覆蓋、延遲、誤殺率、繞過策略 |
| 輸出可控 | safe completion, Model Spec | 如何在安全約束內保持有用 | dual-use 分類、替代幫助、severity 分級 |
| Frontier safety | GDM FSF, Anthropic RSP, OpenAI system cards | 高風險能力如何進入發佈流程 | 能力閾值、緩解計劃、外部評估、版本更新 |
復現建議
第一階段,復現一個拒答邊界評測。用 XSTest 或自建小型對照集,構造 safe / unsafe 成對 prompts。每條記錄至少包含 prompt、預期標籤、模型回答、是否拒答、回答是否有用、人工備註。指標不要只算 accuracy,要分別算 unsafe refusal rate、harmful compliance rate 和 safe false refusal rate。
第二階段,復現一個 jailbreak evaluator。可以選 StrongREJECT 或 HarmBench 的公開實現,先不要擴展攻擊,只跑固定 prompts 和固定模型版本。重點記錄 judge prompt、judge model、解析規則和人工抽樣一致性。如果 LLM judge 與人工判斷衝突,把衝突樣例寫進報告正文,而不是藏在附錄。
第三階段,復現一個偏好數據分析。取 BeaverTails 或 PKU-SafeRLHF 的一小部分,統計 helpfulness 與 harmlessness 衝突樣例,手動分類哪些樣本適合 hard refusal、哪些適合 safe completion、哪些需要澄清。這個練習比盲目訓練 DPO 更能訓練研究直覺。
第四階段,做一個受控生成小實驗。定義一個安全政策子集,例如 cyber 或 bio 的高層信息邊界;為每類 prompt 寫允許、限制、拒絕三種目標輸出;讓模型生成回答後,用人工和 judge 雙重標註 severity。報告中必須寫清楚:哪些內容被脫敏,哪些模型版本待人工核驗,哪些結果不可外推到真實部署。
第五階段,寫 reproduction report。安全方向的報告至少包括:檢索日期、模型版本、API 或 checkpoint、policy taxonomy、數據來源、脫敏策略、judge 設置、人工複核比例、錯誤類型、負結果和倫理邊界。不要發佈可直接複用的危險操作細節。
常見誤區
第一,把 safety score 當單一排名。安全是多目標問題,平均分會掩蓋某個高風險類別的失敗。
第二,把“拒絕更多”當“更安全”。過拒答會損害模型在教育、醫療科普、新聞分析和安全研究中的正常用途。
第三,把 jailbreak prompt 的花哨程度當貢獻。真正的貢獻是更清晰的威脅模型、更可靠的成功定義、更難的數據洩漏和更強的人工複核。
第四,忽略 judge model 漂移。模型評審器、moderation API 和安全政策都會更新;復現時必須固定版本,並在文中寫明檢索日期。
第五,在博客裡洩露有害細節。安全研究可以討論類別、方法論和脫敏案例,不應該為了展示攻擊有效性而傳播可執行步驟。
適合研究生繼續做的選題
- 中文 XSTest 風格過拒答基準:構造包含敏感詞但意圖安全的中文 prompts,並做人工標註一致性分析。
- Safe completion 評分 rubrics:把“安全替代幫助”拆成 severity、specificity、usefulness、policy compliance 四個維度。
- Red-team evaluator 可靠性研究:比較 LLM judge、規則判定和人工標註在 jailbreak 成功判定上的分歧。
- 偏好數據衝突地圖:分析 BeaverTails / SafeRLHF 中 helpfulness 與 harmlessness 標籤衝突的主題分佈。
- Agent refusal 邊界實驗:把安全評測從單輪文本擴展到 tool-use trajectory,研究何時應 plan、ask、act 或 refuse。
總結
Safety / Alignment 論文的精讀重點不是背算法名,而是建立證據鏈:先定義風險 taxonomy,再構造攻擊和邊界樣本,然後用可複核的裁判評估模型輸出,最後分析安全性與幫助度的張力。RLHF 和 Constitutional AI 告訴我們安全行為如何進入訓練;HarmBench、StrongREJECT、XSTest、SORRY-Bench 和 WildGuard 告訴我們評測本身會出錯;safe completion 和 Constitutional Classifiers 則代表了更近的方向:在輸出層面做細粒度控制,並把模型級訓練與系統級防護結合起來。
對研究生最實用的訓練方式,是從一個小型拒答邊界評測開始。你不需要先訓練一個模型,但必須學會寫 policy taxonomy、構造對照 prompt、固定 judge、複核錯誤樣例、保護有害細節,並把負結果轉成下一步研究問題。
參考資料
檢索日期:2026-08-13。以下優先列出論文、官方項目頁、會議頁面和一手資料;模型版本、API 行為、安全政策、demo 結果、benchmark leaderboard 和代碼倉庫狀態可能變化,復現前請再次核對。涉及紅隊和 jailbreak 的資料應只用於合規研究與防禦性評估;危險樣例需脫敏處理。
- Ouyang et al., “Training language models to follow instructions with human feedback”, arXiv, 2022. https://arxiv.org/abs/2203.02155
- Ganguli et al., “Red Teaming Language Models to Reduce Harms: Methods, Scaling Behaviors, and Lessons Learned”, arXiv / Anthropic, 2022. https://arxiv.org/abs/2209.07858
- Perez et al., “Red Teaming Language Models with Language Models”, Google DeepMind, 2022. https://deepmind.google/blog/red-teaming-language-models-with-language-models/
- Bai et al., “Constitutional AI: Harmlessness from AI Feedback”, arXiv / Anthropic, 2022. https://arxiv.org/abs/2212.08073
- Anthropic, “Claude's Constitution”, updated 2026. https://www.anthropic.com/news/claudes-constitution
- Rottger et al., “XSTest: A Test Suite for Identifying Exaggerated Safety Behaviours in Large Language Models”, arXiv, 2023. https://arxiv.org/abs/2308.01263
- Ji et al., “BeaverTails: Towards Improved Safety Alignment of LLM via a Human-Preference Dataset”, NeurIPS 2023 / arXiv. https://arxiv.org/abs/2307.04657
- Dai et al., “Safe RLHF: Safe Reinforcement Learning from Human Feedback”, arXiv, 2023. https://arxiv.org/abs/2310.12773
- PKU-Alignment safe-rlhf repository. https://github.com/PKU-Alignment/safe-rlhf
- Mazeika et al., “HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal”, arXiv, 2024. https://arxiv.org/abs/2402.04249
- Souly et al., “A StrongREJECT for Empty Jailbreaks”, arXiv, 2024. https://arxiv.org/abs/2402.10260
- StrongREJECT dataset page. https://huggingface.co/datasets/walledai/StrongREJECT
- Li et al., “SALAD-Bench: A Hierarchical and Comprehensive Safety Benchmark for Large Language Models”, arXiv, 2024. https://arxiv.org/abs/2402.05044
- Han et al., “WildGuard: Open One-Stop Moderation Tools for Safety Risks, Jailbreaks, and Refusals of LLMs”, NeurIPS 2024 / arXiv. https://arxiv.org/abs/2406.18495
- Xie et al., “SORRY-Bench: Systematically Evaluating LLM Safety Refusal”, ICLR 2025 project page. https://sorry-bench.github.io/
- Ji et al., “AI Alignment: A Contemporary Survey”, ACM Computing Surveys, 2025. https://doi.org/10.1145/3770749
- Lu et al., “Alignment and Safety in Large Language Models: Safety Mechanisms, Training Paradigms, and Emerging Challenges”, arXiv, 2025. https://arxiv.org/abs/2507.19672
- Zhang et al., “Safe RLHF-V: Safe Reinforcement Learning from Multi-modal Human Feedback”, arXiv, 2025. https://arxiv.org/abs/2503.17682
- OpenAI, “From hard refusals to safe-completions: toward output-centric safety training”, 2025. https://openai.com/index/gpt-5-safe-completions/
- OpenAI Model Spec repository. https://github.com/openai/model_spec/blob/main/model_spec.md
- Anthropic, “Constitutional Classifiers: Defending against universal jailbreaks”, 2025. https://www.anthropic.com/news/constitutional-classifiers
- Anthropic, “Next-generation Constitutional Classifiers: More efficient protection against universal jailbreaks”, 2026. https://www.anthropic.com/research/next-generation-constitutional-classifiers
- Google DeepMind, “Frontier safety”, latest framework page checked 2026-08-13. https://deepmind.google/frontier-safety/
- Google DeepMind, “Evaluating Frontier Models for Dangerous Capabilities”, arXiv / publication page, 2024. https://deepmind.google/research/publications/78150/
- Anthropic, “Responsible Scaling Policy”, latest page checked 2026-08-13. https://www.anthropic.com/responsible-scaling-policy