日期:2026-08-15
適合讀者:研究生、LLM 預訓練入門研究者、有工程背景的 AI 讀者
檢索日期:2026-08-15
摘要
Data-Centric AI 的核心問題不是“數據越多越好”,而是:什麼數據在什麼訓練階段、什麼模型規模、什麼評測目標下真正有用?對 LLM 研究來說,這個問題已經從經驗工程變成可以讀論文、做 ablation、寫復現報告的研究主題。DCLM、FineWeb、RedPajama、Dolma/OLMo、Nemotron-CC 等資料把數據篩選、去重、質量評分、數據混合、合成改寫和評測反饋逐漸公開化;WIMBD、Data-Juicer、NeMo Curator 等工具則讓語料審計和處理流程更可復現。
這篇文章給出一條 Data-Centric AI 論文精讀路線:先讀經典去重與數據選擇論文,理解重複、汙染和分佈匹配;再讀 DCLM、FineWeb、RedPajama、Dolma/OLMo 這類開放數據工程報告,學習如何把語料處理變成可對比實驗;然後讀 2025 年以來的 FineWeb 2、Nemotron-CC、REWIRE、JQL、DataPrep-Bench 等資料,理解數據質量評估正在從啟發式過濾走向模型判別、合成數據驗證和訓練效用預測。本文重點服務科研訓練:如何讀、如何拆、如何復現,以及如何從數據問題形成自己的研究選題。
目錄
- 為什麼這個主題重要
- 核心閱讀方法
- 代表論文路線圖
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結與參考資料
為什麼這個主題重要
LLM 論文裡最容易被低估的部分,往往是數據。很多模型報告會詳細寫參數量、優化器、上下文長度和 benchmark 分數,卻只用幾句話概括訓練語料:“filtered web data, code, math, books, synthetic data”。但如果你真正想復現或改進模型,數據部分通常比架構部分更難:原始網頁如何抽取?哪些規則刪掉了低質頁面?重複文本是按 exact hash、MinHash 還是 semantic dedup 去掉?質量分類器是用什麼正負樣本訓練的?被過濾掉的數據是否真的沒價值?合成數據是補充、改寫還是替代自然數據?這些問題決定了訓練成本、泛化能力、汙染風險、隱私風險和論文結論的可信度。
2025-2026 年的變化尤其明顯。DCLM 把“固定模型和訓練代碼,只競爭數據”做成 benchmark;FineWeb 和 FineWeb 2 公開了 Common Crawl 清洗、去重、過濾和多語言擴展流程;Nemotron-CC 把質量分類、去重和合成數據生成組織成可運行 recipe;OLMo 2 繼續強調 fully open 的訓練數據、訓練代碼和評測;DataPrep-Bench 開始把“LLM 能否準備訓練數據”本身作為 benchmark。這些工作說明,Data-Centric AI 已經不是附錄裡的工程雜項,而是 LLM 研究裡的主線問題。
對研究生來說,本主題的訓練價值在於三點。第一,它迫使你把“模型提升”拆成可驗證因果因素,而不是把所有提升歸功於新架構。第二,它天然適合小規模復現:你不需要訓練 70B 模型,也可以在 100M-1B 規模上覆現過濾、去重、混合、合成數據的方向性結論。第三,它能產生很多可靠 follow-up idea,因為開放數據工程仍有大量未解決問題:跨語言質量評分、合成數據汙染、領域數據保真、benchmark leakage、數據選擇與學習率 schedule 的耦合等。
核心閱讀方法
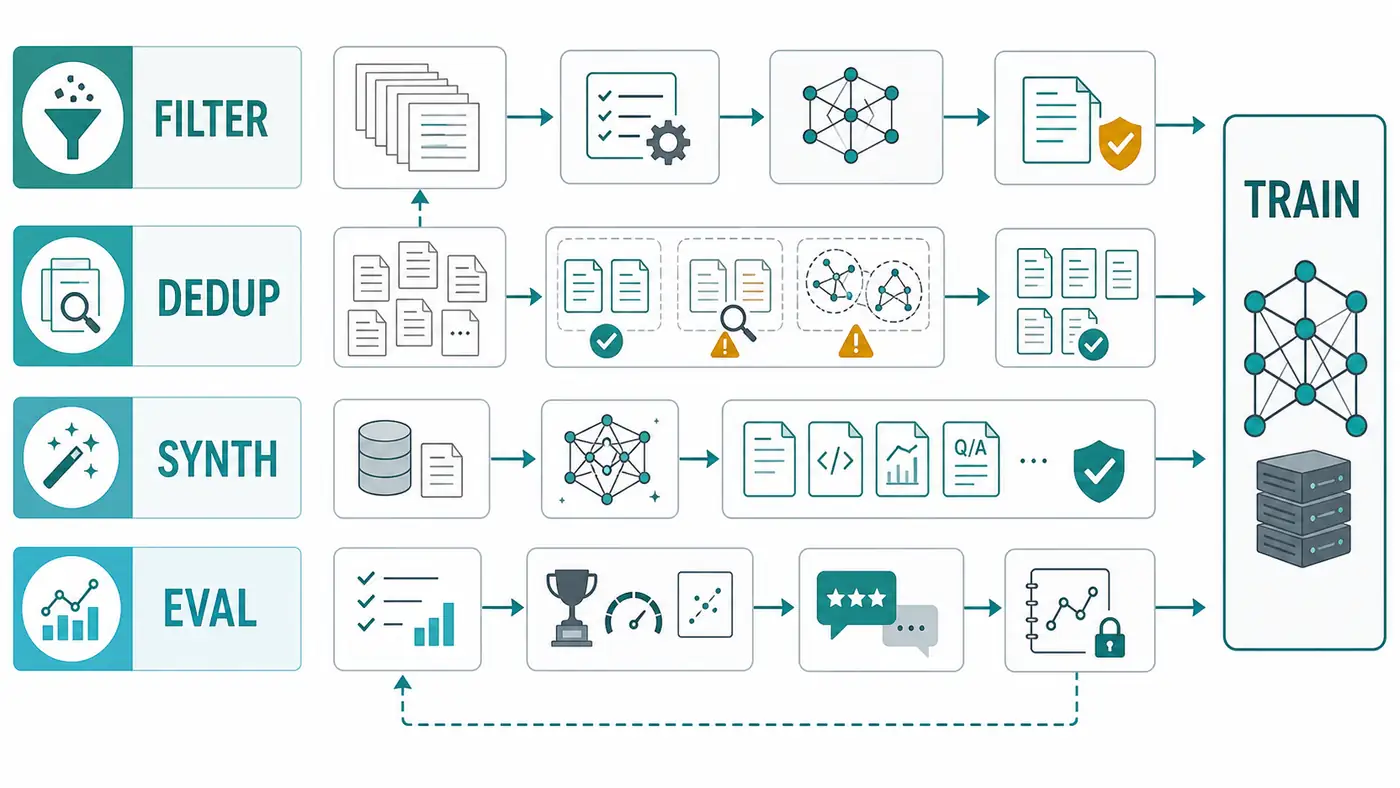
讀 Data-Centric AI 論文時,建議先畫一條“數據生命週期線”,不要直接看最終分數。
第一,原始語料是什麼。記錄來源、時間範圍、語言、許可證、格式和規模。Common Crawl、GitHub、arXiv、StackExchange、Wikipedia、書籍、考試題、用戶對話和合成問答代表完全不同的數據分佈。不要把“web data”當成一個均質概念。
第二,處理流程是什麼。把 pipeline 拆成 extraction、language ID、PII 處理、規則過濾、質量分類、exact dedup、fuzzy dedup、semantic dedup、domain mixing、tokenization、shuffling、evaluation。每一步都要問:輸入是什麼,輸出刪了多少,判斷信號來自哪裡,是否保留被刪樣本的 metadata。
第三,質量如何定義。很多論文說 high-quality data,但質量可能指可讀性、教育價值、低重複、低毒性、低 PII、與目標域相似、能提升 MMLU、能提升代碼能力,或者能改善安全性。質量不是單標量;Longpre 等人的 pretrainer's guide 已經提示,質量過濾、毒性過濾、領域覆蓋之間存在 trade-off,不能用一個分數解釋所有任務。
第四,證據來自哪裡。最強證據不是“過濾器看起來合理”,而是 controlled ablation:同一模型、同一 tokenizer、同一訓練預算、同一評測協議,只改變數據處理策略。DCLM 的價值就在於把數據研究放進固定訓練代碼和 50 多個下游評測的 testbed 中。
第五,復現邊界是否清楚。數據論文必須交代代碼、配置、隨機種子、Common Crawl snapshot、模型規模、訓練 tokens、評測版本和失敗樣例。若只發布最終 dataset 而沒有處理腳本,後續研究只能使用,不能真正解釋。
代表論文路線圖
1. 從去重開始:重複不是小問題
第一組必讀論文是 Deduplicating Training Data Makes Language Models Better 和 Deduplicating Training Data Mitigates Privacy Risks in Language Models。前者顯示常見語料中存在近重複和長重複片段,去重可以降低模型無提示覆述訓練文本的概率,並減少 train-test overlap 對評測的影響;後者進一步指出重複會放大隱私攻擊風險,訓練樣本出現次數與被再生成概率高度相關。讀這兩篇時,不要只記“要去重”,而要區分三件事:訓練集內部重複、訓練集與驗證/測試集重疊、以及長 substring memorization。
第二層是 fuzzy / semantic dedup。FineWeb 使用 MinHash 處理網頁近重複;DCLM baseline 包含清洗、Bloom filter 去重和模型過濾;SemDeDup 則把重複從文本表面相似擴展到語義相似,通過 embedding、聚類和相似度閾值刪掉冗餘樣本。這裡的精讀問題是:刪掉重複後,模型到底少學了噪聲,還是少見了某些高頻事實?FineWeb 的一個重要啟發是,跨全部 Common Crawl dump 的全局去重並不必然優於按 dump 去重,因為過強去重可能改變時間和質量分佈。去重不是越激進越好。
復現訓練可以從一個小語料開始:取 5-10GB 網頁文本,做 exact hash、MinHash 和 embedding-based semantic dedup 三種版本;訓練同一小模型或做 continued pretraining;比較 validation loss、MMLU 子集、memorization probe、重複率和領域覆蓋變化。這樣比直接閱讀“某某數據集更強”更能理解因果鏈。
2. 數據選擇與混合:好數據取決於目標分佈
DSIR 和 DoReMi 是理解數據選擇的兩條經典路線。DSIR 把數據選擇形式化為從大規模未標註 raw corpus 中選擇子集,使其在低維特徵空間中接近目標分佈;DoReMi 則用 proxy / reference 模型的 excess loss 自動優化多域數據混合權重。它們共同說明,數據質量並不只是刪低質文本,也包括“讓訓練分佈對目標任務有用”。
讀這類論文時,建議建立三個層次:document-level selection、domain-level mixing、schedule-level curriculum。document-level selection 關心單篇文本是否保留;domain-level mixing 關心 web、code、math、books、academic、instruction data 的比例;curriculum 關心訓練階段順序。2026 年 ICLR 關於 curriculum-based LLM pretraining 的工作還提醒,數據質量順序與學習率 decay 可能發生衝突:高質量數據如果總在低學習率階段出現,可能被“浪費”。這類結論很適合研究生做小規模驗證。
3. DCLM、FineWeb、RedPajama:把數據工程變成實驗科學
DCLM 是 Data-Centric AI 路線的核心節點。它固定訓練代碼和模型規模,讓研究者從 Common Crawl 候選池中設計過濾和混合策略,再用統一評測判斷數據是否更好。官方頁面強調“models are fixed and the challenge is data”,這對科研訓練很重要:你可以把模型創新的噪聲降到最低,專注研究數據處理本身。DCLM 官方倉庫在 2025 年還提示 CORE / EXTENDED 計算曾有 baseline bug 修復,因此歷史 leaderboard 數字不能無條件橫向比較;這也是讀數據 benchmark 時必須記錄版本的例子。
FineWeb 的價值是透明化 web-scale pipeline。它從 Common Crawl 出發,經過 URL filter、Trafilatura 抽取、語言過濾、Gopher / C4 / FineWeb 規則過濾和 MinHash 去重,並公開了大量 ablation。FineWeb-Edu 使用 Llama-3-70B-Instruct 對樣本教育質量打分,再訓練分類器篩選教育文本。讀 FineWeb 時要注意兩個問題:一是它把“教育質量”定義成面向知識和推理 benchmark 有用的過濾信號,而不是通用文本美學;二是它的 dedup ablation 說明數據分佈會被處理策略深刻改變。
RedPajama-V2 代表另一種設計哲學:儘量提供大規模數據池和 40+ 質量信號,讓研究者自己決定過濾策略。它不是隻發佈一個“最佳篩選版本”,而是把自然語言指標、重複度、perplexity bucket、質量分類器等 metadata 一起提供。對科研來說,這種 high-recall 數據池更適合做數據選擇實驗,因為你能回看被過濾樣本,而不是隻能接受最終成品。
Dolma/OLMo 則強調 fully open model flow。Dolma 提供 3T tokens 的混合語料和工具;OLMo 2 / OLMo 2 32B 頁面公開預訓練、mid-training、post-training 數據階段,例如 OLMo-Mix-1124、Dolmino-Mix-1124 和訓練 token 信息。讀 OLMo 資料時,重點不是背模型分數,而是學習“模型卡 + 數據卡 + 配置 + checkpoint + evaluation suite”如何組成可審計研究對象。
4. 2025-2026 趨勢:質量分類、合成改寫與多語言
FineWeb 2 把 FineWeb 的思路擴展到 1000+ 語言,並針對語言識別、每語種去重、每語種過濾閾值和 PII 匿名化做了適配。它提醒我們:英文 web pipeline 不能直接遷移到多語言。低資源語言的質量評分、重複率、腳本識別和過濾閾值都可能不同。
Nemotron-CC 是 2025 年以來很值得讀的數據工程案例。NVIDIA 的官方資料把 pipeline 寫成 Common Crawl -> Extract & Clean -> Deduplicate -> Quality Classify -> Synthetic Data Generation,並在 NeMo Curator 中提供 recipe。它的關鍵主張是:純粹過濾會丟掉大量中等質量但可轉化的數據,因此可以在高質量數據上做合成問答、知識抽取、改寫或翻譯,把數據量和質量之間的 trade-off 重新打開。官方博客給出 6.3T tokens、其中約 1.9T synthetic tokens 的版本信息;這些數字和後續 Nemotron-CC-v2 / v2.1 數據集會變化,正式引用前必須重新核對。
REWIRE / Recycling the Web 更直接地研究“被過濾掉的數據還能不能回收”。論文提出 guided rewrite,把低質量網頁轉化成更適合預訓練的文本,並在 DCLM benchmark 的 1B、3B、7B 規模上比較。它的科研價值在於把 synthetic data 從“憑空生成更多數據”變成“對現有網頁做可控轉換”。這也能避免 model collapse 文獻警告的一個極端:不要讓合成數據遞歸替代自然數據,而應把合成數據當成經過驗證的補充。
JQL 關注多語言質量過濾:用 LLM 標註能力蒸餾出輕量級 multilingual annotator,降低大規模過濾成本。DataPrep-Bench 則進一步把 LLM-driven data preparation 拆成 data construction 和 data quality evaluation,強調“質量”應指下游訓練效用,而不是表面文本屬性。這兩類工作說明,下一階段 Data-Centric AI 的關鍵詞會是 utility prediction:在真正訓練模型之前,能否預測一批數據是否值得訓練。
5. 數據審計工具:不要只信數據卡
WIMBD 問的是最樸素但最重要的問題:我的大數據裡到底有什麼?它用 count 和 search 支撐多種 corpus analysis,檢查重複、合成內容、低質量內容、PII、毒性語言和 benchmark contamination。讀 WIMBD 時要學習一種態度:數據卡裡的來源描述不等於數據現實;必須有可運行的審計工具和抽樣檢查。
Data-Juicer、NeMo Curator、datatrove、Dolma Toolkit 都值得作為復現實驗的基礎設施來讀。它們把過濾器、去重、質量分類、可視化、分佈式處理和日誌管理模塊化。研究生做數據論文時,工具選擇本身不是貢獻,但可復現 pipeline 是貢獻的前提。
方法與實驗對比表
| 分支 | 代表資料 | 核心問題 | 精讀時檢查 |
|---|---|---|---|
| 去重與隱私 | Lee et al. 2022, Kandpal et al. 2022, SemDeDup | 重複如何影響記憶、隱私和訓練效率 | exact/fuzzy/semantic 標準、閾值、刪減比例、保留策略 |
| 數據選擇 | DSIR, DoReMi, Pretrainer's Guide | 如何匹配目標分佈和優化混合比例 | 目標分佈、proxy model、domain weights、下游任務 |
| 開放數據工程 | DCLM, FineWeb, RedPajama, Dolma | 如何讓數據處理可審計、可復現 | pipeline、配置、代碼、snapshot、metadata、版本 |
| 多語言與低資源 | FineWeb 2, JQL | 英文過濾器能否遷移 | 語言識別、腳本、每語種閾值、低資源評測 |
| 合成與回收 | Nemotron-CC, REWIRE, model collapse | 合成數據何時有益,何時有害 | 原始來源、生成模型、驗證器、自然/合成比例 |
| 質量評估 | WIMBD, DataPrep-Bench | 如何預測訓練效用和風險 | 質量定義、PII、汙染、utility proxy、人工抽查 |
| 工具系統 | Data-Juicer, NeMo Curator, datatrove, Dolma Toolkit | 如何把 pipeline 跑起來 | operator、日誌、分佈式、失敗恢復、輸出審計 |
復現建議
第一階段,復現一個最小數據清洗 pipeline。選取一小批 Common Crawl WET、新聞網頁或開放英文語料,記錄原始文檔數、token 數、語言分佈、平均長度、重複率和 PII 命中。依次運行語言過濾、長度過濾、重複過濾,保留每一步 removed samples。重點不是追求最優過濾器,而是學會解釋“刪掉了什麼”。
第二階段,做去重 ablation。構造 raw、exact dedup、MinHash dedup、semantic dedup 四個版本,用同一 tokenizer 和同一訓練腳本訓練一個小模型,或者在小模型上做 continued pretraining。報告 validation loss、少量下游任務、memorization probe、領域覆蓋和樣本多樣性。負結果也要寫:如果 semantic dedup 傷害了某個領域,檢查是否刪掉了高頻但必要的模板或術語。
第三階段,做質量過濾 ablation。用一個開源質量分類器、一個啟發式規則集、一個 LLM judge 小樣本標註器分別篩選數據,訓練相同 token budget 的模型。比較“高分數據少量重複訓練”和“中等質量數據更多 unique tokens”的差異。不要把 MMLU 單項當成唯一結論,至少加入 perplexity、QA、代碼或數學子集,以及人工抽樣。
第四階段,做合成數據復現實驗。選擇 1-2 萬篇中低質量文檔,用一個開源模型改寫為更清晰的說明文、問答或知識點列表。必須加入 faithfulness check:改寫是否引入新事實、是否丟失細節、是否模板化。然後把自然高質量數據、自然中等質量數據、合成改寫數據按不同比例混合,測試是否存在收益上限。
第五階段,寫 reproduction report。報告必須包含:數據來源和檢索日期、處理腳本 commit、過濾配置、隨機種子、每一步保留比例、樣本審計截圖或片段、訓練預算、評測協議、失敗案例和“待人工核驗”項。Data-Centric AI 復現報告最怕只給最終分數;真正有價值的是讓別人能看懂數據如何變化。
常見誤區
誤區一,把質量等同於可讀性。可讀文本不一定對目標任務有用;低可讀性的代碼、公式、論壇問答、日誌和表格可能對特定能力很重要。
誤區二,把去重當成固定預處理。去重粒度、閾值和時間範圍會改變語料分佈。過度去重可能刪掉合理的重複教學材料,過弱去重則會放大記憶和汙染。
誤區三,把合成數據當作免費數據。合成數據需要來源、生成策略、去重、事實核驗和比例控制。Nature 2024 的 model collapse 論文警告的是遞歸訓練和無差別使用生成內容;它不否定經過驗證的合成數據,但要求我們記錄真實數據和合成數據的邊界。
誤區四,只看最終 benchmark。數據處理常常對不同任務方向相反:更教育化可能提升知識推理,但傷害自然對話或長尾風格;毒性過濾可能影響毒性識別任務;代碼過濾可能影響自然語言能力。必須看 slices。
誤區五,忽視版本漂移。DCLM leaderboard、Hugging Face dataset cards、Nemotron recipe、Common Crawl snapshots、質量分類器和合成模型都可能更新。論文寫作時要寫明檢索日期,易變化數字要重新核對。
適合研究生繼續做的選題
- 小模型上的 dedup scaling law:在 100M、300M、1B 三個規模上比較 exact / fuzzy / semantic dedup 的收益曲線,研究模型規模是否改變最佳去重強度。
- 多語言質量評分遷移:把英文質量分類器遷移到低資源語言,比較直接遷移、LLM 標註蒸餾和少量人工標註校準。
- 合成改寫的事實保真評測:設計一個文檔級 faithfulness benchmark,衡量 rewrite 是否保留實體、數值、引用和因果關係。
- 數據過濾與學習率 schedule:驗證高質量數據在訓練早期、中期、annealing 階段出現時的差異,復現 curriculum 與 LR decay 的耦合問題。
- 數據審計報告模板:為一個開放語料寫 WIMBD-style audit,包括重複、PII、汙染、領域分佈、合成痕跡和抽樣錯誤類型。
- Utility predictor:訓練一個輕量模型預測“某批數據用於 continued pretraining 後是否提升某類任務”,並與啟發式質量分數比較。
總結
Data-Centric AI 的研究訓練,最重要的是把“數據感覺更好”變成可復現證據。你需要讀懂 pipeline、版本、過濾器、去重算法、質量定義、合成策略和評測反饋;更要學會追問被刪除的數據、被保留的數據、被重複訓練的數據和被生成出來的數據分別帶來了什麼。
如果說前幾年 LLM 研究的主線是規模、架構和指令對齊,那麼 2025-2026 年越來越清楚的一點是:數據本身已經成為模型能力的實驗對象。研究生進入這個方向,不必一開始就擁有巨大算力。只要能做出清晰的數據 ablation、誠實的審計報告和可復現的訓練日誌,就能提出有價值的問題。
參考資料
檢索日期:2026-08-15。以下鏈接優先使用論文頁、官方項目頁、官方文檔、GitHub、Hugging Face 數據卡、ACL Anthology、PMLR、OpenReview、Nature 等一手資料。模型、數據集、benchmark 和倉庫狀態可能更新,投稿或發佈前請重新核對。
- DataComp-LM official site: https://www.datacomp.ai/dclm/
- DataComp-LM paper page, arXiv 2406.11794: https://huggingface.co/papers/2406.11794
- DCLM GitHub repository: https://github.com/mlfoundations/dclm
- DCLM-Baseline Hugging Face dataset card: https://huggingface.co/datasets/mlfoundations/dclm-baseline-1.0
- FineWeb dataset card: https://huggingface.co/datasets/HuggingFaceFW/fineweb
- FineWeb paper page, arXiv 2406.17557: https://huggingface.co/papers/2406.17557
- FineWeb blog / technical report: https://huggingfacefw-blogpost-fineweb-v1.static.hf.space/index.html
- FineWeb 2 GitHub README: https://github.com/huggingface/fineweb-2/blob/main/README.md
- RedPajama-V2 announcement / documentation: https://secretive-tarsal-fe8.notion.site/RedPajama-Data-v2-An-open-dataset-with-30-trillion-tokens-for-training-large-language-models-27689a07b1d24f49b3d16743d63f2db0
- Together AI RedPajama-V2 FAQ: https://www.together.ai/blog/redpajama-v2-faq
- Dolma official documentation: https://allenai.github.io/dolma/
- OLMo 2 official page: https://allenai.org/olmo2
- OLMo 2 blog: https://allenai.org/blog/olmo2
- OLMo release notes: https://docs.allenai.org/release_notes/olmo-release-notes
- Deduplicating Training Data Makes Language Models Better, ACL Anthology: https://aclanthology.org/2022.acl-long.577/
- Deduplicating Training Data Mitigates Privacy Risks in Language Models, PMLR: https://proceedings.mlr.press/v162/kandpal22a
- SemDeDup GitHub repository: https://github.com/facebookresearch/SemDeDup/
- Data Selection for Language Models via Importance Resampling, arXiv 2302.03169: https://huggingface.co/papers/2302.03169
- DSIR GitHub repository: https://github.com/p-lambda/dsir
- DoReMi blog and implementation: https://crfm.stanford.edu/2023/09/14/doremi.html
- DoReMi GitHub repository: https://github.com/sangmichaelxie/doremi
- A Pretrainer's Guide to Training Data, arXiv 2305.13169: https://arxiv.org/abs/2305.13169
- WIMBD / What's In My Big Data?, OpenReview: https://openreview.net/forum?id=aydSC2ewu0
- Data-Juicer GitHub repository: https://github.com/datajuicer/data-juicer
- Data-Juicer paper page: https://www.alphaxiv.org/abs/2309.02033
- Nemotron-CC data curation docs: https://docs.nvidia.com/nemotron/nightly/nemotron/data/curation/nemotron-cc.html
- NVIDIA Nemotron-CC announcement: https://developer.nvidia.com/blog/?p=94818
- NVIDIA Nemotron-CC pipeline blog: https://developer.nvidia.com/blog/?p=99540
- NVIDIA Nemotron GitHub / dataset hub: https://github.com/NVIDIA-NeMo/Nemotron
- NeMo Curator GitHub repository: https://github.com/NVIDIA-NeMo/Curator
- Recycling the Web / REWIRE paper page, arXiv 2506.04689: https://huggingface.co/papers/2506.04689
- AI models collapse when trained on recursively generated data, Nature: https://www.nature.com/articles/s41586-024-07566-y
- Collapse or Thrive, ICML 2025 PMLR: https://proceedings.mlr.press/v267/kazdan25a.html
- Judging Quality Across Languages, arXiv 2505.22232: https://www.alphaxiv.org/abs/2505.22232
- DataPrep-Bench paper page, arXiv 2607.20465: https://huggingface.co/papers/2607.20465
- Data-Centric Lessons To Improve Speech-Language Pretraining, OpenReview ICLR 2026: https://openreview.net/forum?id=4amNkYCDqX
- SmolLM2 paper page, arXiv 2502.02737: https://arxiv.org/abs/2502.02737
- How Learning Rate Decay Wastes Your Best Data in Curriculum-Based LLM Pretraining, ML Anthology / ICLR 2026: https://mlanthology.org/iclr/2026/luo2026iclr-learning/