日期:2026-08-16
適合讀者:研究生、LLM 訓練入門研究者、有工程背景的 AI 讀者
檢索日期:2026-08-16
摘要
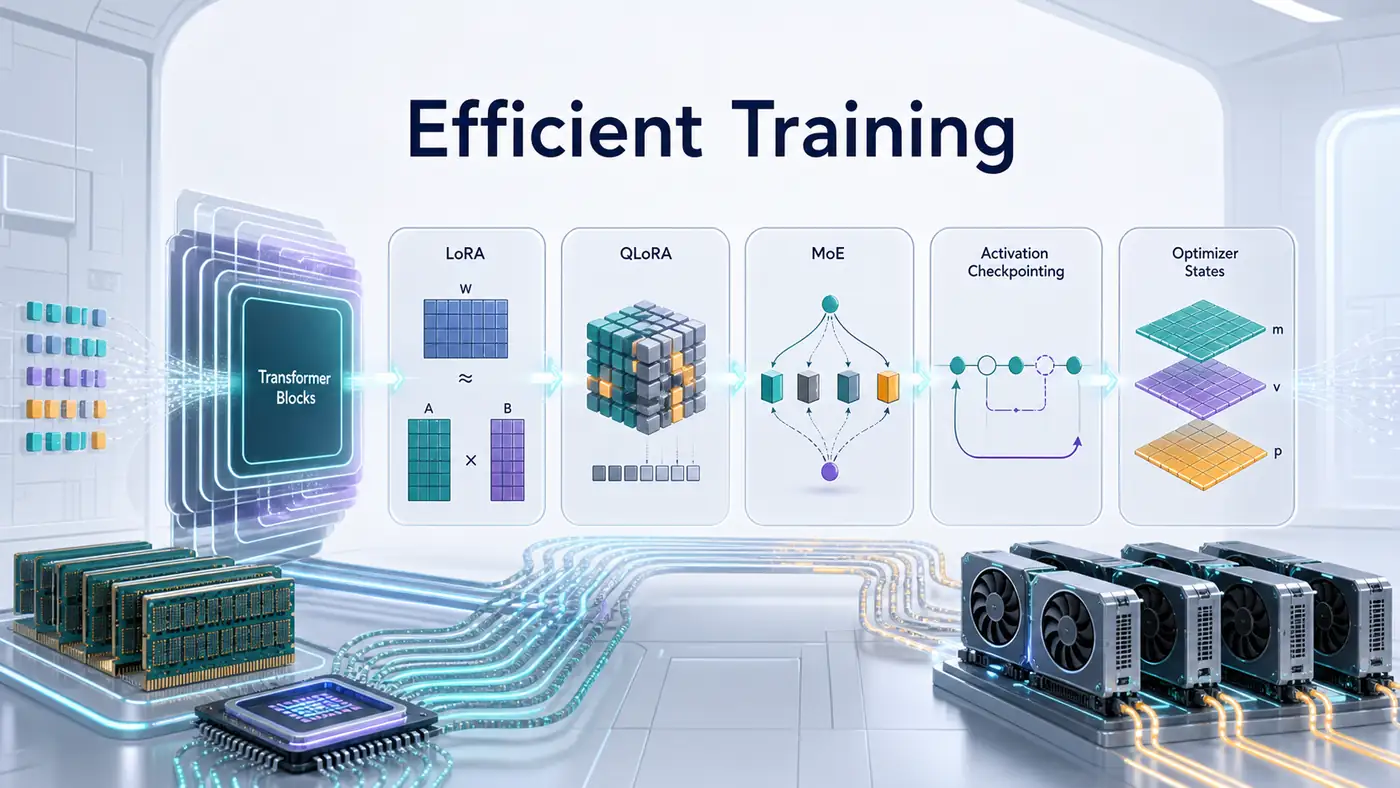
Efficient Training 不是“把訓練做便宜”的工程細節,而是大模型研究裡的資源分配問題:同樣 token budget、同樣硬件和同樣評測下,顯存、通信、重計算、數值穩定性和最終能力如何交換?LoRA/QLoRA 讓大模型微調進入普通實驗室;ZeRO、activation checkpointing、FlashAttention、Megatron/FSDP 把訓練狀態和激活顯存拆成可管理模塊;MoE 試圖把總參數容量和每 token 計算成本解耦;GaLore、Q-GaLore、Muon 等優化器方向則重新討論 optimizer states、更新子空間和大規模訓練穩定性。
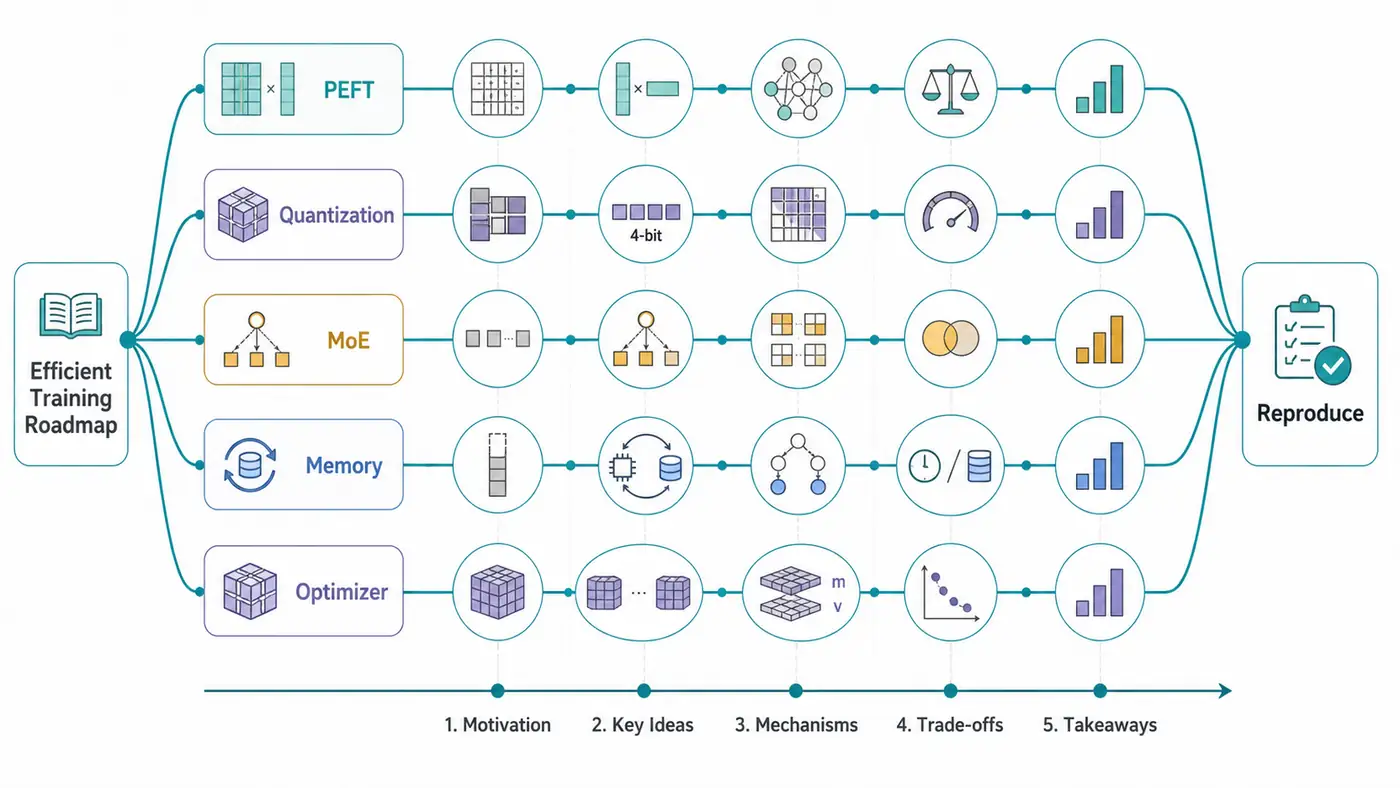
本文給出一條論文精讀路線:先學會寫“訓練資源賬本”,再按 PEFT、量化微調、稀疏專家、內存並行、優化器五條線讀代表論文,最後設計小規模復現實驗,驗證一種效率方法到底省掉了什麼、付出了什麼、結論能否站住。
目錄
- 為什麼這個主題重要
- 核心閱讀方法
- 代表論文路線圖
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結與參考資料
為什麼這個主題重要
大模型訓練瓶頸不是單一的“GPU 不夠”。凍結參數可以減少梯度和優化器狀態,但不一定減少激活顯存;量化權重能省模型內存,卻可能引入數值誤差和 kernel 限制;checkpointing 用額外前向重計算換顯存;ZeRO/FSDP 把參數、梯度和優化器狀態分片,但引入通信;MoE 增加總容量,卻帶來 router、load balancing、expert parallelism 和穩定性問題;優化器改進可能減少狀態或提升收斂,但比較時必須匹配學習率、batch、warmup、訓練 token 和硬件。
這類論文對研究生尤其有訓練價值。第一,你可以在 1B 以下模型、公開數據和單機環境裡做出可解釋復現。第二,它迫使你同時報告 peak memory、tokens/sec、wall-clock、loss curve、最終指標和失敗率,而不是隻挑一個好看的數字。第三,效率方法往往有明確邊界條件:某些任務有效、某些規模失效、某些實現很快但不穩定,這些邊界就是可發表的研究問題。
2025-2026 年的模型技術報告也說明,訓練效率已經進入主線敘事。DeepSeek-V3、Qwen3、Kimi K2、Llama 4 等公開資料都把 MoE、FP8、低秩結構、專家並行、長上下文訓練和優化器穩定性寫進核心設計;PyTorch、DeepSpeed、Megatron Core 文檔也持續更新 activation checkpointing、ZeRO、parallelism 和 MoE 訓練能力。讀現代 LLM 報告時,如果忽略 efficient training,就很難理解模型到底是如何被訓練出來的。
核心閱讀方法
讀 Efficient Training 論文,第一步是畫資源賬本。至少拆成六項:parameters、gradients、optimizer states、activations、communication、recompute。LoRA 主要減少可訓練參數、梯度和優化器狀態;QLoRA 進一步壓縮 frozen base weights;ZeRO/FSDP 分片 training states;activation checkpointing 減少保存的激活;FlashAttention 減少 attention 中間量和 HBM IO;MoE 降低每 token 激活計算相對總容量的成本;GaLore 類方法壓縮梯度統計或優化器狀態;Muon 關注更新幾何和擴展到大規模訓練的穩定性。
第二步是區分訓練階段。預訓練、continued pretraining、SFT、DPO/RLHF、領域微調和 adapter 訓練不是同一個問題。LoRA/QLoRA 很適合下游適配,但不等於低成本預訓練;GaLore 試圖保留 full-parameter learning;MoE 通常需要從架構和系統層面一起設計;checkpointing 和並行系統則橫跨多個階段。
第三步是檢查證據強度。可信論文應儘量固定模型、數據、token budget、硬件、評測和隨機種子,只改變效率方法。只報告 trainable parameters、不報告 activation;只報告 peak memory、不報告 step time;只給最終 benchmark、不展示 loss curve;把不同 batch 或不同訓練 token 的結果放在一張表裡,都是需要警惕的信號。
代表論文路線圖
1. LoRA / PEFT:低秩更新如何改變微調
LoRA 凍結預訓練權重,在 Transformer 層中加入低秩矩陣更新,把全量微調近似為低秩子空間中的適配。精讀時要抓住兩點:為什麼 adaptation update 可能低秩,以及 LoRA 應該插入哪些模塊。復現時不要只記“參數少”,要系統改變 rank、alpha、target modules、dropout、bias、merge/unmerge,並與 full fine-tuning baseline 在同一 token budget 下比較。
2024 之後的 DoRA、LoRA+、RSLoRA、LoftQ、aLoRA 等變體可以作為第二層閱讀。DoRA 把權重更新拆成 magnitude 和 direction;LoRA+ 用不同學習率更新兩個 adapter 矩陣;PEFT 文檔則顯示這些方法已經成為可組合工具。讀變體論文時,重點不是“新方法一定更強”,而是找清楚它修復了 LoRA 的哪一個邊界條件。
2. QLoRA:量化權重上的可訓練適配
QLoRA 的關鍵是組合方案:NF4 量化、double quantization、paged optimizers,以及在量化 base model 上訓練 LoRA adapter。它把凍結模型權重壓低到 4-bit 存儲,同時保留 adapter 的可訓練性。精讀時要畫清楚哪些張量被量化、哪些張量可訓練、梯度如何流動、optimizer states 存在哪裡。復現時必須記錄 bitsandbytes、transformers、PEFT、CUDA、GPU 型號、compute dtype 和是否啟用 gradient checkpointing,因為這些實現細節會直接影響穩定性和速度。
3. Memory / Parallelism:ZeRO、Checkpointing、FlashAttention、Megatron
ZeRO 的核心是去掉數據並行中的冗餘 training states。DeepSpeed 文檔把它拆成 Stage 1 optimizer states、Stage 2 gradients、Stage 3 parameters,並提供 CPU/NVMe offload。讀 ZeRO 時,要把顯存節省和 all-gather、reduce-scatter、offload 帶寬一起看。
Activation checkpointing 用重計算換顯存。PyTorch 文檔明確指出,反向傳播時會重新執行部分 forward;若涉及 dropout 和 RNG state,還要注意 determinism 與性能開銷。FlashAttention 則通過 IO-aware attention 減少中間矩陣和 HBM 訪問,對長序列訓練尤其關鍵。Megatron-LM/Megatron Core 提供 tensor、pipeline、data、expert、context parallelism 等訓練積木。系統論文和文檔的讀法,是把每個開關翻譯成“哪類張量被切分、哪類通信被引入、哪類 kernel 被融合”。
4. MoE:總容量與激活計算的解耦
GShard 和 Switch Transformer 是 MoE 路線的經典起點。GShard 展示條件計算和自動分片;Switch Transformer 用 top-1 routing 簡化專家選擇,並把 load balancing、capacity factor、bfloat16 穩定性放在核心位置。之後 Mixtral、DeepSeekMoE、DeepSeek-V2/V3、Qwen3、Kimi K2、Llama 4 等報告把 MoE 推到開放模型主流。
讀 MoE 報告時,不能只看 total parameters。必須同時記錄 activated parameters、experts per token、shared experts、router、load balancing loss、expert parallelism、token dropping 和通信。模型參數、token 數、GPU hours、benchmark 和倉庫狀態都容易變化,正式引用前應回到官方模型卡和技術報告重新核對。
5. Optimizer:AdamW 之後的內存與穩定性
AdamW 是新優化器的強 baseline,因為它把 weight decay 從 Adam 更新中解耦。GaLore 的問題設定是 optimizer state memory:它不是凍結權重,而是在低秩梯度投影空間中維護優化器狀態,試圖保留 full-parameter learning。Q-GaLore 進一步結合量化和 layer-adaptive low-rank gradients。Muon 及 Kimi K2 報告則把 optimizer 擴展性和訓練穩定性重新推到中心。
這裡最容易誤判貢獻:優化器效果往往混合了算法、實現、學習率、batch、數據和硬件。讀論文時要堅持同一模型、同一數據、獨立調參、完整 loss curve 和失敗率,否則很難判斷是優化器更好,還是 baseline 沒調好。
方法與實驗對比表
| 分支 | 代表資料 | 主要節省對象 | 主要代價 | 精讀檢查 |
|---|---|---|---|---|
| LoRA / PEFT | LoRA, DoRA, LoRA+, PEFT | trainable params、gradients、optimizer states | 可能限制更新子空間 | rank、target modules、同預算 full baseline |
| QLoRA | QLoRA, PEFT quantization | frozen base weights 顯存 | 量化誤差、kernel/版本限制 | NF4、compute dtype、paged optimizer |
| ZeRO / FSDP | ZeRO, DeepSpeed, PyTorch FSDP | 參數、梯度、優化器狀態冗餘 | 通信和 offload 成本 | stage、bucket、batch、網絡帶寬 |
| Checkpointing | PyTorch checkpointing | activations | 額外重計算、RNG 複雜度 | 粒度、step time、determinism |
| FlashAttention | FlashAttention, Megatron | attention 中間量、HBM IO | kernel 和硬件依賴 | sequence length、dtype、端到端吞吐 |
| MoE | GShard, Switch, Mixtral, DeepSeek, Qwen3, Kimi K2, Llama 4 | 每 token 計算相對總容量 | 路由、通信、穩定性 | active vs total params、expert load |
| Optimizer | AdamW, GaLore, Q-GaLore, Muon | optimizer states 或收斂步數 | 超參敏感、歸因困難 | 調參預算、loss curve、失敗率 |
復現建議
第一,復現 LoRA / QLoRA 微調。選擇一個 1B-8B 開源模型和小型指令數據集,比較 full fine-tune、LoRA、QLoRA。固定訓練 tokens、batch、評測集和 seed,報告 peak memory、tokens/sec、訓練時間、loss curve、最終指標和 checkpoint size。
第二,復現 activation checkpointing trade-off。打開/關閉 checkpointing,改變 checkpoint 粒度,記錄最大顯存、step time、吞吐和 loss。若模型包含 dropout,要寫清楚 RNG 和 determinism 設置。
第三,做 ZeRO/FSDP 小實驗。多卡環境下比較 data parallel、ZeRO-1/2/3 或 FSDP;單卡可嘗試 offload,但不要把單卡 offload 結論外推到高速互聯集群。
第四,做 toy MoE。把小 Transformer 的 FFN 換成 4 或 8 個專家,比較 top-1/top-2 routing、shared expert、load balancing loss。報告 expert load entropy、dropped token rate、active FLOPs 和 loss curve。
第五,做 optimizer ablation。以 AdamW 為強 baseline,再加入 Adafactor、GaLore 或 Muon。每個優化器都要獨立調學習率和 weight decay,並報告失敗率。負結果也要寫,因為效率論文的邊界條件往往比正結果更有價值。
常見誤區
- 只看 trainable parameters。LoRA 參數少,但 activation memory、attention 中間量和 batch size 仍可能決定能否訓練。
- 把 total parameters 當成訓練成本。MoE 必須報告 active parameters、experts per token、router 和通信。
- 只報告 peak memory。省顯存但 step time 翻倍、最終 loss 變差或訓練不穩定,不一定更有效。
- 不匹配 token budget 和調參預算。效率方法常常改變最優學習率、warmup、rank、batch 和 precision。
- 忽略版本。PEFT、bitsandbytes、PyTorch、DeepSpeed、Megatron、CUDA kernel、官方模型卡和技術報告都在持續變化。涉及參數量、GPU hours、benchmark、倉庫狀態的內容,正式發佈前應標註檢索日期;不確定項寫“待人工核驗”。
適合研究生繼續做的選題
- LoRA rank scaling:比較 0.5B、1B、3B 模型上的 rank、target modules 和數據規模。
- QLoRA 穩定性審計:比較 NF4、FP4、BF16/FP16 compute dtype、paged optimizer 和 checkpointing。
- Checkpointing 策略搜索:在固定顯存預算下自動選擇 checkpoint 節點。
- 小規模 MoE 路由機制:研究 shared expert、load balancing loss 和 capacity factor。
- Optimizer state 壓縮復現:比較 AdamW、Adafactor、GaLore、Q-GaLore 在 SFT 與 continued pretraining 中的差異。
- 效率報告模板:為一篇 LLM 訓練論文補寫顯存、吞吐、通信、失敗率和復現邊界。
總結
Efficient Training 論文的正確讀法,是把“更省”翻譯成可審計的成本、質量和穩定性三角。LoRA/QLoRA 降低微調門檻,ZeRO/checkpointing/FlashAttention/Megatron 把訓練系統拆成可組合模塊,MoE 改變容量和激活計算的關係,optimizer 方向繼續挑戰 AdamW 的內存和收斂邊界。科研新人最該訓練的能力,是復現一張資源賬本:同樣模型、數據和預算下,省掉了什麼,付出了什麼,結論還能不能站住。
參考資料
檢索日期:2026-08-16。以下鏈接優先使用論文頁、官方項目頁、官方文檔、GitHub、JMLR、ML Anthology、Hugging Face paper page 等一手或接近一手資料。模型參數、訓練 token、GPU hours、benchmark、倉庫狀態、文檔版本和 API 行為可能變化,投稿或發佈前請重新核對。
- LoRA: Low-Rank Adaptation of Large Language Models, ICLR 2022 / ML Anthology: https://mlanthology.org/iclr/2022/hu2022iclr-lora/
- QLoRA: Efficient Finetuning of Quantized LLMs, arXiv 2305.14314: https://arxiv.org/abs/2305.14314
- QLoRA official GitHub repository: https://github.com/artidoro/qlora
- Hugging Face PEFT documentation: https://huggingface.co/docs/peft/en/index
- Hugging Face PEFT LoRA reference: https://huggingface.co/docs/peft/main/en/package_reference/lora
- Hugging Face PEFT quantization guide: https://github.com/huggingface/peft/blob/main/docs/source/developer_guides/quantization.md
- DoRA: Weight-Decomposed Low-Rank Adaptation, NVIDIA Research: https://research.nvidia.com/labs/lpr/publication/liu2024dora/
- LoRA+: Efficient Low Rank Adaptation of Large Models, arXiv 2402.12354: https://arxiv.org/abs/2402.12354
- Decoupled Weight Decay Regularization, ICLR 2019 / ML Anthology: https://mlanthology.org/iclr/2019/loshchilov2019iclr-decoupled/
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models, arXiv 1910.02054: https://arxiv.org/abs/1910.02054
- DeepSpeed ZeRO tutorial: https://github.com/microsoft/DeepSpeed/blob/master/docs/_tutorials/zero.md
- DeepSpeed large-model training guide: https://www.deepspeed.ai/tutorials/large-models-w-deepspeed/
- DeepSpeed ZeRO++ tutorial: https://www.deepspeed.ai/tutorials/zeropp/
- PyTorch activation checkpointing blog: https://pytorch.org/blog/activation-checkpointing-techniques/
- torch.utils.checkpoint documentation: https://docs.pytorch.org/docs/stable/checkpoint
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, arXiv 2205.14135: https://arxiv.org/abs/2205.14135
- Megatron-LM / Megatron Core GitHub repository: https://github.com/NVIDIA/Megatron-LM
- GShard, ICLR 2021 / ML Anthology: https://mlanthology.org/iclr/2021/lepikhin2021iclr-gshard/
- Switch Transformers, JMLR 2022: https://www.jmlr.org/beta/papers/v23/21-0998.html
- Mixtral of Experts, Mistral AI: https://mistral.ai/news/mixtral-of-experts/
- DeepSeekMoE official repository: https://github.com/deepseek-ai/DeepSeek-MoE
- DeepSeek-V2 official repository: https://github.com/deepseek-ai/deepseek-v2
- DeepSeek-V3 official repository and technical report link: https://github.com/deepseek-ai/DeepSeek-V3
- Qwen3 official repository and technical report citation: https://github.com/QwenLM/Qwen3
- Kimi K2 official repository and technical report: https://github.com/MoonshotAI/Kimi-K2
- Muon is Scalable for LLM Training, arXiv 2502.16982: https://arxiv.org/abs/2502.16982
- Llama 4 model card, Meta repository: https://github.com/meta-llama/llama-models/blob/main/models/llama4/MODEL_CARD.md
- Llama 4 official blog: https://ai.meta.com/blog/llama-4-multimodal-intelligence/
- GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection, arXiv 2403.03507: https://arxiv.org/abs/2403.03507
- Q-GaLore, arXiv 2407.08296: https://arxiv.org/abs/2407.08296
- Scalable Parameter and Memory Efficient Pretraining for LLM, arXiv 2505.22922: https://arxiv.org/abs/2505.22922
- EfficientLLM: Efficiency in Large Language Models, arXiv 2505.13840: https://arxiv.org/abs/2505.13840
- Parameter-efficient fine-tuning in large language models: a survey of methodologies, Artificial Intelligence Review 2025: https://link.springer.com/article/10.1007/s10462-025-11236-4
- A Survey on Mixture of Experts in Large Language Models, official repository: https://github.com/withinmiaov/A-Survey-on-Mixture-of-Experts-in-LLMs