日期:2026-08-11
適合讀者:研究生、AI4Science 入門研究者、有工程背景的技術讀者
檢索日期:2026-08-11
摘要
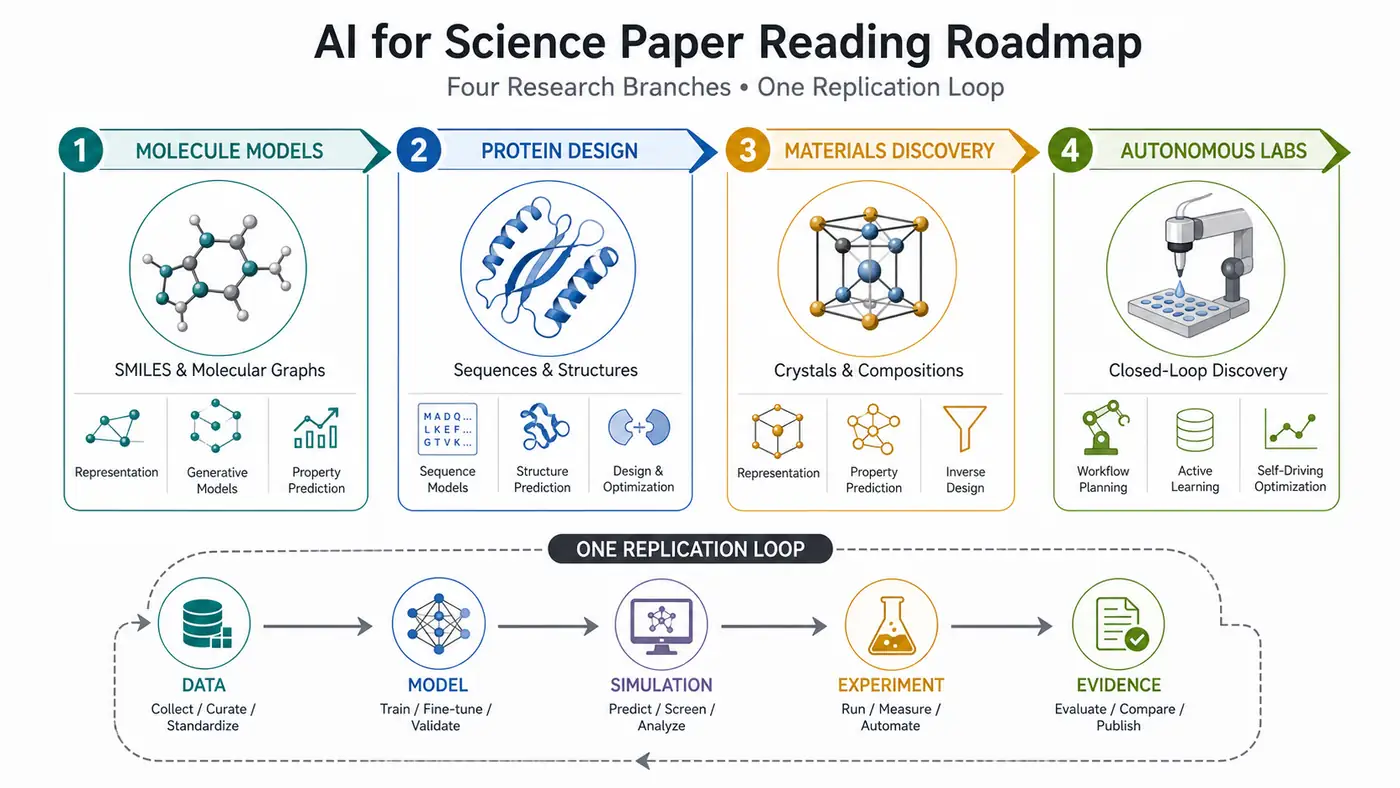
AI for Science 不是一個單點模型方向,而是一組圍繞科學對象、物理約束和實驗驗證組織起來的方法族。分子方向關心 SMILES、分子圖、3D 構象和蛋白口袋;蛋白方向關心序列、結構、功能和溼實驗篩選;材料方向關心晶體結構、組成、穩定性、性質約束和合成可行性;自動實驗方向則把文獻、模型、儀器 API、主動學習和真實測量連成閉環。
這篇文章給出一條適合科研訓練的閱讀路線:先讀“表徵與預測”,再讀“生成與逆向設計”,最後讀“實驗驗證與自主發現”。重點不是記住每個模型名字,而是學會判斷一篇 AI4Science 論文是否真正回答了科學問題:數據是否代表真實分佈,benchmark 是否洩漏,生成結果是否經過物理或實驗驗證,復現時能否拿到數據、權重、代碼和評價協議。
為什麼這個主題重要
AI4Science 的難點在於它同時要求“機器學習正確”和“科學問題正確”。在普通 NLP 任務裡,公開測試集上的提升至少說明模型適應該數據分佈;但在分子、蛋白和材料裡,離線指標只是第一層證據。真正重要的問題是:模型提出的分子能否合成,蛋白能否表達並保持功能,晶體是否穩定且可製備,實驗代理是否能在儀器和安全約束下完成閉環。
2025 到 2026 年的趨勢讓這個問題更明顯。Co-Scientist 把多智能體、文獻檢索和假設生成推到科學發現流程;Boltz-2 把結構預測推進到結合親和力預測;MatterGen 把材料發現從“篩選候選”轉向“按約束直接生成”;InstructBioMol 等工作嘗試讓自然語言成為生物分子設計接口。這些工作很興奮,但也更需要嚴謹閱讀:科學智能系統的失敗往往不是代碼跑不通,而是證據鏈在某一環斷掉。
核心閱讀方法
讀 AI4Science 論文時,建議把每篇文章拆成五層。
- 科學對象:研究的是小分子、蛋白、蛋白-配體複合物、晶體材料、反應條件,還是完整實驗流程?對象決定表示方式。SMILES 方便語言建模但弱化 3D 幾何;分子圖保留連接關係但需要處理構象;蛋白序列適合大規模預訓練但不等於功能;晶體材料還要表示週期性晶格和空間群。
- 任務定義:論文是在做 property prediction、structure prediction、inverse design、docking、binding affinity、reaction planning,還是 hypothesis generation?同樣叫“生成”,有的只是生成合法結構,有的要求滿足性質約束,有的還要求可合成並通過實驗測量。
- 約束來源:分子要滿足價態、藥物相似性、可合成性和口袋相容性;蛋白要摺疊、表達、穩定、結合目標並避免非特異性作用;材料要滿足電荷平衡、熱力學穩定性和工藝條件;自動實驗還要遵守儀器能力、試劑安全和預算。
- 證據強度:離線 benchmark、物理模擬、數據庫驗證、專家評審、自動實驗和溼實驗驗證不是同一級證據。證據越靠後成本越高,也越有說服力,但仍要檢查陰性對照、失敗樣本和統計顯著性。
- 復現邊界:儘早判斷自己能復現哪一層。很多 AI4Science 論文最合理的復現目標不是完整溼實驗,而是復現實驗前的篩選、評價拆分、消融或失敗案例分析。
代表論文路線圖
1. 分子模型:從表示學習到可驗證生成
分子方向的基礎問題是“模型到底看見了什麼”。SMILES/SELFIES 適合語言建模,圖神經網絡適合原子-鍵結構,3D equivariant 模型進一步納入空間幾何。讀這類論文時,先看它解決的是表示、預測還是生成,再看訓練和測試拆分是否真的隔離 scaffold、靶點或 assay。
2025 年一個重要警示是 binding affinity 預測裡的數據洩漏。Graber 等人討論 PDBbind 與 CASF benchmark 的相似性問題,提出 CleanSplit 後,若干模型表現下降。這類論文很適合訓練科研判斷力:指標下降不一定是壞事,可能是評價終於接近真實泛化。
2. 蛋白設計:從結構預測到功能生成
蛋白方向的經典起點仍然是 AlphaFold2。讀它時不要只記住 CASP14,而要拆輸入、MSA、結構模塊、置信度估計和限制條件。接著讀 ProteinMPNN 與 RFdiffusion:前者代表“給定骨架設計序列”的逆問題,後者代表用擴散模型生成滿足結構或功能約束的蛋白骨架。
2024 到 2025 年後,焦點轉向更通用的生物分子交互。AlphaFold3 把蛋白、核酸、小分子、離子和修飾殘基放進統一結構預測框架;Chai、Boltz 等體系推動可復現的複合物建模;ESM3 則代表以序列、結構和功能為多模態空間的生成式蛋白語言模型。閱讀時要特別區分“結構準確”“親和力準確”和“功能有效”。
3. 材料發現:從大規模篩選到逆向生成
材料方向可以先讀 GNoME。它的核心不是語言模型,而是通過圖網絡和高通量計算擴大穩定晶體候選空間。讀這類論文時,要關注穩定性判據、DFT 設置、數據發佈版本,以及是否與 Materials Project 等數據庫聯動。
再讀 MatterGen。它把目標從“從海量候選裡篩”改成“給定化學、對稱性或性質約束直接生成”。這對方法論很重要:篩選式發現考驗候選覆蓋率和打分函數,生成式發現則考驗約束控制、結構有效性、能量弛豫、穩定性和真實合成驗證。尤其要記住:熱力學穩定不等於實驗中容易合成。
4. 自動實驗:從工具代理到科學閉環
A-Lab 把目標材料、文獻挖掘、合成啟發、機器人操作、XRD 表徵和主動學習放在同一閉環裡;Coscientist 用 LLM、文檔檢索、代碼執行和實驗 API 來規劃並執行化學實驗;Co-Scientist 則把多智能體辯論、排序、演化和專家反饋用於假設生成,並在生物醫學問題上做實驗驗證。
這條線最適合訓練“系統讀論文”的能力。你要問:哪一部分是 LLM,哪一部分是數據庫、工具或人類專家?實驗是否全自動,還是隻在決策層自動?失敗實驗有沒有記錄?安全約束如何實現?如果沒有這些問題,自動實驗論文很容易被讀成“機器人做實驗”的新聞稿。
方法與實驗對比表
| 論文/系統 | 應先讀什麼 | 方法關鍵詞 | 復現切入點 |
|---|---|---|---|
| AlphaFold2 | 輸入、置信度、CASP14 設置 | MSA、結構模塊、幾何約束 | 跑公開代碼或 ColabFold,對比置信度與失敗案例 |
| RFdiffusion | 設計任務和實驗篩選 | diffusion、motif scaffolding | 小規模 backbone generation 與過濾流程 |
| ESM3 | 序列/結構/功能三模態如何對齊 | protein language model、prompting | 使用開放模型做受限設計,記錄許可和安全邊界 |
| AlphaFold3 / Chai / Boltz | 輸入實體和輸出任務邊界 | biomolecular complex、affinity | 用小型複合物集合比較輸入格式、速度和置信度 |
| GNoME / MatterGen | 穩定性、約束和數據版本 | graph network、crystal diffusion | 復現候選篩選、弛豫和 SUN 指標定義 |
| A-Lab / Coscientist / Co-Scientist | 閉環中誰做決策 | robotics、tools、multi-agent | 復現實驗日誌結構、主動學習或 hypothesis rubric |
復現建議
AI4Science 的復現要先選層級,不要一上來承諾“完整復現論文”。
閱讀型復現:復現論文表格的列定義、數據來源、評價協議和模型輸入輸出,目標是把任務說清楚。
計算型復現:下載代碼和權重,在小樣本上跑通 inference,記錄環境、GPU、隨機種子、版本、失敗樣例和耗時。
評價型復現:重做 benchmark split、去重、scaffold split、時間切分、相似性過濾和置信度校準。對分子和蛋白親和力任務尤其重要。
閉環型復現:用模擬器、公開數據庫或廉價實驗替代真實實驗。只有在有實驗條件和安全審批時,才進入溼實驗復現。
每次復現都建議保留四份日誌:環境日誌、數據日誌、運行日誌和判斷日誌。判斷日誌要寫明哪些結果可信,哪些只是在復現實驗設置,哪些需要人工核驗。
常見誤區
第一,把 benchmark 分數當成科學發現。AI4Science 的 benchmark 多半是代理任務,不能自動推出真實世界有效。
第二,把結構預測當成功能預測。蛋白結構相似不代表活性、穩定性、表達量和免疫原性都可用。
第三,把“生成合法分子”當成“發現候選藥物”。合法、可合成、可結合、可優化、低毒性和可成藥是不同門檻。
第四,把“穩定材料”當成“能合成材料”。材料論文必須檢查熱力學穩定、動力學路徑、前驅體和實驗表徵之間的關係。
第五,只讀成功樣例。失敗樣例往往更有研究價值,因為它暴露模型的分佈外邊界、儀器瓶頸或評價漏洞。
適合研究生繼續做的選題
- 面向蛋白-配體 benchmark 的數據洩漏審計:從序列相似性、結構相似性和配體 scaffold 三個層次重新拆分訓練測試集。
- AI4Science 生成模型失敗樣例庫:系統收集無效結構、不可合成候選、低置信度預測和溼實驗失敗案例。
- 小規模材料逆向設計復現:用開源材料數據庫復現“約束生成 + 穩定性過濾 + 文獻合成可行性檢查”流程。
- 科學假設生成評價 rubric:比較 LLM 生成假設在新穎性、可檢驗性、證據支持和實驗成本上的排序一致性。
- 復現報告自動化模板:把環境、數據版本、模型權重、評價腳本、失敗日誌和人工核驗項標準化。
總結
AI for Science 的論文閱讀路線可以概括為一句話:先問科學對象,再問建模假設,最後問證據鏈。分子、蛋白、材料和自動實驗看似分散,但它們共享同一個訓練邏輯:把複雜科學對象編碼成模型可處理的表示,用生成或預測方法提出候選,再用物理、統計和實驗驗證把候選變成證據。
對研究生來說,最值得練的不是背下每個模型名稱,而是形成一套可遷移的問題清單:數據從哪裡來,任務是否真實,指標是否洩漏,生成結果如何過濾,失敗樣例是否公開,復現能做到哪一層。
參考資料
檢索日期:2026-08-11。以下優先列出論文、官方項目頁和一手資料;模型版本、API 可用性、leaderboard 結果和代碼發佈狀態可能變化,復現前請再次核對。
- Jumper et al., “Highly accurate protein structure prediction with AlphaFold”, Nature, 2021. https://www.nature.com/articles/s41586-021-03819-2
- Google DeepMind AlphaFold2 GitHub repository. https://github.com/google-deepmind/alphafold
- Watson et al., “De novo design of protein structure and function with RFdiffusion”, Nature, 2023. https://www.nature.com/articles/s41586-023-06415-8
- Abramson et al., “Accurate structure prediction of biomolecular interactions with AlphaFold 3”, Nature, 2024. https://www.nature.com/articles/s41586-024-07487-w
- Hayes et al., “Simulating 500 million years of evolution with a language model”, Science, 2025. https://doi.org/10.1126/science.ads0018
- EvolutionaryScale ESM repository. https://github.com/evolutionaryscale/esm
- Passaro et al., “Boltz-2: Towards Accurate and Efficient Binding Affinity Prediction”, bioRxiv, 2025. https://www.biorxiv.org/content/10.1101/2025.06.14.659707v1
- Boltz official repository. https://github.com/jwohlwend/boltz
- Chai Discovery chai-lab repository and Chai-1/Chai-2 citation notes. https://github.com/chaidiscovery/chai-lab
- Zhuang et al., “Advancing biomolecular understanding and design following human instructions”, Nature Machine Intelligence, 2025. https://www.nature.com/articles/s42256-025-01064-0
- Graber et al., “Resolving data bias improves generalization in binding affinity prediction”, Nature Machine Intelligence, 2025. https://doi.org/10.1038/s42256-025-01124-5
- Merchant et al., “Scaling deep learning for materials discovery”, Nature, 2023. https://www.nature.com/articles/s41586-023-06735-9
- Google DeepMind GNoME materials discovery repository. https://github.com/google-deepmind/materials_discovery
- Zeni et al., “A generative model for inorganic materials design”, Nature, 2025. https://www.nature.com/articles/s41586-025-08628-5
- Szymanski et al., “An autonomous laboratory for the accelerated synthesis of inorganic materials”, Nature, 2023. https://www.nature.com/articles/s41586-023-06734-w
- Boiko et al., “Autonomous chemical research with large language models”, Nature, 2023. https://www.nature.com/articles/s41586-023-06792-0
- Bran et al., “Augmenting large language models with chemistry tools”, Nature Machine Intelligence, 2024. https://doi.org/10.1038/s42256-024-00832-8
- Gottweis et al., “Accelerating scientific discovery with Co-Scientist”, Nature, 2026. https://www.nature.com/articles/s41586-026-10644-y
- Google DeepMind, “Co-Scientist: A multi-agent AI partner to accelerate research”, 2026. https://deepmind.google/blog/co-scientist-a-multi-agent-ai-partner-to-accelerate-research/
- ICLR 2026 Workshop on Foundation Models for Science, OpenReview venue page. https://openreview.net/group?id=ICLR.cc%2F2026%2FWorkshop%2FFM4Science