日期:2026-08-10
適合讀者:準備進入機器人學習、多模態智能體、具身智能方向的研究生;熟悉深度學習和 LLM/VLM、但還沒有系統讀過機器人論文的工程讀者。
檢索日期:2026-08-10
摘要
Vision-Language-Action(VLA)模型把視覺觀測、語言任務和機器人動作放進同一個學習框架裡,是具身智能近兩年最密集的論文線之一。它看起來像“多模態 LLM 加一個動作頭”,但真正難讀的地方不在模型名字,而在五個細節:視覺表示是否足夠空間化,語言指令如何綁定到任務狀態,動作是離散 token、連續迴歸、diffusion 還是 flow matching,機器人數據是否跨 embodiment,評測是否真的能證明泛化。
這篇文章給一條適合科研訓練的精讀路線:先讀 RT-1、PaLM-E、RT-2 和 Open X-Embodiment,理解“規模化機器人數據 + 預訓練多模態模型”為什麼出現;再讀 Octo、OpenVLA、π0、FAST、OpenVLA-OFT、SmolVLA,拆開動作表示和復現配方;最後讀 Gemini Robotics、GR00T、VLA-Arena、VLA 持續學習等 2025-2026 年材料,判斷這個方向的真實瓶頸在哪裡。
目錄
- 為什麼 VLA 是機器人學習的轉折點
- 精讀 VLA 論文的五條線
- 代表論文路線圖
- 關鍵論文怎麼讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
傳統機器人學習論文常被拆成感知、規劃、控制三個模塊:視覺模型識別物體,規劃器生成子目標,控制器輸出動作。這個範式清晰,但每個模塊的錯誤都會傳給下游,而且每換一個機器人、相機視角、末端執行器或任務集合,都要重新調大量工程細節。
VLA 的野心是把這件事改寫成一個端到端學習問題:輸入圖像、語言指令和機器人狀態,輸出下一步或一段未來動作。RT-2 把視覺語言模型轉成動作模型,Open X-Embodiment 把不同實驗室、不同機器人數據統一到可訓練格式,OpenVLA 把開放權重和 PyTorch 訓練管線推到社區面前,π0 用 flow matching 處理高頻連續動作,FAST 把動作 tokenization 當成時序壓縮問題,Gemini Robotics 和 GR00T 則把 VLA 推向更強的多步推理、humanoid 和 on-device 形態。
但對研究生來說,這個方向也容易誤讀。第一,VLA 不是“給 VLM 接機械臂 API”這麼簡單。低層動作要滿足控制頻率、平滑性、延遲和安全約束,動作空間比文本 token 更脆弱。第二,benchmark 成績通常強依賴任務套件、相機視角、初始狀態、控制器、是否早停、是否微調、演示數據是否重疊。第三,論文裡最有價值的部分往往不是大模型口號,而是數據標準化、動作編碼、動作 chunk、後訓練和評測協議。
核心閱讀方法:五條線拆一篇 VLA 論文
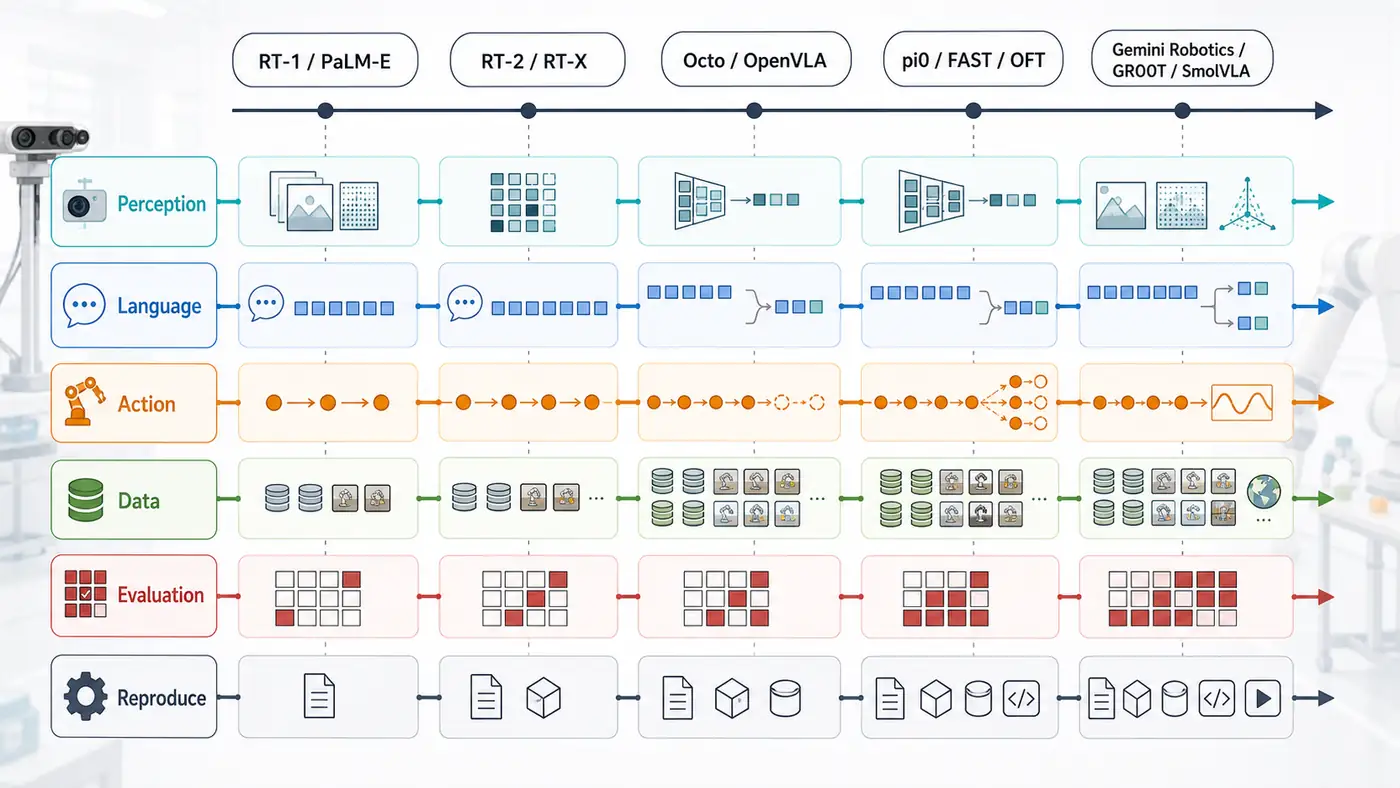
讀 VLA 論文時,不要從模型名開始記。建議每篇都按下面五條線做筆記。
1. Perception Backbone:視覺表示從哪裡來
記錄它使用的是從頭訓練的視覺 transformer、DINOv2/SigLIP/PaliGemma/Gemini/Eagle/Qwen-VL 這類預訓練 VLM,還是隻用凍結特徵。要追問:輸入是單視角還是多視角?有沒有 wrist camera?是否使用歷史幀?圖像分辨率和 token 數怎麼影響延遲?如果論文宣稱“泛化”,視覺 backbone 貢獻了多少,機器人數據貢獻了多少?
2. Language / Task Conditioning:語言到底控制什麼
語言可能只是任務標籤,也可能承擔對象指代、空間關係、子目標規劃和在線糾錯。RT-2 強調從 web-scale VLM 遷移語義知識;OpenVLA 和 SmolVLA 強調語言條件下的操作策略;Gemini Robotics 1.5 進一步強調 agentic planning 和 thinking。讀論文時要標出:語言是訓練時監督,還是推理時交互?評測的指令是否真的覆蓋組合泛化?
3. Action Representation:動作如何被模型生成
這是 VLA 論文的核心。RT-2 把動作離散成 token;OpenVLA 延續離散動作輸出;Octo 使用 diffusion-style action head;π0 使用 flow matching 生成連續動作;FAST 用離散餘弦變換壓縮動作序列再 token 化;OpenVLA-OFT 則把 fine-tuning recipe 改成並行解碼、action chunking、連續動作和 L1 目標。動作表示決定了控制頻率、誤差累積、訓練穩定性和復現難度。
4. Robot Data:數據是否真的跨 embodiment
Open X-Embodiment 彙集 22 種機器人形態、超過 500 個技能和超過 100 萬 episode,是這一輪通用機器人策略的關鍵基礎設施。OpenVLA 報告使用來自 Open X-Embodiment 的 970k 真實機器人演示;Octo 使用 800k trajectories;π0/openpi 提供預訓練於大規模機器人數據的模型;SmolVLA 則反向強調社區數據、低成本硬件和更小規模可復現。讀數據部分時不要只記“多少條軌跡”,要記數據格式、動作空間、相機、任務文字、採集者、清洗規則和 license。
5. Evaluation & Reproduction:泛化證據是否可靠
VLA 評測最容易產生錯覺。LIBERO、CALVIN、SimplerEnv、BridgeData、DROID、真實 ALOHA/Franka/humanoid 任務的難度不等價;同一個 benchmark 上,不同論文可能改 demonstrations、改 early stop、改 action chunk、改最大步數或只報告部分任務。論文如果沒有公開評測腳本、初始化狀態、失敗案例和多 seed 結果,就不要把 SOTA 當成穩定事實。
代表論文路線圖
第一階段:從多任務機器人策略到具身多模態模型
RT-1(2022)是規模化真實機器人控制的重要起點:用大量真實機器人演示訓練 transformer policy,讓模型在語言指令下直接控制機器人。PaLM-E(2023)則把大型語言模型“具身化”,讓語言模型接收圖像、機器人狀態等輸入,輸出計劃或文字形式的中間結果。它還不是今天意義上直接輸出底層 action 的 VLA,但它把“多模態預訓練能否幫助機器人任務”變成了嚴肅問題。
第二階段:VLM 到 VLA
RT-2(2023)明確提出 vision-language-action model:用 PaLI-X、PaLM-E 這類視覺語言模型作為基礎,把機器人動作表示成 token,讓模型從圖像和語言直接生成動作序列。Open X-Embodiment 與 RT-X 同年出現,強調跨機器人數據混合訓練。這個階段的關鍵問題是:web-scale 視覺語言知識能否遷移到真實控制?不同 embodiment 的動作空間能否統一?數據多樣性是否比單一機器人上的任務數量更重要?
第三階段:開放模型與可復現訓練
Octo(2024)和 OpenVLA(2024)讓社區第一次可以系統比較開放 generalist robot policy。Octo 的價值在於小得多、可微調、強調通用 policy initialization;OpenVLA 的價值在於 7B 級開放 VLA、PyTorch/FSDP/LoRA/quantization 訓練與部署路徑、以及對 Open X-Embodiment 數據混合的工程化支持。對研究訓練來說,OpenVLA 的 README、LIBERO 評測腳本和 troubleshooting 比論文摘要更值得細讀。
第四階段:連續動作、flow matching 與高頻控制
π0(2024)把預訓練 VLM 和 flow matching action expert 結合,目標是讓模型輸出高頻連續動作 chunk,處理更復雜的 dexterous manipulation。FAST(2025)指出樸素 per-dimension/per-timestep 動作離散化在高頻 dexterous 數據上會很差,於是把動作 tokenization 轉成頻域壓縮問題,並釋放 FAST+ tokenizer。OpenVLA-OFT(2025)則說明 fine-tuning recipe 本身可以顯著改變速度和成功率:並行解碼、動作 chunk、連續動作、L1 目標這些“工程選擇”可能比換更大 backbone 更關鍵。
第五階段:2025-2026 的 robotics foundation models
Gemini Robotics(2025)把 Gemini 2.0/2.5 的多模態推理接入物理行動,官方資料強調交互性、泛化、dexterity、on-device 低延遲和少量 demonstrations 的適配;但主模型和 SDK 多處處於 private preview/trusted tester 狀態,復現時要標註訪問限制。NVIDIA GR00T N1(2025)和後續 N1.5/N1.7 把 VLA 推向 humanoid,代碼庫到 2026 年已有 N1.7 版本、若干 checkpoint 和部署說明。SmolVLA(2025)則代表另一條重要路線:更小模型、更低硬件門檻、社區數據和異步推理。2026 年的 VLA 持續學習論文開始追問:真實場景裡不斷學習新任務時,模型是否會遺忘舊技能。
關鍵論文精讀
RT-1:先讀數據和控制接口
RT-1 的重點不是“Transformer 又贏了”,而是它把機器人學習的訓練單位從單任務策略擴展到大規模多任務真實機器人數據。精讀時要畫出:觀測包括什麼,語言指令如何進入模型,動作維度如何定義,控制頻率是多少,訓練數據來自怎樣的環境,評測怎樣區分 seen/unseen task。復現上不要一開始追求完整真實機器人實驗,可以先復現數據格式、action normalization 和離線 action prediction。
PaLM-E 與 RT-2:區分 planning model 和 action model
PaLM-E 更像具身多模態推理器,常與低層策略配合;RT-2 則把 VLM fine-tune 成能直接輸出動作 token 的模型。讀這兩篇時要標註“輸出是什麼”:文本計劃、子任務、動作 token,還是連續控制量。很多初學者把 embodied LLM、VLM planner、VLA policy 混在一起,導致 Related Work 結構混亂。
Open X-Embodiment / RT-X:把數據集當論文讀
這篇不是普通 dataset paper。它的關鍵是 RLDS episode 格式、跨實驗室數據整合、機器人 embodiment 差異、task annotation 和 RT-1-X/RT-2-X 的跨數據訓練。精讀時建議做一張數據地圖:每個數據源的機器人、相機、動作空間、任務數量、license、是否適合自己的復現硬件。不要只引用“超過 100 萬 episode”這樣的宏觀數字。
Octo 與 OpenVLA:開放基線的兩種價值
Octo 的優點是更輕、開放、便於把 generalist policy 當作 initialization;OpenVLA 的優點是 VLM backbone 更強、開放模型更貼近 LLM/VLM 生態、fine-tuning 說明更完整。讀 OpenVLA 時尤其要看它如何處理 Prismatic VLM、DINOv2/SigLIP 特徵、Llama 2、動作 token、LoRA、LIBERO 和 BridgeData V2。對於科研訓練,推薦把 OpenVLA 作為“能跑起來的主線”,把 Octo 作為“架構和數據 ablation 的對照”。
π0、FAST、OpenVLA-OFT:把動作表示讀透
π0 的貢獻不只是“更強機器人模型”,而是把 action generation 從離散 token 進一步推向連續軌跡生成;FAST 的貢獻是把離散 VLA 的瓶頸定位到 action tokenizer;OpenVLA-OFT 的貢獻是證明 fine-tuning 配方能極大影響推理速度、頻率和 task success。讀這三篇要重點比較:動作 chunk 長度、輸出空間、損失函數、是否 autoregressive、推理是否並行、是否支持多視角和 proprioception。
Gemini Robotics、GR00T、SmolVLA:讀官方資料時保持實驗警惕
Gemini Robotics 和 GR00T 的官方頁面非常重要,因為模型狀態、訪問方式、模型卡、checkpoint、SDK 和版本號更新很快。讀這類資料時要把“論文可復現證據”和“官方 demo 能力描述”分開。SmolVLA 則特別適合研究生:它把模型縮小到 450M 級別,強調單 GPU/消費級設備、LeRobot 數據格式、異步推理和社區數據,是做課程項目或復現訓練的現實入口。
方法與實驗對比表
| 論文/系統 | 時間 | 關鍵問題 | 動作表示 | 數據與評測線索 | 復現難度 |
|---|---|---|---|---|---|
| RT-1 | 2022 | 多任務真實機器人控制能否 scale | 離散化動作 / transformer policy | Google 真實機器人廚房數據,官方開源模型與數據線索 | 高 |
| PaLM-E | 2023 | 大型語言模型如何接收具身輸入 | 主要輸出文本/計劃,常接低層策略 | 多機器人、多模態任務 | 高 |
| RT-2 | 2023 | VLM 能否轉成直接控制機器人的 VLA | 動作 token | RT-1 數據 + web/VLM 知識遷移 | 高 |
| Open X-Embodiment / RT-X | 2023 | 跨機器人數據能否統一訓練 | 依模型而定 | 22 robot embodiments、500+ skills、100 萬+ episodes | 中到高 |
| Diffusion Policy | 2023 | 連續 visuomotor policy 如何建模多峰動作 | diffusion action generation | 11 tasks、4 benchmarks,代碼和日誌較完整 | 中 |
| Octo | 2024 | 開放 generalist robot policy 初始化 | transformer + diffusion-style action head | 800k OXE trajectories,9 平臺微調 | 中 |
| OpenVLA | 2024 | 開放 7B VLA 與可微調生態 | 離散動作 token | 970k robot demonstrations,LIBERO/BridgeData | 中到高 |
| π0 / openpi | 2024-2025 | VLM + flow matching 能否做高頻 dexterous control | 連續 flow matching action chunk | 多平臺 dexterous 數據,openpi 模型與代碼 | 中到高 |
| FAST | 2025 | 動作 tokenization 是否限制 AR VLA | DCT/頻域壓縮動作 token | FAST+ tokenizer,1M robot action sequences | 中 |
| OpenVLA-OFT | 2025 | fine-tuning 配方如何提升速度與成功率 | 連續動作、L1、action chunk | LIBERO 與 ALOHA,項目頁給出硬件需求 | 中 |
| SmolVLA | 2025 | 小模型和社區數據能否復現 VLA | flow matching action expert | LeRobot 社區數據、SO100/SO101、LIBERO | 低到中 |
| Gemini Robotics | 2025 | agentic VLA、on-device 與交互控制 | 官方未完全開放細節,輸出 action | 私有預覽/可信測試,官方模型卡與技術報告 | 高 |
| GR00T N1.x | 2025-2026 | humanoid generalist policy | VLM + diffusion transformer / action head | GitHub、model card、LIBERO/DROID/SimplerEnv checkpoint 線索 | 中到高 |
復現建議:從能跑開始,不要從真實機器人開始
第一步,選一個開放且腳本完整的棧。研究生訓練建議優先從 LeRobot + LIBERO/Meta-World、OpenVLA 的 LIBERO 腳本、SmolVLA 或 GR00T 的公開 checkpoint 入手。真實機械臂復現不是第一步,因為硬件誤差、相機標定、延遲、控制器和安全約束會掩蓋模型問題。
第二步,固定評測協議。記錄 random seed、任務 suite、初始化狀態、最大步數、成功判定、是否 early stop、每個任務 rollout 數、是否使用同一份 demonstrations。VLA 結果差異很容易來自協議,而不是模型本身。
第三步,先做離線 sanity check。包括 action normalization 是否正確,動作維度順序是否與環境一致,gripper 開合方向是否反了,圖像通道和相機視角是否匹配,語言 prompt 是否與訓練格式一致。很多“模型不工作”其實是接口錯位。
第四步,只改一個變量。動作表示、backbone、數據 mixture、視角數量、action chunk、fine-tuning steps、LoRA rank、學習率都可能影響結果。做 ablation 時,不要同時換數據、模型和評測腳本。
第五步,保存失敗軌跡。VLA 方向的研究價值通常來自失敗模式:看錯物體、聽懂但抓不住、短程成功長程失敗、對未見背景脆弱、連續學習後遺忘舊任務。失敗視頻、action traces 和 per-task logs 比一個平均成功率更有科研價值。
常見誤區
誤區一:把 VLA 論文當多模態 LLM 論文讀。
VLA 的關鍵不是回答問題,而是閉環控制。延遲、控制頻率、動作平滑、執行錯誤恢復,是論文質量的一部分。
誤區二:只看 benchmark 平均分。
LIBERO 平均分高不等於真實機器人強;真實機器人 demo 好看不等於 protocol 嚴格;模型在一種 embodiment 上成功不等於跨機器人泛化。
誤區三:忽略數據格式。
機器人數據的 observation/action/state/schema 往往比模型結構更決定復現成敗。RLDS、LeRobot dataset、DROID、OXE、LIBERO 的格式差異必須單獨整理。
誤區四:把動作 token 當普通文本 token。
文本 token 錯一個字可能還能恢復,動作 token 錯一串會讓機器人走偏。動作離散化、頻域壓縮、連續輸出和 chunk stitching 都值得精讀。
誤區五:把官方 demo 當論文證據。
官方頁面能提示方向,但科研引用要回到論文、模型卡、代碼、評測腳本和可復現 protocol。訪問受限、未開源權重、私有 benchmark 都要寫清楚。
適合研究生繼續做的選題
- VLA 動作表示的可控比較:在同一 LIBERO/SimplerEnv 設置下,比較離散 token、FAST tokenizer、L1 continuous head、diffusion/flow matching head,控制 backbone 和數據不變。
- VLA 失敗模式分類器:從 rollout 視頻和日誌自動標註失敗原因,如 grounding error、grasp failure、recovery failure、instruction drift、action saturation。
- 小數據 post-training 規律:系統比較 10/50/100/500 條 demonstrations 對不同 VLA 的影響,關注何時出現過擬合和災難性遺忘。
- 跨 embodiment adapter:研究如何用少量標定數據把同一個 VLA 遷移到不同 action space,而不是為每個機器人重新訓練全模型。
- VLA 評測協議審計:複查公開 leaderboard 的任務定義、rollout 數、early stop、數據重疊和失敗報告,形成 reproducibility card。
- 安全約束下的 VLA 控制:把語義安全、workspace constraints、low-level controller 和 VLA action head 聯合評測,避免只做文本層拒答。
總結
VLA 論文路線的主線不是“機器人終於有大模型了”,而是:機器人學習開始像 LLM 一樣追求預訓練、數據混合、後訓練、開放權重和標準化評測;同時它仍然被物理世界的低層約束牢牢限制。讀這個方向,要同時具備多模態模型視角和機器人實驗視角。
如果只選三篇精讀,建議順序是 Open X-Embodiment/RT-X、OpenVLA、π0/FAST;如果要做復現,建議從 SmolVLA 或 OpenVLA-OFT 的開放腳本開始;如果要做選題,優先圍繞動作表示、評測可靠性、小數據後訓練和持續學習。VLA 方向還遠沒有收斂,真正好的研究問題往往藏在“論文 demo 很強,但換一個機器人、一個視角、一個任務協議就失敗”的地方。
參考資料
以下資料均在 2026-08-10 檢索。模型版本、代碼倉庫狀態、benchmark 結果、private preview 訪問狀態可能變化,復現實驗前需再次人工核驗。
- RT-1: Robotics Transformer for Real-World Control at Scale, arXiv:2212.06817 / project page: https://robotics-transformer1.github.io/
- Google Research Blog, “RT-1: Robotics Transformer for real-world control at scale”, 2022-12-13: https://research.google/blog/rt-1-robotics-transformer-for-real-world-control-at-scale/
- PaLM-E: An Embodied Multimodal Language Model, Google Research Blog, 2023-03-10: https://research.google/blog/palm-e-an-embodied-multimodal-language-model/
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control / Google DeepMind Blog, 2023-07-28: https://deepmind.google/blog/rt-2-new-model-translates-vision-and-language-into-action/
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models / Google DeepMind Blog, 2023-10-03: https://deepmind.google/blog/scaling-up-learning-across-many-different-robot-types/
- Open X-Embodiment GitHub repository: https://github.com/google-deepmind/open_x_embodiment
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion, arXiv:2303.04137: https://arxiv.org/abs/2303.04137
- Diffusion Policy official code: https://github.com/real-stanford/diffusion_policy
- Octo: An Open-Source Generalist Robot Policy, arXiv:2405.12213: https://arxiv.org/abs/2405.12213
- OpenVLA: An Open-Source Vision-Language-Action Model, arXiv:2406.09246 / project: https://openvla.github.io/
- OpenVLA GitHub repository: https://github.com/openvla/openvla
- π0: A Vision-Language-Action Flow Model for General Robot Control, arXiv:2410.24164 / Physical Intelligence blog: https://www.physicalintelligence.company/blog/pi0
- Physical Intelligence openpi repository: https://github.com/Physical-Intelligence/openpi
- FAST: Efficient Action Tokenization for Vision-Language-Action Models, arXiv:2501.09747 / Hugging Face model card: https://huggingface.co/physical-intelligence/fast
- Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success, arXiv:2502.19645 / project: https://openvla-oft.github.io/
- SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics, arXiv:2506.01844 / Hugging Face blog: https://huggingface.co/blog/smolvla
- LIBERO benchmark project and code: https://libero-project.github.io/main.html and https://github.com/Lifelong-Robot-Learning/LIBERO
- DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset, arXiv:2403.12945 / repository: https://github.com/droid-dataset/droid
- Google DeepMind, “Gemini Robotics brings AI into the physical world”, 2025-03-12: https://deepmind.google/blog/gemini-robotics-brings-ai-into-the-physical-world/
- Google DeepMind, “Gemini Robotics On-Device brings AI to local robotic devices”, 2025-06-24: https://deepmind.google/blog/gemini-robotics-on-device-brings-ai-to-local-robotic-devices/
- Gemini Robotics model page and model cards: https://deepmind.google/models/gemini-robotics/gemini-robotics/ and https://deepmind.google/models/model-cards/
- NVIDIA GR00T N1: An Open Foundation Model for Generalist Humanoid Robots, arXiv:2503.14734 / research page: https://research.nvidia.com/labs/lpr/publication/gr00tn1_2025/
- NVIDIA Isaac-GR00T GitHub repository, checked latest visible N1.7 materials: https://github.com/NVIDIA/Isaac-GR00T
- GR00T N1.5 research page, 2025-06-11: https://research.nvidia.com/labs/gear/gr00t-n1_5/
- A Survey on Vision-Language-Action Models for Embodied AI, arXiv:2405.14093, v8 revised 2026-05-01: https://arxiv.org/abs/2405.14093
- Towards Generalist Robot Policies: What Matters in Building Vision-Language-Action Models, arXiv:2412.14058 / project: https://robovlms.github.io/
- VLA-Arena benchmark project: https://vla-arena.github.io/
- Can VLA Models Learn from Real-World Data Continually without Forgetting?, arXiv:2605.26820: https://arxiv.org/abs/2605.26820
- AtomVLA: Scalable Post-Training for Robotic Manipulation via Predictive Latent World Models, arXiv:2603.08519: https://arxiv.org/abs/2603.08519