日期:2026-08-09
適合讀者:準備進入多模態大模型方向的研究生、科研新人,以及有工程背景、希望系統讀論文和做復現的 AI 讀者。
摘要
多模態 LLM 的論文很容易讀成“模型名盤點”:CLIP、Flamingo、BLIP-2、LLaVA、Qwen-VL、InternVL、Molmo、Gemini、GPT-4o、Llama Vision……每篇都在說模型更強、數據更多、benchmark 更高。但真正適合科研訓練的讀法,不是把榜單背下來,而是追問三個問題:視覺信息如何變成語言模型能使用的 token?圖文、視頻、文檔和指令數據如何改變模型行為?所謂多模態推理到底是在考感知、OCR、空間關係、數學圖表、長視頻記憶,還是語言先驗?
本文給出一條 Multimodal LLM 論文精讀路線。它把論文分成四層:視覺表徵、模態連接、對齊與指令數據、評測與推理。讀完一篇 VLM 論文時,你應該能畫出它的輸入分辨率、視覺編碼器、connector、LLM backbone、訓練階段、數據配方、評測集合和失敗類型。復現時,也不要一上來訓練大模型,而應從開源權重評測、數據格式復刻、少量指令微調和錯誤分析開始。
目錄
- 為什麼多模態 LLM 值得精讀
- 一張閱讀路線圖
- 代表論文時間線
- 四類關鍵問題:encoder、connector、data、reasoning
- 方法與實驗對比表
- 如何做一個可復現的小實驗
- 常見誤區
- 適合研究生繼續做的選題
- 參考資料
為什麼這個主題重要
多模態 LLM 是從“看圖說話”走向“以視覺為證據進行推理”的技術路線。早期視覺語言模型多關注檢索、分類、caption、VQA;現代 MLLM 則希望在同一個對話接口中處理圖像、視頻、文檔、圖表、屏幕、數學題和多輪指令。問題也因此變得更難:模型是否真的看懂了圖?是否只是利用題乾和選項中的語言線索?是否把 OCR 錯誤包裝成自信推理?是否在 chart、醫學圖像、GUI、長視頻中出現新的幻覺?
對研究生來說,這個方向特別適合訓練三種能力。第一,架構拆解能力:同樣是“接入視覺”,有的論文凍結 CLIP/ViT,只訓練 projector;有的使用 Q-Former、cross-attention、resampler;有的開始做原生多模態預訓練和多尺度視覺 token。第二,數據意識:多模態能力很大程度來自數據類型、過濾方式、合成指令、OCR/grounding 標註和偏好數據,而不是單一模塊創新。第三,評測敏感性:MMMU、MathVista、MMBench、Video-MME、CharXiv、MMStar 等 benchmark 測的不是同一種能力,直接比較總分往往會誤導選題。
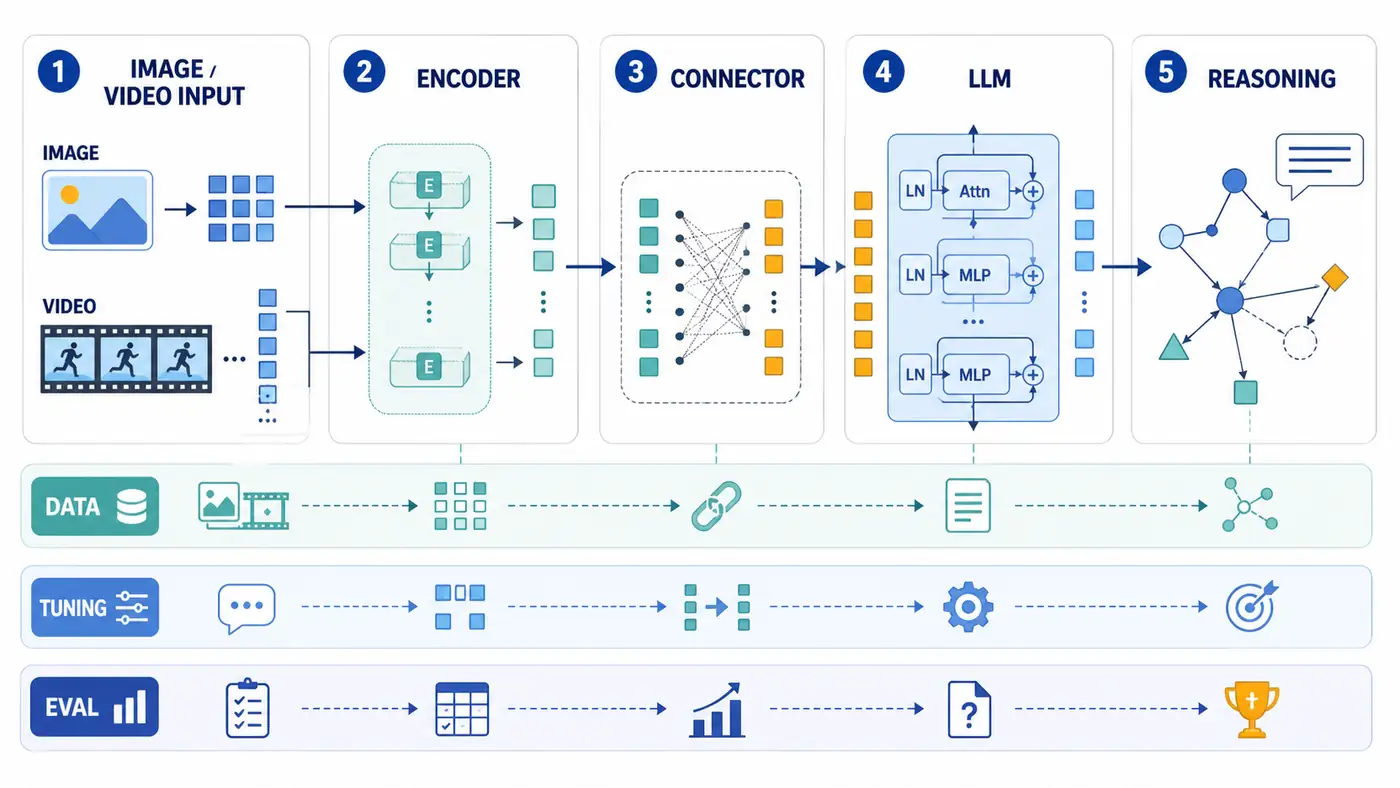
核心閱讀方法:先畫信息流,再看分數
讀多模態 LLM 論文時,建議先畫一張五段式信息流:
輸入層:論文支持單圖、多圖、視頻、文檔、屏幕截圖還是音頻?圖像是否被切成 patch、多尺度 crop、任意分辨率 tile?視頻是抽幀、時間位置編碼,還是音視頻交錯輸入?
視覺編碼器層:使用 CLIP ViT、SigLIP、EVA、InternViT、自研 ViT,還是端到端訓練的視覺模塊?視覺編碼器凍結還是參與訓練?如果凍結,論文是否解釋了分辨率、OCR、細粒度定位的瓶頸?
模態連接層:視覺 token 如何進入 LLM?常見路線包括線性 projector、MLP connector、Q-Former、Perceiver Resampler、cross-attention adapter、token pooling、dynamic resolution 和多層特徵融合。這裡要重點看 token 數量,因為它直接影響上下文成本、長視頻能力和推理延遲。
語言模型層:backbone 是 LLaMA/Qwen/Mistral/OLMo/InternLM/Gemma/Phi 還是閉源模型?論文是否把語言能力和視覺能力拆開評測?如果視覺模型換了 backbone,收益來自視覺訓練還是語言底座更強?
訓練與對齊層:至少拆成預訓練、圖文對齊、視覺指令微調、偏好優化/安全對齊、視覺推理強化或 test-time scaling。不要只記錄“用了多少數據”,還要記錄數據是 caption、OCR、region grounding、multi-image、video QA、chart、document、GUI,還是由強模型蒸餾出來的 synthetic instruction。
代表論文路線圖
第一階段:視覺-語言表徵對齊。 CLIP 用大規模圖文對比學習證明了自然語言監督可以形成可遷移視覺表徵。它不是現代聊天式 VLM,但它定義了很多後續模型的視覺編碼器起點:圖像不是先變成類別,而是變成能和語言空間對齊的 embedding。精讀 CLIP 時要關注訓練目標、負樣本規模、zero-shot prompt 和 robustness gap,而不是隻看 ImageNet。
第二階段:凍結大模型,學習模態接口。 Flamingo 把凍結視覺模型和凍結語言模型連接起來,通過 gated cross-attention 與 Perceiver-style resampler 支持 interleaved image/video/text few-shot prompting。BLIP-2 用 Q-Former 作為輕量橋接模塊,在凍結圖像編碼器和凍結 LLM 之間做兩階段預訓練。這一階段的核心問題是:如何用較少可訓練參數跨過“視覺表徵”和“語言生成”之間的模態間隙。
第三階段:視覺指令微調。 LLaVA 把 GPT-4 生成的視覺指令數據用於大模型對話能力構建,展示了“圖像-問答-解釋”格式對 MLLM 行為的巨大影響。LLaVA-1.5、LLaVA-NeXT、LLaVA-OneVision 等後續工作繼續擴展分辨率、多圖和視頻能力。讀這一路線要把數據構造、訓練階段和評測腳本讀得非常細,因為小改動常常帶來大幅分數變化。
第四階段:開源強模型與原生多模態預訓練。 Qwen-VL/Qwen2-VL/Qwen2.5-VL/Qwen3-VL、InternVL2/3/3.5、Molmo、Llama 3.2 Vision、MiniCPM-V/o、NVLM 等模型把重點從“能接圖”推進到“高分辨率文檔、長視頻、視覺定位、圖表推理、GUI 操作和多模態偏好優化”。例如,Qwen2.5-VL 技術報告覆蓋 3B、7B、72B 規模,並強調文檔解析、目標定位和長視頻理解;Qwen3-VL 官方資料進一步強調空間-時間建模、DeepStack 多層 ViT 特徵和視覺 agent 能力。InternVL3 把 native multimodal pretraining、mixed preference optimization 和 multimodal test-time scaling 放到核心位置。Molmo/PixMo 則強調開放權重、開放數據和可復現訓練配方。
第五階段:從圖片理解到 omni / video / action。 GPT-4o、Gemini 2.x、Qwen2.5-Omni、MiniCPM-o 等報告顯示,前沿模型開始處理圖像、文本、音頻、視頻和語音輸出。對本文主題來說,重點不是追蹤所有產品能力,而是理解多模態輸入如何改變評測方法:音視頻同步、時間戳、長上下文、流式輸入、實時交互和安全評測都會讓傳統 VQA 復現實驗不夠用。
關鍵論文精讀:四個入口
1. 視覺編碼器:它到底看到了什麼?
很多論文把視覺編碼器當作“現成模塊”,但復現時這裡經常決定上限。你要記錄編碼器類型、輸入尺寸、patch size、是否多尺度、是否支持任意分辨率、是否為 OCR/文檔優化。Llama 3.2 Vision 的模型卡明確說明其視覺模型通過單獨訓練的 vision adapter 將圖像編碼器表示接入 Llama 3.1 文本模型,並給出 11B、90B 兩個視覺模型規模。Molmo 官方博客則說明其模型使用多尺度、多 crop 預處理、ViT 圖像編碼器、MLP connector 和 token pooling。這樣的細節比“模型很強”更有研究價值。
讀 encoder 部分時可以問:如果把圖像縮小,文本、表格、小目標會丟失什麼?如果切 tile,空間關係如何保留?如果視頻只抽少量幀,事件順序是否仍可推理?如果使用 frozen CLIP,視覺表徵是否適合文檔、醫學圖像、GUI 和幾何圖?
2. Connector:模態間隙在哪裡被壓縮?
Connector 是多模態論文最容易被低估的部分。線性 projector 簡單、便宜、便於復現;Q-Former 和 resampler 能壓縮視覺 token 並選擇查詢;cross-attention adapter 可以讓語言層按需讀取視覺信息;多層特徵融合則試圖同時保留低層細節和高層語義。Qwen3-VL 技術報告提到 DeepStack 集成多層 ViT features,是近期“不要只取最後一層視覺特徵”的代表信號。
精讀時不要只看模塊圖,要查訓練目標是否真的迫使 connector 學會 grounding。只做 caption 可能會讓模型擅長描述,不一定擅長定位;只做 VQA 可能會過擬合題型;缺少 OCR 和結構化文檔數據時,圖表與論文截圖往往成為短板。
3. 對齊數據:能力來自哪些樣本?
多模態 LLM 的數據通常混合圖文對、caption、OCR、region-level grounding、多輪視覺對話、視頻字幕、文檔問答、數學圖表、GUI 操作和模型生成的 synthetic instruction。這裡要特別警惕“數據規模崇拜”。更大的數據並不自動等於更好的 reasoning;數據覆蓋、標註質量、去重、題目視覺依賴性和評測汙染更關鍵。
Molmo/PixMo 的價值在於把開放數據和訓練配方放到研究問題中心;LLaVA 路線的價值在於展示了視覺指令數據如何塑造對話行為;Qwen、InternVL 等技術報告的價值在於暴露工程化訓練階段如何變複雜。讀這些論文時,應把“數據從哪裡來、是否開放、能否復刻、是否蒸餾閉源模型、是否和 benchmark 重疊”寫進筆記。
4. 多模態推理:它是真的推理,還是語言先驗?
MMMU 強調大學級多學科知識和異質圖像類型;MathVista 關注視覺語境中的數學推理;MMBench 強調多維能力與 circular evaluation;Video-MME 關注長短視頻理解;CharXiv 用真實論文圖表檢驗 chart understanding;MMStar 明確指出許多樣本不需要視覺輸入也能答對,並提出多模態增益與洩漏指標。這些 benchmark 的共同提醒是:多模態分數不是單一能力。
做論文精讀時,建議把每個 benchmark 歸入一類問題:感知/OCR、空間關係、圖表、數學、文檔、視頻時間、領域知識、幻覺診斷、語言洩漏。然後再看模型在哪些類上提升。只報告平均分的論文,證據強度是不夠的。
方法與實驗對比表
| 路線 | 代表論文/系統 | 核心機制 | 精讀重點 | 復現入口 |
|---|---|---|---|---|
| 圖文對比表徵 | CLIP | 圖文對比學習,zero-shot 分類 | 訓練目標、prompt、魯棒性 | 用 open_clip 跑小數據 zero-shot/linear probe |
| 凍結模型橋接 | Flamingo、BLIP-2 | resampler、cross-attention、Q-Former | 凍結策略、視覺 token 壓縮 | 復現小型 VQA 或 caption 微調 |
| 視覺指令微調 | LLaVA 系列 | projector + visual instruction tuning | 指令數據、兩階段訓練、評測腳本 | 用開源權重跑 LMMs-Eval/VLMEvalKit |
| 開源強 VLM | Qwen-VL、InternVL、Molmo、MiniCPM-V | 高分辨率、多圖、視頻、文檔、偏好優化 | 數據配方、OCR/grounding、token 預算 | 固定模型,對比分辨率、prompt、採樣和評測 |
| omni / video / agentic | GPT-4o、Gemini、Qwen-Omni、Qwen3-VL | 音視頻、長上下文、時間對齊、GUI/agent | 輸入協議、時間建模、安全評測 | 以公開 API 或開源模型做受控案例研究 |
如何做一個可復現的小實驗
不要從訓練 70B VLM 開始。一個合理的研究生復現實驗可以這樣設計:
- 選一個開源模型族,例如 Qwen2.5-VL、LLaVA-OneVision、InternVL 或 Molmo,並固定具體 checkpoint、transformers/vLLM/VLMEvalKit 版本。
- 選兩個能力互補的 benchmark 子集,例如 MathVista testmini + CharXiv sample,或者 MMBench dev + Video-MME short subset。若排行榜或數據版本變化,記錄“待人工核驗”。
- 建立嚴格日誌:模型名、commit、權重來源、圖像分辨率、max pixels、frame 數、prompt 模板、temperature、seed、硬件、失敗樣例。
- 做一個小 ablation:只改一個變量,例如圖像分辨率、是否 OCR 文本外置、是否多圖合併、是否 CoT prompt、是否加入 self-consistency。
- 輸出錯誤分類,而不是隻輸出總分。至少分成 OCR 錯誤、定位錯誤、關係錯誤、數學推理錯誤、語言先驗覆蓋視覺證據、格式解析錯誤、拒答/安全策略影響。
這個實驗的價值在於訓練你把“模型能力”拆成可觀察現象。哪怕最終沒有超過任何 SOTA,也能形成可靠的復現筆記和 follow-up idea。
常見誤區
誤區一:把 VLM 看成 LLM 加圖片。 真正的問題是視覺 token 如何被壓縮、對齊和檢索。圖像不是 prompt 附件,而是另一套帶噪聲、分辨率和空間結構限制的證據。
誤區二:只比較榜單總分。 多模態 benchmark 的題型差異很大。MMStar 已經提醒:部分題目可能存在視覺非必要或洩漏問題。讀論文時必須檢查無圖 baseline、文本-only baseline 和題目去重策略。
誤區三:忽視數據開放性。 如果訓練數據、過濾規則、synthetic instruction 生成器和評測腳本都不可得,論文仍可學習思路,但復現目標要降級為“行為復現”或“消融復現”,不能承諾完整訓練復現。
誤區四:默認 CoT 提升代表視覺推理提升。 視覺題中的長解釋可能只是語言模型補全。需要檢查中間步驟是否可由圖像證據支持,必要時做遮擋、裁剪、無圖、反事實圖像和選項打亂實驗。
適合研究生繼續做的選題
- 視覺依賴性評測清洗:從已有 benchmark 中篩出無圖也能答對的樣本,構造更可靠的 visual-required 子集。
- Connector 層消融:在同一 encoder 和 LLM 下比較 projector、Q-Former、resampler、multi-layer feature fusion 的 token 效率與錯誤類型。
- 文檔與圖表的細粒度錯誤分析:圍繞 CharXiv、OCRBench v2、CC-OCR 或 LongDocURL,分析圖表元素、座標、圖例、單位和多頁定位錯誤。
- 長視頻時間推理:固定幀預算,比較均勻抽幀、事件檢索、字幕輔助和時間戳 prompt 對 Video-MME 類任務的影響。
- 多模態偏好優化的副作用:比較 SFT、DPO/MPO/RLHF 後模型在安全拒答、視覺幻覺和詳細解釋上的變化。
總結
Multimodal LLM 論文的精讀重點不是“誰第一”,而是理解視覺證據如何進入語言推理鏈。CLIP 告訴我們自然語言監督可以塑造視覺表徵;Flamingo 和 BLIP-2 告訴我們橋接模塊能用較少訓練成本連接凍結模型;LLaVA 路線說明指令數據會顯著改變模型行為;Qwen、InternVL、Molmo、Llama Vision 等技術報告展示了現代 VLM 已經進入高分辨率、多圖、視頻、文檔、偏好優化和 agentic 交互階段。
作為科研訓練,你的目標是讀完論文後能回答:模型看到了什麼、丟掉了什麼、如何對齊、靠什麼數據學會、在哪些 benchmark 上被驗證、失敗樣例說明了什麼。能回答這些問題,才算真正讀懂一篇多模態 LLM 論文。
參考資料
檢索日期:2026-08-09。以下鏈接優先選取論文、項目主頁、官方博客、模型卡或會議頁面;排行榜、API、模型發佈狀態和 benchmark 最新分數仍建議在投稿或復現實驗前再次人工核驗。
- Radford et al., “Learning Transferable Visual Models From Natural Language Supervision / CLIP,” OpenAI, 2021. https://openai.com/index/clip/ ,論文:https://arxiv.org/abs/2103.00020
- Alayrac et al., “Flamingo: a Visual Language Model for Few-Shot Learning,” DeepMind, 2022. https://deepmind.google/blog/tackling-multiple-tasks-with-a-single-visual-language-model/ ,論文:https://arxiv.org/abs/2204.14198
- Li et al., “BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models,” arXiv, 2023. https://arxiv.org/abs/2301.12597
- Liu et al., “Visual Instruction Tuning / LLaVA,” NeurIPS 2023 Oral, project and code. https://github.com/haotian-liu/LLaVA ,論文:https://arxiv.org/abs/2304.08485
- LLaVA-OneVision documentation, LLaVA-NeXT. https://github.com/LLaVA-VL/LLaVA-NeXT/blob/main/docs/LLaVA_OneVision.md
- Bai et al., “Qwen2.5-VL Technical Report,” arXiv, 2025. https://arxiv.org/abs/2502.13923 ,GitHub:https://github.com/QwenLM/Qwen2.5-VL
- Qwen Team, “Qwen3-VL Technical Report,” arXiv, 2025; official repo and blog. https://arxiv.org/abs/2511.21631 ,https://github.com/QwenLM/Qwen3-VL ,https://qwen.ai/blog?id=99f0335c4ad9ff6153e517418d48535ab6d8afef
- Zhu et al., “InternVL3: Exploring Advanced Training and Test-Time Recipes for Open-Source Multimodal Models,” arXiv, 2025; project page. https://internvl.github.io/blog/2025-04-11-InternVL-3.0/ ,https://github.com/OpenGVLab/InternVL
- Wang et al., “InternVL3.5: Advancing Open-Source Multimodal Models in Versatility, Reasoning, and Efficiency,” arXiv, 2025. https://huggingface.co/papers/2508.18265
- Deitke et al., “Molmo and PixMo: Open Weights and Open Data for State-of-the-Art Multimodal Models,” arXiv, 2024; Ai2 blog/repo. https://arxiv.org/abs/2409.17146 ,https://allenai.org/blog/molmo ,https://github.com/allenai/molmo
- Meta, “Llama 3.2 Vision Model Card,” 2024. https://github.com/meta-llama/llama-models/blob/main/models/llama3_2/MODEL_CARD_VISION.md
- OpenAI, “GPT-4o System Card,” 2024. https://openai.com/index/gpt-4o-system-card/
- Google, “Gemini 2.5: Our most intelligent AI model,” 2025. https://blog.google/innovation-and-ai/models-and-research/google-deepmind/gemini-model-thinking-updates-march-2025/
- Xu et al., “Qwen2.5-Omni Technical Report,” arXiv, 2025. https://arxiv.org/abs/2503.20215
- Yue et al., “MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark,” CVPR 2024 Oral. https://arxiv.org/abs/2311.16502
- Lu et al., “MathVista: Evaluating Mathematical Reasoning of Foundation Models in Visual Contexts,” ICLR 2024 Oral. https://mathvista.github.io/
- OpenCompass, “MMBench: Is Your Multi-modal Model an All-around Player?” official repo. https://github.com/open-compass/MMBench
- Fu et al., “Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis,” arXiv, 2024. https://video-mme.github.io/home_page.html
- Chen et al., “MMStar: Are We on the Right Way for Evaluating Large Vision-Language Models?” NeurIPS 2024. https://mmstar-benchmark.github.io/
- Wang et al., “CharXiv: Charting Gaps in Realistic Chart Understanding in Multimodal LLMs,” NeurIPS 2024 Datasets & Benchmarks. https://proceedings.neurips.cc/paper_files/paper/2024/hash/cdf6f8e9fd9aeaf79b6024caec24f15b-Abstract-Datasets_and_Benchmarks_Track.html ,repo:https://github.com/princeton-nlp/CharXiv
- Yang et al., “CC-OCR: A Comprehensive and Challenging OCR Benchmark for Evaluating Large Multimodal Models in Literacy,” ICCV 2025. https://mlanthology.org/iccv/2025/yang2025iccv-ccocr/