日期:2026-08-08
適合讀者:已經讀過 LLM reasoning、RAG 或 agent 論文,想系統理解工具調用、函數調用、可驗證執行和 agent benchmark 的研究生、科研新人和工程背景讀者。
摘要
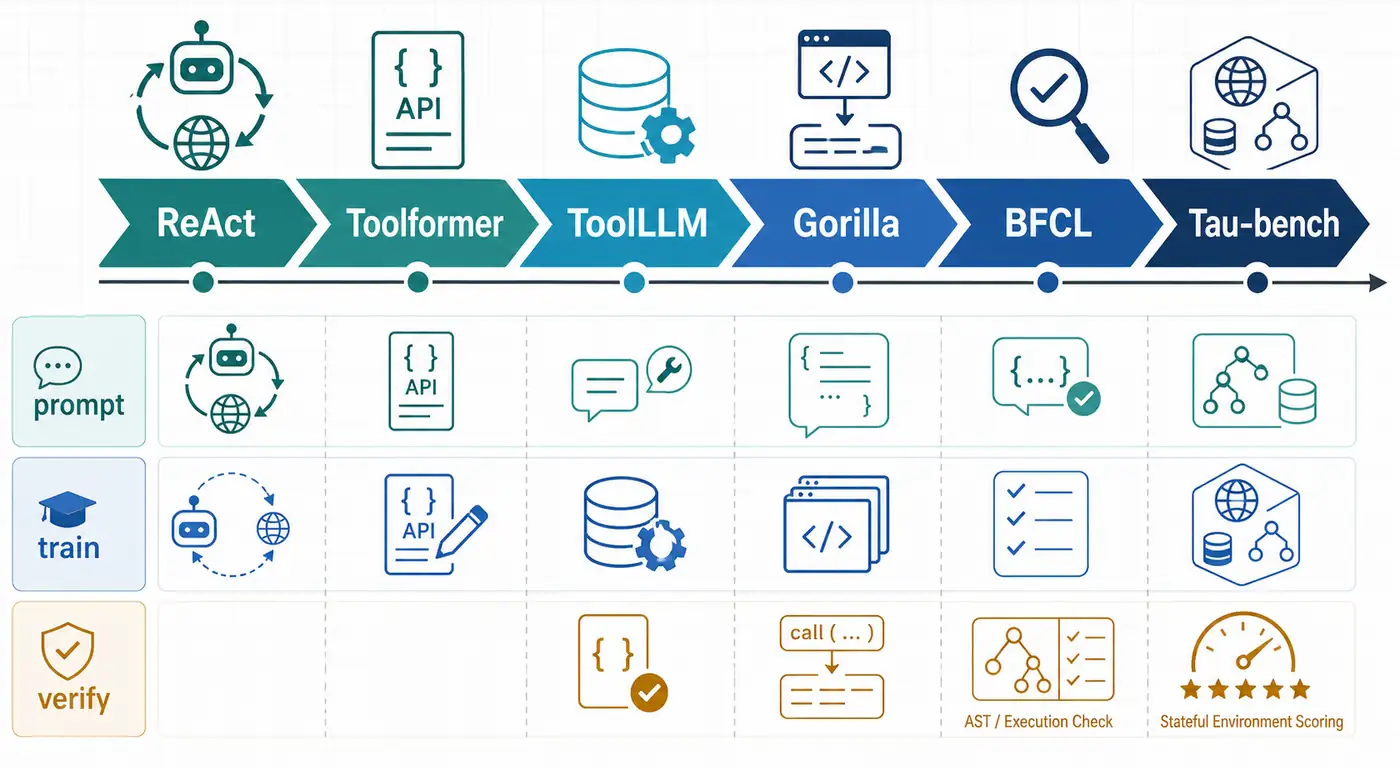
Tool-Using LLM 的核心問題不是“讓模型多一個插件”,而是讓模型在不確定任務中選擇合適動作、給出合法參數、讀取執行反饋、修正計劃,並在最後留下可審計的證據。過去幾年路線大致從 ReAct 的 reason-act-observe prompt,發展到 Toolformer 的自監督工具調用學習、ToolLLM / Gorilla 的大規模 API 數據與函數調用訓練,再到 BFCL、ToolSandbox、tau-bench、APIGen-MT、MCP 等關注結構化 schema、狀態變化、執行驗證和多輪交互的工作。本文給出一條論文精讀路線:讀這類論文時,不要只問“模型會不會調用工具”,而要拆成工具選擇、參數生成、執行結果利用、狀態一致性、拒調用、驗證器和復現實驗六個變量。
目錄
- 為什麼這個主題重要
- 核心閱讀方法:把工具調用拆成六個問題
- 代表論文路線圖
- 關鍵論文精讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
語言模型本身只是在生成文本。它能寫出“我將搜索數據庫”“我會調用天氣 API”,並不等於真的完成了任務。工具調用研究關心的是從自然語言意圖到外部世界動作的轉換:調用哪個函數、何時調用、參數是否符合 schema、執行結果是否被正確吸收、任務狀態是否真的改變、當工具不適用時是否會拒絕或追問。
這正是 Tool-Using LLM 與普通問答、RAG、reasoning 的分界。RAG 主要把外部知識檢索回來,工具調用則會改變環境或觸發計算;reasoning 關注中間推理路徑,工具調用還要求路徑裡的動作可以執行。一個 agent 可能看起來很會規劃,但只要把 user_id 填錯、把日期格式寫錯、在缺少必要參數時硬調用,最終就是失敗。
2025-2026 年之後,研究重心明顯轉向“可驗證”。BFCL 把函數調用評測從單輪選擇推進到 AST 匹配、並行調用、拒調用和多步 agentic 設置;tau-bench 讓 agent 與模擬用戶在零售、航旅等有狀態環境中對話,並用最終數據庫狀態對照目標狀態;ToolSandbox 強調狀態依賴、對話交互和動態里程碑;APIGen-MT 則把多輪工具數據構造成可執行、可驗證的模擬交互。對科研訓練來說,這個方向非常適合練習“從論文主張到可復現實驗”的能力,因為每個結論都可以追問:工具執行了嗎?狀態對了嗎?失敗能定位嗎?
核心閱讀方法:把工具調用拆成六個問題
第一,工具接口如何表示。 ReAct 早期多用自然語言 action;Toolformer 把 API 調用插入文本;現代 function calling 通常使用 JSON schema、參數類型和工具描述。讀論文時要記錄工具描述是人工寫的、自動抽取的,還是由協議或 SDK 生成的。schema 越嚴格,評測越容易;工具描述越開放,模型越容易幻覺參數。
第二,調用策略從哪裡來。 ReAct 依賴少量軌跡示例;Toolformer 通過採樣 API 調用並保留降低語言模型 loss 的樣本來訓練;ToolLLM 使用從 RapidAPI 收集的大規模工具和自動構造的 solution path;Gorilla / OpenFunctions 一類工作把 API 文檔和調用格式作為訓練對象;APIGen 和 APIGen-MT 更強調合成數據必須經過執行、格式和語義驗證。讀這條線,要分清 prompt 能力、SFT 數據能力和執行環境能力。
第三,工具選擇和參數生成是否分開評測。 模型選對工具但參數錯,和選錯工具但格式正確,是兩類失敗。BFCL 的價值之一是把多語言、並行調用、多函數候選、相關性檢測等場景納入評測。做閱讀筆記時,建議每篇論文都寫一列:它主要測 tool selection、argument filling、multi-step planning、state tracking,還是 final outcome。
第四,工具結果如何進入下一步推理。 真正的 agent 不只是“一次調用”。它要讀取 observation,更新工作記憶,判斷是否繼續調用、換工具、追問用戶或停止。tau-bench、ToolSandbox、APIGen-MT 這類多輪環境的難點就在這裡:模型可能前幾步都正確,最後因為忘記政策約束、忽略數據庫狀態或錯誤吸收 API 返回而失敗。
第五,評測是否執行或近似執行。 最弱的評測是讓另一個 LLM 判斷調用是否合理;更可靠的是 AST / schema 匹配;再進一步是實際執行函數,檢查返回值、數據庫狀態、文件系統變化或任務目標。每篇論文的可信度很大程度取決於它的驗證信號。如果工具本身是 live API,還要檢查 API 版本、網絡波動、權限和數據是否隨時間變化。
第六,安全邊界在哪裡。 工具調用把模型輸出變成動作,因此必須讀拒調用、權限、用戶確認、錯誤處理和審計日誌。MCP 規範和主流 Agents SDK 都把工具 schema、調用控制和人工確認作為系統設計問題,而不是隻靠模型“自覺”。科研復現時,安全邊界可以簡化,但不能從問題定義裡消失。
代表論文路線圖
| 階段 | 代表工作 | 精讀抓手 |
|---|---|---|
| 推理-行動交錯 | ReAct | thought-action-observation 軌跡,錯誤是否可人工診斷 |
| 自監督工具學習 | Toolformer | 採樣哪些 API 調用,如何篩選“有幫助”的調用 |
| 多模態/開放工具訓練 | GPT4Tools, ToolLLM | 指令數據如何合成,seen/unseen tools 如何評測 |
| API 函數調用專訓 | Gorilla, OpenFunctions, xLAM/APIGen | API 文檔、schema、retriever、合成數據和執行驗證 |
| 函數調用 benchmark | BFCL, ACEBench | AST 匹配、並行調用、拒調用、多輪和不完整指令 |
| 有狀態 agent 評測 | ToolSandbox, tau-bench, APIGen-MT | 用戶模擬、狀態轉移、pass^k、數據庫目標狀態 |
| 協議和運行時 | MCP, Agents SDK, terminal-use benchmarks | 工具發現、權限、日誌、真實環境執行和可復現性 |
這張表不是論文排名,而是讀文獻時的座標系。一個新工作如果聲稱“提升 tool use”,先判斷它改的是接口、訓練數據、檢索、調用格式、執行器、環境模擬,還是評測協議。
關鍵論文精讀
ReAct。 ReAct 的貢獻是把 reasoning traces 和 task-specific actions 交錯生成,讓模型在“想一步、做一步、看反饋”之間循環。精讀時不要停在 prompt 模板,而要看四類任務:HotpotQA、FEVER、ALFWorld、WebShop 分別代表知識檢索、事實驗證、交互環境和網頁購物。復現可以從一個小型 Wikipedia search 或 WebShop-like 環境開始,重點記錄 action 是否改變了 observation,以及錯誤能否通過軌跡定位。
Toolformer。 Toolformer 把工具使用改寫成語言建模數據篩選問題:先給少量 API 示例,再讓模型在文本中採樣可能的調用,執行工具,保留能改善後續 token 預測的調用。它最值得學習的是“無需大量人工工具軌跡”的訓練思路。閱讀時要追問:保留下來的調用是否真的對任務有因果幫助?對搜索、計算器、翻譯、日曆等不同工具,收益機制是否一樣?
ToolLLM / ToolBench。 ToolLLM 把問題規模放大到真實 API 集合,使用 API 收集、指令生成、solution path 標註和 ToolEval 評測。它適合訓練你閱讀數據構造論文:API 來自哪裡,類別是否均衡,自動標註是否可驗證,unseen API 的泛化如何定義。注意 ToolBench 依賴真實 API 時容易遇到 API 失效和不可復現問題,因此後續工作常引入虛擬 API 或可執行 sandbox。
Gorilla 與 BFCL。 Gorilla 關注把 LLM 連接到大量 API,減少調用幻覺;BFCL 則把函數調用能力做成更標準化的 benchmark。BFCL 的精讀重點是評測設計:AST 匹配為什麼比純字符串匹配更穩,serial / parallel / multiple function call 如何區分,函數相關性檢測如何測試拒調用。2025 的 ICML/PMLR 版本和 Berkeley 項目頁都顯示,BFCL 已從單輪函數調用延伸到更 agentic 的評測設置; live leaderboard 的具體名次和模型版本變化快,寫論文或博客時應標註“檢索日期”和“待人工核驗”。
tau-bench。 tau-bench 的核心不是多了幾個工具,而是把工具調用放進用戶對話和業務規則中。它用模擬用戶與 agent 對話,agent 調用 API 並遵守政策,最後比較數據庫狀態與目標狀態,還提出 pass^k 來衡量多次運行的一致性。讀這篇時要重點看兩件事:第一,任務成功不是“回答聽起來對”,而是環境狀態真的對;第二,同一個任務多次運行是否穩定,比一次成功更接近可靠性。
ToolSandbox 與 APIGen-MT。 ToolSandbox 進一步強調 stateful、conversational、interactive:工具之間有隱含狀態依賴,用戶信息可能分多輪給出,評價包含中間裡程碑和 minefield。APIGen-MT 則從數據生成角度解決多輪工具數據稀缺問題:先生成可驗證任務藍圖,再模擬 human-agent-environment 軌跡,並用執行和語義檢查過濾。兩者適合放在一起讀:一個告訴你好的評測環境長什麼樣,一個告訴你如何合成可驗證多輪訓練數據。
MCP 與現代 Agents SDK。 協議和 SDK 不是傳統論文,但對 2025-2026 的工具調用研究很重要。MCP 標準化了工具如何暴露給模型,工具包含名稱、描述和 schema;OpenAI Agents SDK 等運行時把 hosted tools、function tools、MCP servers、錯誤處理、審批和 tracing 放進統一 agent loop。讀這些資料的目的不是學習某個產品,而是理解研究實驗如何逐漸靠近真實運行時:工具發現、權限、日誌和可審計性都會影響結果。
方法與實驗對比表
| 方法 | 主要變量 | 適合任務 | 復現風險 |
|---|---|---|---|
| ReAct prompting | 示例軌跡、action 格式、observation 設計 | 搜索問答、網頁導航、小型交互環境 | prompt 洩漏,軌跡格式脆弱 |
| Toolformer 式自監督 | API 示例、採樣位置、執行結果、loss 篩選 | 計算、檢索、翻譯、日曆等工具 | “有幫助”信號可能只適配局部分佈 |
| Tool instruction tuning | API 文檔、合成指令、solution path | 大工具集、seen/unseen API 泛化 | 自動標註錯誤和真實 API 失效 |
| Function calling SFT | schema、參數類型、拒調用樣本 | 工程函數調用、並行調用 | 只學格式,不學任務狀態 |
| AST/schema 評測 | 解析器、等價規則、參數容差 | 大規模函數調用 leaderboard | 與真實執行結果仍有差距 |
| Stateful sandbox | 用戶模擬、數據庫狀態、里程碑 | 客服、日程、文件、終端任務 | 環境構造成本高,任務設計需人工審查 |
| MCP/agent runtime | 工具發現、權限、日誌、錯誤處理 | 真實 agent 系統和長期實驗 | 版本變化快,需要鎖定協議和依賴 |
讀實驗表時,至少記錄四類指標:調用格式正確率、工具選擇正確率、任務最終成功率、穩定性或 pass^k。只報告 final answer 或 LLM judge 分數,無法說明工具調用能力。
復現建議
不要一開始復現完整 tau-bench 或 BFCL。更適合訓練營的是搭一個小型可執行 tool-use lab。
- 定義 10-20 個本地函數。 例如查詢課程表、讀寫 JSON 數據庫、計算統計量、生成文件、校驗日期。每個函數寫清 schema、參數類型、錯誤返回和權限。
- 構造 100 條任務。 覆蓋單工具、多工具、並行工具、缺少參數、錯誤參數、無合適工具、需要追問、需要拒絕等類別。
- 實現三個基線。 Direct answer、ReAct text action、structured function calling。所有基線使用同一模型、同一任務集和同一執行器。
- 設計執行驗證器。 不要只看模型輸出。對每題檢查函數調用序列、參數、返回值利用、最終數據庫或文件狀態。
- 記錄完整日誌。 保存 prompt、model、temperature、tool schema、每輪消息、tool call、tool output、錯誤棧、最終狀態和評分腳本版本。
- 做 failure taxonomy。 至少區分:工具選擇錯、參數錯、缺參未追問、調用順序錯、忽略 observation、狀態更新錯、應該拒絕卻調用、格式解析失敗。
- 做 ablation。 去掉工具描述細節、打亂工具順序、加入相似工具、加入無關工具、限制最大調用步數,觀察失敗類型如何變化。
最終 reproduction report 不必追求大榜分數,而要能回答一個研究問題:結構化 schema、執行反饋和狀態驗證分別減少了哪類錯誤?
常見誤區
- 把“能輸出函數名”當成會用工具。 真正的工具調用還包括參數、順序、執行反饋和最終狀態。
- 只測單輪乾淨指令。 真實用戶經常缺參數、改需求、說錯信息或請求越權;這些才是工具 agent 的關鍵難點。
- 混淆檢索和行動。 搜索是工具的一種,但寫數據庫、下訂單、發郵件、改文件需要更強的權限和驗證。
- 用 live API 做不可復現實驗。 API 版本、額度、網絡和數據都會變。嚴肅復現應優先使用 mock server、fixture 或本地 sandbox。
- 忽略拒調用。 好的工具 agent 不只是多調用,還要知道什麼時候不調用、追問或請求人工確認。
- 迷信 leaderboard 名次。 BFCL、tau-bench、MCP 相關榜單更新很快,具體模型排名必須按檢索日期核對,不能寫成長期結論。
適合研究生繼續做的選題
- 工具描述魯棒性。 系統研究 schema 描述長度、參數示例、錯誤提示和工具順序對調用結果的影響。
- 拒調用數據集。 構造缺參、越權、無工具可用、工具結果衝突的樣本,評估模型何時應該停止或追問。
- 執行反饋學習。 比較只用 final state、完整軌跡、錯誤棧和人工 failure label 對後續 SFT/RL 的貢獻。
- 狀態壓縮記憶。 多輪工具任務中,哪些狀態必須保留在上下文,哪些可以通過重新查詢恢復。
- 工具調用 reward model。 研究 reward model 是否能識別參數錯誤、順序錯誤和無效調用,而不是隻偏好流暢解釋。
- MCP-enabled agent benchmark。 在可控本地 MCP server 上設計小而真實的任務,評估工具發現、權限確認和日誌審計。
總結
Tool-Using LLM 的研究主線可以概括為:先用 ReAct 把思考和行動交錯起來,再用 Toolformer / ToolLLM / Gorilla 讓模型學會 API 格式和大規模工具集合,最後用 BFCL、ToolSandbox、tau-bench、APIGen-MT、MCP 和真實運行時把“會調用”推進到“可驗證、可審計、可復現”。讀這類論文時,最重要的不是記住某個榜單第一,而是建立一套檢查框架:接口是否結構化,調用是否執行,狀態是否正確,失敗是否可定位,權限是否可控,實驗是否能在未來重跑。
如果只讀五篇,建議從 ReAct、Toolformer、ToolLLM、BFCL、tau-bench 開始;如果要做一個可發表的小選題,則從本地 sandbox 和 failure taxonomy 開始。工具調用不是 agent 的全部,但它是 agent 從“會說”走向“會做”時最容易被嚴格驗證的一段路徑。
參考資料
檢索日期:2026-08-08。
- Shunyu Yao et al. “ReAct: Synergizing Reasoning and Acting in Language Models.” Project page, arXiv 2022, ICLR 2023. https://react-lm.github.io/
- Timo Schick et al. “Toolformer: Language Models Can Teach Themselves to Use Tools.” NeurIPS 2023. https://proceedings.neurips.cc/paper/2023/hash/d842425e4bf79ba039352da0f658a906-Abstract-Conference.html
- Rui Yang et al. “GPT4Tools: Teaching Large Language Model to Use Tools via Self-instruction.” NeurIPS 2023. https://papers.neurips.cc/paper_files/paper/2023/hash/e393677793767624f2821cec8bdd02f1-Abstract-Conference.html
- Yujia Qin et al. “ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs.” ICLR 2024. https://proceedings.iclr.cc/paper_files/paper/2024/hash/28e50ee5b72e90b50e7196fde8ea260e-Abstract-Conference.html
- Shishir G. Patil et al. “Gorilla: Large Language Model Connected with Massive APIs.” Project page and official GitHub. https://gorilla.cs.berkeley.edu/ ; https://github.com/ShishirPatil/gorilla/
- Shishir G. Patil et al. “The Berkeley Function Calling Leaderboard (BFCL): From Tool Use to Agentic Evaluation of Large Language Models.” ICML 2025, PMLR. https://proceedings.mlr.press/v267/patil25a.html
- Berkeley Sky Computing Lab. “Berkeley Function-Calling Leaderboard.” Project page, updated 2025. https://sky.cs.berkeley.edu/project/berkeley-function-calling-leaderboard/
- Shunyu Yao et al. “tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains.” ICLR 2025. https://proceedings.iclr.cc/paper_files/paper/2025/hash/1b126cc38b8638e07bef37e7b2bb72bf-Abstract-Conference.html
- tau-bench official site and benchmark evolution notes. https://taubench.com/
- Jiarui Lu et al. “ToolSandbox: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities.” arXiv 2024; official repository linked in paper. https://arxiv.org/abs/2408.04682 ; https://github.com/apple/ToolSandbox
- Zuxin Liu et al. “APIGen: Automated Pipeline for Generating Verifiable and Diverse Function-Calling Datasets.” arXiv 2024; project page. https://arxiv.org/abs/2406.18518 ; https://apigen-pipeline.github.io/
- Akshara Prabhakar et al. “APIGen-MT: Agentic Pipeline for Multi-Turn Data Generation via Simulated Agent-Human Interplay.” arXiv 2025; project page. https://apigen-mt.github.io/
- Zhengliang Shi et al. “Tool Learning in the Wild: Empowering Language Models as Automatic Tool Agents.” WWW 2025, OpenReview. https://openreview.net/forum?id=T4wMdeFEjX
- OpenAI Help Center. “Function Calling in the OpenAI API.” Updated 2026. https://help.openai.com/en/articles/8555517
- OpenAI Agents SDK. “Tools.” Official documentation. https://openai.github.io/openai-agents-python/tools/
- Model Context Protocol. “Tools.” Specification 2025-06-18. https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- TUA-Bench. “A Benchmark for General-Purpose Terminal-Use Agents.” Official site, arXiv citation shown on page. https://tuabench.ai/
- Huanzhi Mao et al. “MFCL Vision: Benchmarking Tool Use in Multimodal Large Language Models for Visual Reasoning Tasks.” NeurIPS 2025 Workshop, OpenReview. https://openreview.net/forum?id=vV4tC5rhw6