日期:2026-08-06
適合讀者:已經讀過 Transformer、Instruction Tuning、RLHF 或偏好優化,想系統理解“推理模型”論文如何從提示技巧走向訓練範式、推理預算和可驗證搜索的研究生、科研新人和工程背景讀者。
摘要
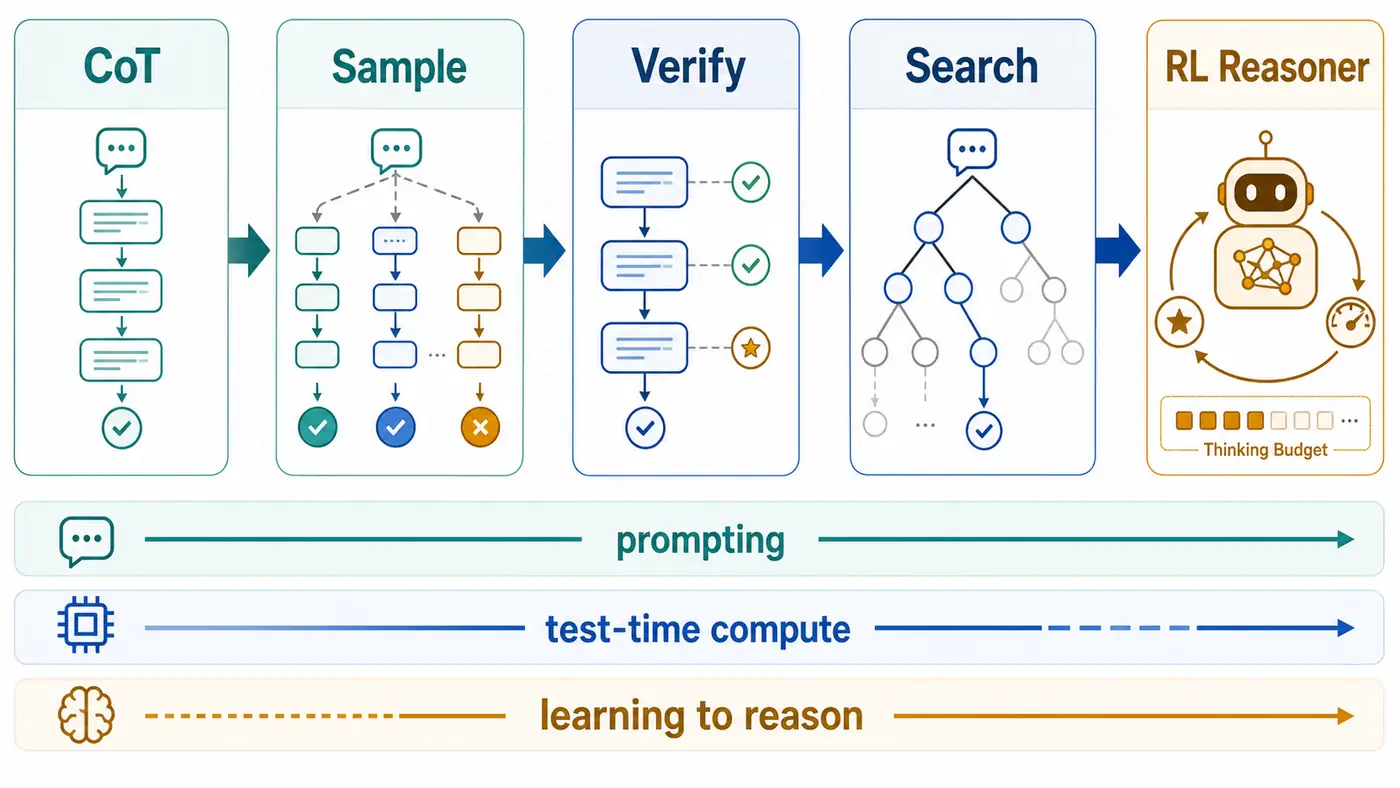
Reasoning Models 不是“讓模型多輸出幾行思考過程”這麼簡單。過去幾年的路線大致經歷了五個階段:Chain-of-Thought 讓中間步驟顯式化;Self-Consistency 把一次解題改成多路徑採樣與答案聚合;Verifier 與 Process Supervision 把“誰的推理更可靠”變成可學習的監督信號;Tree/Search 方法把推理路徑當成可探索空間;2024-2026 年的 o1、DeepSeek-R1、Kimi k1.5、s1、Qwen3 等工作,則把訓練時強化學習、測試時計算預算、長 CoT、蒸餾和可驗證獎勵推到同一張研究地圖裡。本文給出一條適合精讀和復現的論文路線:讀每篇論文時不要只看 benchmark 分數,而要追問任務是否可驗證、推理軌跡是否被監督、搜索空間如何定義、額外計算花在哪裡、失敗樣例是否能定位到具體步驟。
目錄
- 為什麼這個主題重要
- 核心閱讀方法:把推理拆成五個變量
- 代表論文路線圖
- 關鍵論文精讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
“推理”是 LLM 論文裡最容易被濫用的詞。一個模型能在 GSM8K、MATH、AIME、GPQA、Codeforces 或程序合成任務上得高分,可能意味著它真的學會了更穩健的中間步驟,也可能只是更會模式匹配、採樣更多答案、調用了強驗證器,或者 benchmark 已經被訓練數據間接覆蓋。因此,讀 Reasoning Models 的第一條原則是:不要先問“這個模型聰不聰明”,先問“這篇論文把什麼叫作推理”。
經典 CoT 論文的貢獻是讓中間步驟進入輸入輸出接口:模型不再只生成答案,而是生成可讀的解題過程。Self-Consistency 的貢獻是把“單一路徑”換成“多條候選路徑”,用答案一致性降低偶然錯誤。GSM8K verifier 和 PRM800K 一類工作繼續推進:如果可以給候選解或中間步驟打分,推理就可以被選擇、訓練和監督。Tree of Thoughts 則進一步把候選步驟組織成搜索樹,而不是隻在 token 層自迴歸地走一條路。
2025 年之後,Reasoning Models 的焦點發生變化。DeepSeek-R1 把可驗證任務上的強化學習放到中心位置,展示了不用大量人工標註推理軌跡也能誘發自我反思、驗證和策略切換。Kimi k1.5 強調 RL 擴展、長上下文和 long2short。s1 用一個很小的高質量推理數據集和 budget forcing 研究測試時擴展的最小路徑。Qwen3 技術報告則把 thinking mode、non-thinking mode 和 thinking budget 寫進開源模型族的接口。這些工作共同說明:推理模型已經從 prompt engineering 主題變成訓練數據、獎勵設計、推理控制、評測可驗證性和系統成本共同決定的研究方向。
核心閱讀方法:把推理拆成五個變量
讀這一方向,建議把每篇論文拆成五個變量。
第一,任務是否可驗證。 數學題、代碼題、形式化證明、部分科學問答可以用答案、單元測試、證明檢查器或規則驗證;開放問答、規劃、寫作和安全判斷則更依賴人評或模型評審。可驗證任務天然適合採樣、rerank、RL 和搜索;不可驗證任務更容易出現 reward hacking 或“看起來合理但無法證明”的推理鏈。
第二,推理軌跡從哪裡來。 CoT 使用少量人工示例誘導軌跡;STaR、least-to-most、Auto-CoT 等工作嘗試自動構造或分解軌跡;Process Supervision 需要步驟級標註;DeepSeek-R1-Zero 一類路線希望通過可驗證獎勵讓模型自己發展長推理模式。筆記裡要記錄軌跡是人工寫的、模型生成的、篩選過的,還是 RL 過程中湧現的。
第三,選擇發生在什麼層級。 Self-Consistency 在答案層投票;verifier 在整條解答層評分;process reward model 在步驟層評分;Tree of Thoughts 在“thought”層擴展和剪枝;代碼與證明任務可在執行器或 proof checker 層驗證。層級越細,監督成本和錯誤定位能力通常越高。
第四,額外計算花在哪裡。 推理模型常把性能提升建立在更多測試時計算上:多采樣、長 CoT、反思、搜索、驗證器打分、工具執行、rerank。復現實驗必須記錄 samples、temperature、max tokens、thinking budget、搜索寬度、搜索深度、verifier 成本和失敗重試策略,否則結果不可比較。
第五,評測是否區分結果正確和過程可靠。 最終答案正確不代表中間過程可信;中間過程看起來漂亮也不保證答案正確。ProcessBench 的價值就在於把錯誤定位到最早出錯步驟,提醒我們 PRM 是否能泛化到更難數學題,是獨立問題而不是天然成立。
代表論文路線圖
| 階段 | 代表工作 | 精讀抓手 |
|---|---|---|
| 顯式中間步驟 | Chain-of-Thought, Least-to-Most | prompt 示例如何改變任務分解,是否只適用於大模型 |
| 多路徑採樣 | Self-Consistency, Large Language Monkeys | coverage、pass@k、consensus、verifier selection 的關係 |
| 結果驗證器 | GSM8K verifier, code unit tests | 生成與驗證哪個更難,驗證器是否過擬合答案模式 |
| 步驟監督 | Let's Verify Step by Step, PRM800K, ProcessBench | outcome supervision 與 process supervision 的差異,步驟標註成本 |
| 搜索式推理 | Tree of Thoughts, MCTS-style reasoning | state、action、thought、value、剪枝策略如何定義 |
| 強化學習推理模型 | OpenAI o1 report, DeepSeek-R1, Kimi k1.5 | train-time compute、test-time compute、可驗證獎勵、長 CoT |
| 開源推理接口 | s1, Qwen3 | thinking budget、budget forcing、distillation、可復現訓練腳本 |
這張表不是“必讀清單排名”,而是讀論文時的座標系。一個新工作如果聲稱提升 reasoning,你可以先判斷它主要改了哪一列:提示、採樣、驗證、步驟監督、搜索、RL 還是推理預算。
關鍵論文精讀
Chain-of-Thought Prompting。 這篇論文要讀的是“現象”和“邊界”。它說明在足夠大的語言模型上,少量帶中間步驟的示例可以誘發更好的多步推理表現。精讀時不要只記“think step by step”,而要看實驗任務類型、模型規模、示例構造方式,以及小模型為什麼沒有同樣收益。復現時最重要的是固定 prompt、示例順序、解碼參數和答案抽取規則。
Self-Consistency。 它把 CoT 從貪心解碼改成採樣多條推理路徑,再按答案一致性做邊緣化選擇。這裡的研究方法論很關鍵:當問題存在多個合理解題路徑但答案唯一時,多樣化採樣可以提升魯棒性;當答案開放、答案抽取不穩定或模型系統性誤解題意時,投票可能只是放大同一個錯誤。讀這篇要畫出 sampling、answer extraction、majority vote 三個環節。
Training Verifiers 與 Let's Verify Step by Step。 GSM8K verifier 工作展示了“生成多個候選,再由驗證器選擇”的基本範式。Let's Verify Step by Step 則把監督從最終答案推進到中間步驟,併發布 PRM800K 步驟級反饋數據。精讀這類論文,核心是比較 outcome supervision 和 process supervision:前者便宜但信用分配粗,後者更可診斷但標註成本高、標註一致性難、可能只覆蓋某類題目風格。
Tree of Thoughts。 ToT 的關鍵不是“樹”這個視覺隱喻,而是把語言模型生成的中間 thought 變成可搜索對象。讀這篇要明確:狀態是什麼,下一步候選如何產生,value 或 vote 如何評估,BFS/DFS 如何剪枝,任務是否真的需要全局搜索。它在 Game of 24、Mini Crosswords 這類任務上很直觀,但遷移到開放研究問題時,搜索空間和評價函數會變得模糊。
OpenAI o1 報告。 官方報告提供的是高層技術信號而不是完整可復現論文:它把 train-time compute 和 test-time compute 明確列為推理能力提升軸,並展示了在數學、代碼、GPQA 等任務上的評估。讀這種模型報告時要特別謹慎:可以學習問題定義、評測選擇和安全觀察,但不能把未公開訓練細節當成可復現實驗方案。
DeepSeek-R1。 DeepSeek-R1 的重要性在於把“可驗證任務 + 強化學習 + 推理模式湧現”講清楚,並區分了 DeepSeek-R1-Zero 和帶 cold-start、多階段訓練的 DeepSeek-R1。精讀時要追問四件事:獎勵來自哪裡,哪些任務可自動驗證,為什麼不依賴人工長 CoT 仍能出現 self-reflection,蒸餾到小模型時到底蒸餾了能力、格式還是搜索策略。由於 arXiv 頁面顯示該工作在 2026-01-04 更新到 v2,並有關聯 Nature 2025 版本,引用時應註明版本。
Kimi k1.5、s1 與 Qwen3。 Kimi k1.5 把 RL 擴展、長上下文和 long2short 放在一起,強調不依賴複雜 MCTS、價值函數和 PRM 的簡潔 RL 框架。s1 則從相反方向問:用 1000 條高質量推理樣本、SFT 和 budget forcing,能否獲得簡單的測試時擴展路徑。Qwen3 技術報告把 thinking / non-thinking 與 thinking budget 作為模型族能力的一部分,並公開 Apache 2.0 模型。三者適合放在一起讀:一個看大規模訓練實踐,一個看小規模復現實驗,一個看開源模型接口如何暴露推理預算。
方法與實驗對比表
| 方法 | 主要變量 | 適合任務 | 復現風險 |
|---|---|---|---|
| CoT prompting | 示例數量、示例質量、解碼參數 | 數學、常識、多步問答 | prompt 洩漏、答案抽取不一致 |
| Self-consistency | sample 數、temperature、投票規則 | 答案唯一但路徑多樣的問題 | 成本高,錯誤路徑可能同質化 |
| Outcome verifier | 候選數量、驗證器訓練集、rerank 規則 | 數學、代碼、選擇題 | 驗證器記答案或過擬合分佈 |
| Process reward model | 步驟粒度、標註協議、錯誤定位 | 數學推導、證明、可分步任務 | 標註貴,跨難度泛化不穩 |
| Tree/search | 狀態定義、寬度、深度、value 函數 | 規劃、組合搜索、遊戲題 | 評價函數模糊時搜索無意義 |
| RL reasoner | 獎勵、policy optimizer、探索預算 | 可驗證數學、代碼、STEM | reward hacking,訓練成本高 |
| Thinking budget | max tokens、預算強制、停止策略 | 需要速度/準確率折中的任務 | 不同模型接口不可直接比較 |
讀實驗表時,不要只看 pass@1。Reasoning paper 常用 pass@k、consensus、rerank、coverage、step error localization、token budget、latency 和 cost。最基本的復現表至少要同時報告:單次答案、同預算多采樣、同樣 token 上限、是否使用 verifier、是否使用工具或測試用例、失敗案例分類。
復現建議
不要一開始復現完整 DeepSeek-R1 或 Kimi k1.5。更好的訓練營路徑是做一個小而可診斷的 reasoning lab。
- 選擇可驗證任務。 用 GSM8K、MATH 子集、HumanEval/MBPP 小樣本、或你自己構造的 100-300 道可自動判分題。優先選擇能自動判 final answer 的任務。
- 建立四個基線。 Direct answer、CoT greedy、CoT self-consistency、CoT + verifier/reranker。每個基線固定模型、prompt、temperature、max tokens 和答案抽取腳本。
- 記錄推理預算。 對每題記錄生成樣本數、輸出 token、總推理時間、失敗重試次數和驗證器調用次數。沒有預算記錄,任何“推理能力提升”都不完整。
- 做步驟級錯誤標註小樣本。 隨機抽 50 個失敗案例,人工標註最早錯誤步驟:讀題錯誤、公式錯誤、算術錯誤、搜索方向錯誤、答案格式錯誤、驗證器誤判。
- 復現一個 search toy task。 用 Game of 24 或 Mini Crosswords 復現 ToT 思路,比較寬度、深度、value prompt 和 vote prompt。目標不是追 SOTA,而是理解搜索變量。
- 加入 budget ablation。 讓 sample 數從 1、4、8、16 增加,或讓 thinking token budget 分檔,觀察準確率、成本和失敗類型是否同步變化。
建議輸出一份 reproduction report:實驗設置、數據版本、模型版本、prompt、seed、預算、指標、結果表、失敗案例、你認為最可能的機制解釋。注意:如果使用閉源模型或在線 API,模型版本可能發生變化,報告中必須寫明調用日期和模型名稱;若無法鎖定版本,標註“待人工核驗”。
常見誤區
- 把長答案當成長推理。 長 CoT 可能包含反覆、跑題和自我合理化;判斷它有用,需要看 final answer、步驟錯誤和預算收益。
- 只比較準確率,不比較成本。 一個 64-sample consensus 方法如果只比 1-sample 高一點點,在研究上可能有價值,但工程和論文結論都必須寫清預算。
- 用不可驗證任務證明驗證器有效。 如果沒有獨立標籤、執行器、證明檢查器或人類專家審查,驗證器分數很容易變成另一個模型偏好。
- 忽略答案抽取。 數學和代碼評測中,答案格式、單位、等價表達、浮點容差都會製造假失敗或假成功。
- 把 benchmark 提升等同於通用推理。 GSM8K、MATH、AIME、GPQA、Codeforces 測的是不同能力,不應混成一個“reasoning score”。
- 把公開模型報告當完整論文。 o1、部分商業模型報告提供重要線索,但訓練細節、數據和代碼不完整時,不能寫成可復現實驗證據。
適合研究生繼續做的選題
- 推理預算路由器。 給定問題難度、模型置信度和成本約束,動態選擇 direct、CoT、self-consistency、verifier 或 search。
- PRM 跨難度泛化。 用 GSM8K/MATH 訓練或篩選的過程獎勵模型,是否能定位奧賽級題目的早期錯誤。
- 長 CoT 壓縮。 研究 long2short:哪些中間步驟必須保留,哪些只是冗餘自檢。
- 代碼任務中的驗證器分層。 比較自然語言 critic、單元測試、fuzzing、靜態分析和執行反饋對候選程序選擇的貢獻。
- 開放任務的過程可信度。 對無法自動判分的科研問答或文獻綜述任務,設計人類可審計的 evidence trail,而不是隻讓模型自評。
- 搜索空間設計。 對同一任務比較 token-level sampling、step-level search、tool-level planning 和 proof-level search,分析哪種粒度最省預算。
總結
Reasoning Models 的主線可以概括為:先讓模型寫出中間過程,再讓模型生成多條路徑,然後訓練或調用驗證器選擇路徑,最後把推理變成可分配預算、可搜索、可強化學習優化的系統。精讀這條路線時,要避免被“會思考”的表述帶偏。真正值得記錄的是:推理軌跡如何產生,驗證信號來自哪裡,額外計算是否可控,評測是否可復現,失敗能否定位到具體步驟。
如果你要從今天開始讀,建議按五篇打底:CoT、Self-Consistency、Let's Verify Step by Step、Tree of Thoughts、DeepSeek-R1。再用 s1 和 Qwen3 觀察 2025 年開源推理模型如何把 thinking budget 變成可實驗變量。這樣讀完後,你不會只會複述“模型會深度思考”,而能提出一個可檢驗的問題:在什麼任務、什麼預算、什麼驗證信號下,推理真的變可靠了?
參考資料
檢索日期:2026-08-06。
- Jason Wei et al. “Chain-of-Thought Prompting Elicits Reasoning in Large Language Models.” arXiv, 2022; NeurIPS 2022. https://arxiv.org/abs/2201.11903
- Xuezhi Wang et al. “Self-Consistency Improves Chain of Thought Reasoning in Language Models.” arXiv, 2022; ICLR 2023. https://arxiv.org/abs/2203.11171
- Denny Zhou et al. “Least-to-Most Prompting Enables Complex Reasoning in Large Language Models.” arXiv, 2022; ICLR 2023. https://arxiv.org/abs/2205.10625
- Karl Cobbe et al. “Training Verifiers to Solve Math Word Problems.” arXiv, 2021. https://arxiv.org/abs/2110.14168
- Dan Hendrycks et al. “Measuring Mathematical Problem Solving With the MATH Dataset.” arXiv, 2021; NeurIPS 2021. https://arxiv.org/abs/2103.03874
- Hunter Lightman et al. “Let's Verify Step by Step.” arXiv, 2023. https://arxiv.org/abs/2305.20050
- Shunyu Yao et al. “Tree of Thoughts: Deliberate Problem Solving with Large Language Models.” arXiv, 2023; NeurIPS 2023. https://arxiv.org/abs/2305.10601
- Princeton NLP. “tree-of-thought-llm” official repository. https://github.com/princeton-nlp/tree-of-thought-llm
- Shunyu Yao et al. “ReAct: Synergizing Reasoning and Acting in Language Models.” arXiv, 2022; ICLR 2023. https://arxiv.org/abs/2210.03629
- David Rein et al. “GPQA: A Graduate-Level Google-Proof Q&A Benchmark.” arXiv, 2023. https://arxiv.org/abs/2311.12022
- OpenAI. “Learning to reason with LLMs.” Official report, 2024. https://openai.com/index/learning-to-reason-with-llms/
- Bradley Brown et al. “Large Language Monkeys: Scaling Inference Compute with Repeated Sampling.” arXiv, 2024, revised 2024. https://arxiv.org/abs/2407.21787
- Scaling Intelligence. “large_language_monkeys” official repository. https://github.com/ScalingIntelligence/large_language_monkeys
- Chujie Zheng et al. “ProcessBench: Identifying Process Errors in Mathematical Reasoning.” arXiv, 2024, revised 2025; ACL 2025. https://arxiv.org/abs/2412.06559
- DeepSeek-AI et al. “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.” arXiv, 2025, revised 2026; Nature 2025 version linked on arXiv. https://arxiv.org/abs/2501.12948
- Kimi Team et al. “Kimi k1.5: Scaling Reinforcement Learning with LLMs.” arXiv, 2025. https://arxiv.org/abs/2501.12599
- Niklas Muennighoff et al. “s1: Simple test-time scaling.” arXiv, 2025. https://arxiv.org/abs/2501.19393
- SimpleScaling. “s1” official repository. https://github.com/simplescaling/s1
- Zhong-Zhi Li et al. “From System 1 to System 2: A Survey of Reasoning Large Language Models.” arXiv, 2025, revised 2025. https://arxiv.org/abs/2502.17419
- An Yang et al. “Qwen3 Technical Report.” arXiv, 2025. https://arxiv.org/abs/2505.09388