日期:2026-08-05
適合讀者:已經瞭解 Transformer、向量檢索和基礎 RAG 工程流程,想把檢索增強從“應用技巧”讀成“學習範式”的研究生、科研新人和工程背景讀者。
摘要
Retrieval-Augmented Learning 不是簡單地“給 LLM 接一個向量庫”。從 REALM、RAG、RETRO、Atlas 到 Self-RAG、Adaptive-RAG、GraphRAG、Agentic RAG 和 Memory-Augmented Generation,這條路線的核心問題一直在變化:知識應該存進參數,還是存進外部記憶;檢索應該發生在預訓練、微調還是推理時;模型應該被動接收 top-k 文檔,還是主動判斷何時檢索、如何改寫查詢、如何維護長期記憶。本文給出一條論文精讀路線,把經典 RAG 與 2025-2026 年的多輪、跨語言、文本表格、多模態、安全和 agentic memory 研究串起來,並給出可復現的小實驗設計。
目錄
- 為什麼這個主題重要
- 核心閱讀方法:把 RAG 拆成學習系統
- 代表論文路線圖
- 關鍵論文精讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
很多讀者第一次接觸 RAG,是從“embedding + vector database + top-k chunks + prompt”開始的。這個工程模板有用,但它會遮住更根本的研究問題:LLM 的知識並不只有參數記憶一種形態。外部文檔、向量索引、知識圖譜、對話歷史、用戶偏好、實驗日誌和工具調用軌跡,都可以成為模型推理時可訪問的非參數記憶。
2025-2026 年的論文已經不再滿足於“RAG 比閉卷模型少幻覺”。研究問題變得更細:長上下文模型出現後,RAG 是否仍有必要;多輪問題不自包含時如何檢索;跨語言、文本表格和多模態文檔中錯誤來自檢索、推理還是生成;agentic RAG 多次檢索、寫入記憶和調用工具後,錯誤會不會沿循環放大。讀這個方向,要把 RAG 從“應用組件”讀成“學習系統”:何時查、查什麼、如何融合、如何更新、如何驗證。
核心閱讀方法:把 RAG 拆成學習系統
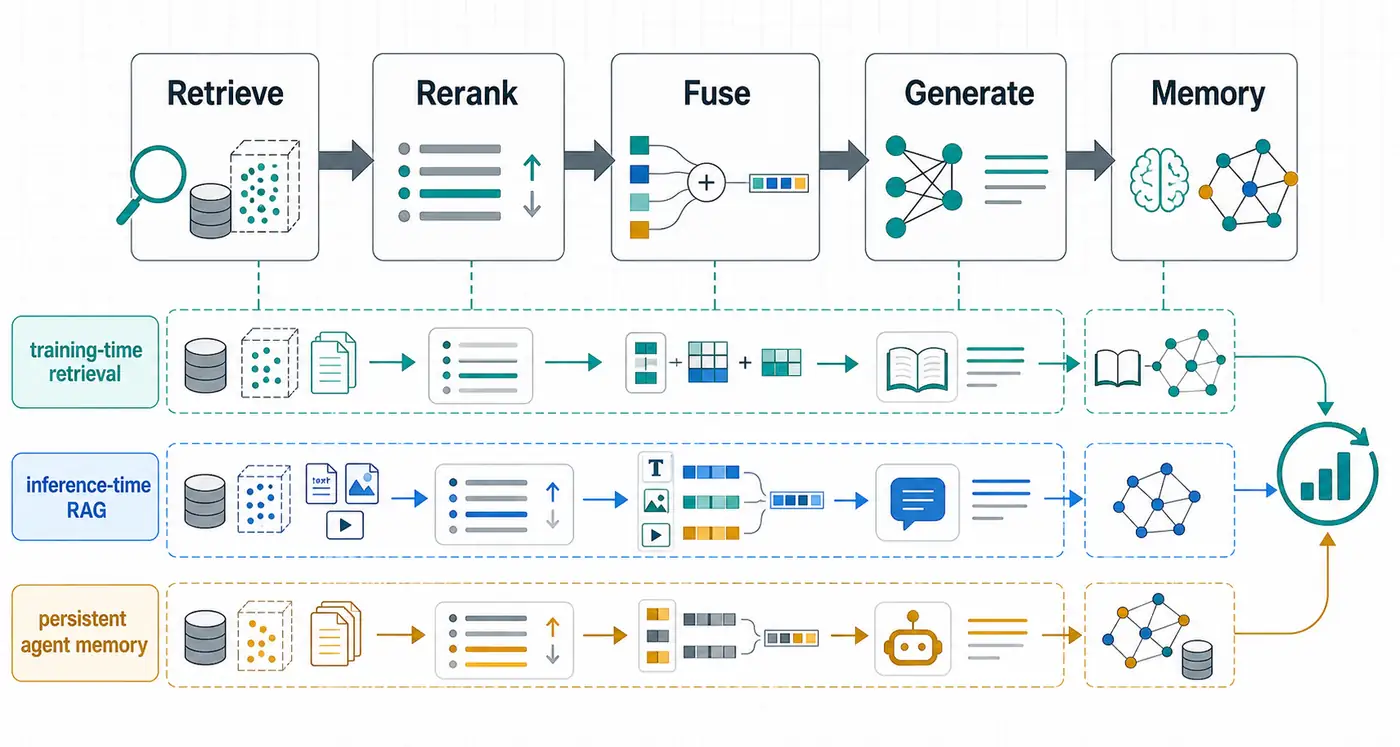
精讀這一方向,可以按五個問題做筆記。
檢索發生在什麼時候。 REALM 把檢索放進預訓練;RAG 在生成任務中結合 parametric memory 與 dense index;RETRO 在自迴歸語言建模中用大規模 token 數據庫;Atlas 研究 few-shot 知識密集任務中的可更新索引。到 Self-RAG、Adaptive-RAG 和 Agentic RAG,檢索變成推理控制問題。
外部記憶是什麼。 早期工作多用 Wikipedia 或網頁文本;後續系統納入表格、圖像、版面、多輪對話、圖結構和長期用戶記憶。筆記中要記錄 corpus snapshot、chunk 粒度、embedding 模型、索引更新方式和 provenance。
檢索結果如何進入模型。 直接拼接 top-k passage、reranker、Fusion-in-Decoder、cross-attention、graph context、memory hierarchy 都是不同假設。這個差異通常比“用了哪個向量庫”更重要。
評測是否能定位失敗來源。 RAG 錯誤可能來自檢索不到、排序錯、上下文太長、生成誤讀、judge 偏置或數據汙染。MIRAGE、MTRAG、XRAG、T^2-RAGBench 和 LaRA 的共同價值,是讓失敗更可歸因。
記憶是否有生命週期。 Memory-augmented models 不只是舊聊天記錄向量化。MemGPT 和 MemOS 把記憶管理提升為系統問題,因此要關注寫入、遺忘、衝突解決、訪問控制和可追蹤性。
代表論文路線圖
| 階段 | 代表工作 | 精讀抓手 |
|---|---|---|
| 檢索增強預訓練 | REALM, RAG | retriever 是否被訓練,非參數記憶如何進目標函數 |
| 大規模顯式記憶 | RETRO | 數據庫規模、chunked cross-attention、參數與外部數據的關係 |
| 少樣本知識密集學習 | Atlas | 索引是否可更新,收益來自模型、檢索器還是知識覆蓋 |
| 自適應 RAG | Self-RAG, CRAG, Adaptive-RAG | 何時檢索、如何判定證據質量、如何糾錯 |
| 結構化和多模態 RAG | GRAG, T^2-RAGBench, ACL 2026 survey | 圖、表格、版面和多模態對象如何融合 |
| RAG vs long context | LaRA | 什麼時候全文上下文更好,什麼時候檢索更好 |
| agentic memory | Generative Agents, MemGPT, MemOS, Agentic RAG SoK | 寫入、檢索、反思、規劃和工具調用閉環 |
關鍵論文精讀
REALM 與 RAG。 REALM 的關鍵是讓檢索器在預訓練階段獲得學習信號,用 masked language modeling 驅動 latent knowledge retriever。RAG 則把預訓練 seq2seq 模型和 Wikipedia dense vector index 結合,提出 sequence-level 和 token-level formulation。讀這兩篇,要寫清楚 retriever、latent documents、generator 和 provenance 的關係。
RETRO 與 Atlas。 RETRO 在自迴歸語言建模中使用 2 trillion token retrieval database,通過 frozen BERT retriever、encoder 和 chunked cross-attention 將近鄰文本用於預測。Atlas 研究 retrieval-augmented model 在少樣本知識密集任務中的表現。讀這兩篇,要區分“架構級 retrieval”和“推理時 prompt RAG”。
Self-RAG / CRAG / Adaptive-RAG。 Self-RAG 通過 reflection tokens 學習何時檢索和評價證據;CRAG 增加 retrieval evaluator,在檢索質量不足時觸發補救;Adaptive-RAG 用問題複雜度選擇 no-retrieval、single-step 或 iterative retrieval。共同結論是:檢索不是越多越好。
2025-2026 benchmarks。 MTRAG 指向多輪對話中的非自包含問題;MIRAGE 分解檢索與生成組件;XRAG 檢查跨語言回答語言和推理;T^2-RAGBench 關注文本表格和數值推理;LaRA 比較 long-context LLM 與 RAG。這些 benchmark 適合訓練錯誤歸因能力。
Memory-Augmented Models。 Generative Agents 展示 memory stream、reflection 和 planning;MemGPT 將上下文管理類比為操作系統虛擬內存;MemOS 把 memory 提升為一等資源。這裡的問題不再只是“檢索到什麼”,而是“系統應該記住什麼、何時忘記、誰能讀取、如何追責”。
方法與實驗對比表
| 方法類型 | 優勢 | 風險 | 小實驗 |
|---|---|---|---|
| 固定 top-k RAG | 簡單、可控 | 噪聲汙染生成 | 改 k、chunk、reranker,記錄 recall 與 faithfulness |
| Fusion / cross-attention | 細粒度融合證據 | 成本高,依賴實現 | 比較 prompt 拼接與融合式 reader |
| 自適應 RAG | 支持複雜問題路由 | 控制器可能誤判 | 構造 simple / multi-hop / unanswerable 問題 |
| Graph / multimodal RAG | 適合結構關係和版面 | 數據構建重 | 用引用圖或財報表格做 hybrid retrieval |
| Memory-augmented agents | 支持長期交互 | 記憶汙染和隱私風險 | 設計多輪對話,測試寫入、召回、衝突和遺忘 |
復現建議
不建議一開始復現完整 RETRO 或大規模 Atlas。更好的訓練路徑是做一個小而可診斷的 RAG lab。
- 固定語料庫:選擇 200-1000 篇論文摘要、課程講義或公開文檔,記錄版本、清洗腳本和 chunk 策略。
- 建立三層指標:retrieval 層看 recall@k、MRR;context 層看有效證據和噪聲;generation 層看事實核查、引用準確性和不可回答識別。
- 做最小 ablation:比較 BM25、dense embedding、hybrid retrieval、reranker、query rewriting、answer citation,並給失敗案例歸因。
- 加入 memory 變量:把一次性 QA 改成多輪任務,比較窗口歷史、summary memory、vector recall memory 和顯式 profile memory。
- 控制長上下文基線:至少加入“直接放全文或長摘要”的基線,避免誇大檢索收益。
常見誤區
- 把 retrieval recall 當成最終答案質量。檢索命中只是必要條件,模型仍可能忽略或誤讀證據。
- 只調 embedding,不看 chunk。邊界、標題、表格轉寫、元數據過濾經常更關鍵。
- 沒有不可回答問題。缺少 unanswerable set 會鼓勵模型強答。
- 把 memory 寫入當作無害優化。長期記憶會引入隱私、汙染、衝突和陳舊問題。
- 用 LLM judge 直接替代證據核查。judge 可輔助篩選,但不能替代 retrieval log、原文證據和可復現實驗腳本。
適合研究生繼續做的選題
- RAG 與 long-context 路由器。 根據問題、文檔長度、檢索置信度和預算選擇全文、檢索或混合策略。
- 多輪 RAG 查詢改寫失敗診斷。 研究後續輪次如何繼承實體、約束和否定信息。
- 文本表格混合 RAG。 檢查系統是否找到正確表格區域,並能完成數值推理。
- 長期記憶衝突解決。 當新舊偏好衝突,系統如何更新、保留版本和解釋來源。
- RAG 安全與記憶汙染。 研究 poisoning、prompt injection 文檔、隱私洩露和訪問控制。
總結
Retrieval-Augmented Learning 的主線是:把知識從“只能靠參數記住”擴展為“可檢索、可更新、可治理、可驗證的外部記憶”。早期論文教我們如何把檢索接入預訓練和生成;最新論文把問題推向多輪、跨語言、多模態、結構化數據、agentic control 和長期記憶治理。讀這條路線,關鍵不是背系統名,而是畫出證據流:問題從哪裡來,知識從哪裡來,檢索如何選擇,證據如何融合,錯誤如何定位,記憶如何更新。
參考資料
檢索日期:2026-08-05。
- Kelvin Guu et al. “REALM: Retrieval-Augmented Language Model Pre-Training.” arXiv, 2020. https://arxiv.org/abs/2002.08909
- Patrick Lewis et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” NeurIPS 2020 / arXiv. https://arxiv.org/abs/2005.11401
- Sebastian Borgeaud et al. “Improving language models by retrieving from trillions of tokens.” arXiv, 2021, revised 2022. https://arxiv.org/abs/2112.04426
- Gautier Izacard et al. “Atlas: Few-shot Learning with Retrieval Augmented Language Models.” arXiv, 2022. https://arxiv.org/abs/2208.03299
- Joon Sung Park et al. “Generative Agents: Interactive Simulacra of Human Behavior.” arXiv, 2023. https://arxiv.org/abs/2304.03442
- Charles Packer et al. “MemGPT: Towards LLMs as Operating Systems.” arXiv, 2023, revised 2024. https://arxiv.org/abs/2310.08560
- Akari Asai et al. “Self-RAG: Learning to Retrieve, Generate, and Critique Through Self-Reflection.” ICLR 2024. https://mlanthology.org/iclr/2024/asai2024iclr-selfrag/
- Shi-Qi Yan et al. “Corrective Retrieval Augmented Generation.” arXiv, 2024, revised 2024. https://arxiv.org/abs/2401.15884
- Soyeong Jeong et al. “Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity.” NAACL 2024 / arXiv. https://arxiv.org/abs/2403.14403
- Yuntong Hu et al. “GRAG: Graph Retrieval-Augmented Generation.” arXiv, 2024, revised 2025. https://arxiv.org/abs/2405.16506
- Yannis Katsis et al. “MTRAG: A Multi-Turn Conversational Benchmark for Evaluating Retrieval-Augmented Generation Systems.” arXiv, 2025. https://arxiv.org/abs/2501.03468
- Kuan Li et al. “LaRA: Benchmarking Retrieval-Augmented Generation and Long-Context LLMs.” arXiv, 2025. https://arxiv.org/abs/2502.09977
- Chanhee Park et al. “MIRAGE: A Metric-Intensive Benchmark for Retrieval-Augmented Generation Evaluation.” NAACL Findings 2025 / arXiv. https://arxiv.org/abs/2504.17137
- Yaxiong Wu et al. “From Human Memory to AI Memory: A Survey on Memory Mechanisms in the Era of LLMs.” arXiv, 2025. https://arxiv.org/abs/2504.15965
- Wei Liu et al. “XRAG: Cross-lingual Retrieval-Augmented Generation.” arXiv, 2025. https://arxiv.org/abs/2505.10089
- Zhiyu Li et al. “MemOS: An Operating System for Memory-Augmented Generation (MAG) in Large Language Models.” arXiv, 2025. https://arxiv.org/abs/2505.22101
- Jan Strich et al. “T^2-RAGBench: Text-and-Table Benchmark for Evaluating Retrieval-Augmented Generation.” EACL 2026 / arXiv. https://arxiv.org/abs/2506.12071
- Saroj Mishra et al. “SoK: Agentic Retrieval-Augmented Generation (RAG): Taxonomy, Architectures, Evaluation, and Research Directions.” arXiv, 2026. https://arxiv.org/abs/2603.07379
- Sensen Gao et al. “Scaling Beyond Context: A Survey of Multimodal Retrieval-Augmented Generation for Document Understanding.” ACL 2026. https://aclanthology.org/2026.acl-long.204/
- Balamurugan Palanisamy et al. “Security and Privacy in Retrieval-Augmented Generation.” arXiv, 2026. https://arxiv.org/abs/2606.25533