日期:2026-08-04
適合讀者:已經瞭解 SFT、Transformer 和基礎強化學習概念,想系統讀懂 RLHF、DPO、GRPO 與偏好數據論文的研究生、科研新人和工程背景讀者。
摘要
RLHF / Preference Optimization 是現代 LLM 後訓練裡最容易被“公式名詞”淹沒的方向:PPO、reward model、DPO、KTO、ORPO、SimPO、GRPO、DAPO 看起來像一串算法清單,但真正要讀懂的是三件事:偏好信號如何被定義,優化目標如何把偏好轉成語言模型更新,評測如何證明模型真的更符合目標而不是更長、更討巧或更會迎合 judge。本文給出一條精讀路線:先讀經典 RLHF 管線,再讀 DPO 家族的離線偏好優化,再讀 GRPO / RLVR 推理訓練,最後用 RewardBench、AlpacaEval 和復現日誌去審視論文證據。
目錄
- 為什麼 RLHF / Preference Optimization 重要
- 核心閱讀方法:從數據、目標函數到評測閉環
- 代表論文路線圖
- 關鍵論文精讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
預訓練模型學到的是“下一個 token 的統計規律”,SFT 讓它更像一個能按指令回答問題的助手,但“什麼回答更好”往往不能只靠一個參考答案來定義。總結是否簡潔、拒答是否適度、數學推理是否可靠、代碼答案是否可執行、長回答是否只是囉嗦,這些都需要某種偏好信號。RLHF 的貢獻在於把人類比較、規則驗證或模型反饋轉成可優化目標,讓模型沿著“更被偏好”的方向更新。
但這個方向也有研究風險。第一,偏好不是客觀真理,數據來源、標註指南和人群差異會改變訓練目標。第二,reward model 可能被模型鑽空子,出現 reward hacking、verbosity bias、拒答過度或安全能力倒退。第三,DPO 等離線方法簡化了管線,卻把問題轉移到偏好對質量、參考模型、長度歸一化和超參數敏感性上。第四,DeepSeek-R1 之後,GRPO / RLVR 讓“可驗證獎勵 + 多樣本採樣 + 長推理”成為研究熱點,但很多復現失敗不是因為公式沒抄對,而是因為數據篩選、模板、採樣、長度懲罰、日誌監控和評測協議沒有對齊。
所以讀這個方向不能只背公式。你需要問:偏好來自誰,獎勵在優化什麼,方法省掉了什麼組件,省掉組件後引入了什麼偏差,論文證據能否排除“模型變長”“benchmark 洩漏”“judge 偏置”“base model 本來就會”的解釋。
核心閱讀方法
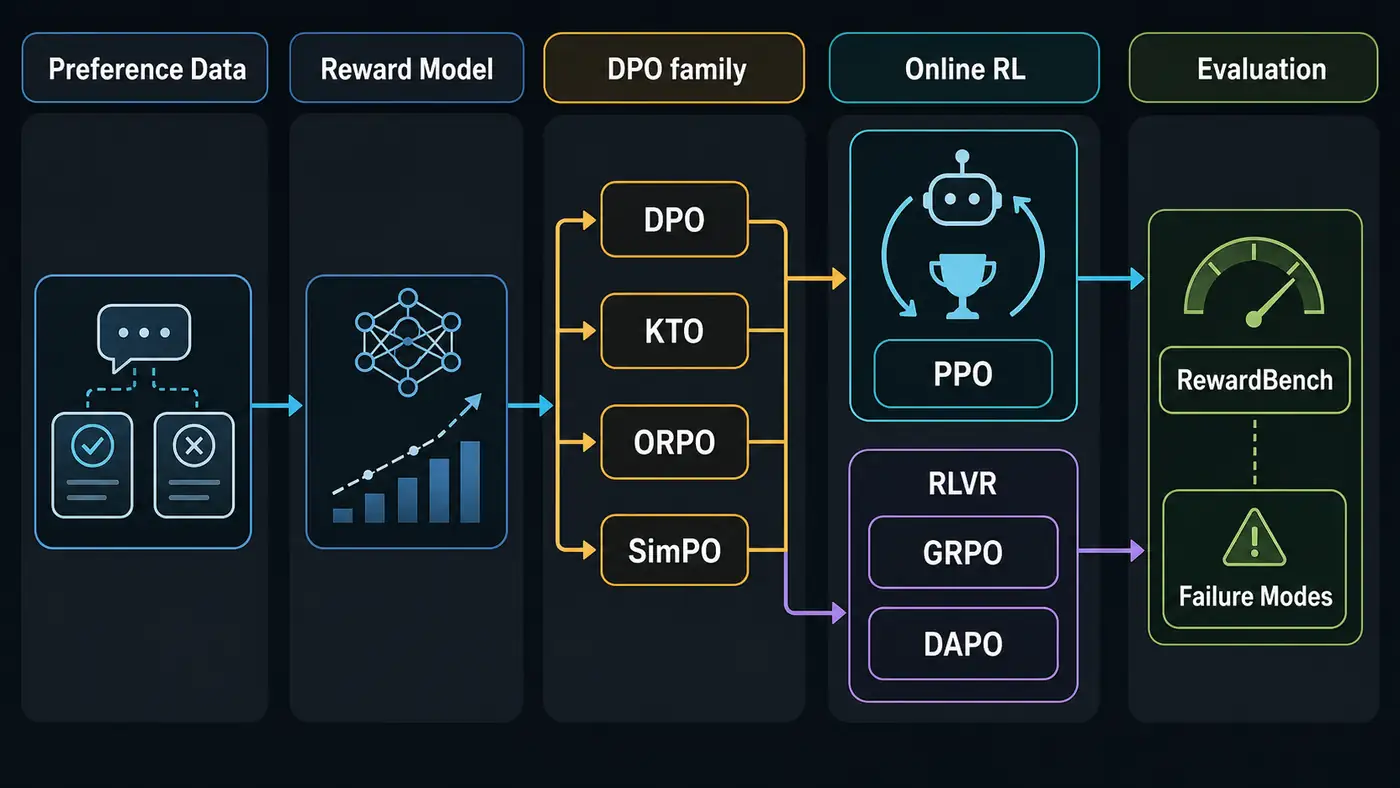
讀 RLHF / Preference Optimization 論文,可以按四層拆解。
第一層是數據。看清楚樣本單元到底是什麼:一個 prompt 配兩個回答,還是一個 prompt 配多個候選;反饋是人類偏好、AI 反饋、規則驗證、單條 thumbs-up/down,還是 reward model 打分;chosen 是否真的高質量,rejected 是否只是弱模型輸出;訓練集和評測集是否共享 prompt 模板、數據源或生成模型。
第二層是目標函數。PPO 類方法顯式訓練 policy 去最大化 reward,同時用 KL 約束不讓模型偏離參考策略;DPO 把 reward model 的最優策略關係重寫成分類損失;KTO 用二元 desirable / undesirable 信號;ORPO 和 SimPO 試圖減少 reference model 或階段數量;GRPO 用同一 prompt 的一組採樣結果做相對優勢估計,減少 critic / value model 的成本。讀公式時不要停在“有沒有 RL”,而要寫出每個 loss 鼓勵什麼、懲罰什麼、默認長度如何處理、參考模型是否參與、是否需要在線採樣。
第三層是訓練系統。RLHF 和 RLVR 很多結論依賴工程細節:rollout 速度、vLLM / SGLang 生成後端、ZeRO/FSDP、reference model 放置、KL 計算、reward server、斷點續訓、seed、採樣溫度、每個 prompt 採樣數、max tokens、是否過濾全對或全錯樣本。論文如果只寫“we use GRPO”,復現價值是不夠的。
第四層是評測。偏好優化論文常用 MT-Bench、AlpacaEval、Arena-Hard、RewardBench、MATH、AIME、HumanEval、IFEval 或安全評測。你要分清:這是評估 policy,還是評估 reward model;是 automatic judge,還是人類偏好;有沒有長度控制;有沒有多次採樣平均;有沒有報告方差;有沒有把失敗樣例公開。
代表論文路線圖
1. 經典 RLHF 管線
從 Ziegler 等人的 human preferences 語言模型微調,到 OpenAI 的 summarization from human feedback,再到 InstructGPT,主線是“收集比較數據 -> 訓練 reward model -> 用 PPO 優化 policy -> 加 KL 控制漂移”。這組論文的閱讀重點不是今天是否還用完全相同的 pipeline,而是理解 reward model 為什麼必要、PPO 為什麼複雜、KL 為什麼成為後訓練裡的基礎約束。
2. DPO 與離線偏好優化
DPO 的關鍵貢獻是把 RLHF 目標改寫成不顯式訓練 reward model、不在線 rollout 的監督式 pairwise loss。後續 KTO、ORPO、SimPO、f-DPO、RSO 等方法從反饋形式、reference model、divergence、長度歸一化和採樣來源上繼續改造。讀這一支時要追問:方法變簡單以後,是否犧牲了探索能力?是否更依賴偏好數據質量?是否會把 chosen 變得更短、更長或更模式化?
3. GRPO / RLVR 與推理模型
DeepSeekMath 提出 GRPO,DeepSeek-R1 把“可驗證任務上的強化學習”推到研究中心。這裡的偏好不一定來自人類比較,而可能來自數學、代碼、格式或單元測試這類可驗證獎勵。DAPO、Dr. GRPO 和異步 RL 系統進一步指出:長推理訓練的關鍵不只是 reward,而是採樣組的方差、長度偏差、過長懲罰、動態採樣和系統吞吐。
4. Reward model 與評測
RewardBench 與 RewardBench 2 說明,評估 reward model 本身已經是一個獨立問題。一個 reward model 在 pairwise benchmark 上高分,不必然意味著它能穩定改進 policy;一個 policy 在 AlpacaEval 上贏,也不必然表示推理能力或安全性提高。讀評測論文時要把“評價器的偏好”作為研究對象,而不是當成客觀裁判。
關鍵論文精讀
Learning to summarize from human feedback / InstructGPT
這兩篇適合放在第一週讀。閱讀時畫出三階段流程:SFT 初始化、reward model 學比較、PPO 優化 policy。重點看偏好數據如何採集、標註者一致性如何控制、KL penalty 如何防止模型偏離,以及為什麼人工偏好能擊敗 ROUGE 之類的自動指標。復現訓練不必一開始跑大模型,可以用開源 summarization 數據、一個小 reward model 和 TRL 的 PPOTrainer 做最小閉環。
DPO
DPO 要精讀公式推導。你需要自己從 KL-regularized RLHF objective 推到 reward-policy 關係,再推到 Bradley-Terry preference loss。讀完後寫一頁“DPO 省掉了什麼”:省掉 reward model 顯式訓練,省掉在線採樣,省掉 PPO 的 critic,但保留 reference policy 和偏好對。實驗部分重點看 DPO 與 PPO、SFT、rejection sampling 的比較是否控制了模型初始化、數據和評測協議。
KTO / ORPO / SimPO
這三篇適合並排讀。KTO 問的是“如果沒有成對偏好,只有 desirable / undesirable 能不能訓”;ORPO 試圖把 SFT 和偏好懲罰合成一個階段;SimPO 用平均 log probability 作為隱式 reward,並移除 reference model。它們的共同訓練點是:不要只看論文聲稱“更簡單”,而要拆每個簡化背後的假設。比如 reference-free 是否真的省內存,是否更難控制漂移;binary feedback 是否更便宜,是否也更含混;單階段訓練是否容易把 instruction learning 和 preference learning 混在一起。
DeepSeekMath / DeepSeek-R1 / DAPO / Dr. GRPO
這一組論文是 2025 之後讀 RLHF 必須補的新分支。DeepSeekMath 裡 GRPO 的動機是減少 PPO 中 value model 的成本,用同一 prompt 下多個輸出的 reward 均值和標準差估計 advantage。DeepSeek-R1 讓研究者看到 rule-based reward 可以在數學、代碼等可驗證任務中驅動長推理模式。DAPO 的價值在於公開了更完整的訓練 recipe:動態採樣、clip 調整、token-level loss、過長懲罰。Dr. GRPO 則提醒大家,GRPO 的標準化和長度處理可能引入優化偏差,所謂“思考變長”不一定等於“推理機制變強”。
RewardBench / RewardBench 2
這兩篇用來訓練你的評測敏感度。Reward model 既可以用於 RLHF 訓練,也可以用於 best-of-N 或 reranking;但 reward model benchmark 與 downstream policy 改進之間不是自動等價。RewardBench 2 明確把多技能 reward model 評測做得更難,並報告與下游推理擴展和 PPO 等訓練用途的相關性。讀這類論文時,最好把 benchmark item 分成 instruction following、reasoning、safety、style、拒答、細微差別等桶,再看模型在哪些桶上掉分。
方法與實驗對比表
| 方法 | 主要信號 | 是否顯式 reward model | 是否在線採樣 | 讀論文時最該檢查 |
|---|---|---|---|---|
| PPO-RLHF | human preference -> RM score | 是 | 是 | KL、critic、reward overoptimization、rollout 日誌 |
| DPO | chosen/rejected pair | 否 | 否 | reference model、beta、pair 質量、長度偏差 |
| KTO | desirable / undesirable binary feedback | 否 | 否 | 二元標籤來源、正負樣本比例、任務適配性 |
| ORPO | SFT 數據 + preference pair | 否 | 否 | 單階段訓練是否混淆 SFT 與對齊收益 |
| SimPO | pairwise preference + average log probability | 否 | 否 | reference-free 漂移、beta/gamma、回答長度 |
| GRPO | 同 prompt 多采樣 reward | 可選 | 是 | group size、reward 方差、零方差樣本、長度處理 |
| DAPO | RLVR reward + 動態採樣 | 可選 | 是 | 數據篩選、動態採樣規則、過長懲罰、復現腳本 |
復現建議
不要從完整 RLHF 大系統開始。建議做三層復現。
第一層:DPO 最小復現。選一個 1B-3B instruction model,使用 HH-RLHF 或 UltraFeedback 的小子集,固定 prompt template,用 TRL DPOTrainer 訓練一輪。記錄 train loss、chosen/rejected reward margin、response length、MT-Bench 或 AlpacaEval 子集結果。目標不是刷榜,而是觀察 beta 和 learning rate 如何影響輸出長度與拒答風格。
第二層:reward model 復現。訓練一個 pairwise reward model,然後在 RewardBench 或自建小集合上測 accuracy。再用它做 best-of-N,觀察 reward 分數提高是否真的改善人工檢查質量。這裡最容易發現 reward hacking:模型可能變長、變模板化、過度安全或迎合 judge。
第三層:RLVR / GRPO 玩具復現。選 GSM8K、MATH 子集或可單元測試的代碼任務,用規則 verifier 給 reward,設置每個 prompt 多采樣,跑 GRPO 或 RLOO。必須保存每步 group reward、answer length、pass rate、全對/全錯樣本比例、KL、entropy、截斷率。沒有這些日誌,就無法判斷訓練是在學習推理,還是隻是在改變採樣長度。
復現報告至少寫五個字段:數據版本、模型 checkpoint、訓練命令、關鍵超參數、失敗樣例。偏好優化實驗對 seed、模板和生成參數很敏感,單次結果不能當結論。
常見誤區
誤區一:DPO 比 PPO “一定更好”。 DPO 更簡單、更穩定,但它主要是離線偏好優化。需要探索新行為、依賴環境反饋或可驗證獎勵時,在線 RL 仍然有價值。
誤區二:reward model 分數越高,policy 越好。 reward model 會有盲區。RewardBench 2 這類工作的重要提醒是:reward model evaluation 和 downstream training performance 要分開驗證。
誤區三:長 CoT 就是推理能力湧現。 GRPO / RLVR 訓練中,長度增長可能來自任務需要,也可能來自 loss、標準化、截斷和過長懲罰設計。必須同時報告準確率、token 數、截斷率和錯誤樣例。
誤區四:偏好數據只看規模。 DPO 數據研究已經反覆指出,chosen 質量、pair 對比度、on-policy 程度和標註一致性都可能比單純樣本數更關鍵。
誤區五:自動評測可以替代人工閱讀。 AlpacaEval、Arena-Hard、LLM-as-judge 很有用,但在 preference optimization 論文裡,它們本身就是可能被優化的對象。高分樣例要人工抽查。
適合研究生繼續做的選題
- 偏好對質量診斷:設計指標預測哪些 DPO 樣本會帶來有效更新,比較 chosen 質量、rejected 難度、語義距離和長度差。
- reference-free 方法的漂移分析:對 SimPO / ORPO 類方法做多任務評測,檢查安全、事實性、推理和回答長度的共同變化。
- GRPO 長度偏差復現實驗:在數學小模型上系統改變 group size、max tokens、過長懲罰和標準化方式,驗證長度增長與準確率的關係。
- reward model 與 downstream policy 相關性:訓練多個 reward model,在 RewardBench、best-of-N、PPO 或 DPO 後 policy 表現之間做相關性分析。
- 偏好優化失敗樣例庫:收集過度拒答、迎合 judge、長而錯、格式正確但語義錯、代碼測試過擬合等樣例,形成可複用 evaluation card。
總結
RLHF / Preference Optimization 的閱讀順序應該從“人類偏好如何進入訓練”開始,而不是從算法名字開始。經典 RLHF 教你 reward model、PPO 和 KL 的基本閉環;DPO 家族教你如何把偏好優化變成更輕量的監督損失;GRPO / RLVR 教你可驗證獎勵如何推動推理訓練;RewardBench 和復現論文提醒你,優化目標和評測目標之間永遠可能存在裂縫。真正的科研訓練不是記住 DPO、KTO、ORPO、SimPO、GRPO 的公式差異,而是能拿一篇新論文問出四個問題:數據可信嗎,loss 在鼓勵什麼,系統細節是否足夠復現,評測是否排除了更簡單的解釋。
參考資料
檢索日期:2026-08-04。
- Schulman et al., “Proximal Policy Optimization Algorithms,” arXiv, 2017. https://arxiv.org/abs/1707.06347
- OpenAI, “Learning to summarize with human feedback,” 2020. https://openai.com/index/learning-to-summarize-with-human-feedback/
- Stiennon et al., “Learning to summarize from human feedback,” arXiv, 2020. https://arxiv.org/abs/2009.01325
- OpenAI, “Aligning language models to follow instructions,” 2022. https://openai.com/index/instruction-following/
- Rafailov et al., “Direct Preference Optimization: Your Language Model is Secretly a Reward Model,” arXiv, submitted 2023, revised 2024. https://arxiv.org/abs/2305.18290
- Ethayarajh et al., “Model Alignment as Prospect Theoretic Optimization,” ICML / PMLR, 2024. https://proceedings.mlr.press/v235/ethayarajh24a.html
- Hong, Lee and Thorne, “ORPO: Monolithic Preference Optimization without Reference Model,” arXiv, 2024. https://arxiv.org/abs/2403.07691
- Meng, Xia and Chen, “SimPO: Simple Preference Optimization with a Reference-Free Reward,” NeurIPS 2024. https://papers.neurips.cc/paper_files/paper/2024/hash/e099c1c9699814af0be873a175361713-Abstract-Conference.html
- Shao et al., “DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models,” arXiv, 2024. https://arxiv.org/abs/2402.03300
- DeepSeek-AI et al., “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning,” arXiv / Nature, submitted 2025, revised 2026. https://arxiv.org/abs/2501.12948
- Yu et al., “DAPO: An Open-Source LLM Reinforcement Learning System at Scale,” arXiv, 2025. https://arxiv.org/abs/2503.14476
- DAPO project page, ByteDance Seed / Tsinghua AIR / HKU / SIA-Lab. https://dapo-sia.github.io/
- Liu et al., “Understanding R1-Zero-Like Training: A Critical Perspective,” arXiv, 2025. https://arxiv.org/abs/2503.20783
- Malik et al., “RewardBench 2: Advancing Reward Model Evaluation,” arXiv / ICLR 2026. https://arxiv.org/abs/2506.01937
- Hugging Face TRL documentation, accessed 2026-08-04. https://huggingface.co/docs/trl/en/index
- OpenRLHF documentation, “RL Training Guide,” accessed 2026-08-04. https://openrlhf.readthedocs.io/en/latest/agent_training.html
- Anthropic HH-RLHF dataset, Hugging Face, accessed 2026-08-04. https://huggingface.co/datasets/Anthropic/hh-rlhf/tree/main
- OpenBMB UltraFeedback repository, accessed 2026-08-04. https://github.com/OpenBMB/UltraFeedback
- AllenAI RewardBench repository, accessed 2026-08-04. https://github.com/allenai/reward-bench
- Tatsu Lab AlpacaEval repository, accessed 2026-08-04. https://github.com/tatsu-lab/alpaca_eval