日期:2026-08-03
適合讀者:研究生、準備做大模型後訓練方向的科研新人、有工程背景但想系統理解 SFT 與指令遵循的讀者
建議前置:理解語言模型預訓練、交叉熵損失、prompt、few-shot/zero-shot、Transformer 基本結構和常見 LLM benchmark
摘要
Instruction Tuning 最容易被一句話講錯:它不只是“拿問答數據再訓一下模型”,也不等於完整的 RLHF、DPO 或 GRPO。更準確地說,它是一類把預訓練語言模型從“預測下一個 token”拉向“理解自然語言任務描述並按要求輸出”的監督後訓練方法。早期 FLAN 和 T0 證明,多任務自然語言指令可以顯著提升 zero-shot 泛化;InstructGPT 把 SFT 放進“示範數據 + 偏好排序 + RLHF”的人類反饋流程;Self-Instruct 和 Flan Collection 推動了合成指令數據;LIMA 則提出“少量高質量對齊數據也可能足夠教會交互格式”的強假設。到了 2025-2026 年,Tulu 3、Qwen3、GRAPE、IFEval/IFBench/LexInstructEval 等工作把問題推進到開放配方、數據適配、可驗證約束和更嚴格評測。
這篇文章給出一條 Instruction Tuning 的論文精讀路線。讀者需要學會:先區分 SFT、instruction following、preference optimization 和 RLVR;再拆解數據來源、任務混合、訓練目標和評測證據;最後把一篇論文改造成自己可復現的小實驗。
目錄
- 為什麼 Instruction Tuning 值得精讀
- 核心閱讀方法:從“任務-數據-訓練-評測”四格表開始
- 代表論文路線圖
- 關鍵論文精讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
預訓練語言模型學到的是語言分佈和世界知識,但用戶給模型的輸入通常不是“請繼續這段網頁”,而是“請總結、改寫、翻譯、推理、寫代碼、按 JSON 輸出、不要超過 100 字”。Instruction Tuning 的科研價值就在這個錯位處:它研究如何用自然語言任務描述和目標輸出,讓模型在未見過的新任務上更像一個可交互系統。
對研究生來說,這個主題尤其適合作為後訓練入門,因為它連接了三個層次。第一,方法簡單:最基本版本就是在 instruction-output pairs 上做 teacher forcing,用交叉熵訓練。第二,變量複雜:同樣叫 SFT,數據可能來自人工標註、模板化 NLP 數據集、強模型蒸餾、自生成、用戶日誌或偏好篩選;模型可能是 encoder-decoder、decoder-only、dense、MoE、多模態;評測可能是 MMLU、BBH、MT-Bench、AlpacaEval、IFEval 或人工偏好。第三,容易產生可復現選題:你可以不訓練 70B 模型,也能研究數據質量、任務覆蓋、模板設計、約束遵循和失敗模式。
這條路線的核心判斷是:一篇 Instruction Tuning 論文到底在證明“模型學會任務”,還是隻學會“回答格式”?到底是數據量起作用,還是數據質量、任務多樣性、模型規模、teacher 模型、chat template、evaluation prompt 或 benchmark contamination 起作用?
核心閱讀方法:從四格表開始
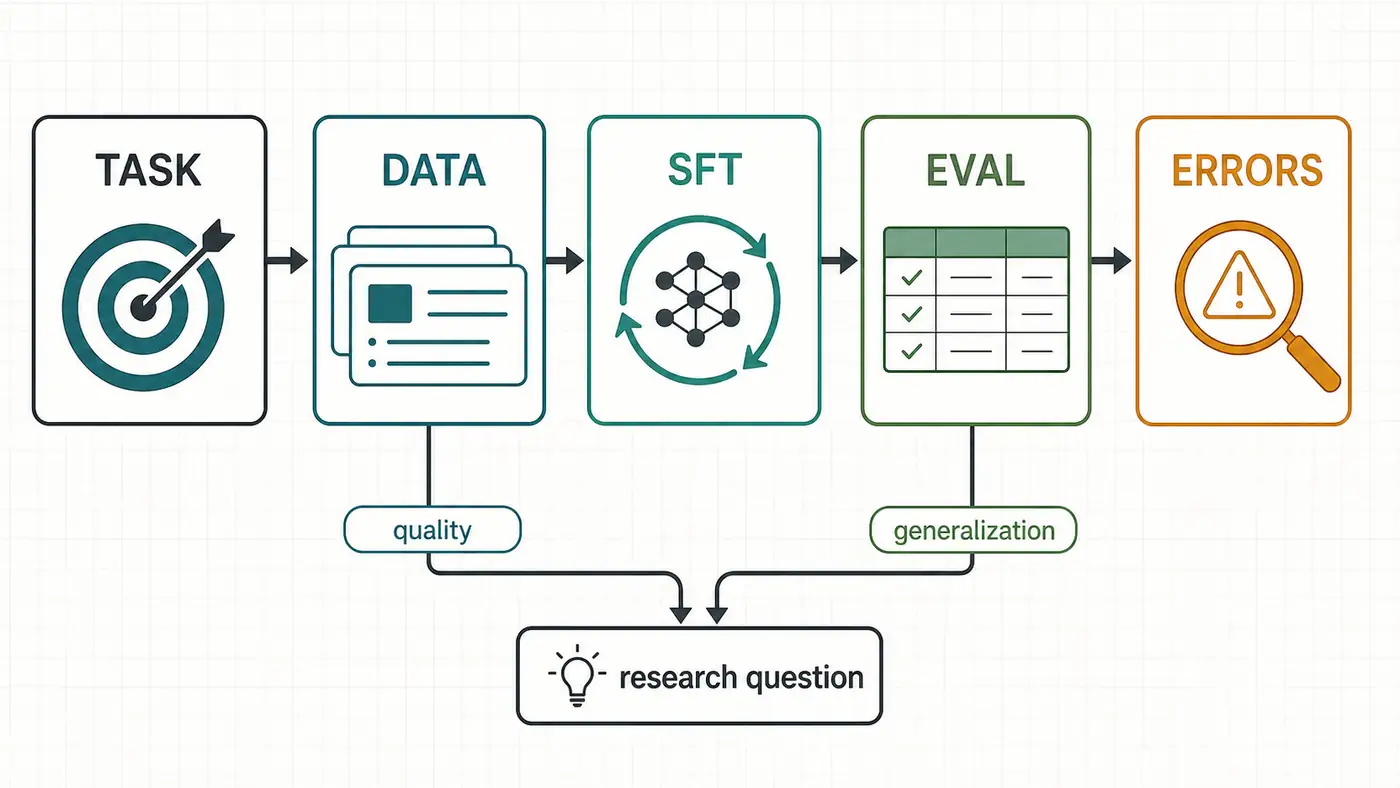
精讀這類論文時,先不要急著看排行榜。建議每篇論文先填一張四格表:
- Task:任務定義。 論文裡的 instruction 是傳統 NLP 任務模板、開放式用戶請求、多輪對話、格式約束、工具調用,還是領域任務?訓練任務和測試任務是否同分布?
- Data:數據來源。 數據是人工寫的、從公開數據集轉寫的、由強模型生成的、模型自舉生成的、由偏好數據篩出的,還是混合配方?是否報告去重、過濾、許可證、汙染檢查和版本?
- SFT:訓練目標。 是全參數微調、LoRA/QLoRA 等 PEFT,還是多階段後訓練中的第一步?loss 是否只算 assistant tokens?chat template、特殊 token、packing、學習率、batch size 是否可復現?
- Eval:證據強度。 評測是 held-out task、held-out instruction、held-out constraint,還是同源 benchmark?是程序驗證、人類評測、LLM-as-judge,還是傳統 accuracy?是否有 ablation、負結果和誤差分析?
填完四格表,再讀結果表。Instruction tuning 論文的表格常常把多種能力揉在一起:知識問答、數學、代碼、對話偏好、安全拒答、格式遵循、長上下文。你要把它們拆開看,因為一種數據混合可能提升指令格式,卻損害事實性;提升 reasoning benchmark,卻降低簡潔回答;提升英文開放問答,卻對中文、代碼或多輪約束沒有幫助。
代表論文路線圖
第一站:FLAN。
2021 年 Google 的 Finetuned Language Models Are Zero-Shot Learners 提出把多個 NLP 任務改寫成自然語言指令來微調語言模型。它的重點不是“FLAN 這個模型名”,而是“用自然語言任務描述進行跨任務泛化”的實驗範式:訓練任務、未見任務、指令模板、模型規模和 ablation。
第二站:T0 與 Super-NaturalInstructions。
T0 用大規模 multitask prompted training 研究 zero-shot task generalization;Super-NaturalInstructions 把問題擴展到 1600 多個 NLP 任務和專家寫的說明。讀這一支線要關注“task generalization”:測試集不是普通 held-out examples,而是未見任務、未見指令類型或未見任務族。
第三站:InstructGPT。
2022 年 OpenAI 的 InstructGPT 論文把 SFT 放在更完整的人類反饋管線中:先用標註員示範數據做監督微調,再收集模型輸出排序訓練 reward model,最後用 RLHF 優化。精讀時要明確:SFT 是基線和初始化,RLHF 是後續偏好優化,不要把整篇論文簡化成“instruction tuning 論文”。
第四站:Scaling Instruction-Finetuned Language Models 與 Flan Collection。
Flan-PaLM / Flan-T5 系列把問題轉向 scale:任務數量、模型規模、chain-of-thought 數據、prompting setup 與多 benchmark 表現如何共同作用。Flan Collection 的價值在於公開了任務、模板和方法,使後續研究能更系統地分析數據配方。
第五站:Self-Instruct。
Self-Instruct 的關鍵問題是:人工指令有限時,模型能否自舉生成 instruction、input、output,再過濾後用於微調?這條線開啟了“合成指令數據”的大規模使用,也留下了質量、偏差、模式坍縮和 teacher-student 分佈錯配等問題。
第六站:LIMA。
LIMA 用少量高質量樣本做 SFT,提出“大部分知識和能力來自預訓練,對齊階段主要教交互風格”的強假設。讀它時不要只記“1000 條數據”,而要看樣本篩選、基座模型、人工評測、比較對象和它無法覆蓋的安全、複雜推理與可驗證約束問題。
第七站:開放後訓練配方。
Tulu 3 把現代開放 post-training 展示成更完整的工程科研對象:提示與數據策劃、SFT、DPO、RLVR、評測與去汙染。Qwen3、Llama 3/4 等官方技術資料也說明,現代 instruct 模型通常不是單階段 SFT,而是多階段數據篩選、SFT、偏好優化、RL、長上下文和工具能力共同作用的結果。
第八站:2025-2026 的數據適配與可驗證指令遵循。
GRAPE 提醒我們,最強 teacher 的回答不一定最適合某個 target model;“fit” 可以用目標模型自身概率等信號度量。IFEval 用程序驗證格式約束,IFBench 進一步指出模型可能過擬合少數 constraint templates,AAAI-26 的 LexInstructEval 則把細粒度詞彙約束 formalize 成可檢查規則。這些工作把 instruction following 從“主觀好不好”推向“能否驗證、能否泛化”。
關鍵論文精讀
1. FLAN:讀跨任務泛化,而不是讀單點分數
FLAN 的核心設計是把許多任務 verbalize 成自然語言指令,然後評估未見任務上的 zero-shot 表現。精讀時建議畫三列:訓練任務類型、測試任務類型、指令模板。真正的問題是:模型提升來自“見過更多任務”,還是來自“見過自然語言任務說明”?論文中的 ablation 指出任務數量、模型規模和自然語言指令都很關鍵,這正是讀者應復現的小問題。
最小復現可以選 8-12 個公開分類/問答/摘要任務,把其中幾類作為 held-out task。訓練一個小型 T5 或小型 decoder-only 模型,比較三組:無指令模板、單一模板、多模板。你的目標不是復現原論文絕對分數,而是觀察“未見任務泛化”是否隨模板多樣性和任務數量改變。
2. T0 / Super-NaturalInstructions:讀 benchmark 構造
T0 和 Super-NaturalInstructions 的價值在於把 instruction following 從單一數據集擴展成任務集合。讀這類論文時,dataset section 比結果表更重要:任務如何分組?訓練/測試如何切分?什麼算 unseen task?一個任務的多個 prompt 是否會洩漏到測試?評價是 exact match、ROUGE、BLEU、F1 還是人工判斷?
如果你想做 follow-up,可以從“任務切分”入手。很多論文聲稱 zero-shot,但訓練集中可能存在語義相近任務;也可能只是換了 prompt 表述,而不是換了真實能力。一個可靠小選題是重新劃分任務族,例如把所有情感分類、事實問答、生成式改寫分開,觀察模型泛化到底跨過了哪條邊界。
3. InstructGPT:讀 SFT 在完整對齊鏈條裡的角色
InstructGPT 常被當作 RLHF 入門論文,但在 Instruction Tuning 路線裡,它的精讀重點是 SFT 如何成為偏好優化的起點。論文先收集 labeler-written demonstrations 做 supervised learning,再用模型輸出排序訓練 reward model,最後做 RLHF。這裡的科研問題是:SFT 已經讓模型學到什麼?RLHF 在哪些 prompt 分佈上繼續改善?公共 NLP benchmark 的 regression 如何處理?
復現時不要試圖完整複製 OpenAI 的私有數據和人類反饋流程。更合理的訓練是:用公開 instruction 數據做 SFT,然後用小規模偏好數據或規則驗證數據做 DPO/RLVR,對比 SFT-only 與 preference stage 的差異。報告必須分開:helpfulness、format following、truthfulness、toxicity 或 safety 不是同一個指標。
4. Self-Instruct:讀合成數據的過濾鏈
Self-Instruct 的方法很適合拆解:從少量 seed tasks 開始,生成新 instruction,判斷任務類型,生成實例,再過濾相似、無效或低質量樣本,最後訓練模型。精讀時要盯住兩個環節:生成是否增加了真實任務多樣性,過濾是否足夠強。
研究生可以做一個小復現實驗:讓一個開源 instruct 模型為特定領域生成 2k-5k 條 instruction-output pairs,分別訓練未過濾、去重過濾、規則過濾、人工抽樣過濾四個版本。評測時使用 held-out human-written prompts 和 IFEval 風格約束,觀察模型是更會“回答”,還是隻是更會模仿 teacher 的語氣。
5. LIMA:讀“質量大於數量”的邊界
LIMA 的影響力來自一個反常識問題:如果預訓練模型已經足夠強,少量高質量對齊樣本是否足以教會它交互方式?這篇論文適合訓練你區分“能力學習”和“行為格式選擇”。如果模型本來就知道知識,SFT 可能只是在提示它用 assistant-like 形式輸出;但如果任務需要新領域知識、嚴格可驗證約束、可靠拒答或複雜多步推理,少量樣本是否仍夠用,就需要新證據。
讀 LIMA 時要避免兩個極端:既不要把它理解成“數據越少越好”,也不要因為它樣本少就否定大規模指令數據。更好的問題是:什麼類型的數據必須高質量少量?什麼能力需要覆蓋大量長尾任務?什麼能力不能靠 SFT 單獨解決?
6. Tulu 3 / Qwen3:讀現代開放配方
Tulu 3 的官方資料強調開放數據、代碼、訓練配方和評測,是研究後訓練的好樣本。它把 post-training 拆成提示策劃與合成、SFT、偏好數據與 DPO、RLVR 等階段。Qwen3 官方倉庫則顯示 2025 年 Qwen3-2507 的 Instruct/Thinking 變體繼續強化 instruction following、reasoning、tool usage、alignment 和長上下文,並提供 SFT/DPO/GRPO 等訓練入口說明。
這類資料要作為“技術報告”讀,而不是當成普通論文讀。你要查模型卡、訓練數據透明度、許可證、代碼是否可跑、benchmark 是否可復現、是否有 contamination 說明。若官方只給總結而沒有數據細節,文章裡要標註“待人工核驗”,不能把發佈文案寫成實驗結論。
7. IFEval / IFBench / LexInstructEval:讀可驗證約束
傳統 instruction following 評測常依賴人類偏好或 LLM-as-judge,成本高且可能有偏。IFEval 把問題縮窄到可程序驗證的約束,例如長度、關鍵詞、格式、大小寫等;IFBench 進一步指出,模型可能過擬合 IFEval 的固定 constraint templates,而不能泛化到新約束;LexInstructEval 用規則語法構造更細粒度的詞彙指令評測。
這條線特別適合作為復現訓練:你可以自己定義 20 箇中文可驗證約束,例如“恰好三段”“不得使用某詞”“每條以動詞開頭”“輸出合法 JSON 且字段順序固定”。然後評估若干開源模型的 strict/loose accuracy,並分析失敗類型。這比用一個大模型打分更可控。
方法與實驗對比表
| 論文/資料 | 重點讀什麼 | 數據形態 | 訓練/評測焦點 | 最小復現 |
|---|---|---|---|---|
| FLAN | 多任務自然語言指令能否提升 zero-shot | 傳統 NLP 任務模板 | held-out task generalization | 多任務小模型 + 模板 ablation |
| T0 | 大規模 prompted multitask training | PromptSource/多任務 prompt | 未見任務泛化 | 按任務族重切分測試 |
| Super-NaturalInstructions | instruction benchmark 構造 | 1600+ NLP 任務說明 | task type coverage | 抽樣任務重做 train/test split |
| InstructGPT | SFT 與 RLHF 的分工 | 示範 + 偏好排序 | helpfulness/truthfulness/safety | SFT-only vs DPO/RLVR 小實驗 |
| Self-Instruct | 合成指令數據自舉 | seed task + model-generated data | 過濾與多樣性 | 過濾策略 ablation |
| LIMA | 少量高質量樣本的邊界 | curated prompt-response | alignment style vs capability | 1k/5k/20k 高質量數據對比 |
| Tulu 3 | 開放後訓練配方 | 混合公開/合成數據 | SFT+DPO+RLVR+去汙染 | 複用 open-instruct 做 1B/3B 實驗 |
| GRAPE | 數據是否適配目標模型 | 多 teacher response candidates | target-model fit | 按 target likelihood 選答案 |
| IFEval/IFBench | 可驗證指令遵循 | 規則約束 prompt | strict/loose programmatic eval | 自建中文 constraint suite |
| LexInstructEval | 詞彙級細粒度約束 | 規則語法 + human-in-loop | lexical control | 生成規則 + verifier |
復現建議
實驗一:SFT 數據量與質量對比。
選一個 0.5B-3B 級 base model,準備三組數據:小而人工篩選的數據、較大的合成數據、去重和規則過濾後的合成數據。保持訓練步數、學習率、chat template、tokenizer 和 eval set 不變。報告訓練 loss、held-out prompts、IFEval 風格約束和人工抽樣錯誤分析。
實驗二:teacher-student fit。
對同一批 instruction,讓多個 teacher 生成回答。用 target base model 計算回答的平均 log probability 或 length-normalized loss,再選擇“目標模型更容易學習”的回答訓練。這是 GRAPE 思路的縮小版。重點不是證明 GRAPE 一定更好,而是觀察強 teacher 的複雜回答是否會讓小模型學壞。
實驗三:指令泛化切分。
不要隨機劃分樣本,而要按任務族、約束類型或領域劃分。例如訓練只含長度和關鍵詞約束,測試格式和詞彙約束;訓練英文指令,測試中文指令;訓練單輪,測試多輪。這樣才能區分 memorization 和 generalization。
實驗四:SFT vs 偏好優化。
先做 SFT,再用小規模 chosen/rejected pairs 做 DPO,或用規則 verifier 做 RLVR。分別測開放問答質量、可驗證格式遵循和安全拒答。很多模型的提升不是統一提升,而是某一類行為被優化,另一類行為可能退化。
每次復現都要保存:
- 數據文件 hash、數據來源、許可證、過濾腳本和抽樣種子。
- chat template、特殊 token、最大長度、是否 packing、loss mask 規則。
- 模型 checkpoint、訓練框架版本、顯卡、precision、學習率、batch size、warmup、epoch。
- eval prompt、解碼參數、verifier 代碼、人工評測 rubric。
- 失敗樣本:未遵循格式、答非所問、過度冗長、幻覺、拒答錯誤、多輪遺忘。
常見誤區
誤區一:把所有後訓練都叫 instruction tuning。
SFT、DPO、PPO/RLHF、RLVR、拒絕採樣、蒸餾和安全微調是不同階段。論文如果沒有拆清楚訓練目標,就很難判斷貢獻。
誤區二:只看數據條數。
10 萬條低質量合成數據可能不如 1000 條高質量樣本;但少量樣本也未必覆蓋長尾約束、領域任務和安全邊界。要同時看質量、多樣性、覆蓋和目標模型適配。
誤區三:把模型語氣改善當能力提升。
SFT 很容易讓模型更像助手、更會排版、更會說“當然可以”。這不等於事實性、推理、代碼正確性或工具使用真的提升。
誤區四:忽略 chat template。
很多復現失敗不是因為方法無效,而是 template、EOS、role token、loss mask 或 tokenizer 不一致。Instruction tuning 的輸入格式本身就是方法的一部分。
誤區五:用同源 benchmark 證明泛化。
如果訓練數據來自 IFEval 模板、Alpaca 風格問題或某個 leaderboard 的近鄰數據,那麼 benchmark 提升可能只是模板熟悉。需要 held-out constraint、held-out task 和汙染檢查。
適合研究生繼續做的選題
- 中文可驗證指令遵循 benchmark。 構造 30-50 箇中文格式、詞彙、段落、引用和 JSON 約束,提供 verifier 與 strict/loose evaluation。
- 目標模型適配的數據選擇。 比較 strongest-teacher、random-teacher、target-likelihood、diversity-aware selection 對小模型 SFT 的影響。
- Instruction data 去重與汙染審計。 對常見開源 SFT 數據做 n-gram、embedding、prompt-template 層面的 contamination 檢測。
- SFT 對校準和拒答的副作用。 評估 SFT 後模型是否更自信、更少表達不確定性,或更容易在不知道時編造。
- 多輪約束保持。 研究模型在第 1 輪接受格式約束後,第 3-5 輪是否仍遵守約束,哪些訓練數據能改善記憶。
- 小模型 SFT 訓練動態。 復現 2025 ICLR 小模型 SFT 論文中的學習率、batch size、早期 loss/gradient signal,驗證在中文或代碼任務上是否成立。
總結
Instruction Tuning 是後訓練研究的入口,但不是後訓練的全部。讀這條路線時,最重要的是建立分解能力:任務是什麼,數據從哪裡來,SFT 訓練了什麼行為,評測能否證明泛化,失敗樣本揭示了什麼機制。經典論文提供了範式:FLAN/T0 講跨任務指令泛化,InstructGPT 講 SFT 在人類反饋鏈條中的位置,Self-Instruct 講合成數據自舉,LIMA 講質量與預訓練能力的關係。近年的開放配方和可驗證評測則提醒我們:今天的 instruction following 研究已經從“看起來更會回答”進入“數據是否適配、約束是否可驗證、結果是否能復現”的階段。
如果你要從這篇文章開始做研究,最穩的路線不是訓練更大的模型,而是做一個可控小實驗:固定模型,系統改變數據;固定數據,系統改變 template;固定 benchmark,系統分析約束泛化。把每個失敗樣本保存下來,你會比只看排行榜更接近真正的研究問題。
參考資料
檢索日期:2026-08-03。以下鏈接優先使用論文頁面、會議頁面、官方項目頁或官方倉庫;模型性能、代碼狀態、數據版本和 benchmark 結果可能變化,正式發表前建議再次核驗。
- Jason Wei et al., Finetuned Language Models Are Zero-Shot Learners, arXiv:2109.01652, 2021/2022. https://arxiv.org/abs/2109.01652
- Victor Sanh et al., Multitask Prompted Training Enables Zero-Shot Task Generalization, ICLR 2022 / OpenReview. https://openreview.net/forum?id=9Vrb9D0WI4
- Yizhong Wang et al., Super-NaturalInstructions: Generalization via Declarative Instructions on 1600+ NLP Tasks, EMNLP 2022, ACL Anthology. https://aclanthology.org/2022.emnlp-main.340/
- Long Ouyang et al., Training language models to follow instructions with human feedback, arXiv:2203.02155, 2022. https://arxiv.org/abs/2203.02155
- Hyung Won Chung et al., Scaling Instruction-Finetuned Language Models, arXiv:2210.11416, 2022. https://arxiv.org/abs/2210.11416
- Google Research Blog, The Flan Collection: Advancing open source methods for instruction tuning, 2023. https://research.google/blog/the-flan-collection-advancing-open-source-methods-for-instruction-tuning/
- Yizhong Wang et al., Self-Instruct: Aligning Language Models with Self-Generated Instructions, arXiv:2212.10560 / ACL 2023 camera ready. https://arxiv.org/abs/2212.10560
- Self-Instruct official repository. https://github.com/yizhongw/self-instruct
- Chunting Zhou et al., LIMA: Less Is More for Alignment, arXiv:2305.11206 / NeurIPS 2023. https://arxiv.org/abs/2305.11206
- Shengyu Zhang et al., Instruction Tuning for Large Language Models: A Survey, ACM Computing Surveys, 2026. https://doi.org/10.1145/3777411
- Yifan Lou et al., Large Language Model Instruction Following: A Survey of Progresses and Challenges, Computational Linguistics, 2024. https://direct.mit.edu/coli/article/50/3/1053/121669/Large-Language-Model-Instruction-Following-A
- Nathan Lambert et al., Tulu 3: Pushing Frontiers in Open Language Model Post-Training, arXiv:2411.15124, revised 2025. https://arxiv.org/abs/2411.15124
- Ai2 Tulu 3 official project page. https://allenai.org/tulu
- AllenAI open-instruct official repository. https://github.com/allenai/open-instruct
- QwenLM, Qwen3 official repository and model documentation. https://github.com/QwenLM/Qwen3
- Aldo Pareja et al., Unveiling the Secret Recipe: A Guide For Supervised Fine-Tuning Small LLMs, ICLR 2025. https://proceedings.iclr.cc/paper_files/paper/2025/hash/b6e2c96bc4702f761d7d108d6e31930f-Abstract-Conference.html
- Dylan Zhang, Qirun Dai, Hao Peng, The Best Instruction-Tuning Data are Those That Fit, arXiv:2502.04194, 2025/2026 revision. https://arxiv.org/abs/2502.04194
- Jeffrey Zhou et al., Instruction-Following Evaluation for Large Language Models, arXiv:2311.07911, 2023. https://arxiv.org/abs/2311.07911
- Valentina Pyatkin et al., Generalizing Verifiable Instruction Following, arXiv:2507.02833 / NeurIPS 2025 Datasets & Benchmarks. https://arxiv.org/abs/2507.02833
- Huimin Ren et al., LexInstructEval: Lexical Instruction Following Evaluation for Large Language Models, AAAI-26. https://ojs.aaai.org/index.php/AAAI/article/view/39701
- Hugging Face TRL, SFTTrainer documentation. https://github.com/huggingface/trl/blob/main/docs/source/sft_trainer.md