日期:2026-08-02
適合讀者:研究生、準備做大模型方向的科研新人、有工程背景但想系統理解模型規模實驗的讀者
建議前置:理解語言模型交叉熵、Transformer 參數量、訓練 token、FLOPs、log-log 圖和基本統計擬合
摘要
Scaling Laws 不是一句“模型越大越好”,而是一套用小規模實驗預測大規模行為的研究方法。Kaplan 等人在 2020 年把語言模型 loss 與參數量、數據量、訓練計算量之間的冪律關係系統化;DeepMind 的 Chinchilla 工作在 2022 年把問題改寫為“給定 compute budget,參數和 token 應該如何分配”;隨後數據受限、多模態、多語言、post-training、test-time compute、emergent abilities 爭議和 2026 年的 unified scaling law 又不斷擴大了這個框架。
這篇文章的目標是給出一條 Scaling Laws 論文精讀路線。讀者要學會三件事:第一,看懂 scaling law 論文到底擬合了什麼變量;第二,判斷它的外推是否可信;第三,把論文裡的大模型問題改造成自己能復現的小實驗。
目錄
- 為什麼 Scaling Laws 值得精讀
- 核心閱讀方法:先讀變量,再讀曲線
- 代表論文路線圖
- 關鍵論文精讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
大模型研究有一個現實約束:很多關鍵結論只能在昂貴訓練之前判斷。一個實驗室不可能隨意訓練幾十個 100B 級模型來試錯,因此需要用較小模型、較少 token 和較低算力估計更大規模下的趨勢。Scaling laws 的科研價值就在這裡:它把“經驗直覺”變成可擬合、可外推、可質疑的函數關係。
但 scaling law 也很容易被誤讀。論文中常見的橫軸可能是 non-embedding parameters、training tokens、training FLOPs、訓練步數、數據重複輪次、sampling ratio、test-time compute 或 reward optimization budget;縱軸可能是 validation loss、downstream accuracy、pass@k、reward score、人類偏好或安全指標。只要變量定義變了,“規模帶來什麼”的結論就可能完全不同。
所以這條路線的核心不是崇拜規模,而是訓練一種科研判斷:當作者說“可預測”時,他預測的是哪個指標?當作者說“emergent”時,突變來自能力本身,還是來自 metric、prompt、數據汙染、採樣方式或閾值化評分?
核心閱讀方法:先讀變量,再讀曲線
精讀 Scaling Laws 論文時,不建議從結論圖開始,而要先做一張“變量表”:
- N:模型規模。 是否排除 embedding 參數?MoE 模型寫的是 total parameters 還是 activated parameters?寬度、深度、head 數是否隨 N 一起變化?
- D:訓練數據。 計量單位是 token、樣本、episode 還是多模態離散 token?數據是否去重?重複 token 是否被當作新數據?
- C:計算量。 是估算 FLOPs、實際訓練時間、GPU-days,還是推理階段的採樣/搜索預算?
- L 或 M:指標。 是 cross-entropy loss、perplexity、accuracy、reward、human preference,還是離散的 pass/fail 指標?
- 外推範圍。 擬合是在 10M 到 1B 之間做的,卻外推到 100B 嗎?是否驗證過中間尺度或 held-out scale?
- 控制變量。 架構、tokenizer、數據 mixture、訓練超參、batch size、learning rate schedule、eval set 是否保持一致?
讀完變量表,再看曲線形態。傳統冪律在 log-log 圖上接近直線;broken scaling law 允許不同區間有不同斜率;temporal scaling law 關注訓練過程中的 loss 軌跡;observational scaling law 嘗試從公開模型而非自訓模型中擬合規律。曲線越複雜,越要追問:複雜度帶來的是解釋力,還是過擬合?
代表論文路線圖
第一站:Kaplan scaling laws。
2020 年 Scaling Laws for Neural Language Models 系統研究語言模型 cross-entropy loss 如何隨參數量、數據量和訓練計算量變化。它的重要性不在某個具體指數,而在研究範式:訓練一族模型、跨尺度擬合、用小規模趨勢指導大規模預算。
第二站:Chinchilla compute-optimal scaling。
2022 年 Training Compute-Optimal Large Language Models 重新估計參數與 token 的分配關係。論文通過 400 多個模型的實驗指出,在固定訓練 compute 下,許多當時的大模型相對“參數過多、數據不足”;Chinchilla 用 70B 參數和更多訓練 token 與 Gopher 使用相近訓練 compute,報告了更好的整體表現。對科研讀者來說,重點是“預算分配”而不是“70B 這個數字”。
第三站:數據受限與重複數據。
Muennighoff 等人的 Scaling Data-Constrained Language Models 從 2023 年 arXiv 到 2025 年 JMLR 版本持續完善,研究高質量文本可能有限時,重複數據、代碼數據、過濾策略和過量參數如何影響 compute optimality。它提醒我們:D 不是一個無窮可擴展的乾淨變量,數據來源和重複次數會改變 scaling law 的含義。
第四站:emergent abilities 的爭議。
Wei 等人的 2022 年 TMLR 論文討論了大模型中看似在某個規模後突然出現的能力;Schaeffer、Miranda 和 Koyejo 在 NeurIPS 2023 論文中指出,一些“湧現”可能來自 metric choice,例如非連續或閾值化指標會把平滑提升顯示成突變。2025 年的 emergent abilities survey 又把爭議擴展到 reasoning、quantization、prompting 和安全問題。讀這一支線的重點是:不要把曲線形狀和能力機制混為一談。
第五站:多模態、多語言和更寬的 scaling。
Generative mixed-modal scaling laws 把文本、圖像、語音、代碼等離散 token 放進統一生成建模框架,討論模態間競爭和協同;multilingual scaling laws 則研究多語言預訓練中的 sampling ratio 與語言家族表現。這類論文說明,D 不只是“更多 token”,還包括數據混合比例、模態結構和任務分佈。
第六站:post-training 與 test-time scaling。
2024 年以來,alignment 和 reasoning 方向把 scaling 從 pre-training 擴展到 reward optimization、DPO 類直接對齊、SFT/RLxF/test-time compute。ACL 2025 的 post-training scaling survey 和 2025 年 test-time scaling survey 都說明:今天的 scaling 不再只發生在預訓練階段,也發生在偏好數據、採樣數量、搜索深度、反思輪次和工具調用過程中。
第七站:統一與動態 scaling law。
Temporal scaling law 關注訓練過程中 test loss 隨 step 的變化,並在 2025 年 EMNLP 版本中強調 token position 級別的動態;2026 年 Unified Neural Scaling Laws 試圖把參數、數據、訓練步數、推理步數、compute 和超參放進同一個函數形式。對讀者來說,這類工作適合放在後半程讀,因為它們假設你已經理解傳統冪律的邊界。
關鍵論文精讀
1. Kaplan:讀“可預測性”的前提
Kaplan 論文的精讀重點是實驗設計。作者不是訓練一個大模型後畫圖,而是訓練多個尺度的模型,在參數量、數據量和計算量上做系統 sweep。你要問:模型族是否足夠一致?loss 是否在同一驗證分佈上測?擬合是否跨越足夠數量級?是否區分了 undertrained、overtrained 和 data-limited 區域?
這篇論文適合訓練你讀 log-log 圖。不要只看曲線漂亮,要看每個點代表什麼實驗、誤差來自哪裡、哪些點沒有參與擬合、外推目標離已有數據有多遠。
2. Chinchilla:讀“預算分配”而不是冠軍模型
Chinchilla 的核心問題是:給定固定訓練 FLOPs,應該增大 N 還是增大 D?論文的答案推動了後續 LLM 訓練從“堆參數”轉向“參數和 token 更平衡”的配方。精讀時建議把 Gopher、GPT-3、Chinchilla 放在參數-token 平面上,而不是隻比較 benchmark 表。
一個容易忽略的點是:compute-optimal 是針對訓練 loss 和給定計算預算的概念,不等於任意下游任務、任意推理成本、任意部署環境都最優。小模型訓練更多 token,可能降低推理成本;但如果任務依賴長程推理、工具使用或多模態能力,還需要額外證據。
3. Data-constrained:讀“數據不是免費變量”
數據受限 scaling law 很適合研究生精讀,因為它把一個真實問題具體化:如果獨立高質量文本不夠了,重複數據是否還能繼續帶來收益?論文報告在一定重複輪次內損失變化很小,但更多重複後新增 compute 的價值會衰減,並公開了 datablations 相關模型和數據。
復現時不要追求 900B token 級別實驗。可以用小語料構造 unique token、2 epoch、4 epoch、8 epoch、代碼數據增強和弱過濾版本,觀察 validation loss 與 memorization 指標。關鍵是記錄“重複”如何定義,以及 eval set 是否和訓練語料隔離。
4. Emergence:讀指標,不要只讀故事
Emergent abilities 論文很吸引人,因為它暗示模型規模可能帶來質變。但科研訓練要把問題拆開:能力是否真的不存在於小模型,還是小模型在連續指標上已經逐步改善?如果用 exact match、pass/fail 或超過閾值才算成功,曲線可能自然顯得突變;如果換成 token-level probability、partial credit 或 calibrated score,可能變得平滑。
因此讀 emergence 論文要做一個檢查清單:任務是否足夠難?指標是否連續?prompt 是否統一?樣本量是否足夠?是否報告置信區間?是否在多個模型族和數據源上覆現?是否可能存在 benchmark contamination?
5. Post-training 與 test-time:讀新的“規模軸”
2025 年以後,“scale”越來越多地指向預訓練之外:SFT 數據規模、偏好數據規模、reward model 參數量、DPO/RL 優化強度、best-of-n 樣本數、search depth、self-reflection 輪次、tool-use rollout 數量。它們不一定遵循和 pre-training 相同的冪律。
這裡的核心訓練是區分三種 compute:訓練 compute、後訓練 compute、推理 compute。一個方法可能訓練便宜但推理貴,也可能通過更多 test-time compute 換取更高 accuracy。讀這類論文時,表格裡必須補上 latency、token usage、失敗率和成本,而不只是最終分數。
方法與實驗對比表
| 論文/資料 | 重點讀什麼 | 主要變量 | 最小復現實驗 | 主要風險 |
|---|---|---|---|---|
| Scaling Laws for Neural Language Models | loss 與 N/D/C 的冪律擬合 | 參數、token、FLOPs、loss | 訓練 10M-100M 小 LM,擬合 validation loss | 外推過遠,忽略數據質量 |
| Chinchilla | 固定 compute 下的參數-token 分配 | N、D、訓練預算 | 同一預算下比較大 N 少 token vs 小 N 多 token | 把 compute-optimal 誤解成所有任務最優 |
| Scaling Data-Constrained LMs | 數據重複和數據稀缺 | unique token、重複輪次、過濾 | 小語料重複訓練,記錄 loss 與記憶化 | eval 洩漏、重複定義不清 |
| Emergent Abilities / Mirage | 湧現是否來自指標 | model scale、metric、threshold | 同一輸出用連續與離散指標重評估 | 把指標突變當機制突變 |
| Mixed-modal / Multilingual Scaling | 數據混合如何影響 scaling | 模態、語言家族、sampling ratio | 小型多語言語料調整採樣比例 | 不同語料質量混入結論 |
| Post-training / Test-time Scaling | 預訓練之後的規模軸 | SFT/RL/TTC、採樣數、搜索深度 | best-of-n 或 self-consistency 成本-收益曲線 | 忽略推理成本和失敗樣本 |
| Temporal / Unified Scaling Laws | 動態過程和多變量統一擬合 | step、inference step、超參 | 保存中間 checkpoint 擬合 loss trajectory | 函數形式複雜導致過擬合 |
復現建議
如果你沒有大規模算力,可以做三個小而可靠的訓練:
實驗一:小型 LM 的 loss scaling。
選一個乾淨小語料,例如 TinyStories、WikiText 或自建英文/中文語料,訓練 4 到 6 個 decoder-only 模型。控制 tokenizer、訓練 token、batch size 和學習率,記錄 validation loss。目標不是得到通用指數,而是學會如何構造 scale sweep 和 log-log 圖。
實驗二:compute 分配對比。
固定總訓練 token 或近似 FLOPs,比較“更大模型訓練更少步”和“更小模型訓練更多 token”。報告參數量、實際 tokens、wall-clock、顯存、最終 loss 和少量下游 probe。重點觀察是否存在 undertrained 現象。
實驗三:emergence metric audit。
找一個小推理任務或代碼任務,用同一批模型輸出,分別計算 exact match、partial credit、token probability、pass@k 和人工檢查標籤。看所謂“突然出現”是否仍然存在。這個實驗非常適合寫成 reproduction report。
每次復現都要保存:
- 代碼 commit 或壓縮包 hash。
- 數據來源、版本、去重方式、訓練/驗證切分。
- 模型 config:層數、hidden size、head 數、參數量計算方式。
- 訓練預算:token 數、batch size、學習率、warmup、precision、硬件。
- 擬合腳本:函數形式、參與擬合的數據點、held-out scale。
- 圖表:log-log loss curve、殘差圖、誤差條、外推區間。
- 負結果:loss spike、過擬合、重複數據收益消失、指標不穩定。
常見誤區
誤區一:把 scaling law 當自然定律。
它是經驗規律,依賴模型族、數據、訓練配方、指標和擬合區間。換架構、換數據、換 tokenizer,都可能改變係數甚至曲線形態。
誤區二:只看參數量。
現代模型比較必須同時看參數、激活參數、訓練 token、數據質量、上下文長度、後訓練和推理預算。只說“某模型更大”沒有科研信息量。
誤區三:把 loss 直接等同於能力。
Cross-entropy 是基礎指標,但下游 reasoning、coding、tool use、安全拒答和多模態推理不一定按同一斜率改善。
誤區四:看到 emergence 就停止追問。
真正的問題不是“有沒有湧現”這個標籤,而是任務、指標、模型族和數據是否支持“不可由小尺度趨勢預測”的強結論。
誤區五:忽略成本維度。
Test-time scaling 可能用更多采樣和搜索換分數;如果不報告 token 成本、latency 和失敗模式,結論對復現和科研選題都不完整。
適合研究生繼續做的選題
- 中文小語料 scaling law 復現:用 10M-200M 參數模型比較中文新聞、百科、代碼混合比例對 loss 的影響。
- 數據重複的邊界實驗:固定 unique token,系統改變重複輪次,測 validation loss、近鄰記憶和生成重複率。
- emergence 指標審計工具:把 exact match、partial credit、log probability 和 confidence interval 自動放進同一報告。
- 小模型 compute-optimal 配方搜索:在固定 GPU 小時內尋找 N/D 分配,並比較不同 tokenizer 的影響。
- post-training scaling 的成本曲線:比較 SFT 數據量、DPO epoch、best-of-n 和 self-consistency 的收益遞減點。
- 多語言 sampling ratio 復現:用低資源語言小語料測試 sampling ratio 是否能從小模型外推到較大模型。
總結
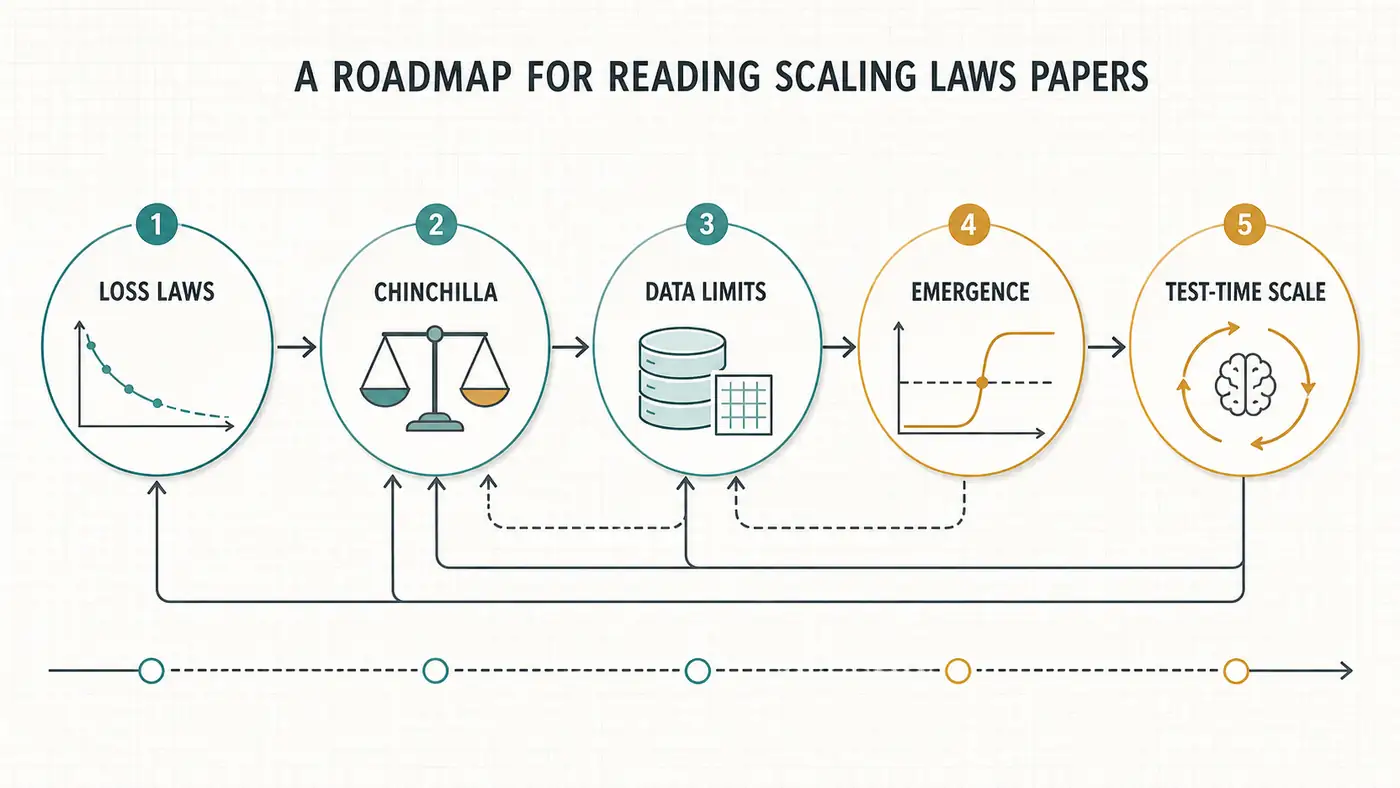
Scaling Laws 是大模型科研中少數能把“昂貴直覺”變成“可檢驗預測”的工具。讀這條路線時,要從 Kaplan 的 loss 冪律開始,理解 N、D、C 與 loss 的基本關係;再讀 Chinchilla,理解固定 compute 下的參數-token 分配;接著讀數據受限、多模態、多語言、emergence 爭議和 post-training/test-time scaling,看到“規模”這個概念如何從預訓練擴展到數據混合、指標選擇和推理計算。
對研究生來說,最重要的訓練不是背下某個 scaling 指數,而是學會設計 scale sweep、控制變量、畫 log-log 圖、檢查殘差、標出外推範圍,並誠實報告負結果。能做到這些,Scaling Laws 就不只是大廠訓練前的預算工具,也會成為你形成研究問題和復現能力的基本方法。
參考資料
檢索日期:2026-08-02。以下優先列出論文、會議頁面、官方倉庫或官方出版頁面;模型規模、benchmark 數字、代碼倉庫狀態、數據集版本等易變化信息,投稿或發佈前建議再次核驗。
- Kaplan et al., 2020, Scaling Laws for Neural Language Models, arXiv: https://arxiv.org/abs/2001.08361
- Hoffmann et al., 2022, Training Compute-Optimal Large Language Models, arXiv: https://arxiv.org/abs/2203.15556
- Google DeepMind, 2022, An empirical analysis of compute-optimal large language model training: https://deepmind.google/blog/an-empirical-analysis-of-compute-optimal-large-language-model-training/
- Wei et al., 2022, Emergent Abilities of Large Language Models, arXiv / TMLR: https://arxiv.org/abs/2206.07682
- Schaeffer, Miranda, Koyejo, 2023, Are Emergent Abilities of Large Language Models a Mirage?, NeurIPS: https://proceedings.neurips.cc/paper_files/paper/2023/hash/adc98a266f45005c403b8311ca7e8bd7-Abstract-Conference.html
- Muennighoff et al., 2023/2025, Scaling Data-Constrained Language Models, arXiv: https://arxiv.org/abs/2305.16264
- Muennighoff et al., 2025, JMLR version: https://jmlr.org/papers/v26/24-1000.html
- Hugging Face datablations repository: https://github.com/huggingface/datablations
- Caballero et al., 2023, Broken Neural Scaling Laws, arXiv / ICLR: https://arxiv.org/abs/2210.14891
- Aghajanyan et al., 2023, Scaling Laws for Generative Mixed-Modal Language Models, arXiv: https://arxiv.org/abs/2301.03728
- Gao, Schulman, Hilton, 2023, Scaling Laws for Reward Model Overoptimization, ICML: https://icml.cc/virtual/2023/poster/24924
- Rafailov et al., 2024, Scaling Laws for Reward Model Overoptimization in Direct Alignment Algorithms, arXiv / NeurIPS 2024: https://arxiv.org/abs/2406.02900
- Ruan, Maddison, Hashimoto, 2024, Observational Scaling Laws and the Predictability of Language Model Performance, arXiv: https://arxiv.org/abs/2405.10938
- He et al., 2024, Scaling Laws for Multilingual Language Models, arXiv: https://arxiv.org/abs/2410.12883
- Xiong et al., 2024/2025, Temporal Scaling Law for Large Language Models, arXiv / EMNLP 2025: https://arxiv.org/abs/2404.17785
- Lai et al., 2025, A Survey of Post-Training Scaling in Large Language Models, ACL Anthology: https://aclanthology.org/2025.acl-long.140/
- Zhang et al., 2025, A Survey on Test-Time Scaling in Large Language Models: What, How, Where, and How Well?, arXiv: https://arxiv.org/abs/2503.24235
- Berti, Giorgi, Kasneci, 2025, Emergent Abilities in Large Language Models: A Survey, arXiv: https://arxiv.org/abs/2503.05788
- Caballero et al., 2026, Unified Neural Scaling Laws, arXiv: https://arxiv.org/abs/2605.26248