日期:2026-08-01
適合讀者:研究生、準備進入 LLM 方向的科研新人、有深度學習工程背景但想系統讀架構論文的讀者
建議前置:理解矩陣乘法、softmax、殘差連接、LayerNorm、語言模型訓練目標
摘要
Transformer 不是一篇讀完就結束的論文,而是一條持續擴展的架構譜系。2017 年的 Attention Is All You Need 給出了“用注意力替代循環和卷積”的核心範式;BERT、T5、GPT-3 把它分別推向表示學習、統一文本到文本任務和大規模自迴歸語言建模;LLaMA、PaLM、Qwen3、DeepSeek-V3、Llama 4 等技術報告又把研究重點轉向 decoder-only block、歸一化、位置編碼、KV cache、GQA/MQA、MoE、長上下文和多模態融合。
這篇文章的目標不是把所有論文摘要翻譯一遍,而是給一條可執行的精讀路線:每讀一篇架構論文,都要問四個問題:它改了 Transformer block 的哪一部分?它解決的是訓練穩定性、表達能力、上下文長度、推理成本還是數據/規模問題?它的實驗是否能隔離架構貢獻?如果要復現,最小實驗應該怎麼設計?
目錄
- 為什麼 Transformer 路線值得精讀
- 核心閱讀方法:先找不變量,再找改動點
- 代表論文路線圖
- 關鍵論文精讀
- 方法與實驗對比表
- 復現建議
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼這個主題重要
很多同學第一次讀 Transformer,會把注意力公式、encoder-decoder 圖和 BLEU 分數當成重點。但現代 LLM 的論文已經很少停留在“是否使用 Transformer”這個層面,它們默認讀者知道基本 block,然後在局部做選擇:用 pre-norm 還是 post-norm?用 LayerNorm、RMSNorm 還是額外 normalization?位置編碼用絕對位置、相對位置還是 RoPE?注意力頭是否共享 KV?FFN 是否使用 gated activation?dense FFN 是否換成 MoE?長上下文靠架構、訓練數據、位置外推還是 serving 系統?
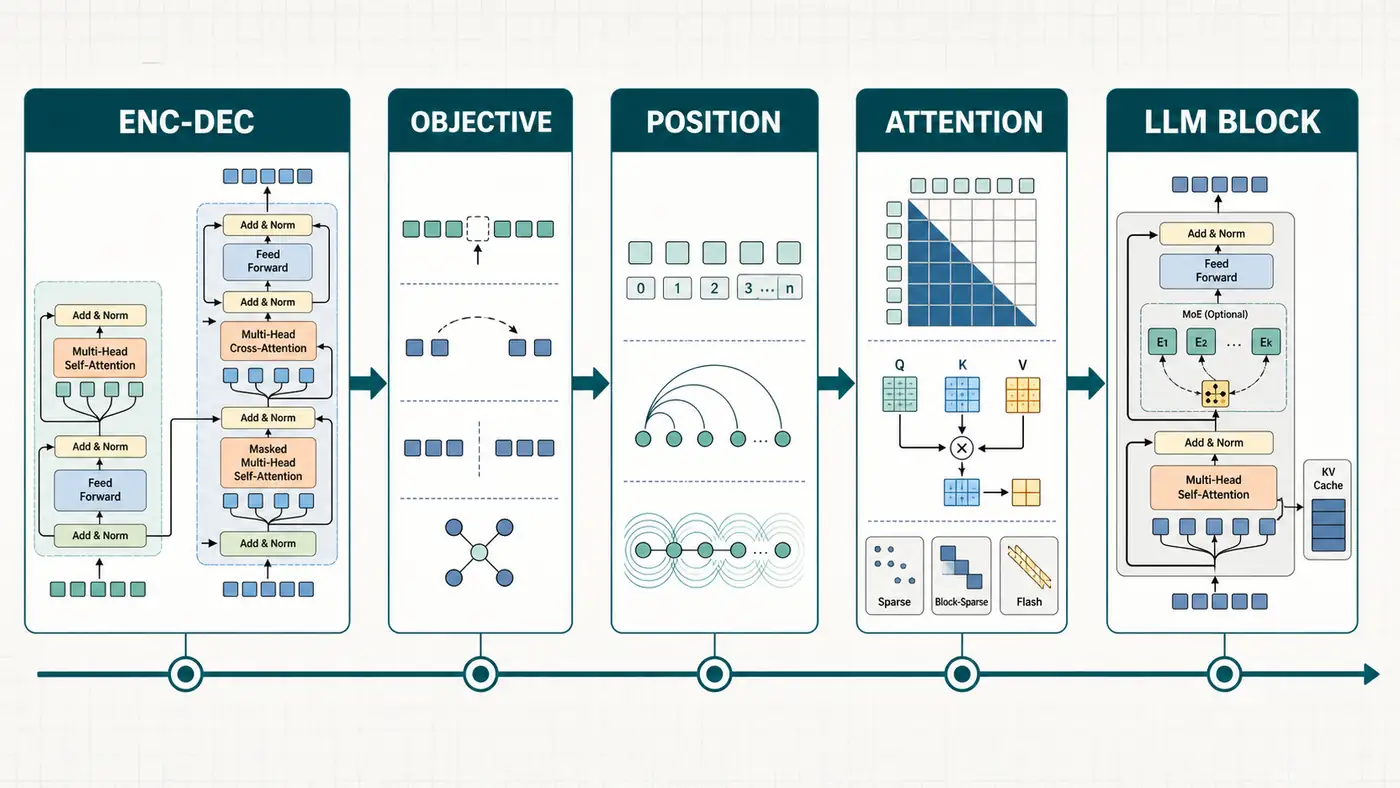
因此,Transformer 路線的真正價值是建立一套架構閱讀座標系。你以後讀任何 LLM 技術報告,都可以把它拆成五層:token 與位置、attention、FFN/MoE、normalization/residual、訓練目標與上下文長度。論文裡的模型名會變,但這五層會反覆出現。
核心閱讀方法:先找不變量,再找改動點
讀 Transformer 架構論文時,不建議從 benchmark 表格開始。先畫一個最小 block:
- 輸入 token embedding 加上位置信息。
- attention 子層混合序列內的信息。
- FFN 子層對每個位置做非線性變換。
- residual connection 保留梯度與原始表示。
- normalization 控制訓練穩定性。
- decoder-only 模型還要考慮 causal mask 與 KV cache。
然後對每篇論文做“改動點標註”:
- 改 attention:可能是 multi-head、multi-query、grouped-query、latent attention、sparse/block attention、FlashAttention 這類系統友好實現。
- 改 position:可能是 sinusoidal、learned absolute、relative position、RoPE、長上下文外推。
- 改 FFN:可能是 ReLU/GELU 到 GEGLU/SwiGLU,也可能是 dense FFN 到 MoE。
- 改 norm/residual:可能是 post-norm 到 pre-norm、RMSNorm、額外 normalization 或 residual scaling。
- 改 objective:可能是 masked LM、causal LM、span corruption、text-to-text、multi-token prediction。
- 改 scale:可能是參數、數據、上下文長度、激活參數、訓練精度和硬件效率的共同設計。
這樣讀的好處是,你不會把“模型更大”“數據更多”“調參更好”誤讀成“架構必然更優”。架構論文的證據強度,取決於它是否把改動點從訓練配方、數據質量和推理系統中分離出來。
代表論文路線圖
第一站:原始 Transformer。
Vaswani 等人在 2017 年提交的 Attention Is All You Need 提出完全基於注意力的 encoder-decoder 架構,去掉 recurrent 和 convolutional 結構,並用 multi-head attention、position-wise FFN、residual、normalization 和 positional encoding 組成可並行訓練的序列轉導模型。精讀時不要只背公式,要重點看作者如何把序列建模問題拆成“token-to-token 信息路由”和“位置無關的逐點變換”。
第二站:預訓練目標分叉。
BERT 選擇 encoder-only 和 masked language modeling,強調雙向表示;GPT 系列選擇 decoder-only 和 causal language modeling,強調自迴歸生成;T5 把 NLP 任務統一為 text-to-text,並系統比較預訓練目標、數據、架構和遷移策略。這裡要讀懂:同樣基於 Transformer,為什麼輸入可見性、mask 方式和 fine-tuning 形式會塑造模型能力。
第三站:規模化 decoder-only。
GPT-3、PaLM、LLaMA 把研究重點轉向“如何把 decoder-only LM 訓練到足夠大且可用”。GPT-3 證明 few-shot prompting 與規模強相關;PaLM 報告 540B dense Transformer 及 Pathways 系統訓練;LLaMA 證明在公開數據與更充分 token 預算下,中小參數量模型也能有強表現。讀這一段時要把 architecture、data、compute 三者一起看。
第四站:現代 block 的局部替換。
RoPE 影響了位置編碼的主流選擇;RMSNorm 降低歸一化開銷並被多種 LLM 採用;GLU/SwiGLU 改寫 FFN 的非線性部分;MQA/GQA 直接面向自迴歸推理中的 KV cache 帶寬瓶頸;FlashAttention 系列說明很多“架構可用性”實際依賴 GPU memory hierarchy 和 kernel 實現。
第五站:2025 前後的系統級架構。
DeepSeek-V3 使用 MoE、Multi-head Latent Attention、auxiliary-loss-free load balancing 和 multi-token prediction;Qwen3 同時發佈 dense 與 MoE 尺寸,並強調 thinking / non-thinking 模式和長上下文支持;Llama 4 模型卡說明其使用 MoE 與 early fusion 多模態架構。現代技術報告往往不是單一創新,而是 architecture、training、data、post-training、serving 的組合包。
關鍵論文精讀
1. Attention Is All You Need:讀結構,不只讀公式
這篇論文最重要的貢獻不是 softmax(QK^T / sqrt(d_k)) 這個公式本身,而是把序列建模從時間步遞歸中解放出來。你要重點讀三處:
- Multi-head attention 為什麼要分頭?它讓模型在不同表示子空間中學習不同關係,而不是把所有關係壓進一個注意力矩陣。
- Encoder-decoder attention 為什麼存在?它把源序列表示作為 memory,讓 decoder 在生成時查詢。
- Positional encoding 為什麼必要?純注意力本身對 token 順序不敏感,必須注入順序信息。
精讀動作:把論文圖 1 重畫成你自己的 block,並標註每個張量的形狀。然後嘗試解釋為什麼 self-attention 的計算複雜度與序列長度平方相關,這會為後續長上下文論文打地基。
2. BERT、T5 與 GPT-3:架構相似,目標不同
BERT 的關鍵是 bidirectional encoder 表示,適合做理解任務的 fine-tuning;T5 的關鍵是把任務統一成 text-to-text,從而能系統研究預訓練目標;GPT-3 的關鍵是把 decoder-only causal LM 推向大規模 few-shot setting。三者都不是“誰替代誰”,而是展示了 Transformer 在不同可見性約束下的分工。
讀這組論文時,建議做一個三列表:輸入能看見什麼、訓練時預測什麼、推理時怎麼使用。BERT 的 masked token 預測和 GPT 的 next-token prediction 對梯度信號、數據構造和能力外顯方式都有影響。T5 適合作為方法論樣本,因為它系統比較多個變量,而不是隻發佈一個更大的模型。
3. RoPE、RMSNorm、SwiGLU:現代 LLM block 的“三個小改動”
很多 LLM 架構看起來只是 Transformer 的變體,但它們的 block 已經和 2017 版本不同。RoPE 把位置信息編碼進 query/key 的旋轉關係,適合與 attention 分數結合;RMSNorm 去掉 LayerNorm 的 re-centering,僅保留 RMS 級別的縮放歸一化;SwiGLU/GEGLU 這類 gated FFN 讓前饋層不僅是“線性-激活-線性”,而是帶門控的信息篩選。
這類論文的讀法不是問“提升多少分”,而是問:改動是否局部、是否容易插入已有 block、計算開銷如何、是否在多個規模上穩定。研究生做復現時,可以選 100M 到 1B 級別的小模型,比較 ReLU/GELU/SwiGLU、LayerNorm/RMSNorm、absolute/RoPE 的訓練 loss 曲線和下游小任務,而不必復現大模型分數。
4. MQA、GQA、FlashAttention:從訓練架構讀到推理瓶頸
自迴歸生成不是一次性並行輸出,而是逐 token 解碼。每生成一個 token,模型都要讀歷史 token 的 key/value cache。Multi-query attention 讓多個 query head 共享一組 key/value,降低 KV cache 讀寫壓力;grouped-query attention 在 MHA 與 MQA 之間折中,用多個 KV 組保留質量;FlashAttention 則不是改變數學定義,而是改變 attention 的 GPU 計算與 memory access 方式。
這一組論文訓練你區分“數學架構”和“系統實現”。有些方法不改變模型函數,卻顯著改變可訓練長度、吞吐和顯存佔用。讀實驗表時,不要只看 perplexity,也要看 throughput、memory、context length、硬件型號和 kernel 支持。
5. DeepSeek-V3、Qwen3、Llama 4:現代技術報告怎麼拆
DeepSeek-V3 報告稱模型為 671B total、37B activated 的 MoE,使用 MLA 和 DeepSeekMoE,並加入 auxiliary-loss-free load balancing 與 multi-token prediction。Qwen3 官方倉庫顯示其發佈 dense 與 MoE 多尺寸模型,包括 30B-A3B、235B-A22B 等,並在 2025 年更新了長上下文與 thinking/non-thinking 形態。Meta Llama 4 模型卡寫明 Scout 與 Maverick 是 auto-regressive、MoE、early-fusion multimodal 模型,發佈時間為 2025-04-05。
讀這些報告時要更剋制:不要把開放模型的 benchmark 表直接當作架構結論。它們通常同時改了數據、tokenizer、訓練配方、RL/post-training、serving kernel 和評測集合。正確做法是把報告拆成“架構聲明”“訓練聲明”“數據聲明”“評測聲明”“限制聲明”,併為每條聲明找可復現證據。
方法與實驗對比表
| 論文/資料 | 重點讀什麼 | 架構改動位置 | 復現最小實驗 | 主要風險 |
|---|---|---|---|---|
| Attention Is All You Need | multi-head attention、encoder-decoder、positional encoding | attention 與整體 block | 小型機器翻譯或複製任務,重畫張量形狀 | 只背公式,不理解並行化動機 |
| BERT | masked LM 與雙向 encoder | objective + encoder-only | 小語料 MLM 預訓練 + 分類微調 | 把理解任務結論泛化到生成模型 |
| T5 | text-to-text 統一框架與消融 | objective + transfer setup | 用同一模型格式跑分類/摘要小任務 | 忽略數據清洗和任務模板 |
| GPT-3 | decoder-only + few-shot scaling | scale + prompting interface | 小 decoder LM 的 in-context 學習探針 | 把規模效應誤判為單一架構創新 |
| RoPE / RMSNorm / SwiGLU | 局部 block 替換 | position、norm、FFN | 同規模小模型訓練曲線對比 | 只看最終分數,不看穩定性 |
| MQA / GQA / FlashAttention | KV cache、吞吐、顯存 | attention 與 kernel | 固定模型比較 prefill/decode latency | 混淆算法複雜度和實際硬件效率 |
| DeepSeek-V3 / Qwen3 / Llama 4 | MoE、長上下文、多模態/推理形態 | system-level architecture | 復現子模塊或配置解析,不復現全量訓練 | 把技術報告當成單變量實驗 |
復現建議
如果你是研究生,不建議從“復現 Llama 級別模型”開始。更合理的路線是做三個小實驗。
實驗一:重建最小 Transformer。
用 PyTorch 寫一個 decoder-only LM,在 TinyStories、WikiText-2 或自建小語料上訓練。目標不是高分,而是驗證 mask、residual、norm、FFN、position 的實現是否正確。必須保存 config、seed、loss 曲線和樣例生成。
實驗二:局部替換消融。
在同一訓練預算下比較兩到三個改動:absolute position vs RoPE,LayerNorm vs RMSNorm,GELU FFN vs SwiGLU FFN,MHA vs GQA。每次只改一個變量。報告裡寫明參數量是否變化、訓練 token 是否一致、學習率是否重新調過。
實驗三:推理側測量。
固定一個開源小模型,測 prefill latency、decode latency、顯存、KV cache 大小,比較不同上下文長度。這裡不要追求論文級 benchmark,而要訓練自己理解“為什麼現代架構論文總在談 KV cache、GQA、FlashAttention、serving engine”。
復現記錄至少包括:
- 代碼 commit 或壓縮包 hash。
- Python、PyTorch、CUDA、transformers/vLLM/llama.cpp 版本。
- 數據集名稱、版本、清洗規則和樣本數。
- 模型 config:層數、hidden size、head 數、KV head 數、FFN hidden size、position type、norm type。
- 訓練預算:token 數、batch size、學習率、warmup、precision。
- 日誌:loss、吞吐、顯存峰值、異常樣例。
- 負結果:不穩定、loss spike、OOM、速度反常都要寫。
常見誤區
誤區一:把 Transformer 等同於 attention。
Attention 是核心,但現代 LLM 的表現還依賴 FFN 容量、normalization、位置編碼、訓練目標、數據和規模。只讀 attention 公式無法讀懂 LLM 技術報告。
誤區二:把 decoder-only 當成“更高級”。
Encoder-only、encoder-decoder、decoder-only 是任務和訓練目標選擇,不是線性進化。BERT 仍然適合表示學習;T5 仍然適合統一任務建模;decoder-only 只是現代通用生成模型的主流選擇。
誤區三:看到 MoE 就認為計算一定便宜。
MoE 降低每 token 激活參數,但會引入 routing、負載均衡、通信和部署複雜度。論文裡的 total params、activated params、專家數、top-k、共享專家都要分開記錄。
誤區四:忽略硬件和 kernel。
長上下文 attention 是否可用,常常取決於 FlashAttention、paged KV cache、tensor parallel、GPU memory bandwidth 和 batch scheduling。架構讀不懂系統,復現就容易失敗。
誤區五:複製 benchmark 表格當結論。
技術報告的評測表通常混合了模型、數據、後訓練、提示格式和評測實現。科研訓練要追求“能解釋的差異”,不是堆排名。
適合研究生繼續做的選題
- 小模型上的 position encoding 外推研究:固定 100M 到 300M decoder-only 模型,比較 RoPE、ALiBi、RoPE scaling 在短訓長測下的穩定性。
- GQA 的質量-速度折中曲線:固定參數量和訓練數據,系統改變 KV head 數,測 perplexity、decode latency 和顯存。
- FFN 門控對推理任務的影響:比較 GELU、GEGLU、SwiGLU 在數學、代碼、小語料語言建模上的差異,重點分析訓練穩定性。
- MoE routing 可解釋性小實驗:在小型 MoE LM 上觀察不同 token 類型、語言或任務是否傾向不同 expert。
- 技術報告聲明核驗工具:寫腳本解析 Hugging Face config、model card 和論文表格,自動生成“架構聲明清單”,標出待人工核驗字段。
- 訓練目標與架構交互:比較同一 Transformer block 在 causal LM、span corruption、prefix LM 下的表示和生成差異。
總結
Transformer 精讀路線的核心不是“讀完一篇神作”,而是建立一個能持續複用的架構座標系。先讀 2017 年原始 Transformer,理解 attention、FFN、position、residual、norm 的基本分工;再讀 BERT、T5、GPT-3,理解訓練目標如何改變模型用途;然後讀 RoPE、RMSNorm、SwiGLU、MQA/GQA、FlashAttention,理解現代 block 的局部演化;最後讀 DeepSeek-V3、Qwen3、Llama 4 這類技術報告,訓練自己把系統級模型拆回可檢驗的研究問題。
真正的科研訓練發生在復現和消融裡:你能否固定變量、重跑小實驗、解釋負結果,並從一個局部改動提出下一步問題。能做到這一點,Transformer 就不再是一張經典架構圖,而會變成你進入 LLM 研究的工具箱。
參考資料
檢索日期:2026-08-01。以下優先列出論文、官方項目頁、官方模型卡或會議頁面;模型卡、倉庫 release、benchmark 數字等易變化信息,投稿或發佈前建議再次核驗。
- Vaswani et al., 2017, Attention Is All You Need, arXiv: https://arxiv.org/abs/1706.03762
- Devlin et al., 2018/2019, BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, arXiv: https://arxiv.org/abs/1810.04805
- Raffel et al., 2019/2023, Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, arXiv: https://arxiv.org/abs/1910.10683
- Brown et al., 2020, Language Models are Few-Shot Learners, NeurIPS: https://papers.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Kaplan et al., 2020, Scaling Laws for Neural Language Models, arXiv: https://arxiv.org/abs/2001.08361
- Shazeer, 2020, GLU Variants Improve Transformer, arXiv: https://arxiv.org/abs/2002.05202
- Zhang and Sennrich, 2019, Root Mean Square Layer Normalization, NeurIPS: https://papers.nips.cc/paper_files/paper/2019/hash/1e8a19426224ca89e83cef47f1e7f53b-Abstract.html
- Su et al., 2021, RoFormer: Enhanced Transformer with Rotary Position Embedding, arXiv: https://arxiv.org/abs/2104.09864
- Shazeer, 2019, Fast Transformer Decoding: One Write-Head is All You Need, arXiv: https://arxiv.org/abs/1911.02150
- Ainslie et al., 2023, GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, ACL Anthology / EMNLP 2023: https://aclanthology.org/2023.emnlp-main.298/
- Dao, 2023, FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, arXiv: https://arxiv.org/abs/2307.08691
- Chowdhery et al., 2022, PaLM: Scaling Language Modeling with Pathways, arXiv: https://arxiv.org/abs/2204.02311
- Touvron et al., 2023, LLaMA: Open and Efficient Foundation Language Models, arXiv: https://arxiv.org/abs/2302.13971
- Grattafiori et al., 2024, The Llama 3 Herd of Models, arXiv: https://arxiv.org/abs/2407.21783
- DeepSeek-AI, 2024/2025, DeepSeek-V3 Technical Report, arXiv: https://arxiv.org/abs/2412.19437
- Qwen Team, 2025, Qwen3 official repository and technical report links: https://github.com/QwenLM/Qwen3
- Qwen Team, 2025, Qwen3: Think Deeper, Act Faster, official blog: https://qwenlm.github.io/blog/qwen3/
- Meta, 2025, Llama 4 model card: https://github.com/meta-llama/llama-models/blob/main/models/llama4/MODEL_CARD.md
- Meta, 2025, The Llama 4 herd, official blog: https://ai.meta.com/blog/llama-4-multimodal-intelligence/